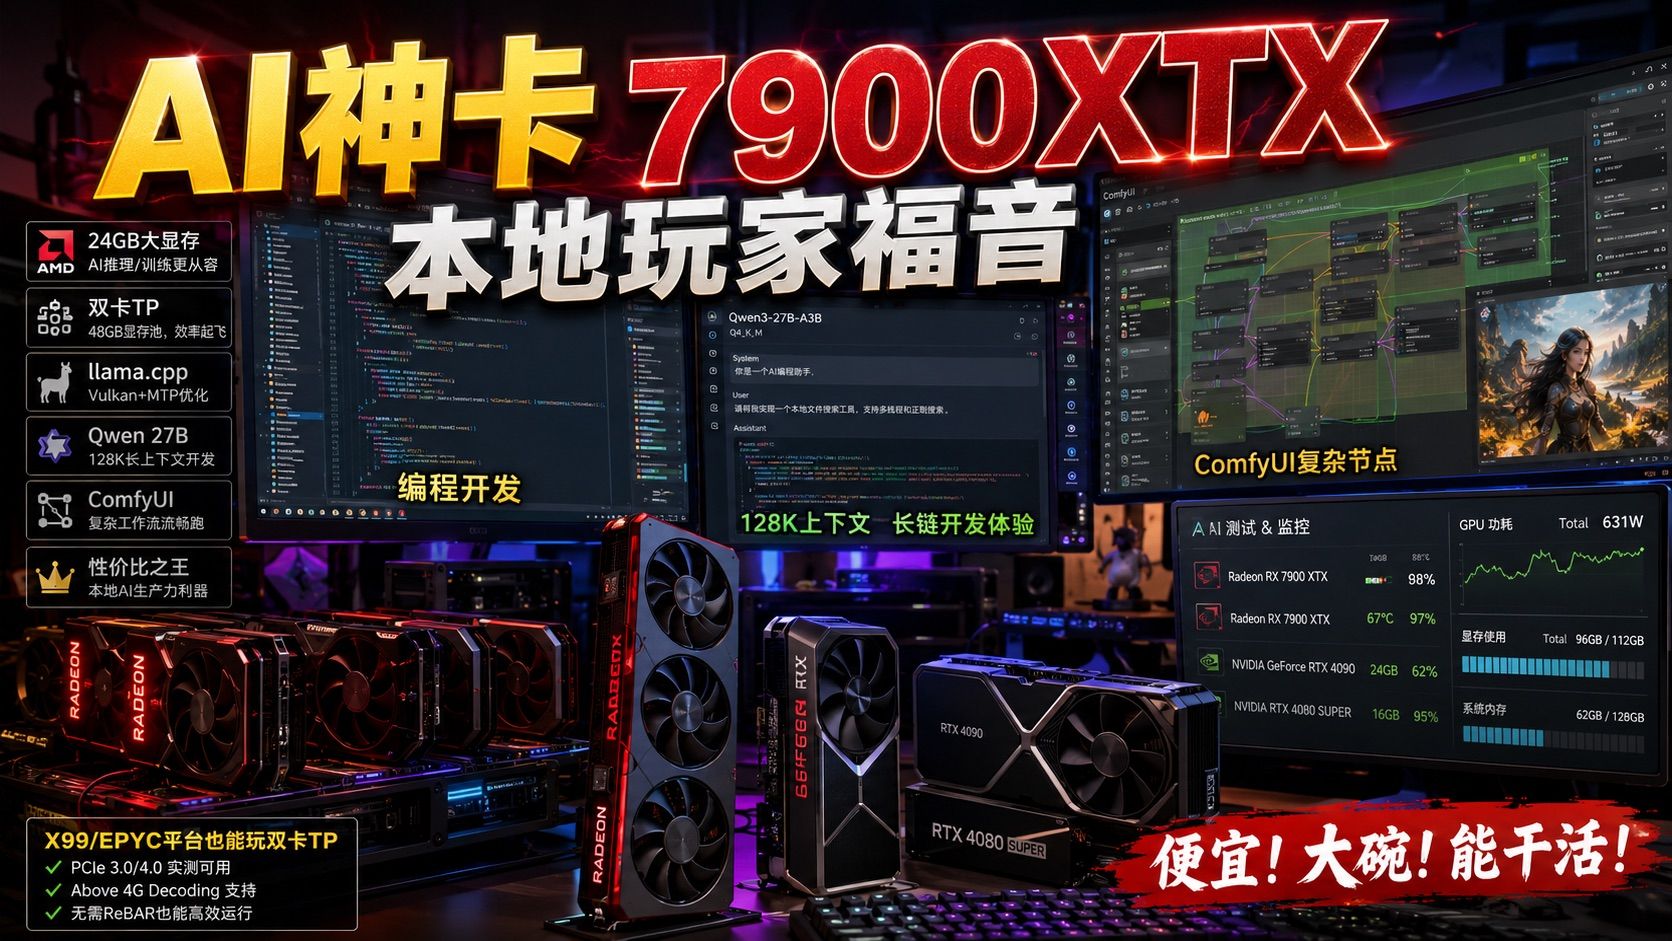
平民AI神卡:7900 XTX突然真香了?单卡/双卡TP + llama.cpp,MiniMax H3也能玩,本地AI性价比暴涨!
-
这两天的视频都是以小头像加上 OBS 录屏的方式来给大家呈现的。当然,也不能一直做这种格式,要不然这个频道就没有我明显的风格了,是吧?有可能有一天又会被平台打成 AI Slop,到时候我又申诉无门。所以还是偶尔露露脸,做一做真人出镜的视频,展示一下我这张老脸。虽然大家不太愿意看,但是这个也没办法,必须要这样操作。
那么本期我们还是聊一聊我们频道,包括我们论坛讨论度最高的一张显卡,就是 7900 XTX。最近它的性价比又突然爆棚,我认为市场上这个涨价的幅度甚至还没有完全覆盖这张卡的价值。那么今天我们就讲一讲这其中的门道。当然,事先我必须要说一下,有很多人在我的频道,包括论坛留言,说我们最推荐的就是这张卡。其实不是,我本人最推荐的卡是 RTX PRO 6000,然后是 RTX PRO 5000,然后是 4090D 48G 魔改卡,接下来才是 7900 XTX。可是问题是,大部分的观众愿意花三万块钱、四万块钱、十万块钱去买这样高端的显卡吗?我相信也不会吧。是不是?那么我们就更多地照顾一下我们大多数观众能够够到的地方。
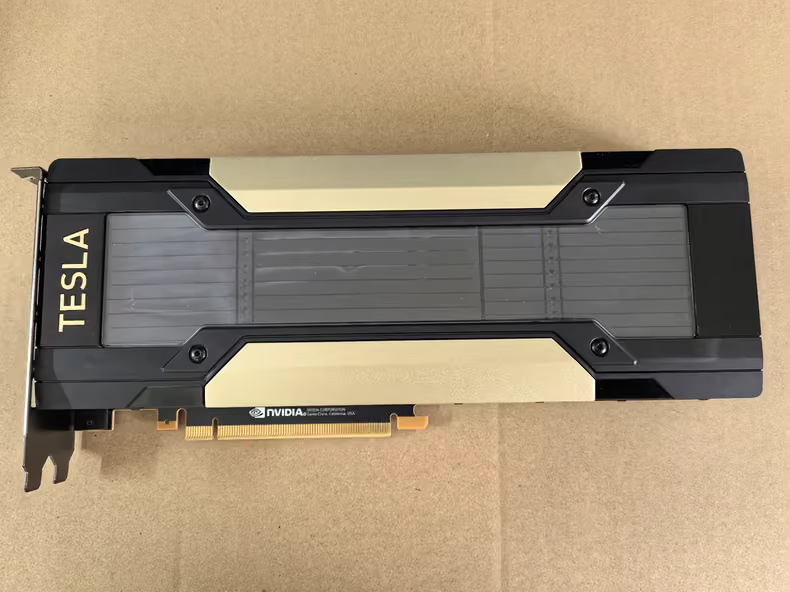
也有人问,你为什么不讲什么 MI210、V100 这些卡呢?它们不是更便宜吗?这些卡我也说过了它们的局限性。我经常在视频中喷它们是工业垃圾,并不是要砸这里面商家、二手贩子的饭碗,就是因为我不能不负责任地把它们推荐给我的观众,让他们拿到手之后这也不能干、那也不能干,浪费很长的时间,最后他们会把怨气发泄到我的频道上,这个得不偿失。
还有我要说一下,我并不是说跟什么华南金牌、精粤有什么合作关系。那么为什么我提到华南金牌更多呢?就是因为当时我买了华南金牌的板子。如果我买了精粤的板子,我肯定会更多地提到精粤嘛。那我跟 AMD、英伟达签什么合同吗?有什么 PY 关系吗?没有啊,我还得讲它们的显卡呀,是吧?我跟英特尔这家也没什么仇恨啊,但是我在视频中还是经常喷它们的显卡生态不好。这个就是纯粹的个人经验分享。我频道也不是什么像极客湾这种大型的、有一定社会影响力的硬件测评频道,我就是分享我的个人使用经验,主观意识非常浓厚。你们愿意听就听,你们觉得哪些地方讲得不如意,可以到论坛去发帖,或者我直播的时候你们上来喷我。就不要在评论区打一些有的没的、酸酸的这种评论,就非常不爷们,知道吗?
然后我们把话题回到 7900 XTX 这张显卡上来。为什么最近我认为它的价值忽然提升了呢?第一,显卡涨价,显卡供应、算力供应紧张,大家相信能够看到。英伟达又预告它的机柜,包括它的这些计算卡,交付之后都要涨价。我认为可能到明年下半年之前,甚至明年年底之前,这个状况应该不会改善。现在如果说你有算力需求的话,尤其是有这种本地部署的隐私算力,或者可控算力的需求,那么你还是要去买显卡。你现在像华为的这些、寒武纪的这些芯片,你买得到吗?你也买不到,而且人家也不单卖。就算是做成了 PCIe 接口的这种计算卡,你也买不到,买到了性价比也很低。那你还是要去考虑买 AMD 或者买英伟达的显卡。
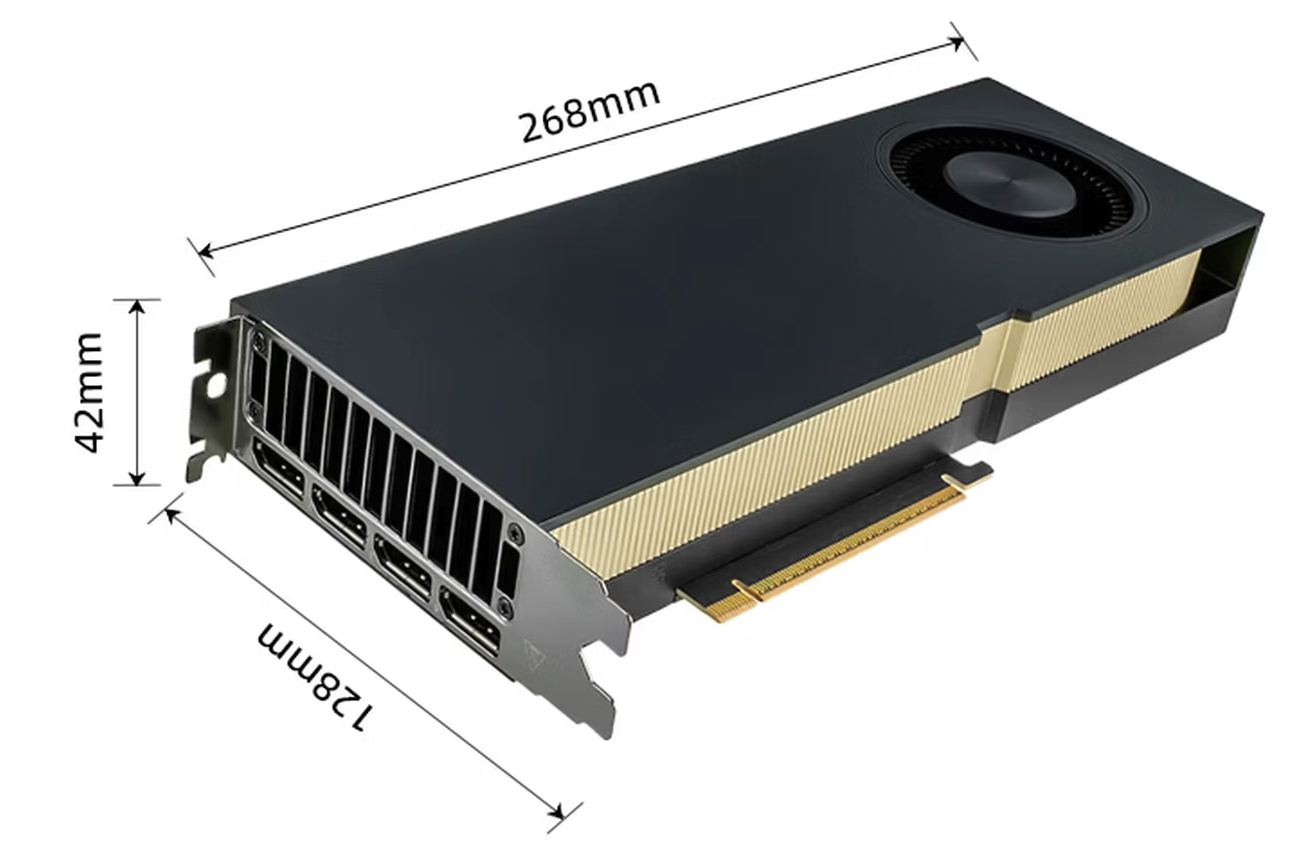
那么 N 卡,无论是 4080S 32G,还是 RTX PRO 4000、4500 这种 24G 起步的这些卡,讲实话价格都比较贵。那么我谈得最多的这个 7900 XTX,就是因为这张卡它现在便宜啊,它比 3090 还便宜啊。它现在新卡可能 6000 块钱到 7000 块钱之间,或者 7000 块钱附近,它还没有彻底地涨上来。而且这个卡是新卡,3090 肯定是二手翻修的。这种涡轮卡噪音大,而 7900 XTX 这张卡相当地安静,功耗 TDP 是 350 瓦,然后我的 Linux 系统是给它默认限定的 303 瓦。它在大部分时候的噪音,比这个 X99 洋垃圾,就是华南金牌送的这个洋垃圾附带的风扇,噪音要低得多。就算是在全力进行 AI 推理、长链开发任务的时候,它的噪音也是比较小的,也是可以接受的。
这张卡你能买到什么蓝宝石,能买到讯景这些新卡。尤其是蓝宝石的 7900 XTX 白金版,也就是丐版,这张卡的性价比非常高,做工非常优秀,散热也非常好。那你买到这样的卡,立刻就能投入生产。你说未来两年还有什么更好的选择吗?我认为都不至于。
然后我们谈到应用。就说这个 MiniMax H3,这个重磅的 ComfyUI 生态、多模态大模型、视频大模型,7900 XTX 它就能够比较好地玩。虽然是在 480P 分辨率底下,虽然它的生产效率可能没有我们想的那么高,但是如果说你个人就是有那么一两个短片的小频道,立马这个东西掌握了,它就能够给你切切实实地提供生产力。它不是玩具啊,它是生产力工具啊。就光这一条,它就值这么多钱。
当然了,这个并不是我们今天视频要谈的主要话题。今天要谈的还是在传统的 AI 大模型方面,它带来的这种生产力,它忽然间变得很有价值。之前我们提到千问 3.8 27B 稠密模型,是吧?它这个 Q4_K_M 量化版本,我是把它用 7900 XTX 驱动,然后接入了我的 Codex。讲实话,它在开发中的体验略差于 DeepSeek V4 Flash,也要比最近几天吵的这个什么 Ox Alpha,也就是传说中有可能是 GLM 5.3 的这个模型,要差一点。但是这个体验,我认为已经是可以接受的差距,不影响你正常开发。可能说速度略慢一点,但是它不要钱嘛,你把它挂在那里让它跑就行了。
就光这一块,7900 XTX 能够让它以稳定的 128K 上下文来执行长链开发任务,这一个单项功能也值这么多钱。因为你对比一下 DeepSeek V4 Flash 的 API 费用嘛,你现在一天说实话花个二三十,如果重度开发的话,花个四五十很正常。那你一个月下来,不就是 1500 左右?那几个月就回本了。你有一个本地的算力,关键是你不用担心它的 API 哪天再度涨价,或者说算力供应又会出现问题。你有一张卡在自己本地,你手中就多一个安全感,你就可以放心地使用它去开发。
并且千问 3.8 27B 这个模型是黄金尺寸的模型。在这个维度的竞争上,像谷歌也好,它的 Gemma,像 Meta 也好,它的 Muse Glimmer,已经被证明无法跟千问竞争,这一块的竞争已经结束了。阿里巴巴一定会继续发布这个模型的更新版本,它的下一次进步同样非常值得我们期待。那你有了这样一张卡,你就可以保证在未来两年不至于落伍,你的本地 AI 都可以帮你实实在在地干活。你看,又能跑千问 27B,又能跑 MiniMax H3。你说对于一张 7000 块钱的卡,还能保修三年,还能买到大品牌这种逼格看起来很高、用料很足的卡,是要面子有面子,要里子有里子,你还要什么自行车呢?
那么论坛最近关于 AMD 的显卡玩法又多了起来。最重要的是什么呢?llama.cpp 进行了大幅度的更新。它的 Vulkan 驱动,包括 MTP 技术,分别解决了 Prefill 很慢的问题,也解决了吐字速度不够的问题。7900 XTX 这张卡,它的吐字速度在单会话中已经达到了相当可用、相当流畅的地步。并且由于 Vulkan 管线的更新,Prefill 的速度让你在进行长链任务、长上下文任务中,不会感觉到半天才回应你,不会有这种便秘的感觉,它的响应速度是很快的。
而且以前我们认为的一些禁区,由于 llama.cpp 架构的革新,也得到了很大的改善。比如说之前我们认为 TP 可能只有 vLLM 或者 SGLang 能够玩,你又想体验好一点的话,可能只能用 SGLang 了。因为 vLLM 只能解决并发的问题,它不能解决长上下文的问题。但是如今我们是在 Agent 的时代,Agent 的时代就要求你肯定要能够很好地驱动 DeepSeek Harness、Codex、Hermes、OpenClaw 这些通用的、用量比较大的 Agent,也包括 OpenCode 之类的。
那么 vLLM 呢?它如果是进行长上下文这种任务的话,我认为它的首 Token 延迟也好,就是 Prefill,也包括 Decode 也好,我认为它的体验事实上在单用户场景中是完全不如 llama.cpp 的。而且 llama.cpp 相比于 vLLM、相比于 SGLang,它的部署门槛是低到令人发指。无论在 Windows 上,还是在 Mac 上,还是在 Linux 上,它都能非常方便地部署,并且版本迭代的速度是相当快的。而且它还有 Ollama、LM Studio 这样的前端软件在。它是非常值得玩的,门槛又非常低。
那么最近这个更新,让我最重视的张量并行是一个什么样的场景?就是论坛中有很多用户发帖,用两张 Radeon AI PRO R9700 进行双卡 TP,就是用 llama.cpp 来驱动。Prefill 的速度跟解码的速度,也就是 Decode 的速度,已经达到了非常不错的水平。我们不能说一加一等于二,但是能够一加一等于 1.6、1.7,甚至 1.8,是吧?那么这种损失就能够接受了。
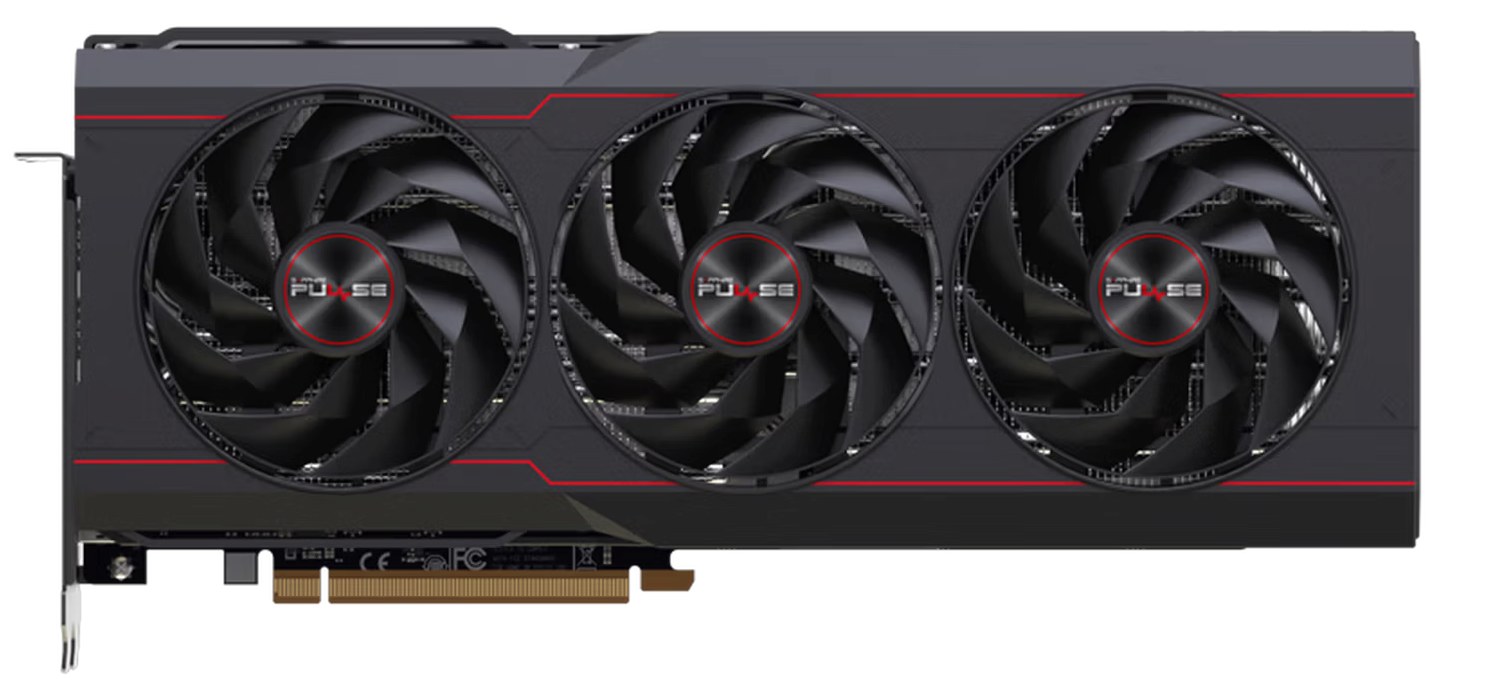
如果是用两张 7900 XTX 的话,那你这个门槛又会降低了。因为毕竟 R9700 Pro 它 32G 显存不假,但是它需要 11000 块钱,两张就要 22000。但是你两张 7900 XTX,组成 48G 的显存池,你跑一个什么 Qwen 3.6 27B Q4_K_M 版本,可以支持好多个会话。你跑一两个主要的长链任务会话,然后再跑几个短的日常小任务、短的会话,完全扛得住。因为它是 TP,它跟串行计算有一个很大的区别,就是它两张 GPU 是同时在算的。
我们日常开发讲实话,一个 GPU 运算速度已经能够满足我们的要求了。比如说我们正在这里进行长链的开发任务,开发我这个论坛的 APP,是吧?那么这个卡的算力,两张肯定是过剩的。这个时候你再有一些短的请求进来,它也能够很快就响应。就是说两张卡组成一个算力池的话,在本地就能够提供一个不错的综合智能计算中心。甚至你前台一个任务,后台一个任务,同时再处理两个临时并发的小任务,它是完全扛得住的。
之前我比较担心的是什么?就是说像我们买的这些便宜的主板,比如说华南金牌的 X99 CD3 或者 CD4,这些板子都相当地便宜,几百块钱一张,还给你送 CPU。它有一个什么问题呢?就是它的显卡是 PCIe 3.0 ×16 的,第二张卡可能只能到 PCIe 3.0 ×8。那么这个卡它是支持 Above 4G Decoding,但是它并不支持 REBAR。不支持 REBAR 的话,就表示两张显卡之间的 P2P 通信效率可能会受到严重的影响,那么你可能要通过 CPU 来中转。在这种情况下,如果说你是玩 SGLang 的话,那个架构,或者玩 vLLM,那么你 TP 的效率可能就会有很大的瓶颈,效率不高,效果完全不行。
但是如果说你现在用 llama.cpp,它这个新的 TP 架构,在内部做了专门的优化。在这一块,在 N 卡上的体验也相当不错了,在 A 卡上我认为可能需要一段时间的完善。但是我看论坛,人家用两张 R9700 Pro 加上 X99 CD4 这种入门的板子,跑起来的体验也是还不错的。不能说一加一等于二,但是一加一大于 1.5,能够做到 1.6、1.7,甚至 1.8,这个调一调搞不好都是可以玩的。测试的数据就在那里,有想要抄作业的可以去看一下。
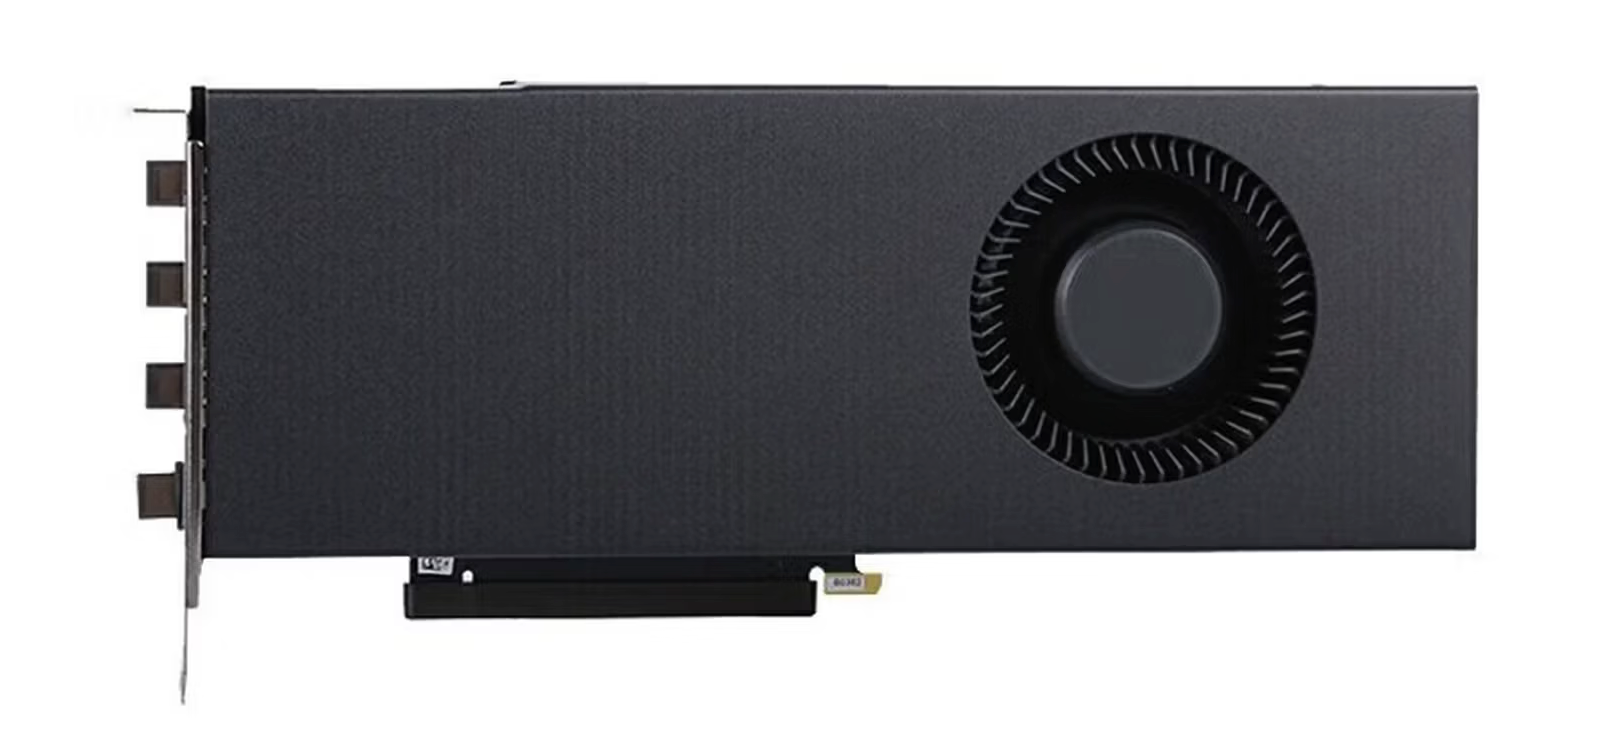
如果在这种情况下的话,我觉得这张卡的价值真的是被大大低估了。因为很多人说我买什么 3090。你买 3090,它一个天大的优势就是说支持 NVLink,是吧?这样它对主板的要求可能就没有那么高了,它这个通信的效率可能也会高很多。但是你别忘了,玩 NVLink 它还是要一定门槛的,你要能折腾硬件。关键的问题是什么呢?就是说 3090 这个东西的发热,它的制程是 8 纳米制程,发热是相当恐怖的。把它改成涡轮卡之后,它的噪音也是相当大的。
别的不说,就是我这个 4090 48G,我讲实话,它满功率工作的时候,那噪音真的是相当地夸张。对于我这样反应比较迟钝的人,我可能一旦专心工作就不太在乎了,在它旁边能坐得下去。对于大多数人来说的话,你在它旁边坐着,那是一种折磨。但是如果说你有两张 7900 XTX,它是台积电 5 纳米、6 纳米的混合工艺,是黄金节点,这是台积电当年的巅峰之作。那么这张卡的工艺是非常优秀的,然后散热做得也相当好。它的大厂,像蓝宝石我之前提到的,包括华硕也好,包括讯景也好,它们的散热做得都是相当不错的。因为它们是消费级旗舰卡,就是 AMD 当年的顶配,做工是不用去怀疑的。
你在这种情况下买两张 7900 XTX,搭配一个寨板,甚至你们可以不要用 CD4,你们多花一点钱,去找好一点的、能够支持 PCIe 4.0 的平台板子。比如说现在不是有人在卖 AMD EPYC 搭配的洋垃圾套餐吗?板 U 套餐可能 3000 块钱左右,是吧?那你如果说为了双卡 TP 去买好一点、贵一点的板 U 套餐,我认为也是过得去的。你们可以去玩一玩。这个东西我认为它的难度又低,SGLang 的部署说实话必须要用 Docker,你如果是原生部署的话,那坑一大堆。但是 llama.cpp,尤其是你用 AMD 的 Vulkan,它甚至都不用编译,直接把它下载下来就能跑,而且你在本地编译它的难度也很低。
你想一想,你两张 7900 XTX,可以一张跑大模型,一张跑 MiniMax H3,协同工作。当你不需要生产视频的时候,你把两张卡组成 TP,张量并行,来跑本地大模型的吞吐,大量的吞吐。一边开发,前台一个任务、后台一个任务,或者一边开发发几个小任务,几个 Sub Agent 让它工作,这个体验会是相当好的。
当然,我现在还没有去买第二张 7900 XTX,因为我本地的显卡已经完全够用了。我有一张 4060 Ti 16G,平时跑一些小的画图任务,就长期挂着让它开着。然后我还有 7900 XTX,我还有 4090D 48G,那我的算力是完全足够了。就是在新的洋垃圾套餐,安培架构的 A100 大规模上市之前,我本地的算力是足够用的。
如果说未来这个算力荒变得廉价,存储荒变得廉价,那么硬件大幅度降价,那个时候我肯定也不会去买什么 RTX PRO 5000、6000 了,我肯定会去市场上面淘 A100,是吧?它同代的产品,安培架构的产品。我们本地目前还是不太需要一定要跑 FP8,一定要跑 NVFP4,没有这个需求。你知道吗?你看 MiniMax H3,是吧?你 INT8 的模型跑起来,性价比反而是最高的。我们就没有必要一定要走在这个市场的最前沿,有多少钱咱就消费什么样的卡,就不装逼,寻找对自己最有性价比的解决方案。
当然了,现在如果说大家问我还有什么有性价比的卡,我就建议你去论坛问论坛大神。我们这个频道自建立以来,这几个月以来,我给大家推荐的卡其实是可以一口气说完的。从入门开始,3080 20G 涡轮卡,你用来做单卡还是双卡 TP 都能玩。然后就是 3090,这个是神卡。当初我推荐的时候也就 6000 块钱,现在可能涨到 9000、10000 去了。然后 7900 XTX,当初我推荐的时候是 6100 块钱,后来降到 5000 块钱,现在又涨到 7000 块钱了。
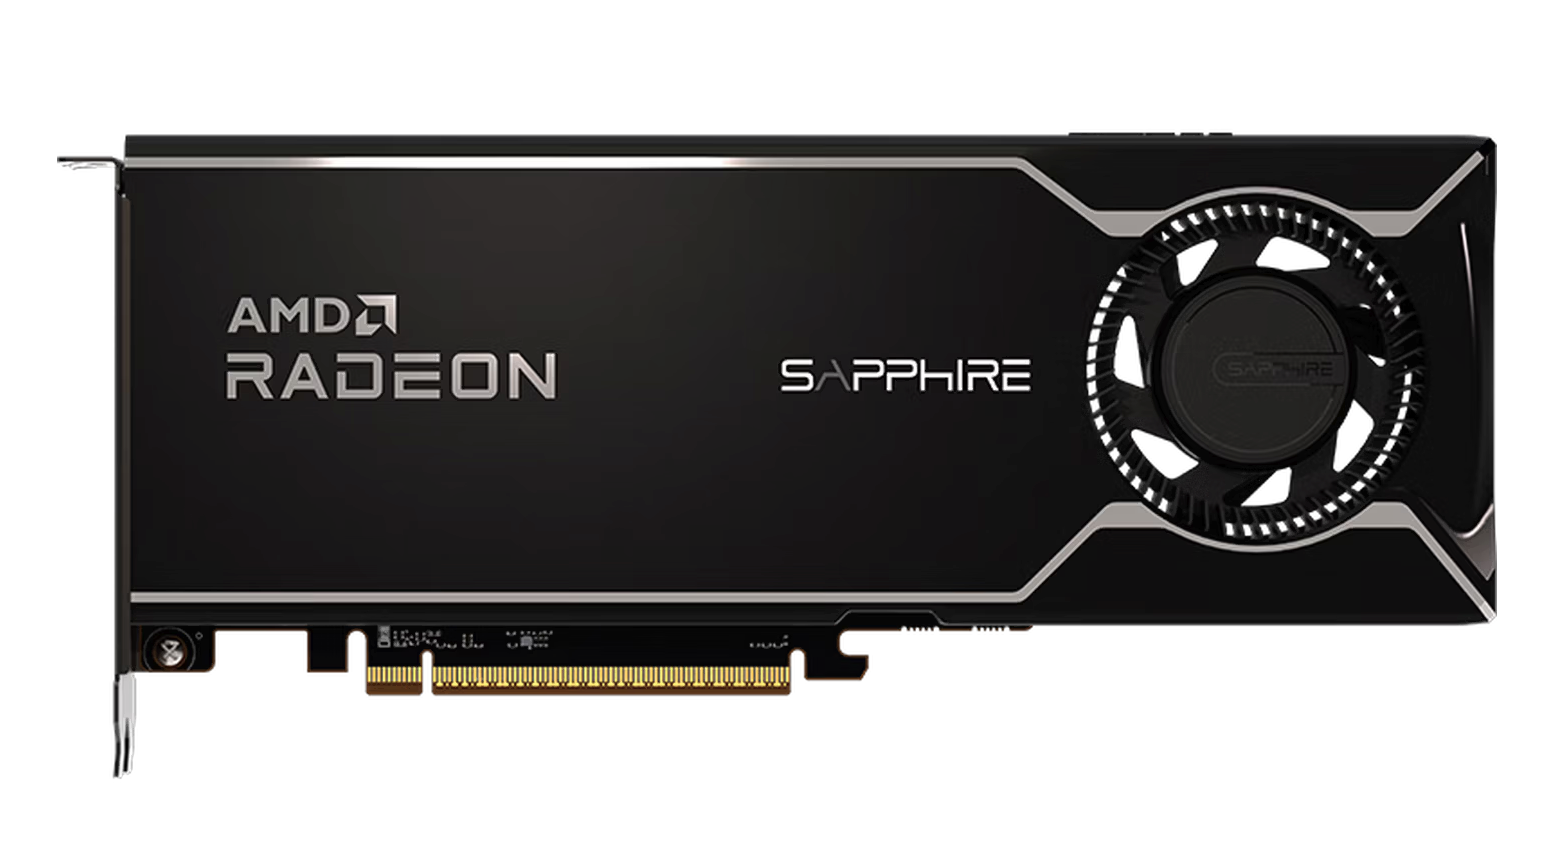
然后就是 AI PRO R9700,这个卡没怎么涨价,但是这个卡现在被证明,它确实也是非常有性价比的,这卡是很能扛打的,很扛打。然后是 4080S 32G 魔改卡,然后就是 RTX PRO 系列 4000、4500、5000,如果说你在乎品质的话,包括 6000 你都能买。然后 4090 48G,也包括 4090D 48G,其实是差不多的。
我明确不推荐的卡,比如说我当时明确举例说明出来,就是不要去买 5090 32G。因为你在国内这个东西一样是没有保修的,你必须要从京东自营去买。从京东自营去买的话,价格又很高,它比 4090D 48G 还贵。在大模型场景中,显存还是比算力要更加重要的。而且 5090 这张卡,我可以说你几乎是不可能避免它烧接口,甚至出现其他由于过热带来的这些问题。就完全不推荐。如果你想生产的话,如果你玩游戏可能无所谓,你要把它当作 AI 主力生产工具的话,我还是不推荐的。
你看,一共就这么几张卡,是不是?翻来覆去其实都是这些,没有什么新鲜的范式。我们要知道,算力市场现在一定是已经高度趋稳了,就是算力贩子知道什么卡值什么钱,然后买的人也比较精。这个市场是比较均衡的,没有什么捡便宜的事情。大家说什么,我去买 2080 Ti,我去买 V100,然后 MI210,然后我占了天大的便宜,扯犊子呢,怎么可能呢?市场就你聪明,卖的人没有你聪明?不可能的。
当然了,我也要纠正一下我之前在视频中对这些卡非常不屑的这种态度。是的,它们如果说对于新手来讲的话,确实是工业垃圾。但是如果说你在某些特殊的领域,就是用这个卡它就能完成你的任务,那不妨碍你们去买它、用它嘛。
好吧,本期视频就到这里,我们下期再见。
-
4080 32G魔改也行比4080S便宜几百
-
大概率是,但要分场景说。
R9700 32G 对 27B 级模型是「显存舒适区」:Q5_K_M/Q6_K + 128K 上下文能全量进显存。TID:1250 算过这笔账:Q5_K_M 权重 ~19GB + 128K 双 Q8 KV 8-10GB ≈ 28GB,24G 的 7900XTX 装不下,只能 Q4+128K 或 Q5+64K 二选一;R9700 32G 正好全装下。
7900XTX 的优势是带宽:960 vs 640 GB/s,纯 decode 快 30-50%,跑 MiniMax H3 视频生成、ComfyUI 更跟手。
价格上 7900XTX 这轮被炒到 7000+,R9700 是工作站卡、流通量小反而没被涨价潮带飞(TID:1291 里对比过:R9700 价格相对合理 + Linux ECC + ROCm 官方支持)。
结论:主力跑 27B 文本/Agent/长上下文 → R9700 更划算;要视频生成和高 tok/s → 7900XTX 的带宽优势值这个溢价。预算够又都想要,可以等 7900XTX 回落再入。
-
7900XTX都涨价了。。。那AI PRO R9700是不是反而更有性价比了?
7900XTX 蓝宝白金现在7500 9700蓝宝 12000
但7900xtx 显存带宽是 9700 的1.5倍