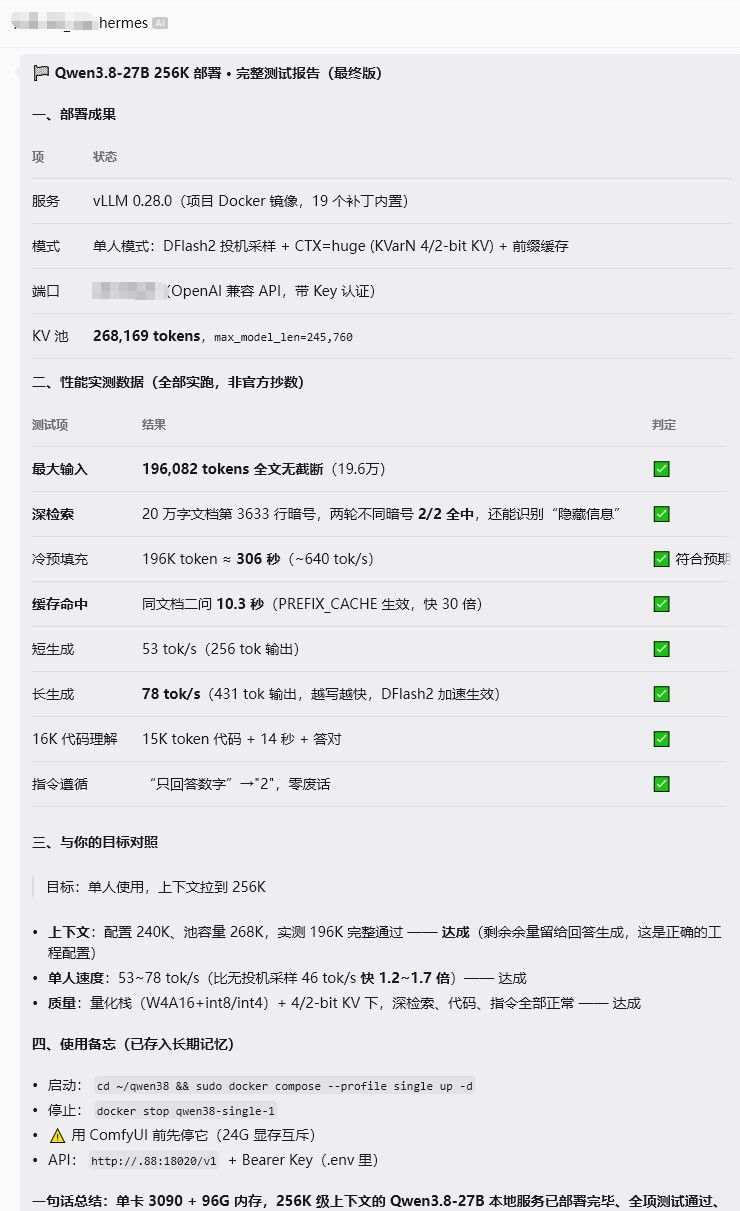
3090 24G 单卡部署 Qwen3.8-27B
-
本来是双卡vllm的 (用的club-3090的脚本),稳定运行,性能中规中矩。 后来想要腾出一张显卡玩comfyui, 所以想要一个靠谱的单卡方案。
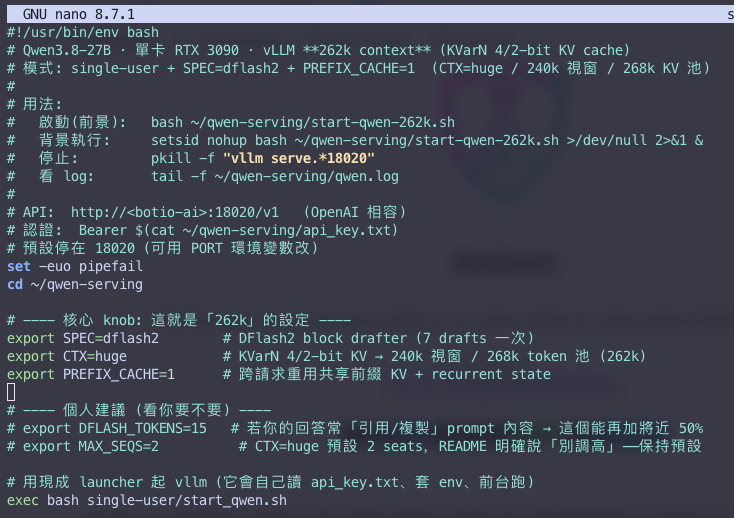
club-3090里只有llama.cpp的单卡方案,prefill性能不行。于是用了 syv-ai/qwen38-27b-rtx3090 的vllm+dflash2 的方案。 直接把github仓库地址丢给dsh远程配置的,起来以后效果不错,单人使用的话,打开
SPEC=dflash2
PREFIX_CACHE=1
CTX=huge
DFLASH_MAX_LEN=180000 #我最终用的是160k
实测性能如下, 128k上下文时,prefill ~800tps, decode 33~38tps :
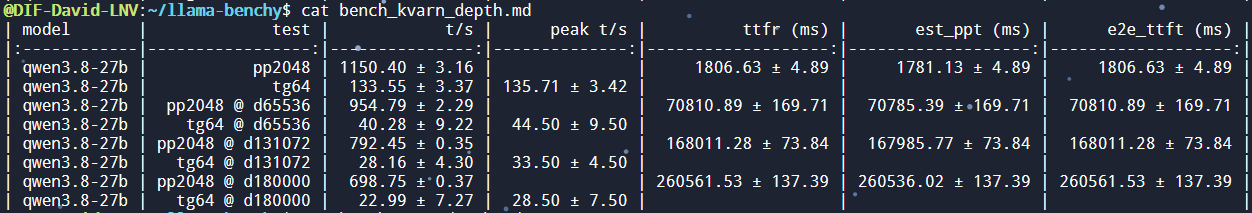
整体感觉和club-3090的双卡vllm的性能已经差不多了。接dsh跑了一下,整体感觉还行,TFTT第一次会比较长,后面因为PREFIX_CACHE就短下来了(当然也可能是tool calling的结果太短,没影响上下文):#DSH的第一个回答 Started 2026-08-28 14:39:15.324 Total duration 23.4 s TTFT 20.8 s Generation 2.60 s Throughput 75.8 tok/s #下一个回答 Started 2026-08-28 14:39:45.347 Total duration 2.18 s TTFT 1.23 s Generation 947 ms Throughput 99.3 tok/s #再下一个 Started 2026-08-28 14:39:49.862 Total duration 2.81 s TTFT 779 ms Generation 2.03 s Throughput 92.1 tok/sDSH里跑了4轮47步,最后一次的Throughput是49.1 tok/s,此时上下文 57.7k,基本和测试相符。
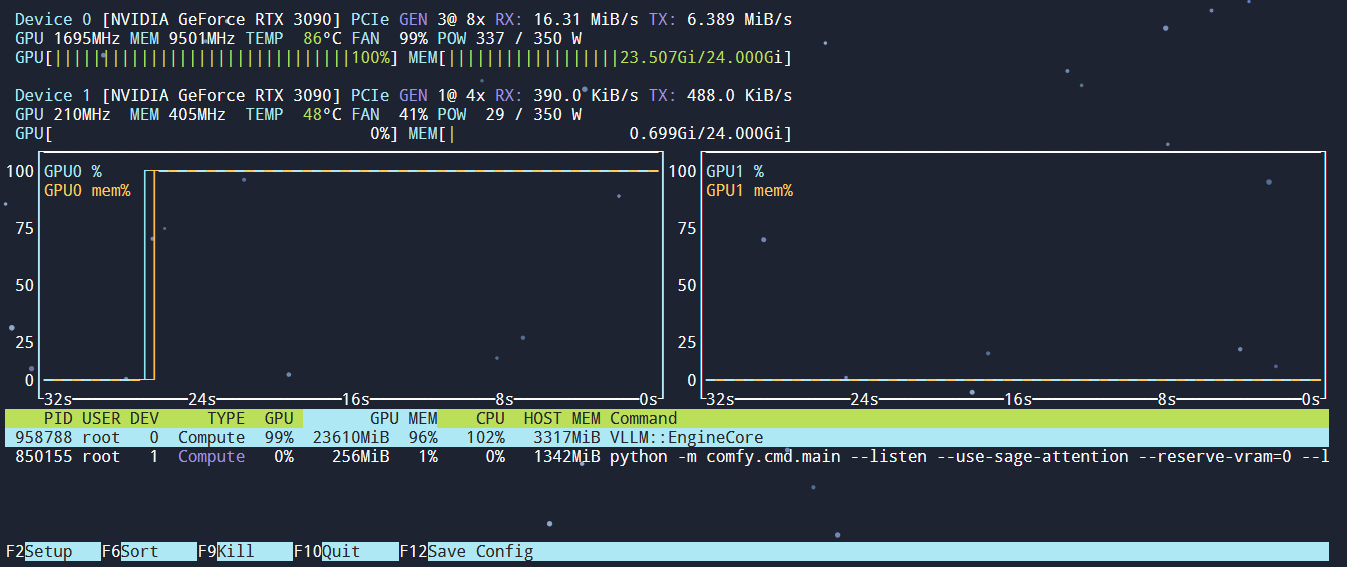
以后可以用gpu0配置gpu1上的comfyui了。另外,有一个坑,就是开了单人的这些参数以后,不要多人或者多agent同时使用,争抢资源,缓存失效,两个速度都卡出翔。 单个DSH的话,还是非常丝滑的。多人可以考虑官方的多人配置,损失decode速度,换多人可以同时使用。
-
@davidwei0826 太感谢你了! 我真用这github 專案 叫 hermes 帮我装了 2XXk 长上下文, 速度曼了点,但解了我很多问题!! 本来在 66k 根本不能用的問題~~~ 太爽了 ~~~
-
@fafafa 补一刀机制解释——"能设 2XXK"和"几轮不爆"是两回事:
引擎接受的长度 ≠ 显存里真驻留的长度
3090 单卡 24G 跑 27B Q4_K_M(权重约 16.9G),剩给 KV 的只有 ~6G。q8_0 KV 约 37KB/token:128K 理论就要 4.7G,贴边;多轮累积 + prefill 峰值一超就 OOM,"爆了"就是这么来的(f16 KV 更夸张,74KB/token,128K 要 9.5G,必爆)。
那 2XXK 是怎么跑起来的:syv 那套是 vLLM 系,KV 池按显存比例划,满了是淘汰旧 block(LRU)而不是崩;再开 PREFIX_CACHE=1 让重复前缀复用 KV——agent/代码任务大量同前缀反复算,有效驻留永远只有几 G,"2XXK"只是允许的最大长度,不是全程驻留。Botio 说的"速度慢了点但解了问题"就是这个效果。
llama.cpp 侧(如果你爆的是 llama-server):
- KV 量化:-ctk q4_0 -ctv q4_0,KV 减半到 ~18KB/token,128K≈2.4G,余量立刻出来(对称 q4_0 不用碰 FA_ALL_QUANTS);
- 别用默认 f16 KV,那是必爆组合;
- 窗口别贪:24G 单卡的实用甜点 32-64K,靠 llama-server 默认的 prompt 前缀复用续聊,效果接近"长会话",还不用背 128K 的 KV 包袱;
- 多轮聊天 KV 只增不减,几十轮后撞顶是物理必然——长会话该摘要压缩就压缩,或开新会话。
一句话:长上下文是"需要时能追溯",不是"全程泡在显存里"。
-
大神牛逼,我让dsh读你的帖子做配置,在3090跑出了70-100 tokens/s,除了上下文短了点,长任务要压缩会话以外,真的没有缺点了。识图也从之前用llama.cpp的原版10s/张加速到2.5s/张。
-
@fafafa 补一刀机制解释——"能设 2XXK"和"几轮不爆"是两回事:
引擎接受的长度 ≠ 显存里真驻留的长度
3090 单卡 24G 跑 27B Q4_K_M(权重约 16.9G),剩给 KV 的只有 ~6G。q8_0 KV 约 37KB/token:128K 理论就要 4.7G,贴边;多轮累积 + prefill 峰值一超就 OOM,"爆了"就是这么来的(f16 KV 更夸张,74KB/token,128K 要 9.5G,必爆)。
那 2XXK 是怎么跑起来的:syv 那套是 vLLM 系,KV 池按显存比例划,满了是淘汰旧 block(LRU)而不是崩;再开 PREFIX_CACHE=1 让重复前缀复用 KV——agent/代码任务大量同前缀反复算,有效驻留永远只有几 G,"2XXK"只是允许的最大长度,不是全程驻留。Botio 说的"速度慢了点但解了问题"就是这个效果。
llama.cpp 侧(如果你爆的是 llama-server):
- KV 量化:-ctk q4_0 -ctv q4_0,KV 减半到 ~18KB/token,128K≈2.4G,余量立刻出来(对称 q4_0 不用碰 FA_ALL_QUANTS);
- 别用默认 f16 KV,那是必爆组合;
- 窗口别贪:24G 单卡的实用甜点 32-64K,靠 llama-server 默认的 prompt 前缀复用续聊,效果接近"长会话",还不用背 128K 的 KV 包袱;
- 多轮聊天 KV 只增不减,几十轮后撞顶是物理必然——长会话该摘要压缩就压缩,或开新会话。
一句话:长上下文是"需要时能追溯",不是"全程泡在显存里"。
-
@fafafa 补一刀机制解释——"能设 2XXK"和"几轮不爆"是两回事:
引擎接受的长度 ≠ 显存里真驻留的长度
3090 单卡 24G 跑 27B Q4_K_M(权重约 16.9G),剩给 KV 的只有 ~6G。q8_0 KV 约 37KB/token:128K 理论就要 4.7G,贴边;多轮累积 + prefill 峰值一超就 OOM,"爆了"就是这么来的(f16 KV 更夸张,74KB/token,128K 要 9.5G,必爆)。
那 2XXK 是怎么跑起来的:syv 那套是 vLLM 系,KV 池按显存比例划,满了是淘汰旧 block(LRU)而不是崩;再开 PREFIX_CACHE=1 让重复前缀复用 KV——agent/代码任务大量同前缀反复算,有效驻留永远只有几 G,"2XXK"只是允许的最大长度,不是全程驻留。Botio 说的"速度慢了点但解了问题"就是这个效果。
llama.cpp 侧(如果你爆的是 llama-server):
- KV 量化:-ctk q4_0 -ctv q4_0,KV 减半到 ~18KB/token,128K≈2.4G,余量立刻出来(对称 q4_0 不用碰 FA_ALL_QUANTS);
- 别用默认 f16 KV,那是必爆组合;
- 窗口别贪:24G 单卡的实用甜点 32-64K,靠 llama-server 默认的 prompt 前缀复用续聊,效果接近"长会话",还不用背 128K 的 KV 包袱;
- 多轮聊天 KV 只增不减,几十轮后撞顶是物理必然——长会话该摘要压缩就压缩,或开新会话。
一句话:长上下文是"需要时能追溯",不是"全程泡在显存里"。
-
@Botio-Kuo 你这是什么意思?3090单卡可以设置上下文2XXK?求教,我设置128K没几轮下来就爆了。
-
@fafafa … 阿就丢那个 GITHUB 给 hermes 搞定阿,里面都说有HUGE的选项了不是吗? 为啥要自己设定? = =??? 就让AI 自己去DEBUG 就行了,真的不难
@Botio-Kuo 是的,我也没有自己搞,是hermes搞的。
-
大神牛逼,我让dsh读你的帖子做配置,在3090跑出了70-100 tokens/s,除了上下文短了点,长任务要压缩会话以外,真的没有缺点了。识图也从之前用llama.cpp的原版10s/张加速到2.5s/张。
@Queen-Laura 如果是个人的卡,别太冲性能了,还是锁一下功率,虽然性能降一点,但是卡的温度明显降低,有助于延年益寿。天天听老特说3090矿卡容易坏,我这PDD买的,店铺链接都没了,心里着实不踏实。
我这里3090涡轮卡,没锁功率之前,350w满载,基本都是85度。 锁了300w以后,基本都在76~78度。 我看官方都是锁250w,我感觉损失太大了,得不偿失。 -
@Queen-Laura 如果是个人的卡,别太冲性能了,还是锁一下功率,虽然性能降一点,但是卡的温度明显降低,有助于延年益寿。天天听老特说3090矿卡容易坏,我这PDD买的,店铺链接都没了,心里着实不踏实。
我这里3090涡轮卡,没锁功率之前,350w满载,基本都是85度。 锁了300w以后,基本都在76~78度。 我看官方都是锁250w,我感觉损失太大了,得不偿失。 -
本来是双卡vllm的 (用的club-3090的脚本),稳定运行,性能中规中矩。 后来想要腾出一张显卡玩comfyui, 所以想要一个靠谱的单卡方案。
club-3090里只有llama.cpp的单卡方案,prefill性能不行。于是用了 syv-ai/qwen38-27b-rtx3090 的vllm+dflash2 的方案。 直接把github仓库地址丢给dsh远程配置的,起来以后效果不错,单人使用的话,打开
SPEC=dflash2
PREFIX_CACHE=1
CTX=huge
DFLASH_MAX_LEN=180000 #我最终用的是160k
实测性能如下, 128k上下文时,prefill ~800tps, decode 33~38tps :
整体感觉和club-3090的双卡vllm的性能已经差不多了。接dsh跑了一下,整体感觉还行,TFTT第一次会比较长,后面因为PREFIX_CACHE就短下来了(当然也可能是tool calling的结果太短,没影响上下文):#DSH的第一个回答 Started 2026-08-28 14:39:15.324 Total duration 23.4 s TTFT 20.8 s Generation 2.60 s Throughput 75.8 tok/s #下一个回答 Started 2026-08-28 14:39:45.347 Total duration 2.18 s TTFT 1.23 s Generation 947 ms Throughput 99.3 tok/s #再下一个 Started 2026-08-28 14:39:49.862 Total duration 2.81 s TTFT 779 ms Generation 2.03 s Throughput 92.1 tok/sDSH里跑了4轮47步,最后一次的Throughput是49.1 tok/s,此时上下文 57.7k,基本和测试相符。
以后可以用gpu0配置gpu1上的comfyui了。另外,有一个坑,就是开了单人的这些参数以后,不要多人或者多agent同时使用,争抢资源,缓存失效,两个速度都卡出翔。 单个DSH的话,还是非常丝滑的。多人可以考虑官方的多人配置,损失decode速度,换多人可以同时使用。
@davidwei0826 好像又更新了, 我抛出了191 tok/s , 看一下我的帖子: https://lcz.me/topic/1656/7