
GLM 5.3 Flash让 DeepSeek V4 Flash跌落斩杀线?国产优秀模型很多,DeepSeek 一直被碰瓷,从未被超越!
-
最近有不少网友都在讨论,说这个 GLM-5.3 Flash,也就是 OX Alpha 这个模型,把 DeepSeek V4 Flash 给斩落马下,让它跌入了“斩杀线”。这个说法在我看来有点夸张了。其实我自己去研究了一下,如果是在低谷期,双方的输入输出价格都是 DeepSeek V4 Flash 更加便宜。更重要的是缓存命中价格,因为我们比如说执行 Agent 编程、长链任务,或者让它去执行一些脚本,那么缓存命中率基本上都在 99%,甚至是 100%。在这种情况下,你输入输出的价格都不重要,看的就是缓存命中价格。
DeepSeek 是 0.005 每百万 Tokens,然后 GLM-5.3 Flash 是 0.011,它比 DeepSeek 贵了一倍还多。如果是在白天,DeepSeek 的 API 价格,尤其是 V4 Flash,确实比 GLM-5.3 Flash 要高,但是缓存命中价格其实并没有什么差距。并且我们要知道,DeepSeek V4 Flash 是可以把思考全部关掉的,但是 GLM-5.3 是关不掉的,它必须强制使用一部分思考资源。那么这个思考推理的过程本身是不能作为缓存命中的,它要作为输出来计入总价。
而且我之前不是说了吗?我说在测试中,这个 GLM-5.3,也就是 OX Alpha 那个模型,它智力上是比 V4 Flash 要高一点的,但是低于 DeepSeek V4 Pro。但是我忘记了跟大家讲一个重要的前提,就是我一直是把 V4 Flash 的思考过程完全关掉的,然后我在测试 GLM-5.3 的时候,使用的是它默认的思考模式。当时我在视频中说,它的智力确实比 V4 Flash 要强,但是它慢了很多,就是完全不具备实用价值。后来我就测试了一下,把这个思考模式关低,发现它立刻就变成了傻逼,它就变成了另外一个模型。
说白了,GLM 走的还是 Anthropic 的那个路线,就是把 Harness 工程内置到 API 内部。这样可能会让这个 API 看起来很聪明,然后能够跑高分,但是这是一条邪路。我说实话,这是一条不归路。我不知道 GLM 为什么要在这个时候采用这么一个不明智的方法。同样采用这种方法的还有一家,就是千问 3.8 Flash。
我实在不能明白,你阿里巴巴已经有千问 3.8 27B FP8,或者说这个 4 比特量化模型,都能在 SGLang 上面本地部署,跑出来非常好的成绩,你干嘛要去搞一个在模型内部过度思考的千问 3.8 Flash?然后弄一个什么 125B A6B 模型,又号称它秒杀了千问 3.8 27B,又秒杀了 DeepSeek V4 Flash。结果跑一个任务,一个非常简单的脚本任务,你要十几分钟,然后还失败了。是不是因为如果不把你关掉的话,你可能要跑一天?或者说跑一个简单的网页生成任务,你就要花 20 分钟。你说你走这样的路线,它有意义吗?
然后我再回到价格对比上来讲,现在的一切价格对比都还是基于 GLM-5.3 在 9 月 9 号之前打 5 折。不是 0.5 折,0.5 折就骨折了,是打 5 折。9 月 9 号它要恢复价格,那个时候它会比 DeepSeek V4 Flash 贵得更多。
也就是说,我希望我们国产模型之间的竞争,就是真刀真枪地去干,不要把电子产品圈子里的这种饭圈文化带到大模型领域,这样非常无聊。你说自己的大模型进步,你可以说自己的大模型进步。GLM 我认为是国产非常优秀的模型之一,你可以说自己牛逼,我们也愿意支持国产,但是你不要说自己牛逼的同时去打压别人,说别人被你给斩落马下,搞这些水军在网络上搞什么舆论营销,就非常无聊,知道吗?
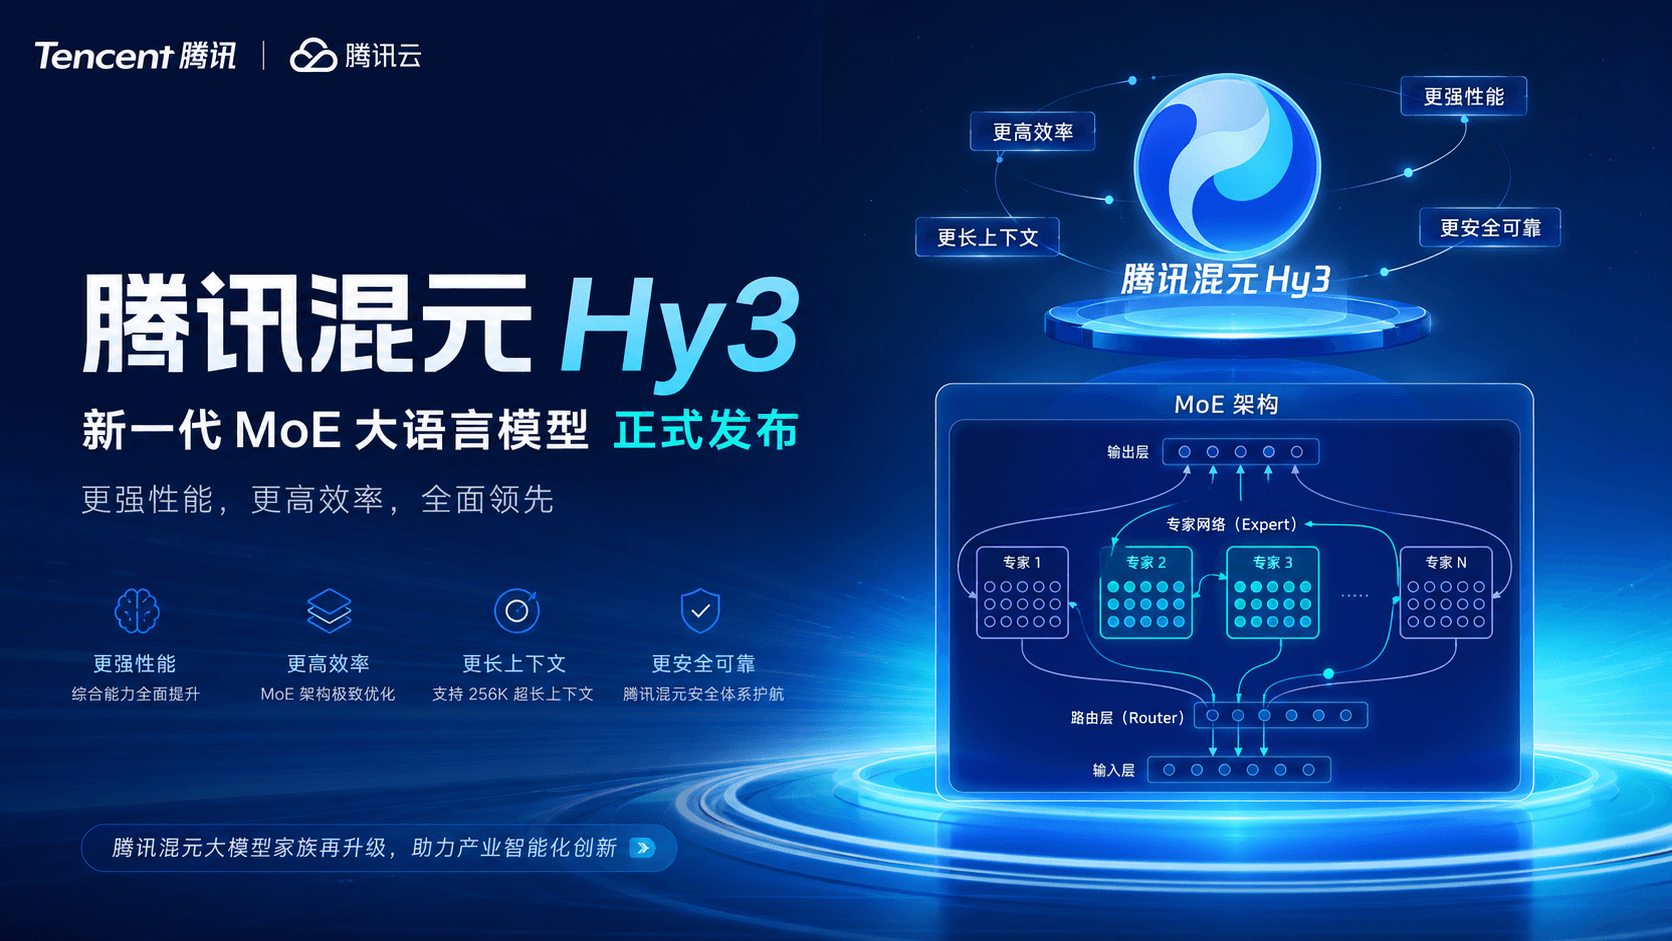
当然了,这个话说得有点过了。就是针对这些我在网上看到的贬低 DeepSeek,然后抬高 GLM 的这种说法,我是有感而发,说了一些重话。在我心中,我比较喜欢的国产模型有几个,DeepSeek V4 Flash 算一个,GLM 绝对算一个,另外一个就是腾讯的混元 3。
混元 3 现在主要的问题就是它没有多模态。之前 DeepSeek V4 Flash 没有多模态的时候,我做很多任务,跟大家在视频中明确讲过,我是用小米的模型的,用小米的 MiMo。我个人认为 MiMo V2.5 版本做得就非常好,虽然它在编程、Agent 方面跟 DeepSeek V4 Flash 不能比,但是它的统一多模态在很多场景我都需要用到。
混元 3 是我认为所有模型中最像 DeepSeek V4 Flash 的,就是它的上下文召回准确率非常高。然后这个模型的编程效率,包括对于 Agent 场景的适配度也是非常高的。但是它可能需要在参数上面再进行进一步的打磨,比如说上下文你起码要搞到 1M,然后多模态原生还是要支持的,甚至我觉得多模态能力可能比 1M 上下文更加重要。
然后我就必须要说,DeepSeek 这家公司是中国非常特殊的一家公司,甚至放在全世界,它也是最特殊的公司。它在一炮而红,也就是 V3.2,包括 DeepSeek R1 一炮而红,造就了这个 DeepSeek Moment 之后,并没有急着去发布下一代的模型,相反它是去打磨底层。
它之前在搞 DeepSeek V3 的时候,不是在用 PTX 重写 CUDA 底层算子吗?后来它就把 PTX 跟 CUDA 都抛弃了,用国产的、北大研发的 TileLang 这个底层胶水语言重构底层。这样做的好处就是说,它牵扯到华为、寒武纪、海光、摩尔线程这些国产芯片的时候,难度要小得多。果然经过一年的打磨,它今年把推理集群大规模转向华为的昇腾 950 系列之后,效率并没有受到影响,相反整个公司的业务总量有很大的提升。
另外,它还搞了 HCA、CSA 注意力机制,这些都是开源的论文,但是它只是把论文公开了,包括 Engram 架构。它把 N-Gram 算法也公开开源了,但是没有告诉你具体的工程实现。HCA 跟 CSA 是干什么的呢?就是混合注意力机制,它能够保证长上下文,比如说大海捞针的准确率。
很多模型虽然标称 1M 上下文、2M 上下文,尤其是谷歌的这些模型,动不动就标称 2M 上下文,实际上超过 500K 基本上就变成傻逼了,甚至 256K 之后就不行了。但是 DeepSeek 的 1M 上下文是实打实的,我在之前的视频中多次给出过截图。我跑到了 700K 上下文之后,它依然非常稳定。这个在我用过的所有模型中,我不是吹牛逼,就是独一无二,就是唯一一个在我能够明确看到它用了多长上下文的情况下,在 700K 之后还非常稳定、没有崩的。这个就是实打实的硬实力。
然后这个 Engram 架构是干什么的呢?就是说它可以把一些静态的知识权重放到内存或者 SSD 中,不必占用昂贵的 HBM 显存。并且它不仅可以放静态知识权重,也可以把 KV 缓存卸载到内存和 SSD 中去。一般来说,我们平时用到的内存,比如 DRAM,它的价格大概是同容量 HBM 的 1/5 左右,那么 SSD 比起 DRAM 就要更便宜了。
它的一个重要合作伙伴 SGLang,这段时间不是推出了 HiCache 吗?HiCache 就是把冷的 KV 缓存从显存中卸载到内存中,甚至卸载到 SSD 中。它跟 DeepSeek 是深度合作的。DeepSeek 能够爆火,跟 SGLang 对它第一时间的支持有很大的关系。当然我说的是开源社区,并不是说 DeepSeek 官方。我说的是它的开源权重能够第一时间爆火,跟 SGLang 的支持有很大的关系。
然后 SGLang 能够走到今天这个地位,成为事实上的各大芯片公司发布芯片架构时候的 Benchmark,甚至成为很多中小企业优先的部署推理架构,那么它跟 DeepSeek 对它的支持也是有很大关系的。它总是能够第一时间拿到 DeepSeek 对它的支持,能够提前拿到权重、提前适配,然后发布的时候就第一时间享受流量红利。
如果说 SGLang 掌握了这样的技术,这个技术相对于 DeepSeek 的技术而言,门槛是要低得多的,那么 DeepSeek 肯定也是在用类似的技术。就这一整套东西,它的原理论文全部是开源的,放在网上,但是你能不能抄会,那就很难讲了。
比如说我之前提到的千问 3.8 Flash,阿里巴巴官方就大方地承认,他们这个 N-Gram 模块就是参考了 DeepSeek 开源的 N-Gram 算法。但是问题是你只学到了这一块,你没有学到 HCA、CSA 注意力机制,没有学到 DeepSeek 对于 MoE 路由的高效调度技术。这些工程化技术你都没有,你就匆匆地把这个模型发布了,最终导致的结果就是你的模型是节省了资源,用不太多的资源就能够跑起来,它的智力也在线,但是它的路由调度,包括推理效率,就有灾难性的影响,导致你执行一个任务需要花很长的时间。一个非常小的生成网页的任务,你就要花十几分钟、20 分钟,否则的话,它生成的质量就非常低。
所以说这个低价,讲实话,我在之前的视频中反复强调过,它不是一个说你想低价你就能低价的东西,它不是一个入门的技术。相反,在模型智力差距不太大的情况下,低价甚至是核心的技术、核心的护城河。
DeepSeek 爆火以来,我们中国出现了很多模型,包括 Kimi 也好、MiniMax 也好、GLM 也好,包括小米也好、腾讯的混元也好、阿里巴巴的千问也好,大家都是在不同的时间段喊出要把 DeepSeek 斩落马下。可问题是,这么长时间过去了,DeepSeek 还是 DeepSeek。每一次能够震动全球开源圈子的就是 DeepSeek,你们的影响力就是跟 DeepSeek 没法比。这个是硬实力,你不服是不行的。
少一点炒作,每个模型都有自己的特点。比如说 Kimi K3,人家就是能够跟 Anthropic、OpenAI 去比跑分,也能够跟它们在某些场景下比应用实力。虽然 API 也比较贵,但是比起 AO 两家,它还是便宜的嘛。
再比如说 GLM,我也不是说这家公司就一无是处,我还是特别喜欢它的,因为它对于国产算力的支持总是第一时间就搞定。它的图片模型已经完全基于华为的昇腾集群来训练了。然后前一阵子 OX Alpha 这个模型不是爆火吗?在 OpenCode 上面有大量的消耗,它的这些集群,官方说了是用华为的推理集群,并且后续的训练都要转向国产算力。而且它还到处散布消息,说要用什么国产的万卡、10 万卡集群资源。
都是国产大模型,而且 GLM 在编程这一块确实有它的独到之处。它自家的 IDE,是不是叫什么 ZCode,据说反响也挺不错的。就相互盼着对方一定好,不要把什么小米跟华为的这种饭圈文化带到大模型领域,就非常俗。一个“遥遥领先”,一个永远是“年轻人的第一台车”“第一个笔记本”“第一部手机”,真的是完全没有必要,知道吗?
就像我本人对于余大嘴、对于雷布斯,其实说实话我都不太喜欢,但是他们的产品好的时候,我也是给他们点赞的。就是不要在宣称自己厉害的时候去踩踏其他公司,尤其是在你的实力,说实话,如果客观地来讲,你这个 GLM-5.3 Flash 跟 DeepSeek V4 Flash 的差距是有的,是存在的。不是说两个是完全同等级别、同等性价比的模型,这个不符合客观事实。你现在依靠免费,调用量比较牛逼,但是讲实话,也只是个阶段性的现象。
然后我也是跟我评论区,包括论坛的很多观众都说,你们如果有精力,去研究各种各样的大模型也好、API 也好,这个是可以的。但是你们选用哪个模型,肯定有自己的考虑。你不要发帖去嘲笑用其他 API、用其他模型的人,说别人傻逼,就他妈你聪明。
有钱在人家手里面花,人家愿意用 Claude,有他的理由;愿意用 GPT,有他的理由;愿意用 Kimi、用小米 MiMo,还是 MiniMax,或者是 GLM、DeepSeek、混元,也都有自己的考量。你可以说,我认为我的这个模型比你这个模型有性价比,然后什么场景、什么原因,一二三列出来,可以装逼,可以讨论。但是你不要上来就说别人用的模型不行,就你聪明。
尤其是很多模型厂商,你要把核心的竞争思路放到提升模型的效率、提升模型的性价比上来讲。之前我还忘记提了,DeepSeek 还在搞 MTP 投机解码,它搞了一个叫 DSpark 的东西,这个对于降低成本、提升吞吐量又有很大的帮助。人家是在实实在在地搞研发。你 AI 大模型企业就得搞这个东西,把架构打磨好,把推理效率弄上来,把体验弄好。
你说千问 3.8 27B,我们拿阿里巴巴举例。我在本地部署之后,社区调好了之后,确实可以把它的思考关掉,响应非常迅速,然后又能够给我执行长链的编码任务。我无论是 7900 XTX 加上 llama.cpp 来驱动它的 4 比特版本,还是用 SGLang 加上 4090 48G 来驱动它的 FP8 版本,我得到的体验都是非常好的。
那么就不用你们去宣传,我也会在视频中讲,这个模型虽然比 DeepSeek V4 Flash 要差一点,但是它毕竟是在本地部署,它不要钱,并且 DeepSeek V4 Flash 能够完成的工作,它都能够完成。那么这样的评论不比你去黑 DeepSeek 好吗?
你去拿一个千问 3.8 Flash,这种他妈慢得跟屎一样的模型,在前面的跑分上进行对比,说你跑分超过 DeepSeek V4 Flash,超过什么 Claude Opus 4.6 Max。虽然我非常不喜欢 Anthropic 这家公司,但是你拿你这个狗屎模型跟他妈 Opus 4.6 比,这就是侮辱别人,知道吗?而且你是在侮辱观众的智商。
当然,每次对着镜头录视频,就有点搂不住,往往容易讲偏,情绪会比较激动。这并不是说因为我特别喜欢 DeepSeek,或者特别喜欢千问 3.8 27B,我的看法就不容别人怀疑、不容别人驳斥。而是真的说实话,有的时候我真的是希望我们搞技术的就踏踏实实搞技术,不要把一些不良现象引入到我们这个技术圈子里。
生活本来就挺累的,一天到晚搞这些勾心斗角的事情干什么呢?吹牛能够强身吗?人家说“手淫强身,意淫强国”,真的能做到吗?没必要。好吧,本期视频就到这里,我们下期再见。
