-
-
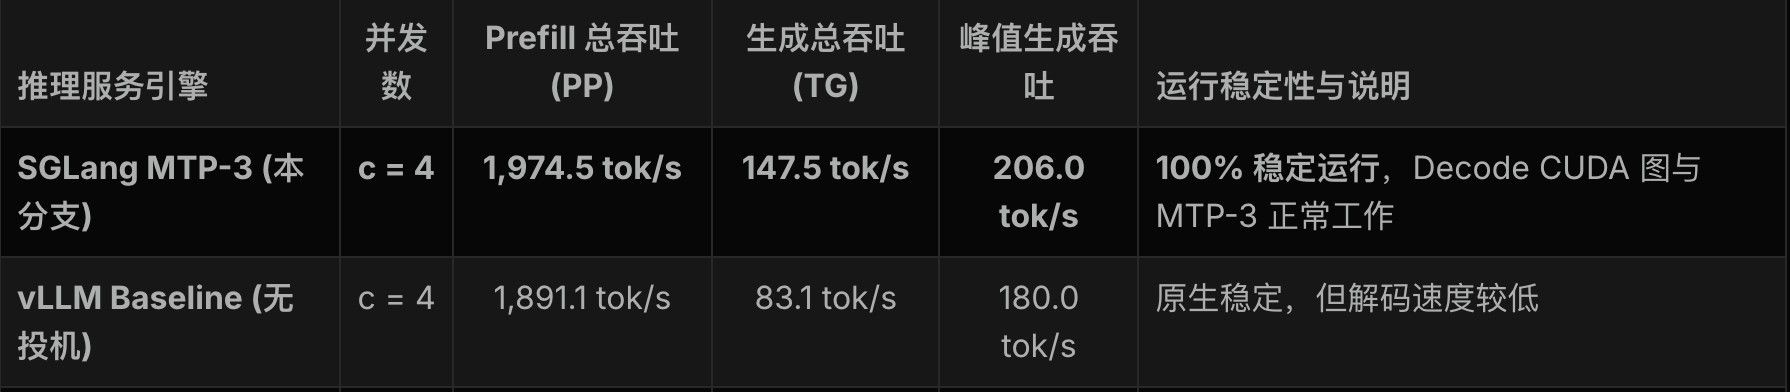
我是双卡的,经过测试速度vllm满意多了,
这是30k左右上下文的速度
[2026-09-09 19:50:38 TP0] Decode batch, #running-req: 1, #full token: 33103, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.77, accept rate: 0.59, cuda graph: True, gen throughput (token/s): 60.85, #queue-req: 0
[2026-09-09 19:50:39 TP0] Decode batch, #running-req: 1, #full token: 33215, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.85, accept rate: 0.62, cuda graph: True, gen throughput (token/s): 62.58, #queue-req: 0
[2026-09-09 19:50:41 TP0] Decode batch, #running-req: 1, #full token: 33332, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.88, accept rate: 0.62, cuda graph: True, gen throughput (token/s): 62.95, #queue-req: 0
[2026-09-09 19:50:43 TP0] Decode batch, #running-req: 1, #full token: 33434, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.55, accept rate: 0.52, cuda graph: True, gen throughput (token/s): 55.82, #queue-req: 0
[2026-09-09 19:50:45 TP0] Decode batch, #running-req: 1, #full token: 33542, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.73, accept rate: 0.57, cuda graph: True, gen throughput (token/s): 59.54, #queue-req: 0
[2026-09-09 19:50:47 TP0] Decode batch, #running-req: 1, #full token: 33665, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.10, accept rate: 0.70, cuda graph: True, gen throughput (token/s): 66.78, #queue-req: 0
[2026-09-09 19:50:49 TP0] Decode batch, #running-req: 1, #full token: 33810, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.62, accept rate: 0.88, cuda graph: True, gen throughput (token/s): 79.26, #queue-req: 0
[2026-09-09 19:50:50 TP0] Decode batch, #running-req: 1, #full token: 33943, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.33, accept rate: 0.78, cuda graph: True, gen throughput (token/s): 72.62, #queue-req: 0
[2026-09-09 19:50:52 TP0] Decode batch, #running-req: 1, #full token: 34081, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.38, accept rate: 0.79, cuda graph: True, gen throughput (token/s): 73.58, #queue-req: 0
[2026-09-09 19:50:54 TP0] Decode batch, #running-req: 1, #full token: 34213, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.38, accept rate: 0.79, cuda graph: True, gen throughput (token/s): 73.63, #queue-req: 0
[2026-09-09 19:50:56 TP0] Decode batch, #running-req: 1, #full token: 34358, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.62, accept rate: 0.88, cuda graph: True, gen throughput (token/s): 79.04, #queue-req: 0
[2026-09-09 19:50:58 TP0] Decode batch, #running-req: 1, #full token: 34485, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.12, accept rate: 0.71, cuda graph: True, gen throughput (token/s): 68.08, #queue-req: 0
这是64k上下文左右的 [2026-09-09 19:59:43 TP0] Decode batch, #running-req: 1, #full token: 67798, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.40, accept rate: 0.80, cuda graph: True, gen throughput (token/s): 62.86, #queue-req: 0 [2026-09-09 19:59:45 TP0] Decode batch, #running-req: 1, #full token: 67933, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.38, accept rate: 0.79, cuda graph: True, gen throughput (token/s): 62.37, #queue-req: 0 [2026-09-09 19:59:47 TP0] Decode batch, #running-req: 1, #full token: 68056, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.08, accept rate: 0.69, cuda graph: True, gen throughput (token/s): 56.86, #queue-req: 0 [2026-09-09 19:59:49 TP0] Decode batch, #running-req: 1, #full token: 68170, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.92, accept rate: 0.64, cuda graph: True, gen throughput (token/s): 53.99, #queue-req: 0 [2026-09-09 19:59:52 TP0] Decode batch, #running-req: 1, #full token: 68298, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.20, accept rate: 0.73, cuda graph: True, gen throughput (token/s): 59.00, #queue-req: 0 [2026-09-09 19:59:54 TP0] Decode batch, #running-req: 1, #full token: 68418, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.00, accept rate: 0.67, cuda graph: True, gen throughput (token/s): 55.36, #queue-req: 0 [2026-09-09 19:59:56 TP0] Decode batch, #running-req: 1, #full token: 68532, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.77, accept rate: 0.59, cuda graph: True, gen throughput (token/s): 51.23, #queue-req: 0 [2026-09-09 19:59:58 TP0] Decode batch, #running-req: 1, #full token: 68636, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.60, accept rate: 0.53, cuda graph: True, gen throughput (token/s): 47.93, #queue-req: 0 [2026-09-09 20:00:00 TP0] Decode batch, #running-req: 1, #full token: 68729, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.35, accept rate: 0.45, cuda graph: True, gen throughput (token/s): 43.04, #queue-req: 0 [2026-09-09 20:00:02 TP0] Decode batch, #running-req: 1, #full token: 68822, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.30, accept rate: 0.43, cuda graph: True, gen throughput (token/s): 42.36, #queue-req: 0 [2026-09-09 20:00:05 TP0] Decode batch, #running-req: 1, #full token: 68901, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.05, accept rate: 0.35, cuda graph: True, gen throughput (token/s): 37.75, #queue-req: 0 [2026-09-09 20:00:07 TP0] Decode batch, #running-req: 1, #full token: 69001, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.48, accept rate: 0.49, cuda graph: True, gen throughput (token/s): 45.58, #queue-req: 0 [2026-09-09 20:00:09 TP0] Decode batch, #running-req: 1, #full token: 69130, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.25, accept rate: 0.75, cuda graph: True, gen throughput (token/s): 59.83, #queue-req: 0 [2026-09-09 20:00:11 TP0] Decode batch, #running-req: 1, #full token: 69247, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.85, accept rate: 0.62, cuda graph: True, gen throughput (token/s): 52.28, #queue-req: 0使用codex和用dsh和hermes调用的话非常舒服
-
@flyer666 顶礼膜拜flyer666 大神,上次看了您 8/23 发的帖子《双卡 7900 XTX VLLM 跑 Qwen3.8,爽玩 Agent,PP1600 / TG160+(附 MTP / 7900 XTX 全攻略)》之后,我也照着折腾了一套双卡部署。
从之前单卡 llama.cpp Vulkan,到现在双 7900 XTX TP2,体感真的是“一步登天”。不光速度上去了,并发、长上下文、Agent 实际使用体验也完全不是一个级别,确实让我第一次很直观地体会到 1+1 > 2 的感觉。
听老特周末的视频,马上搜到了这个帖子,花了三天时间狠狠折腾了一轮 SGLang,短 benchmark 一度非常惊艳,但真实多 Agent 长上下文用下来踩了一个挺大的坑,也顺手做了一轮比较完整的排查,想把结果发出来给大家参考,也希望有高人能够指点一二。
SGLang 的短 benchmark 确实非常漂亮,C4 aggregate decode 能跑到 200 tok/s 左右,一开始我还挺满意。
但真正拿去跑 Hermes / 多 Agent 以后,体验完全不是一回事:一个长上下文请求开始 prefill,另外一个正在回复的 Agent 会直接“冻住”几十秒。反复优化排查,甚至尝试了最新的RCOM10,问题依旧,表现就是一开始三并发甚至四并发都是飞一般的速度,堪比DSF,但是对话和跑任务几轮后就体会到了明显的卡顿,甚至所有的并发全部卡死(假死,后台排队但是token速度降到10几甚至个位数)。
我后来折腾ChatGPT和DeepSeek做了一系列测试,ChatGPT告诉我基本把问题钉死了。所以目前我的选择很简单:生产切回前一个帖子介绍的vLLM, 目前是Int8 KV 192K上下文三并发,设置65%的压缩阈值,可以做到两个并发跑满,另外一个并发用作本地识图(小上下文)。为什么不用Int4 KV?是因为开满三并发或者四并发的速度体验下降太大,而且测下来Int8反而是速度上的甜点,反正我两个本地推理+1个本地识图服务足够了。
说回到SGLang我踩得坑,我的环境大概是:
2× RX 7900 XTX,TP2
Qwen3.8-27B W4A16 GPTQ
SGLang gfx1100 fork
BF16 KV
192K context
MTP3 / EAGLE
FCFS scheduler
chunked prefill 4096最典型的一组测试
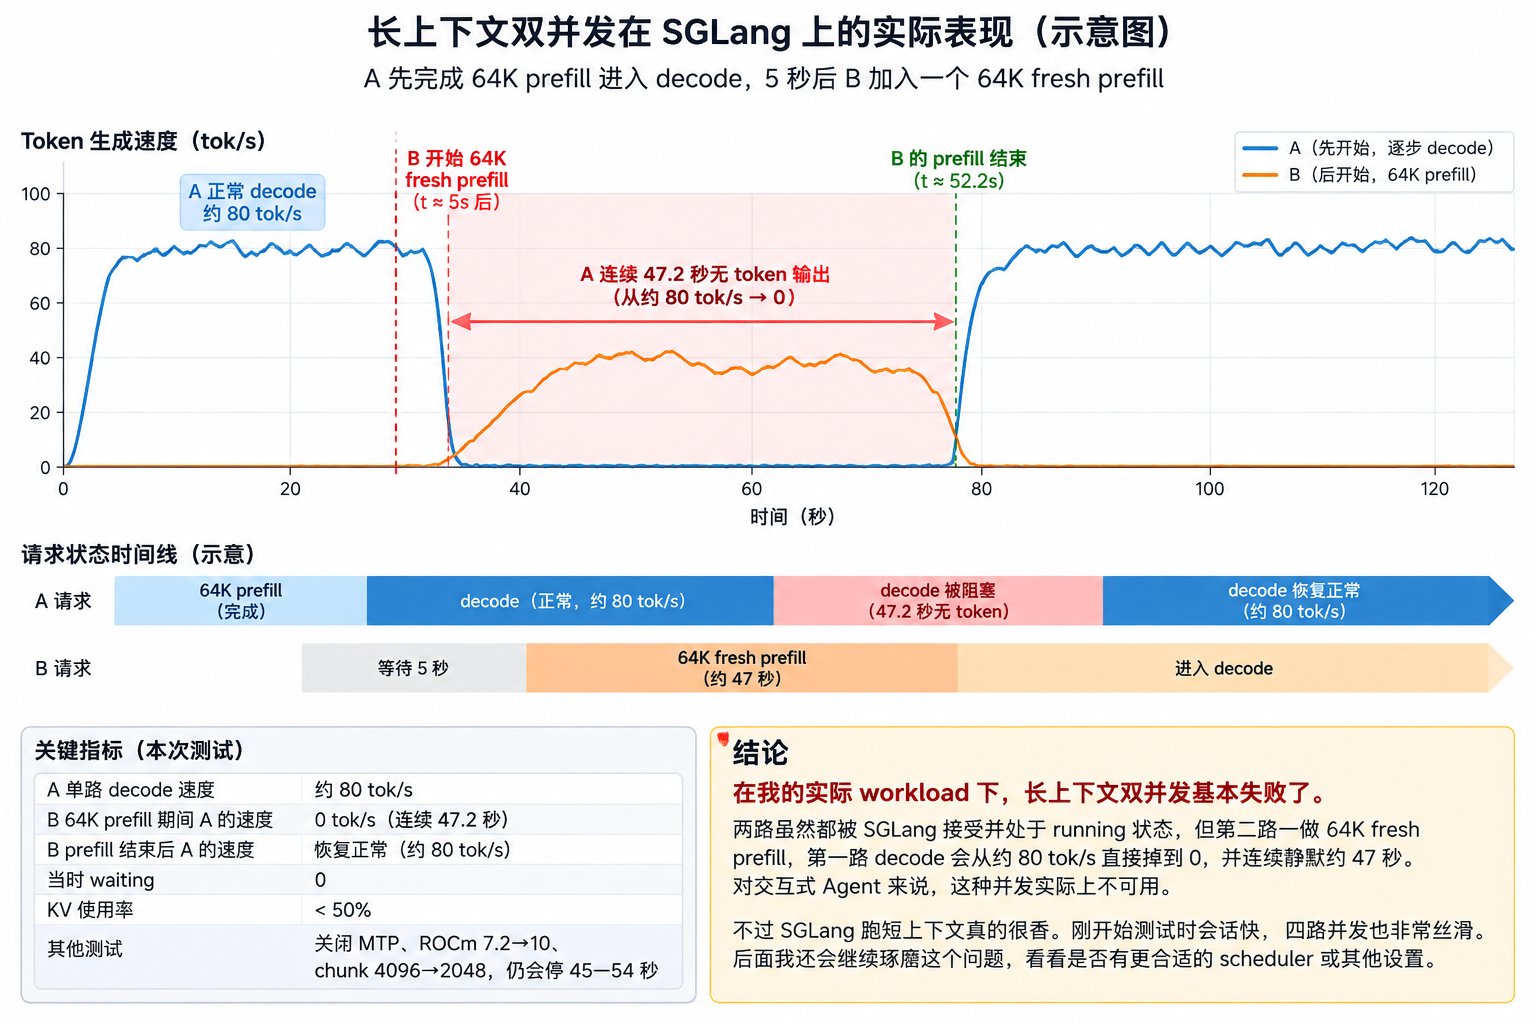
先让 A:64K prefill → 开始正常 decode
等 5 秒,再让 B 加入:64K prefill
结果:
A 最大无 token gap:47.226 秒
B TTFT:49.434 秒
A 的停顿覆盖了 B prefill 时间的 95.5%
waiting=0
KV peak 只有 49.76%也就是说:
不是 KV 不够,也不是请求排队。B 在做 64K prefill 的时候,A 基本整整 47 秒不吐一个 token。
这就完全解释了为什么 benchmark 看着很猛,实际多 Agent 用起来却很“卡”。
三并发更明显:
A 最大停顿:67.736 秒
B 已经开始回复后又停了:18.468 秒
C TTFT:64.945 秒
KV peak 也才 62.22%所以这不是“显存撑爆了”的问题。
我又把几个最可能的原因逐个排了一遍
MTP?
关掉 MTP/EAGLE,其他不动:
MTP3:A gap 47.226s
MTP OFF:A gap 45.051s只改善大约 4.6%。
所以 MTP 不是主因。
chunk 太大?
把:
4096 → 2048
结果:
4096:47.226s
2048:48.913s基本没区别。
ROCm 版本?
这个我也折腾得比较彻底,7.2、7.14、ROCm 10 nightly 都实际跑过。
短 benchmark 里 ROCm 10 hot run 有时候确实快一点,之前 C4 decode 大约能看到几个百分点的优势;7.14 没表现出什么特别明显的好处。
但放到真正有问题的 long-context workload:
ROCm 7.2:A gap 47.226s
ROCm 10 nightly:A gap 54.234sROCm 10 这次反而更慢,因为 64K prefill 本身更慢,结果 A 被“冻住”的时间也跟着变长。
所以至少在我这套环境里:
升级 ROCm 并不能解决这个问题。
它可能改变 prefill/kernel 的原始速度,但没有改变“prefill 期间 concurrent decode 被饿死”这个行为。
网上也有一些很接近的 SGLang issue
我后来查了一圈,发现这个方向并不是完全没人碰到。
比较值得看的有:
SGLang #32549:持续 chunked prefill 时出现 decode starvation,和我的现象最接近。
Discussion #27762:讨论新 prefill 如何严重影响正在运行的 decode,以及如何优先保护 decode。
#35537:chunked-prefill scheduler 里也出现过 starvation / waiting request 长时间得不到调度的问题。
#34676:Hybrid/Mamba 模型的 prefill/cache/scheduler 路径也有相关问题。
#38319:Qwen3.8 + chunked prefill + Radix Cache 还有另外的 race/cache 问题。这些 issue 不一定和我这个 47 秒 stall 是完全同一个 bug,但至少说明 SGLang 最近这一块 scheduler / chunked-prefill / hybrid model 的路径确实还有不少边角问题。
我最后的结论:
我现在比较确定的一点是:短 PP + C4 aggregate tok/s,不能代表真实多 Agent 体验。
以前我测:
PP≈2K
C4数字非常好看。和帖子里的数值基本一致。
但现实是:
A 已经在长上下文里回复
+
B 突然带着 64K/100K 历史进来,然后两边卡几分钟。。。这才是 Agent 的真实 workload。
所以以后我测 serving engine,一定会加这一条:
A: 64K → 开始 decode
5 秒后
B: 64K prefill然后看:A max no-token gap
我的 SGLang 现在实测的结果是:47 秒。就是说我的B会话要等将近一分钟。这还只是64K,大家都知道Hermes启动阶段可能就不止这个数量级了,何况是几轮后上下文滚动到100K+。
所以这一轮的学习,就是这个实测数字对我来说,已经比“C4 200 tok/s”实用得多了。
罗嗦一大圈,最后总结一下:
之前 vLLM 已经连续用了两个星期,和云端大模型搭配着用,整体效果其实已经非常满意了。同样是多 Agent、长上下文的使用方式,vLLM 基本没有出现过这种“一个长 prefill 一进来,另外一路直接冻住几十秒”的情况,日常体感明显更顺。
这段时间在论坛里跟老特和各位高手确实学到了太多东西。7900XTX就是给老特给安利买的。R9700我嫌声音太吵让我给退了然后价格猛涨后悔不迭,然后最近学到单卡 Vulkan 能把本地模型更顺滑得在7900XTX上跑起来,我就已经喜出望外了;看了flyer666大神的帖子马上又买了一张7900XTX组双卡折腾 vLLM、TP2、MTP、长上下文和多并发,才发现这张2022年发布的AMD显卡居然还能玩得这么溜,性价比拉满。
大家可能都比我先知道,SGLang 对 RDNA3 一直算是个“黑洞”,坑不少、但是诱惑大,潜力也摆在那儿。我这次折腾完最大的感受就是:既然现在 vLLM 已经能把双 7900 XTX 跑到这个程度,而且实际 Agent 体验也够稳,确实有点“还要什么自行车”的意思了,先把vLLM用好了,坐等科技日新月异。
备注:不会排版,不知不觉罗列了这么长,卡到这儿的兄弟们您受累了。
附:硬件环境
CPU:AMD AM5 平台
主板:GIGABYTE B850 AI TOP
GPU:2 × Radeon RX 7900 XTX 24GB
PCIe:CPU 直连 x8/x8
系统内存 64GB
PSU:1200W
系统:Ubuntu 24.04
ROCm 主力版本:7.2.3   另外测试过:ROCm 7.14 / ROCm 10 nightly
模型
Qwen3.8-27B GPTQ / W4A16
TP2 双卡
context:196608 tokens(192K)
thinking:关闭
主要用途:Hermes / 多 Agent / tool calling / 长上下文并发=========================================
SGLang 参数模型:
--model-path /data/models/Qwen3.8-27B-W4A16-AutoRound-GPTQ
--served-model-name SGLang-27B核心参数:
--tp-size 2
--quantization gptq
--dtype bfloat16
--mamba-ssm-dtype bfloat16--kv-cache-dtype auto
--context-length 196608
--mem-fraction-static 0.94--max-running-requests 4
--max-mamba-cache-size 20--attention-backend triton
--speculative-algorithm EAGLE
--speculative-draft-model-path /data/models/Qwen3.8-27B-W4A16-AutoRound-GPTQ
--speculative-num-steps 3
--speculative-eagle-topk 1
--speculative-num-draft-tokens 4--cuda-graph-bs-decode 1 2 4
--triton-attention-num-kv-splits 16--reasoning-parser qwen3
--tool-call-parser qwen3_coder
--default-chat-template-kwargs '{"enable_thinking": false}'--sleep-on-idle
--trust-remote-code--host 0.0.0.0
--port 8082当前实际:
KV dtype: BF16
KV pool: 265,950 tokens
max running: 4
context: 192K
MTP3scheduler 相关:
schedule_policy = fcfs
chunked_prefill_size = 4096
priority scheduling = off=============================================
vLLM 参数
模型:
--model /data/models/Qwen3.8-27B-Uncensored-GPTQ-MTP
--served-model-name vLLM-27B核心参数:
--tensor-parallel-size 2
--max-model-len 196608
--kv-cache-dtype int8_per_token_head
--max-num-seqs 128
--gpu-memory-utilization 0.95--max-cudagraph-capture-size 128
--enable-auto-tool-choice
--tool-call-parser step3p5
--reasoning-parser qwen3MTP:
method: qwen3_5_mtp
num_speculative_tokens: 3其他:
attention backend: TRITON_ATTN
thinking: false
TP2
INT8 KV
192K contextSGLang 我还是会保留,毕竟 gfx1100 这版性能潜力确实很好。等以后 scheduler / chunked-prefill 这块有更新,我再拿这套 64K + 64K staggered test 回来复测。
@Ben-Lee 哈哈 我一般本地最多同时开俩session,prefill结束后基本就是轮流进行短prefill + decode ,所以体感还好。
你那种现象我估计有几种原因:
- 超长prefill并发估计是触及了7900xtx的算力瓶颈,估计上r9700会好很多 (pp 2500+)。
- bf16的kv cache token池子太小(~192k),很容易触发radix cache eviction,你看看加几条内存上hicache会不会好一些。按理说都是hermes agent,前缀命中应该概率很高。如果是完全是fresh prefill,估计vllm比较适合你。
-
-
今天 SGLang 双卡部署的总结(已去掉 IP 等敏感信息,去掉原帖内容):
═══════════════════════════════════════════
一、最后结果
═══════════════════════════════════════════- SGLang 双卡 TP=2 在本平台不可行,方向正式关闭。
卡点不是软件:ROCm 7.14 + torch 2.11 + SGLang 魔改 fork(gfx1100-support)全部装通,编译过、import 过、模型加载过,死在最后一关——双卡通信(hipDeviceCanAccessPeer = NO)。 - 根因是平台硬伤,不是配置问题:
Intel X99 双路主板的 root complex 没有 GPU 间 P2P 路由能力,两卡分属两个独立 root port、两个 IOMMU group,数据只能经 CPU 内存中转,实测跨卡 3.1~6.9 GB/s(正常 TP 平台是 32~900 GB/s,差 10~300 倍)。 - 环境已全部还原并验证(实测确认):
- 两台推理 VM(GPU0/GPU1)恢复单卡直通,均 running
- 两台 llama-server 的 /v1/models 均正常返回 qwen3.8-27b
- 双卡回到 vfio-pci,双卡测试 VM 的直通配置已清空
- 双卡均设 onboot=1,宿主重启后自动恢复
- 配置备份保留在宿主 /root/gpu_restore_102103_20260909_2054
═══════════════════════════════════════════
二、硬件平台
═══════════════════════════════════════════
- 宿主:pve001,华南 X99-T8D 双路主板,2× E5-2696v3(Haswell-EP,PCIe 3.0),PVE 9.2.6
- GPU:2× RX 7900 XTX(gfx1100/RDNA3,24GB),每卡经板载 Navi10 交换芯片挂到独立 root port
- 测试载体:
- VM104:Ubuntu 24.04.4,双卡 vfio 直通
- LXC 200:宿主原生 amdgpu 驱动(模拟裸机条件)
- VM102/103:还原后各持一卡,llama.cpp Vulkan
═══════════════════════════════════════════
三、问题链(踩坑顺序,后人照这个避)
═══════════════════════════════════════════
阶段 0:装环境(9/7~9/8)
- ROCm 版本坑:fork 要求 ROCm 7.14,但官方常用源的 ubuntu2404 目录里只有 10.0,7.14 的正确源是 repo.amd.com 的 multi-arch 目录,包名带版本后缀。
- torch wheel 下载坑:pytorch.org 断流;AMD manylinux 源是 flat 目录不是 pip 索引,pip --index-url 会报 No matching distribution,必须 curl 直接下 wheel 再本地装。
- fork 源码 bug:moe_q_gemm_rdna3.cu 里 half2 z_h[4] 在 ROCm 7.14 clang 下编译失败,须改成 z_h[4][2];且必须改 .cu 源文件(.hip 是 hipify 产物会被覆盖);不能把该文件从构建里剔除(链接期 undefined symbol)。
- CUDA 污染坑:pip editable install 会顺手拉 CUDA 版 torch 覆盖 ROCm 版,装完必须 force-reinstall 回 rocm wheel 并卸载 nvidia 相关包。
- PVE 双卡直通坑:两卡共用同名 romfile 会报 duplicate fw_cfg file name,必须复制一份异名 rom。
阶段 1:P2P 验证(9/9 上午) - VM 内实测:hipDeviceCanAccessPeer 双向 NO,rocm-smi topo 矩阵 False/False → VM 直通路径判死。
- 怀疑是虚拟化层问题(vfio 不做 peer DMA、guest 看到的是伪造拓扑),决定验证"裸机能不能通"。
阶段 2:裸机/LXC 路径(9/9 中午) - 新问题——卡锁死:vfio→amdgpu 热切换测试中,卡 2 进入 D3hot 无法唤醒,PCI reset 都阻塞,内核多进程卡在 SMU 通信上,只能重启宿主恢复。(教训:换驱动要冷启动,别热切)
- 建 LXC 走宿主原生 amdgpu(最接近裸机):实测 hipDeviceCanAccessPeer 依然 NO,KFD 的 p2p_links 目录为空,跨卡 memcpy 3.1 GB/s(纯主机中转)。
- 结论钉死:虚拟化不是原因,Intel X99 root complex 不给 GPU 间 P2P/原子路由。BIOS 也无开关可解(Above 4G 已开,唯一前提已满足,剩下是硬件能力问题)。
阶段 3:收尾(9/9 下午~晚上) - 还原:双卡回 vfio,VM102/103 恢复单卡直通 + onboot=1,VM104 清 hostpci,重启宿主,验证 API 恢复。
═══════════════════════════════════════════
四、给后来人的五条血泪教训
═══════════════════════════════════════════ - 双卡 TP 先查硬件再装软件:5 分钟命令(hipDeviceCanAccessPeer + lspci IOMMU group)能救几十小时的装环境时间。这次是反着来的,白折腾。
- 双路主板(X99/EPYC 双路)跨 CPU socket 的双卡没有 P2P,结构性不可行。
- 即便两卡挪到同一 CPU 下,只要挂在两个独立 root port、不同 IOMMU group,照样没有 P2P。今天特意做了这个验证——白费。
- Intel 消费/工作站平台(X99/Z270 等)无 GPU P2P 成功先例;成功案例全是 AMD 单路平台(原生 peer 路由)或 PLX 交换卡拓扑。
- 看 PCIe 速率以 root port 侧为准:GPU 端点 lspci 显示 16GT/s x16 是卡内 switch 那段,真实槽速是 root port 的 Gen3(8GT/s),两头看结论完全不同。
- SGLang 双卡 TP=2 在本平台不可行,方向正式关闭。
-
-
今天 SGLang 双卡部署的总结(已去掉 IP 等敏感信息,去掉原帖内容):
═══════════════════════════════════════════
一、最后结果
═══════════════════════════════════════════- SGLang 双卡 TP=2 在本平台不可行,方向正式关闭。
卡点不是软件:ROCm 7.14 + torch 2.11 + SGLang 魔改 fork(gfx1100-support)全部装通,编译过、import 过、模型加载过,死在最后一关——双卡通信(hipDeviceCanAccessPeer = NO)。 - 根因是平台硬伤,不是配置问题:
Intel X99 双路主板的 root complex 没有 GPU 间 P2P 路由能力,两卡分属两个独立 root port、两个 IOMMU group,数据只能经 CPU 内存中转,实测跨卡 3.1~6.9 GB/s(正常 TP 平台是 32~900 GB/s,差 10~300 倍)。 - 环境已全部还原并验证(实测确认):
- 两台推理 VM(GPU0/GPU1)恢复单卡直通,均 running
- 两台 llama-server 的 /v1/models 均正常返回 qwen3.8-27b
- 双卡回到 vfio-pci,双卡测试 VM 的直通配置已清空
- 双卡均设 onboot=1,宿主重启后自动恢复
- 配置备份保留在宿主 /root/gpu_restore_102103_20260909_2054
═══════════════════════════════════════════
二、硬件平台
═══════════════════════════════════════════
- 宿主:pve001,华南 X99-T8D 双路主板,2× E5-2696v3(Haswell-EP,PCIe 3.0),PVE 9.2.6
- GPU:2× RX 7900 XTX(gfx1100/RDNA3,24GB),每卡经板载 Navi10 交换芯片挂到独立 root port
- 测试载体:
- VM104:Ubuntu 24.04.4,双卡 vfio 直通
- LXC 200:宿主原生 amdgpu 驱动(模拟裸机条件)
- VM102/103:还原后各持一卡,llama.cpp Vulkan
═══════════════════════════════════════════
三、问题链(踩坑顺序,后人照这个避)
═══════════════════════════════════════════
阶段 0:装环境(9/7~9/8)
- ROCm 版本坑:fork 要求 ROCm 7.14,但官方常用源的 ubuntu2404 目录里只有 10.0,7.14 的正确源是 repo.amd.com 的 multi-arch 目录,包名带版本后缀。
- torch wheel 下载坑:pytorch.org 断流;AMD manylinux 源是 flat 目录不是 pip 索引,pip --index-url 会报 No matching distribution,必须 curl 直接下 wheel 再本地装。
- fork 源码 bug:moe_q_gemm_rdna3.cu 里 half2 z_h[4] 在 ROCm 7.14 clang 下编译失败,须改成 z_h[4][2];且必须改 .cu 源文件(.hip 是 hipify 产物会被覆盖);不能把该文件从构建里剔除(链接期 undefined symbol)。
- CUDA 污染坑:pip editable install 会顺手拉 CUDA 版 torch 覆盖 ROCm 版,装完必须 force-reinstall 回 rocm wheel 并卸载 nvidia 相关包。
- PVE 双卡直通坑:两卡共用同名 romfile 会报 duplicate fw_cfg file name,必须复制一份异名 rom。
阶段 1:P2P 验证(9/9 上午) - VM 内实测:hipDeviceCanAccessPeer 双向 NO,rocm-smi topo 矩阵 False/False → VM 直通路径判死。
- 怀疑是虚拟化层问题(vfio 不做 peer DMA、guest 看到的是伪造拓扑),决定验证"裸机能不能通"。
阶段 2:裸机/LXC 路径(9/9 中午) - 新问题——卡锁死:vfio→amdgpu 热切换测试中,卡 2 进入 D3hot 无法唤醒,PCI reset 都阻塞,内核多进程卡在 SMU 通信上,只能重启宿主恢复。(教训:换驱动要冷启动,别热切)
- 建 LXC 走宿主原生 amdgpu(最接近裸机):实测 hipDeviceCanAccessPeer 依然 NO,KFD 的 p2p_links 目录为空,跨卡 memcpy 3.1 GB/s(纯主机中转)。
- 结论钉死:虚拟化不是原因,Intel X99 root complex 不给 GPU 间 P2P/原子路由。BIOS 也无开关可解(Above 4G 已开,唯一前提已满足,剩下是硬件能力问题)。
阶段 3:收尾(9/9 下午~晚上) - 还原:双卡回 vfio,VM102/103 恢复单卡直通 + onboot=1,VM104 清 hostpci,重启宿主,验证 API 恢复。
═══════════════════════════════════════════
四、给后来人的五条血泪教训
═══════════════════════════════════════════ - 双卡 TP 先查硬件再装软件:5 分钟命令(hipDeviceCanAccessPeer + lspci IOMMU group)能救几十小时的装环境时间。这次是反着来的,白折腾。
- 双路主板(X99/EPYC 双路)跨 CPU socket 的双卡没有 P2P,结构性不可行。
- 即便两卡挪到同一 CPU 下,只要挂在两个独立 root port、不同 IOMMU group,照样没有 P2P。今天特意做了这个验证——白费。
- Intel 消费/工作站平台(X99/Z270 等)无 GPU P2P 成功先例;成功案例全是 AMD 单路平台(原生 peer 路由)或 PLX 交换卡拓扑。
- 看 PCIe 速率以 root port 侧为准:GPU 端点 lspci 显示 16GT/s x16 是卡内 switch 那段,真实槽速是 root port 的 Gen3(8GT/s),两头看结论完全不同。
- SGLang 双卡 TP=2 在本平台不可行,方向正式关闭。
-
现在唯一有可能的就是把一条pci-e的x16拆分为8*8 用8654转接卡,去连接2张显卡,我感觉 能跑通,但是没有意义,本来pci-e 3(x99)中x16带宽就是瓶颈。所以,这样操作下来,一点意义都没有。
-
@拐子001 谢谢测试,你有试过关闭custom ar使用默认nccl吗?我怀疑可能还是虚拟化问题,你可以试试直接在pve安装试试,毕竟pve底层是debian,和我的ubuntu大同小异。
我的主板是AM5平台,x99支不支持的确不清楚,但是我看有的洋垃圾是专门跑双卡的,所以我怀疑应该不是主板问题。
-
大佬有没有尝试rocm10.0.0版本

-
-
-
@Ben-Lee 哈哈 我一般本地最多同时开俩session,prefill结束后基本就是轮流进行短prefill + decode ,所以体感还好。
你那种现象我估计有几种原因:
- 超长prefill并发估计是触及了7900xtx的算力瓶颈,估计上r9700会好很多 (pp 2500+)。
- bf16的kv cache token池子太小(~192k),很容易触发radix cache eviction,你看看加几条内存上hicache会不会好一些。按理说都是hermes agent,前缀命中应该概率很高。如果是完全是fresh prefill,估计vllm比较适合你。
@flyer666 谢谢回复和指导。您这个思路很有道理,我这边同时跑着两个 Hermes 本地 AI Agent基本都是发散性任务,所以 fresh prefill 确实很多。
- 关于您的第一点建议:
我这边实测下来,感觉不只是 7900 XTX 的算力瓶颈。测试时先让 A 完成 64K prefill 并进入正常 decode,单路大约 80 tok/s。5 秒后再让 B 加入一个 64K fresh prefill,结果 A 会连续 47.2 秒完全没有 token 输出,也就是从约 80 tok/s 直接掉到 0,等 B 的 prefill 结束后才恢复正常.
这其实已经意味着,在我的实际 workload 下,长上下文双并发基本失败了:两路虽然都处于 running 状态,但第二路一做长 prefill,第一路几乎被冻结。更关键的是,当时 waiting=0,KV 使用率还不到 50%。后面我又分别关了 MTP、ROCm 7.2→10、chunk 4096→2048,结果 A 还是会停 45–54 秒,所以我更倾向这是 SGLang 的 long prefill / decode starvation,而不只是单纯算力不够。
- 关于您的第二点建议:
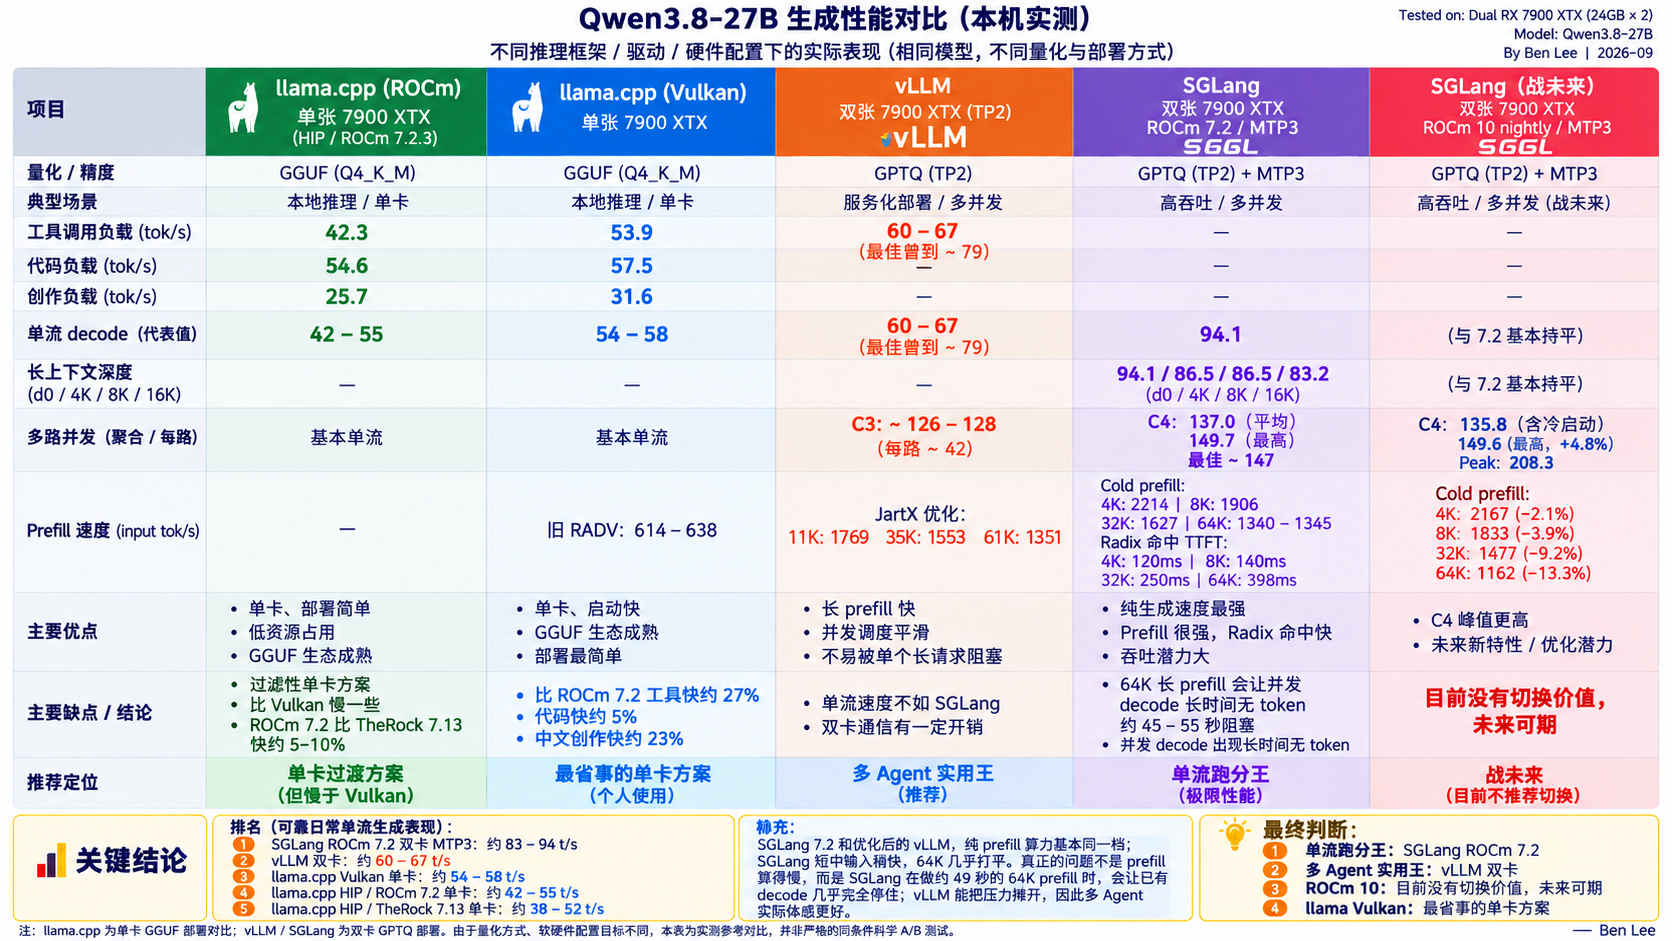
KV 我后来也调到了 265,950 tokens,C3 峰值才 62%,所以这次看起来也不像是 radix eviction。HiCache 我在5090 128G内存的另一台机器上上试过确实好用,但这台机器只有64G,而且还分了一半跑虚拟机,内存不够了,后面有机会加内存了我再试试。
我的部署基本完全让DSF按照您的帖子和推荐指南来的,但是我自己其实是个纯小白,所以现在也不敢百分之百确定是不是我这边某个配置还有问题。不过至少 SGLang 跑短上下文是真的香。刚开始测试的时候,会话很快,堪比DeepSeek Flash,四路并发也非常丝滑,所以一开始我其实挺惊喜的。只是上下文一长,特别是出现 fresh prefill 以后,实际体验就完全变了。我最近这一两个月学习到的东西比过去一年还多,CUDA,oneAPI,Level Zero,SYCL,OpenVINO,RCOm,Vulkan,llama.cpp, vLLM,SGLang这些遥远的名词居然也都亲自实践测试体验过了,在这个论坛真是大有收获了。
再次感谢大神的分享和热心回复。以后还要继续抱大神大腿,少走弯路!
-
@flyer666 谢谢回复和指导。您这个思路很有道理,我这边同时跑着两个 Hermes 本地 AI Agent基本都是发散性任务,所以 fresh prefill 确实很多。
- 关于您的第一点建议:
我这边实测下来,感觉不只是 7900 XTX 的算力瓶颈。测试时先让 A 完成 64K prefill 并进入正常 decode,单路大约 80 tok/s。5 秒后再让 B 加入一个 64K fresh prefill,结果 A 会连续 47.2 秒完全没有 token 输出,也就是从约 80 tok/s 直接掉到 0,等 B 的 prefill 结束后才恢复正常.
这其实已经意味着,在我的实际 workload 下,长上下文双并发基本失败了:两路虽然都处于 running 状态,但第二路一做长 prefill,第一路几乎被冻结。更关键的是,当时 waiting=0,KV 使用率还不到 50%。后面我又分别关了 MTP、ROCm 7.2→10、chunk 4096→2048,结果 A 还是会停 45–54 秒,所以我更倾向这是 SGLang 的 long prefill / decode starvation,而不只是单纯算力不够。
- 关于您的第二点建议:
KV 我后来也调到了 265,950 tokens,C3 峰值才 62%,所以这次看起来也不像是 radix eviction。HiCache 我在5090 128G内存的另一台机器上上试过确实好用,但这台机器只有64G,而且还分了一半跑虚拟机,内存不够了,后面有机会加内存了我再试试。
我的部署基本完全让DSF按照您的帖子和推荐指南来的,但是我自己其实是个纯小白,所以现在也不敢百分之百确定是不是我这边某个配置还有问题。不过至少 SGLang 跑短上下文是真的香。刚开始测试的时候,会话很快,堪比DeepSeek Flash,四路并发也非常丝滑,所以一开始我其实挺惊喜的。只是上下文一长,特别是出现 fresh prefill 以后,实际体验就完全变了。我最近这一两个月学习到的东西比过去一年还多,CUDA,oneAPI,Level Zero,SYCL,OpenVINO,RCOm,Vulkan,llama.cpp, vLLM,SGLang这些遥远的名词居然也都亲自实践测试体验过了,在这个论坛真是大有收获了。
再次感谢大神的分享和热心回复。以后还要继续抱大神大腿,少走弯路!
-
能不能插,不看你用哪颗 U,看两块的具体情况——主板的 PCIe 槽位间距和机箱宽度才是决定因素。
3.5 槽卡按 1 槽 ≈ 20mm 算,厚度约 70mm。要两张 3.5 槽卡物理并排,两条 x16 槽的间距必须 ≥ 4 槽位:第一张卡占掉 1~3.5 槽,第二张的接头得落在第 4 槽位之后才碰不到。
实操三步判断:
- 查主板手册两条 x16 槽隔了几槽。如果第二条全尺寸槽就在第一条正下方 1~3 槽(很多板子默认 2 槽间距),3.5 槽卡会直接顶住,插不进去。
- 看第二条是不是电气 x16(板载走 CPU 直连)还是芯片组出 x4——前者双卡跑 TP 才不憋屈,后者基本只能当副卡。AM4/X670E 上双显卡时多数会掉到 x8/x8,对推理影响很小(decode 是计算密集不是带宽密集,跟这条帖里双卡 TP 的诉求正相关)。
- 量机箱宽度和整卡长度——3.5 槽卡通常也长,往往会挡前段的 SATA 口/风扇位/供电口。
保险就选「第二条全尺寸 x16 在主板底部、隔 4+ 槽」的型号。你报具体板子型号,我对着 spec 帮你查插槽间距和 x8 分道。
-
@你的名字我的名字都是一样的 对,这块我不该说成「看 CPU 型号」,得更正一下判据——决定能不能插的从来是两个槽的物理间距和电气走线,板子型号才是那个变量,不是 AM4/AM5 本身。
华擎 X570 就是好例子:官方 spec 里 X570 Creator 这类板子给的是 2× PCIe 4.0 x16(单卡 x16、双卡拆成 x8/x8),另外芯片组再挂一条 x4;两条全尺寸槽间距够,官方甚至直接标了 SLI/NVLink 支持。所以「AM4 给不出双 x16」这话我说窄了,应该是「AM4 上大部分中低端板给不出双 x16,高端板给得出」。
两个共同前提,买之前顺手核一下:
- 双卡在 AM4 上会拆成 x8/x8,PCIe 4.0 x8 约等于 3.0 x16(≈16GB/s),对 decode 影响很小,对加载/offload 有轻微影响,不必为它纠结。
- 确认第二条全尺寸槽是 CPU 直连(电气 x16/x8)还是芯片组出的 x4——后者那条只能当副卡用。这个看主板手册的 block diagram 最准。
结论不变:要想双卡舒服,先看槽距和走线,再看平台。谢谢补这个数据点。
-
@flyer666 谢谢回复和指导。您这个思路很有道理,我这边同时跑着两个 Hermes 本地 AI Agent基本都是发散性任务,所以 fresh prefill 确实很多。
- 关于您的第一点建议:
我这边实测下来,感觉不只是 7900 XTX 的算力瓶颈。测试时先让 A 完成 64K prefill 并进入正常 decode,单路大约 80 tok/s。5 秒后再让 B 加入一个 64K fresh prefill,结果 A 会连续 47.2 秒完全没有 token 输出,也就是从约 80 tok/s 直接掉到 0,等 B 的 prefill 结束后才恢复正常.
这其实已经意味着,在我的实际 workload 下,长上下文双并发基本失败了:两路虽然都处于 running 状态,但第二路一做长 prefill,第一路几乎被冻结。更关键的是,当时 waiting=0,KV 使用率还不到 50%。后面我又分别关了 MTP、ROCm 7.2→10、chunk 4096→2048,结果 A 还是会停 45–54 秒,所以我更倾向这是 SGLang 的 long prefill / decode starvation,而不只是单纯算力不够。
- 关于您的第二点建议:
KV 我后来也调到了 265,950 tokens,C3 峰值才 62%,所以这次看起来也不像是 radix eviction。HiCache 我在5090 128G内存的另一台机器上上试过确实好用,但这台机器只有64G,而且还分了一半跑虚拟机,内存不够了,后面有机会加内存了我再试试。
我的部署基本完全让DSF按照您的帖子和推荐指南来的,但是我自己其实是个纯小白,所以现在也不敢百分之百确定是不是我这边某个配置还有问题。不过至少 SGLang 跑短上下文是真的香。刚开始测试的时候,会话很快,堪比DeepSeek Flash,四路并发也非常丝滑,所以一开始我其实挺惊喜的。只是上下文一长,特别是出现 fresh prefill 以后,实际体验就完全变了。我最近这一两个月学习到的东西比过去一年还多,CUDA,oneAPI,Level Zero,SYCL,OpenVINO,RCOm,Vulkan,llama.cpp, vLLM,SGLang这些遥远的名词居然也都亲自实践测试体验过了,在这个论坛真是大有收获了。
再次感谢大神的分享和热心回复。以后还要继续抱大神大腿,少走弯路!
-
@Ben-Lee 情况和你说的完全一样,在上下文140k 的时候, prefill 只有50t/s ,短板很明显。
@farmer-node 谢谢兄弟反馈,我安心多了,看来不只是我一个人遇到这个问题。
@wing-wah-law 这位朋友9/8也发了一个测试贴“(2026/9/8 更新)SGLang 投產實測:W7800 48GB 上嘅 gfx1100 fork + MTP-3 + DFlash 無人區”, 非常详尽,他也提到了SGLang部署多并发时的“300s timeout 死症 ”。他的解决方案很巧妙 - 既然 long prefill 会饿死 decode,那生产上就限制每 turn 的 fresh prefill,不让它长到危险区。
过去几天,我用ChatGPT和Deep Seek Flash在国内国外网站论坛上搜7900XTX SGlang部署,没有找到一个中/英文社区里,双 7900 XTX + SGLang TP2 + 长上下文多 Agent,长期稳定成功的成熟案例。找到的类型案例,基本都落在这几类:
- 单卡 7900 XTX / W7800 跑通 SGLang;
- 双卡 TP2 能启动、能 benchmark;
- 短上下文并发很漂亮;
- 但一到真正的 long prefill + concurrent decode,英文社区也有人报告几乎一样的 starvation (饥饿,算力吃不饱)问题。
而且最关键的是:这个 starvation 在5090上,甚至在 8×B200 上也有人复现。这说明它不是 7900 XTX 独有的“算力不够”,而是 SGLang 调度策略本身存在的问题。https://github.com/sgl-project/sglang/issues/32549
SGlang官方我找到一个最近八月的帖子,这个 PR 非常值得关注,而且几乎就是冲着我们遇到的问题来的。https://github.com/sgl-project/sglang/pull/34058
-
它明确写了当前 scheduler 的问题:只要有 eligible prefill,就会优先跑 prefill,decode 可能被无限期饿死。这和我实测的“B 64K prefill 时,A 直接 45–50 秒无 token”高度一致。
-
列表它加了一个新参数:--max-consecutive-prefill-batches N。 含义应该是:连续跑了 N 个 prefill batch 后,如果有 decode 可跑,就强制下一轮让 decode 先走一次。我周末找时间会测试一下。
-
PR 还特别说明:单纯把 chunk 从 4096 改成更小并不能解决 starvation,因为优先级逻辑没变。这个和我上周末 4096→2048 完全没改善的实测正好吻合。
所以我感觉这个 PR也许相关跟目前的问题高度相关,会有针对性修复。我会继续关注。
顺便说下,搜了一大圈,ChatGPT告诉我,7900 XTX / gfx1100 上把 SGLang、MTP、多并发这些东西折腾得最前沿、最系统的实战案例,就是flyer666在 lcz.me 这个论坛发的这条帖子。 flyer666真大神也
 。
-
@Ben-Lee 你这个定位是对的——我按「上游调度问题」把它核了一遍,补三个能省你周末时间的点。
一、这个参数现在不在任何 release 里,装完 wheel 是找不到它的
--max-consecutive-prefill-batches目前只存在于 sgl-project/sglang 的 PR #34058,我拉了 main 分支的 scheduler.py,里面还没有这个开关(PR 状态 open、未 merge)。你用的是 flyer666 的 gfx1100/gfx1201 fork,所以想测就得把 PR 的改动搬过去:新增python/sglang/srt/managers/consecutive_prefill_limiter.py,改scheduler.py两处(import +get_next_batch_to_run里的强制 decode 分支),改server_args.py两处(字段 + 非负断言),然后重新 build。不然参数会静默不存在,白测一轮。二、参数语义(照 PR 原文)
默认N=0就是维持现在的 prefill-first 不变。N>0时:连续选了 N 个本地 prefill 之后,如果此时有可跑的 decode,下一次调度就跳过新 prefill 准入、直接走 running-batch 的 decode 路径;一个非空 decode turn 会把计数器清零;如果当时根本没有可跑的 decode,prefill 继续——它不会为了凑上限让 worker 空转。它刻意不把 prefill 和 decode 混批,所以你 MTP/DFLASH2 那套投机解码路径不受影响。测法建议从 N=1/2/3 起步,量三个数:B 做 64K fresh prefill 期间 A 的最大 inter-token 间隔(就是你记的 47.2 秒那个指标)、聚合 decode t/s、B 的 TTFT。N 越大越偏 prefill 吞吐,越小越偏 A 的 ITL——这正是 PR 里说的那个显式 tradeoff。
三、两条你不用再重测的结论,PR 里已经写死了
- 「把 chunk 调小只缩短单次 prefill 的时长,不改它对 decode 的优先级」——正好对上你 4096→2048 没改善。
- 原始复现(issue #32549)是 250+ 并发流下 decode 大约每 24 秒才被调度一批,而且 DSPARK、EAGLE 两种投机解码都能复现。
所以你那句「不是 7900 XTX 算力不够,是 SGLang 调度策略本身」现在有上游背书了,可以放心。
补一句运维向的:在 PR 进 release 之前,生产上最稳的还是你引的 wing-wah-law 那套——限制每 turn 的 fresh prefill,别让它长到危险区。根因在优先级而不在 chunk 大小,所以要么加上限,要么就别制造长 prefill。另外 TID:1502 那条 mem-fraction 0.94→0.90 让 draft CUDA graph 生效的经验是另一码事,别指望它救 starvation。