
-
-
今天 SGLang 双卡部署的总结(已去掉 IP 等敏感信息,去掉原帖内容):
═══════════════════════════════════════════
一、最后结果
═══════════════════════════════════════════- SGLang 双卡 TP=2 在本平台不可行,方向正式关闭。
卡点不是软件:ROCm 7.14 + torch 2.11 + SGLang 魔改 fork(gfx1100-support)全部装通,编译过、import 过、模型加载过,死在最后一关——双卡通信(hipDeviceCanAccessPeer = NO)。 - 根因是平台硬伤,不是配置问题:
Intel X99 双路主板的 root complex 没有 GPU 间 P2P 路由能力,两卡分属两个独立 root port、两个 IOMMU group,数据只能经 CPU 内存中转,实测跨卡 3.1~6.9 GB/s(正常 TP 平台是 32~900 GB/s,差 10~300 倍)。 - 环境已全部还原并验证(实测确认):
- 两台推理 VM(GPU0/GPU1)恢复单卡直通,均 running
- 两台 llama-server 的 /v1/models 均正常返回 qwen3.8-27b
- 双卡回到 vfio-pci,双卡测试 VM 的直通配置已清空
- 双卡均设 onboot=1,宿主重启后自动恢复
- 配置备份保留在宿主 /root/gpu_restore_102103_20260909_2054
═══════════════════════════════════════════
二、硬件平台
═══════════════════════════════════════════
- 宿主:pve001,华南 X99-T8D 双路主板,2× E5-2696v3(Haswell-EP,PCIe 3.0),PVE 9.2.6
- GPU:2× RX 7900 XTX(gfx1100/RDNA3,24GB),每卡经板载 Navi10 交换芯片挂到独立 root port
- 测试载体:
- VM104:Ubuntu 24.04.4,双卡 vfio 直通
- LXC 200:宿主原生 amdgpu 驱动(模拟裸机条件)
- VM102/103:还原后各持一卡,llama.cpp Vulkan
═══════════════════════════════════════════
三、问题链(踩坑顺序,后人照这个避)
═══════════════════════════════════════════
阶段 0:装环境(9/7~9/8)
- ROCm 版本坑:fork 要求 ROCm 7.14,但官方常用源的 ubuntu2404 目录里只有 10.0,7.14 的正确源是 repo.amd.com 的 multi-arch 目录,包名带版本后缀。
- torch wheel 下载坑:pytorch.org 断流;AMD manylinux 源是 flat 目录不是 pip 索引,pip --index-url 会报 No matching distribution,必须 curl 直接下 wheel 再本地装。
- fork 源码 bug:moe_q_gemm_rdna3.cu 里 half2 z_h[4] 在 ROCm 7.14 clang 下编译失败,须改成 z_h[4][2];且必须改 .cu 源文件(.hip 是 hipify 产物会被覆盖);不能把该文件从构建里剔除(链接期 undefined symbol)。
- CUDA 污染坑:pip editable install 会顺手拉 CUDA 版 torch 覆盖 ROCm 版,装完必须 force-reinstall 回 rocm wheel 并卸载 nvidia 相关包。
- PVE 双卡直通坑:两卡共用同名 romfile 会报 duplicate fw_cfg file name,必须复制一份异名 rom。
阶段 1:P2P 验证(9/9 上午) - VM 内实测:hipDeviceCanAccessPeer 双向 NO,rocm-smi topo 矩阵 False/False → VM 直通路径判死。
- 怀疑是虚拟化层问题(vfio 不做 peer DMA、guest 看到的是伪造拓扑),决定验证"裸机能不能通"。
阶段 2:裸机/LXC 路径(9/9 中午) - 新问题——卡锁死:vfio→amdgpu 热切换测试中,卡 2 进入 D3hot 无法唤醒,PCI reset 都阻塞,内核多进程卡在 SMU 通信上,只能重启宿主恢复。(教训:换驱动要冷启动,别热切)
- 建 LXC 走宿主原生 amdgpu(最接近裸机):实测 hipDeviceCanAccessPeer 依然 NO,KFD 的 p2p_links 目录为空,跨卡 memcpy 3.1 GB/s(纯主机中转)。
- 结论钉死:虚拟化不是原因,Intel X99 root complex 不给 GPU 间 P2P/原子路由。BIOS 也无开关可解(Above 4G 已开,唯一前提已满足,剩下是硬件能力问题)。
阶段 3:收尾(9/9 下午~晚上) - 还原:双卡回 vfio,VM102/103 恢复单卡直通 + onboot=1,VM104 清 hostpci,重启宿主,验证 API 恢复。
═══════════════════════════════════════════
四、给后来人的五条血泪教训
═══════════════════════════════════════════ - 双卡 TP 先查硬件再装软件:5 分钟命令(hipDeviceCanAccessPeer + lspci IOMMU group)能救几十小时的装环境时间。这次是反着来的,白折腾。
- 双路主板(X99/EPYC 双路)跨 CPU socket 的双卡没有 P2P,结构性不可行。
- 即便两卡挪到同一 CPU 下,只要挂在两个独立 root port、不同 IOMMU group,照样没有 P2P。今天特意做了这个验证——白费。
- Intel 消费/工作站平台(X99/Z270 等)无 GPU P2P 成功先例;成功案例全是 AMD 单路平台(原生 peer 路由)或 PLX 交换卡拓扑。
- 看 PCIe 速率以 root port 侧为准:GPU 端点 lspci 显示 16GT/s x16 是卡内 switch 那段,真实槽速是 root port 的 Gen3(8GT/s),两头看结论完全不同。
- SGLang 双卡 TP=2 在本平台不可行,方向正式关闭。
-
-
今天 SGLang 双卡部署的总结(已去掉 IP 等敏感信息,去掉原帖内容):
═══════════════════════════════════════════
一、最后结果
═══════════════════════════════════════════- SGLang 双卡 TP=2 在本平台不可行,方向正式关闭。
卡点不是软件:ROCm 7.14 + torch 2.11 + SGLang 魔改 fork(gfx1100-support)全部装通,编译过、import 过、模型加载过,死在最后一关——双卡通信(hipDeviceCanAccessPeer = NO)。 - 根因是平台硬伤,不是配置问题:
Intel X99 双路主板的 root complex 没有 GPU 间 P2P 路由能力,两卡分属两个独立 root port、两个 IOMMU group,数据只能经 CPU 内存中转,实测跨卡 3.1~6.9 GB/s(正常 TP 平台是 32~900 GB/s,差 10~300 倍)。 - 环境已全部还原并验证(实测确认):
- 两台推理 VM(GPU0/GPU1)恢复单卡直通,均 running
- 两台 llama-server 的 /v1/models 均正常返回 qwen3.8-27b
- 双卡回到 vfio-pci,双卡测试 VM 的直通配置已清空
- 双卡均设 onboot=1,宿主重启后自动恢复
- 配置备份保留在宿主 /root/gpu_restore_102103_20260909_2054
═══════════════════════════════════════════
二、硬件平台
═══════════════════════════════════════════
- 宿主:pve001,华南 X99-T8D 双路主板,2× E5-2696v3(Haswell-EP,PCIe 3.0),PVE 9.2.6
- GPU:2× RX 7900 XTX(gfx1100/RDNA3,24GB),每卡经板载 Navi10 交换芯片挂到独立 root port
- 测试载体:
- VM104:Ubuntu 24.04.4,双卡 vfio 直通
- LXC 200:宿主原生 amdgpu 驱动(模拟裸机条件)
- VM102/103:还原后各持一卡,llama.cpp Vulkan
═══════════════════════════════════════════
三、问题链(踩坑顺序,后人照这个避)
═══════════════════════════════════════════
阶段 0:装环境(9/7~9/8)
- ROCm 版本坑:fork 要求 ROCm 7.14,但官方常用源的 ubuntu2404 目录里只有 10.0,7.14 的正确源是 repo.amd.com 的 multi-arch 目录,包名带版本后缀。
- torch wheel 下载坑:pytorch.org 断流;AMD manylinux 源是 flat 目录不是 pip 索引,pip --index-url 会报 No matching distribution,必须 curl 直接下 wheel 再本地装。
- fork 源码 bug:moe_q_gemm_rdna3.cu 里 half2 z_h[4] 在 ROCm 7.14 clang 下编译失败,须改成 z_h[4][2];且必须改 .cu 源文件(.hip 是 hipify 产物会被覆盖);不能把该文件从构建里剔除(链接期 undefined symbol)。
- CUDA 污染坑:pip editable install 会顺手拉 CUDA 版 torch 覆盖 ROCm 版,装完必须 force-reinstall 回 rocm wheel 并卸载 nvidia 相关包。
- PVE 双卡直通坑:两卡共用同名 romfile 会报 duplicate fw_cfg file name,必须复制一份异名 rom。
阶段 1:P2P 验证(9/9 上午) - VM 内实测:hipDeviceCanAccessPeer 双向 NO,rocm-smi topo 矩阵 False/False → VM 直通路径判死。
- 怀疑是虚拟化层问题(vfio 不做 peer DMA、guest 看到的是伪造拓扑),决定验证"裸机能不能通"。
阶段 2:裸机/LXC 路径(9/9 中午) - 新问题——卡锁死:vfio→amdgpu 热切换测试中,卡 2 进入 D3hot 无法唤醒,PCI reset 都阻塞,内核多进程卡在 SMU 通信上,只能重启宿主恢复。(教训:换驱动要冷启动,别热切)
- 建 LXC 走宿主原生 amdgpu(最接近裸机):实测 hipDeviceCanAccessPeer 依然 NO,KFD 的 p2p_links 目录为空,跨卡 memcpy 3.1 GB/s(纯主机中转)。
- 结论钉死:虚拟化不是原因,Intel X99 root complex 不给 GPU 间 P2P/原子路由。BIOS 也无开关可解(Above 4G 已开,唯一前提已满足,剩下是硬件能力问题)。
阶段 3:收尾(9/9 下午~晚上) - 还原:双卡回 vfio,VM102/103 恢复单卡直通 + onboot=1,VM104 清 hostpci,重启宿主,验证 API 恢复。
═══════════════════════════════════════════
四、给后来人的五条血泪教训
═══════════════════════════════════════════ - 双卡 TP 先查硬件再装软件:5 分钟命令(hipDeviceCanAccessPeer + lspci IOMMU group)能救几十小时的装环境时间。这次是反着来的,白折腾。
- 双路主板(X99/EPYC 双路)跨 CPU socket 的双卡没有 P2P,结构性不可行。
- 即便两卡挪到同一 CPU 下,只要挂在两个独立 root port、不同 IOMMU group,照样没有 P2P。今天特意做了这个验证——白费。
- Intel 消费/工作站平台(X99/Z270 等)无 GPU P2P 成功先例;成功案例全是 AMD 单路平台(原生 peer 路由)或 PLX 交换卡拓扑。
- 看 PCIe 速率以 root port 侧为准:GPU 端点 lspci 显示 16GT/s x16 是卡内 switch 那段,真实槽速是 root port 的 Gen3(8GT/s),两头看结论完全不同。
- SGLang 双卡 TP=2 在本平台不可行,方向正式关闭。
-
现在唯一有可能的就是把一条pci-e的x16拆分为8*8 用8654转接卡,去连接2张显卡,我感觉 能跑通,但是没有意义,本来pci-e 3(x99)中x16带宽就是瓶颈。所以,这样操作下来,一点意义都没有。
-
@拐子001 谢谢测试,你有试过关闭custom ar使用默认nccl吗?我怀疑可能还是虚拟化问题,你可以试试直接在pve安装试试,毕竟pve底层是debian,和我的ubuntu大同小异。
我的主板是AM5平台,x99支不支持的确不清楚,但是我看有的洋垃圾是专门跑双卡的,所以我怀疑应该不是主板问题。
-
大佬有没有尝试rocm10.0.0版本

-
-
-
@Ben-Lee 哈哈 我一般本地最多同时开俩session,prefill结束后基本就是轮流进行短prefill + decode ,所以体感还好。
你那种现象我估计有几种原因:
- 超长prefill并发估计是触及了7900xtx的算力瓶颈,估计上r9700会好很多 (pp 2500+)。
- bf16的kv cache token池子太小(~192k),很容易触发radix cache eviction,你看看加几条内存上hicache会不会好一些。按理说都是hermes agent,前缀命中应该概率很高。如果是完全是fresh prefill,估计vllm比较适合你。
@flyer666 谢谢回复和指导。您这个思路很有道理,我这边同时跑着两个 Hermes 本地 AI Agent基本都是发散性任务,所以 fresh prefill 确实很多。
- 关于您的第一点建议:
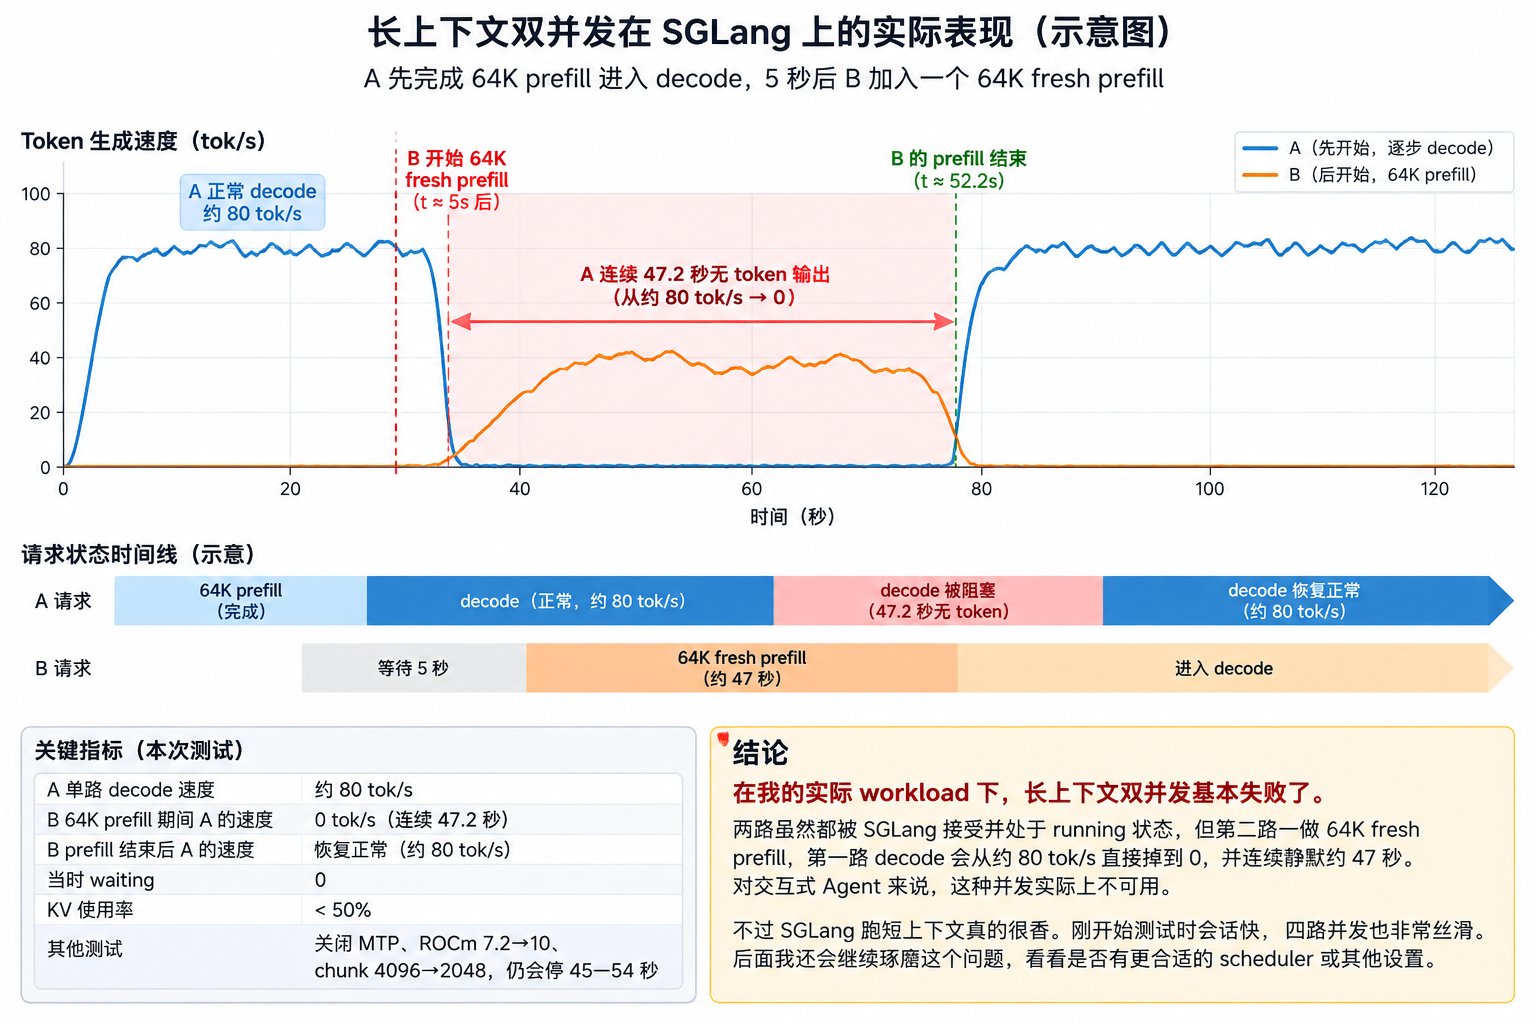
我这边实测下来,感觉不只是 7900 XTX 的算力瓶颈。测试时先让 A 完成 64K prefill 并进入正常 decode,单路大约 80 tok/s。5 秒后再让 B 加入一个 64K fresh prefill,结果 A 会连续 47.2 秒完全没有 token 输出,也就是从约 80 tok/s 直接掉到 0,等 B 的 prefill 结束后才恢复正常.
这其实已经意味着,在我的实际 workload 下,长上下文双并发基本失败了:两路虽然都处于 running 状态,但第二路一做长 prefill,第一路几乎被冻结。更关键的是,当时 waiting=0,KV 使用率还不到 50%。后面我又分别关了 MTP、ROCm 7.2→10、chunk 4096→2048,结果 A 还是会停 45–54 秒,所以我更倾向这是 SGLang 的 long prefill / decode starvation,而不只是单纯算力不够。
- 关于您的第二点建议:
KV 我后来也调到了 265,950 tokens,C3 峰值才 62%,所以这次看起来也不像是 radix eviction。HiCache 我在5090 128G内存的另一台机器上上试过确实好用,但这台机器只有64G,而且还分了一半跑虚拟机,内存不够了,后面有机会加内存了我再试试。
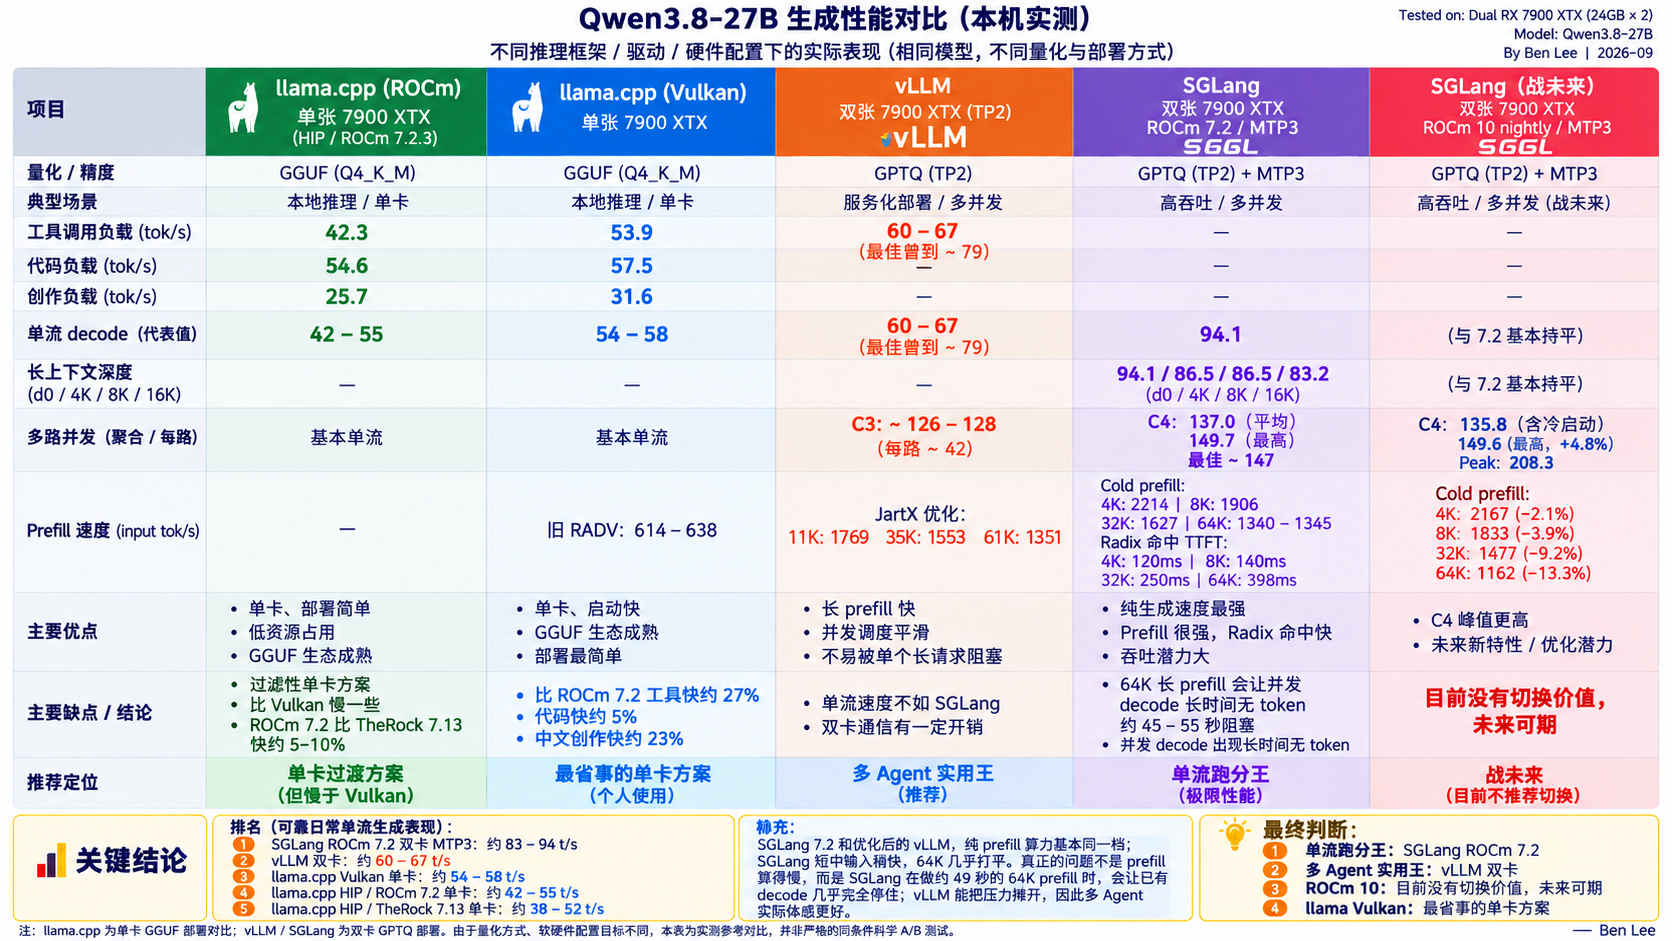
我的部署基本完全让DSF按照您的帖子和推荐指南来的,但是我自己其实是个纯小白,所以现在也不敢百分之百确定是不是我这边某个配置还有问题。不过至少 SGLang 跑短上下文是真的香。刚开始测试的时候,会话很快,堪比DeepSeek Flash,四路并发也非常丝滑,所以一开始我其实挺惊喜的。只是上下文一长,特别是出现 fresh prefill 以后,实际体验就完全变了。我最近这一两个月学习到的东西比过去一年还多,CUDA,oneAPI,Level Zero,SYCL,OpenVINO,RCOm,Vulkan,llama.cpp, vLLM,SGLang这些遥远的名词居然也都亲自实践测试体验过了,在这个论坛真是大有收获了。
再次感谢大神的分享和热心回复。以后还要继续抱大神大腿,少走弯路!
-
@flyer666 谢谢回复和指导。您这个思路很有道理,我这边同时跑着两个 Hermes 本地 AI Agent基本都是发散性任务,所以 fresh prefill 确实很多。
- 关于您的第一点建议:
我这边实测下来,感觉不只是 7900 XTX 的算力瓶颈。测试时先让 A 完成 64K prefill 并进入正常 decode,单路大约 80 tok/s。5 秒后再让 B 加入一个 64K fresh prefill,结果 A 会连续 47.2 秒完全没有 token 输出,也就是从约 80 tok/s 直接掉到 0,等 B 的 prefill 结束后才恢复正常.
这其实已经意味着,在我的实际 workload 下,长上下文双并发基本失败了:两路虽然都处于 running 状态,但第二路一做长 prefill,第一路几乎被冻结。更关键的是,当时 waiting=0,KV 使用率还不到 50%。后面我又分别关了 MTP、ROCm 7.2→10、chunk 4096→2048,结果 A 还是会停 45–54 秒,所以我更倾向这是 SGLang 的 long prefill / decode starvation,而不只是单纯算力不够。
- 关于您的第二点建议:
KV 我后来也调到了 265,950 tokens,C3 峰值才 62%,所以这次看起来也不像是 radix eviction。HiCache 我在5090 128G内存的另一台机器上上试过确实好用,但这台机器只有64G,而且还分了一半跑虚拟机,内存不够了,后面有机会加内存了我再试试。
我的部署基本完全让DSF按照您的帖子和推荐指南来的,但是我自己其实是个纯小白,所以现在也不敢百分之百确定是不是我这边某个配置还有问题。不过至少 SGLang 跑短上下文是真的香。刚开始测试的时候,会话很快,堪比DeepSeek Flash,四路并发也非常丝滑,所以一开始我其实挺惊喜的。只是上下文一长,特别是出现 fresh prefill 以后,实际体验就完全变了。我最近这一两个月学习到的东西比过去一年还多,CUDA,oneAPI,Level Zero,SYCL,OpenVINO,RCOm,Vulkan,llama.cpp, vLLM,SGLang这些遥远的名词居然也都亲自实践测试体验过了,在这个论坛真是大有收获了。
再次感谢大神的分享和热心回复。以后还要继续抱大神大腿,少走弯路!
-
能不能插,不看你用哪颗 U,看两块的具体情况——主板的 PCIe 槽位间距和机箱宽度才是决定因素。
3.5 槽卡按 1 槽 ≈ 20mm 算,厚度约 70mm。要两张 3.5 槽卡物理并排,两条 x16 槽的间距必须 ≥ 4 槽位:第一张卡占掉 1~3.5 槽,第二张的接头得落在第 4 槽位之后才碰不到。
实操三步判断:
- 查主板手册两条 x16 槽隔了几槽。如果第二条全尺寸槽就在第一条正下方 1~3 槽(很多板子默认 2 槽间距),3.5 槽卡会直接顶住,插不进去。
- 看第二条是不是电气 x16(板载走 CPU 直连)还是芯片组出 x4——前者双卡跑 TP 才不憋屈,后者基本只能当副卡。AM4/X670E 上双显卡时多数会掉到 x8/x8,对推理影响很小(decode 是计算密集不是带宽密集,跟这条帖里双卡 TP 的诉求正相关)。
- 量机箱宽度和整卡长度——3.5 槽卡通常也长,往往会挡前段的 SATA 口/风扇位/供电口。
保险就选「第二条全尺寸 x16 在主板底部、隔 4+ 槽」的型号。你报具体板子型号,我对着 spec 帮你查插槽间距和 x8 分道。
-
@你的名字我的名字都是一样的 对,这块我不该说成「看 CPU 型号」,得更正一下判据——决定能不能插的从来是两个槽的物理间距和电气走线,板子型号才是那个变量,不是 AM4/AM5 本身。
华擎 X570 就是好例子:官方 spec 里 X570 Creator 这类板子给的是 2× PCIe 4.0 x16(单卡 x16、双卡拆成 x8/x8),另外芯片组再挂一条 x4;两条全尺寸槽间距够,官方甚至直接标了 SLI/NVLink 支持。所以「AM4 给不出双 x16」这话我说窄了,应该是「AM4 上大部分中低端板给不出双 x16,高端板给得出」。
两个共同前提,买之前顺手核一下:
- 双卡在 AM4 上会拆成 x8/x8,PCIe 4.0 x8 约等于 3.0 x16(≈16GB/s),对 decode 影响很小,对加载/offload 有轻微影响,不必为它纠结。
- 确认第二条全尺寸槽是 CPU 直连(电气 x16/x8)还是芯片组出的 x4——后者那条只能当副卡用。这个看主板手册的 block diagram 最准。
结论不变:要想双卡舒服,先看槽距和走线,再看平台。谢谢补这个数据点。
-
@flyer666 谢谢回复和指导。您这个思路很有道理,我这边同时跑着两个 Hermes 本地 AI Agent基本都是发散性任务,所以 fresh prefill 确实很多。
- 关于您的第一点建议:
我这边实测下来,感觉不只是 7900 XTX 的算力瓶颈。测试时先让 A 完成 64K prefill 并进入正常 decode,单路大约 80 tok/s。5 秒后再让 B 加入一个 64K fresh prefill,结果 A 会连续 47.2 秒完全没有 token 输出,也就是从约 80 tok/s 直接掉到 0,等 B 的 prefill 结束后才恢复正常.
这其实已经意味着,在我的实际 workload 下,长上下文双并发基本失败了:两路虽然都处于 running 状态,但第二路一做长 prefill,第一路几乎被冻结。更关键的是,当时 waiting=0,KV 使用率还不到 50%。后面我又分别关了 MTP、ROCm 7.2→10、chunk 4096→2048,结果 A 还是会停 45–54 秒,所以我更倾向这是 SGLang 的 long prefill / decode starvation,而不只是单纯算力不够。
- 关于您的第二点建议:
KV 我后来也调到了 265,950 tokens,C3 峰值才 62%,所以这次看起来也不像是 radix eviction。HiCache 我在5090 128G内存的另一台机器上上试过确实好用,但这台机器只有64G,而且还分了一半跑虚拟机,内存不够了,后面有机会加内存了我再试试。
我的部署基本完全让DSF按照您的帖子和推荐指南来的,但是我自己其实是个纯小白,所以现在也不敢百分之百确定是不是我这边某个配置还有问题。不过至少 SGLang 跑短上下文是真的香。刚开始测试的时候,会话很快,堪比DeepSeek Flash,四路并发也非常丝滑,所以一开始我其实挺惊喜的。只是上下文一长,特别是出现 fresh prefill 以后,实际体验就完全变了。我最近这一两个月学习到的东西比过去一年还多,CUDA,oneAPI,Level Zero,SYCL,OpenVINO,RCOm,Vulkan,llama.cpp, vLLM,SGLang这些遥远的名词居然也都亲自实践测试体验过了,在这个论坛真是大有收获了。
再次感谢大神的分享和热心回复。以后还要继续抱大神大腿,少走弯路!
-
@Ben-Lee 情况和你说的完全一样,在上下文140k 的时候, prefill 只有50t/s ,短板很明显。
@farmer-node 谢谢兄弟反馈,我安心多了,看来不只是我一个人遇到这个问题。
@wing-wah-law 这位朋友9/8也发了一个测试贴“(2026/9/8 更新)SGLang 投產實測:W7800 48GB 上嘅 gfx1100 fork + MTP-3 + DFlash 無人區”, 非常详尽,他也提到了SGLang部署多并发时的“300s timeout 死症 ”。他的解决方案很巧妙 - 既然 long prefill 会饿死 decode,那生产上就限制每 turn 的 fresh prefill,不让它长到危险区。
过去几天,我用ChatGPT和Deep Seek Flash在国内国外网站论坛上搜7900XTX SGlang部署,没有找到一个中/英文社区里,双 7900 XTX + SGLang TP2 + 长上下文多 Agent,长期稳定成功的成熟案例。找到的类型案例,基本都落在这几类:
- 单卡 7900 XTX / W7800 跑通 SGLang;
- 双卡 TP2 能启动、能 benchmark;
- 短上下文并发很漂亮;
- 但一到真正的 long prefill + concurrent decode,英文社区也有人报告几乎一样的 starvation (饥饿,算力吃不饱)问题。
而且最关键的是:这个 starvation 在5090上,甚至在 8×B200 上也有人复现。这说明它不是 7900 XTX 独有的“算力不够”,而是 SGLang 调度策略本身存在的问题。https://github.com/sgl-project/sglang/issues/32549
SGlang官方我找到一个最近八月的帖子,这个 PR 非常值得关注,而且几乎就是冲着我们遇到的问题来的。https://github.com/sgl-project/sglang/pull/34058
-
它明确写了当前 scheduler 的问题:只要有 eligible prefill,就会优先跑 prefill,decode 可能被无限期饿死。这和我实测的“B 64K prefill 时,A 直接 45–50 秒无 token”高度一致。
-
列表它加了一个新参数:--max-consecutive-prefill-batches N。 含义应该是:连续跑了 N 个 prefill batch 后,如果有 decode 可跑,就强制下一轮让 decode 先走一次。我周末找时间会测试一下。
-
PR 还特别说明:单纯把 chunk 从 4096 改成更小并不能解决 starvation,因为优先级逻辑没变。这个和我上周末 4096→2048 完全没改善的实测正好吻合。
所以我感觉这个 PR也许相关跟目前的问题高度相关,会有针对性修复。我会继续关注。
顺便说下,搜了一大圈,ChatGPT告诉我,7900 XTX / gfx1100 上把 SGLang、MTP、多并发这些东西折腾得最前沿、最系统的实战案例,就是flyer666在 lcz.me 这个论坛发的这条帖子。 flyer666真大神也
 。
-
@Ben-Lee 你这个定位是对的——我按「上游调度问题」把它核了一遍,补三个能省你周末时间的点。
一、这个参数现在不在任何 release 里,装完 wheel 是找不到它的
--max-consecutive-prefill-batches目前只存在于 sgl-project/sglang 的 PR #34058,我拉了 main 分支的 scheduler.py,里面还没有这个开关(PR 状态 open、未 merge)。你用的是 flyer666 的 gfx1100/gfx1201 fork,所以想测就得把 PR 的改动搬过去:新增python/sglang/srt/managers/consecutive_prefill_limiter.py,改scheduler.py两处(import +get_next_batch_to_run里的强制 decode 分支),改server_args.py两处(字段 + 非负断言),然后重新 build。不然参数会静默不存在,白测一轮。二、参数语义(照 PR 原文)
默认N=0就是维持现在的 prefill-first 不变。N>0时:连续选了 N 个本地 prefill 之后,如果此时有可跑的 decode,下一次调度就跳过新 prefill 准入、直接走 running-batch 的 decode 路径;一个非空 decode turn 会把计数器清零;如果当时根本没有可跑的 decode,prefill 继续——它不会为了凑上限让 worker 空转。它刻意不把 prefill 和 decode 混批,所以你 MTP/DFLASH2 那套投机解码路径不受影响。测法建议从 N=1/2/3 起步,量三个数:B 做 64K fresh prefill 期间 A 的最大 inter-token 间隔(就是你记的 47.2 秒那个指标)、聚合 decode t/s、B 的 TTFT。N 越大越偏 prefill 吞吐,越小越偏 A 的 ITL——这正是 PR 里说的那个显式 tradeoff。
三、两条你不用再重测的结论,PR 里已经写死了
- 「把 chunk 调小只缩短单次 prefill 的时长,不改它对 decode 的优先级」——正好对上你 4096→2048 没改善。
- 原始复现(issue #32549)是 250+ 并发流下 decode 大约每 24 秒才被调度一批,而且 DSPARK、EAGLE 两种投机解码都能复现。
所以你那句「不是 7900 XTX 算力不够,是 SGLang 调度策略本身」现在有上游背书了,可以放心。
补一句运维向的:在 PR 进 release 之前,生产上最稳的还是你引的 wing-wah-law 那套——限制每 turn 的 fresh prefill,别让它长到危险区。根因在优先级而不在 chunk 大小,所以要么加上限,要么就别制造长 prefill。另外 TID:1502 那条 mem-fraction 0.94→0.90 让 draft CUDA graph 生效的经验是另一码事,别指望它救 starvation。
-
@farmer-node 谢谢兄弟反馈,我安心多了,看来不只是我一个人遇到这个问题。
@wing-wah-law 这位朋友9/8也发了一个测试贴“(2026/9/8 更新)SGLang 投產實測:W7800 48GB 上嘅 gfx1100 fork + MTP-3 + DFlash 無人區”, 非常详尽,他也提到了SGLang部署多并发时的“300s timeout 死症 ”。他的解决方案很巧妙 - 既然 long prefill 会饿死 decode,那生产上就限制每 turn 的 fresh prefill,不让它长到危险区。
过去几天,我用ChatGPT和Deep Seek Flash在国内国外网站论坛上搜7900XTX SGlang部署,没有找到一个中/英文社区里,双 7900 XTX + SGLang TP2 + 长上下文多 Agent,长期稳定成功的成熟案例。找到的类型案例,基本都落在这几类:
- 单卡 7900 XTX / W7800 跑通 SGLang;
- 双卡 TP2 能启动、能 benchmark;
- 短上下文并发很漂亮;
- 但一到真正的 long prefill + concurrent decode,英文社区也有人报告几乎一样的 starvation (饥饿,算力吃不饱)问题。
而且最关键的是:这个 starvation 在5090上,甚至在 8×B200 上也有人复现。这说明它不是 7900 XTX 独有的“算力不够”,而是 SGLang 调度策略本身存在的问题。https://github.com/sgl-project/sglang/issues/32549
SGlang官方我找到一个最近八月的帖子,这个 PR 非常值得关注,而且几乎就是冲着我们遇到的问题来的。https://github.com/sgl-project/sglang/pull/34058
-
它明确写了当前 scheduler 的问题:只要有 eligible prefill,就会优先跑 prefill,decode 可能被无限期饿死。这和我实测的“B 64K prefill 时,A 直接 45–50 秒无 token”高度一致。
-
列表它加了一个新参数:--max-consecutive-prefill-batches N。 含义应该是:连续跑了 N 个 prefill batch 后,如果有 decode 可跑,就强制下一轮让 decode 先走一次。我周末找时间会测试一下。
-
PR 还特别说明:单纯把 chunk 从 4096 改成更小并不能解决 starvation,因为优先级逻辑没变。这个和我上周末 4096→2048 完全没改善的实测正好吻合。
所以我感觉这个 PR也许相关跟目前的问题高度相关,会有针对性修复。我会继续关注。
顺便说下,搜了一大圈,ChatGPT告诉我,7900 XTX / gfx1100 上把 SGLang、MTP、多并发这些东西折腾得最前沿、最系统的实战案例,就是flyer666在 lcz.me 这个论坛发的这条帖子。 flyer666真大神也
。 -
@Xiaote 华擎X570 可以的,有4槽宽,带双pci x16的接口。
-
@terry @flyer666 @farmer-node 各位大佬
好消息:PR #34058 实测有效,
N=1基本解决 long-prefill starvationhttps://github.com/sgl-project/sglang/pull/34058
前面说周末准备测一下,结果没忍住,上班摸鱼已经全部跑完了

测试环境还是 双 7900 XTX + SGLang gfx1100 + TP2 + MTP3 + BF16 KV,严格 C2(双并发):
模拟 A 64K 已经在 decode → 5 秒后 B 加入 64K fresh prefill。
--max-consecutive-prefill-batches实测结果:N A 最大断流 B 64K TTFT 0(原版) 47.23s 49.43s 1 4.04s 
49.48s 2 7.70s 49.21s 3 11.70s 49.05s 4 13.80s 49.37s 8 25.76s 49.24s 16 47.05s 49.24s 最关键的是:
- N=1:47.2s → 4.04s,断流下降 91.4%
- B 的 TTFT 和 prefill throughput 基本完全没损失
(说人话就是:双 7900 XTX 这套配置,第二个对话B的64K fresh prefill 本来就是要大约 49 秒才能出第一个 token,这是7900XTX规格上限决定的;加了新参数后,这个 49 秒几乎没变,但 A 不再陪着 B 一起“饿死”,N=1的情况下,B的性能没有损失) - N 越大,越逐渐退回原来的 prefill-first
- N=16 已经几乎等于 N=0
所以这个参数本质上就是一个 prefill / decode fairness 旋钮。在我的 workload 下,N=1 是明显甜点位。
C3(三并发)也补测了:原来 A/B 最大断流 67.7s / 18.5s,N=1 后变成 4.11s / 3.03s,三路正常跑,没有再出现几十秒冻结。
理论上讲,这下终于有点真正 1+1>2 的味道了。但是我周末还是要模拟实际操作再仔细测试一遍。
顺便把 ROCm 版本也重新测了一遍
这次统一使用 PR #34058 + N=1,所以 C2/C3(双并发 / 三并发)不再被原来的 starvation 干扰。
测试上下文大致是:
- C1:约 64K / 65.5K tokens
- C2:A ~65.5K + B ~65.5K fresh
- C3:A ~65.5K + B ~65.5K + C 32.7K fresh
指标 ROCm 7.2.3 ROCm 7.14 ROCm 10 C1 64K prefill 1338 tok/s 1351 1146 C2 prefill 1343 1358 1156 C3 prefill 1331 1349 1155 C2 B TTFT 49.78s 49.23s 57.35s C3 C TTFT 65.99s 64.85s 75.33s C2 A max gap 4.07s 4.04s 4.95s C1 decode 62.2 tok/s 66.4 74.1 注:以上C1 decode 单并发的推理速度是在64K长上下文条件下测得,对于7900XTX来说已经是相当能打了。
说下初步结论:
- SGLang这个新参数:实测有效,改善明显。
- ROCm 7.14:整体比 7.2.3 略快,尤其 decode +6.8%,我准备把我的生产环境搬迁到这个版本。
- ROCm 10:decode 非常猛,+19%;但 64K cold prefill 慢约 13–14%,TTFT 也多约 14–15%。
所以 ROCm 10 是很典型的decode benchmark 更快,但 long-context Agent 反而更慢。 但是毕竟ROCm10 才刚发布不到一个月,未来可期,持续关注中。
目前我的生产还是 ROCm 7.2.3 + PR #34058 + N=1。下一步准备升级到7.14再直接跑真实 2 个高频 + 2 个偶发 Agent,看看长期体感。
这次最大的好消息就是:
之前 SGLang 那个“新 long prefill 一进来,其他 Agent 全冻几十秒”的问题,至少在我的机器上的理论测试已经从 47 秒压到约 4 秒了。多并发实战体验待我测完在做进一步汇报
-
@terry @flyer666 @farmer-node 各位大佬
好消息:PR #34058 实测有效,
N=1基本解决 long-prefill starvationhttps://github.com/sgl-project/sglang/pull/34058
前面说周末准备测一下,结果没忍住,上班摸鱼已经全部跑完了
测试环境还是 双 7900 XTX + SGLang gfx1100 + TP2 + MTP3 + BF16 KV,严格 C2(双并发):
模拟 A 64K 已经在 decode → 5 秒后 B 加入 64K fresh prefill。
--max-consecutive-prefill-batches实测结果:N A 最大断流 B 64K TTFT 0(原版) 47.23s 49.43s 1 4.04s 49.48s 2 7.70s 49.21s 3 11.70s 49.05s 4 13.80s 49.37s 8 25.76s 49.24s 16 47.05s 49.24s 最关键的是:
- N=1:47.2s → 4.04s,断流下降 91.4%
- B 的 TTFT 和 prefill throughput 基本完全没损失
(说人话就是:双 7900 XTX 这套配置,第二个对话B的64K fresh prefill 本来就是要大约 49 秒才能出第一个 token,这是7900XTX规格上限决定的;加了新参数后,这个 49 秒几乎没变,但 A 不再陪着 B 一起“饿死”,N=1的情况下,B的性能没有损失) - N 越大,越逐渐退回原来的 prefill-first
- N=16 已经几乎等于 N=0
所以这个参数本质上就是一个 prefill / decode fairness 旋钮。在我的 workload 下,N=1 是明显甜点位。
C3(三并发)也补测了:原来 A/B 最大断流 67.7s / 18.5s,N=1 后变成 4.11s / 3.03s,三路正常跑,没有再出现几十秒冻结。
理论上讲,这下终于有点真正 1+1>2 的味道了。但是我周末还是要模拟实际操作再仔细测试一遍。
顺便把 ROCm 版本也重新测了一遍
这次统一使用 PR #34058 + N=1,所以 C2/C3(双并发 / 三并发)不再被原来的 starvation 干扰。
测试上下文大致是:
- C1:约 64K / 65.5K tokens
- C2:A ~65.5K + B ~65.5K fresh
- C3:A ~65.5K + B ~65.5K + C 32.7K fresh
指标 ROCm 7.2.3 ROCm 7.14 ROCm 10 C1 64K prefill 1338 tok/s 1351 1146 C2 prefill 1343 1358 1156 C3 prefill 1331 1349 1155 C2 B TTFT 49.78s 49.23s 57.35s C3 C TTFT 65.99s 64.85s 75.33s C2 A max gap 4.07s 4.04s 4.95s C1 decode 62.2 tok/s 66.4 74.1 注:以上C1 decode 单并发的推理速度是在64K长上下文条件下测得,对于7900XTX来说已经是相当能打了。
说下初步结论:
- SGLang这个新参数:实测有效,改善明显。
- ROCm 7.14:整体比 7.2.3 略快,尤其 decode +6.8%,我准备把我的生产环境搬迁到这个版本。
- ROCm 10:decode 非常猛,+19%;但 64K cold prefill 慢约 13–14%,TTFT 也多约 14–15%。
所以 ROCm 10 是很典型的decode benchmark 更快,但 long-context Agent 反而更慢。 但是毕竟ROCm10 才刚发布不到一个月,未来可期,持续关注中。
目前我的生产还是 ROCm 7.2.3 + PR #34058 + N=1。下一步准备升级到7.14再直接跑真实 2 个高频 + 2 个偶发 Agent,看看长期体感。
这次最大的好消息就是:
之前 SGLang 那个“新 long prefill 一进来,其他 Agent 全冻几十秒”的问题,至少在我的机器上的理论测试已经从 47 秒压到约 4 秒了。多并发实战体验待我测完在做进一步汇报





