
RTX8000/2080Ti/V100是否值得买?前AI世代老显卡缺乏BF16是硬性残疾,SGLang和ComfyUI支持都不好!
-
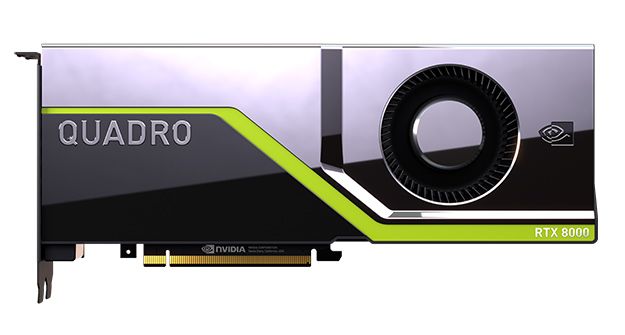
评论区有人让我谈一谈 RTX 8000 这张卡。我到论坛找了一下,上一个相关帖子还是两个星期之前有人发的。我不知道是不是卡贩子在点我,但这张卡其实没有什么好谈的,它就是一个 48G 的 2080 Ti,或者说比 2080 Ti 略强一点点的 48G 版本。现在卖 11000 元,纯属智商税,妥妥的工业垃圾。
你买它还不如买两张 2080 Ti,因为买 RTX 8000 的主要目的无非就是为了大显存。48G 显存拿来干什么?你可以跑 Qwen 27B,但你也不能很好地拿它跑 ComfyUI,因为图灵架构的卡没有 BF16 支持,FP32 原始算力也不算强,所以跑 ComfyUI 的时候非常吃力。即便是跑大模型,说实话它对 SGLang 的支持也不好,可能用来跑 llama.cpp 体验还不错,但这种情况下,你为什么不买双卡跑 TP 呢?llama.cpp、SGLang 的体验都会比单卡 RTX 8000 更好,而且双卡 2080 Ti 现在好像并不贵,应该几千块钱,白菜价。
那你说,我这个 48G 大显存拿来跑 MiniMax H3 行吗?可以跑应该是可以跑的,但是速度应该比较智障,完全不值得。你不如把这个钱拿去买一个 32G 的 R9700,跑起 MiniMax H3 绝对吊打它,跑大模型也比它爽。
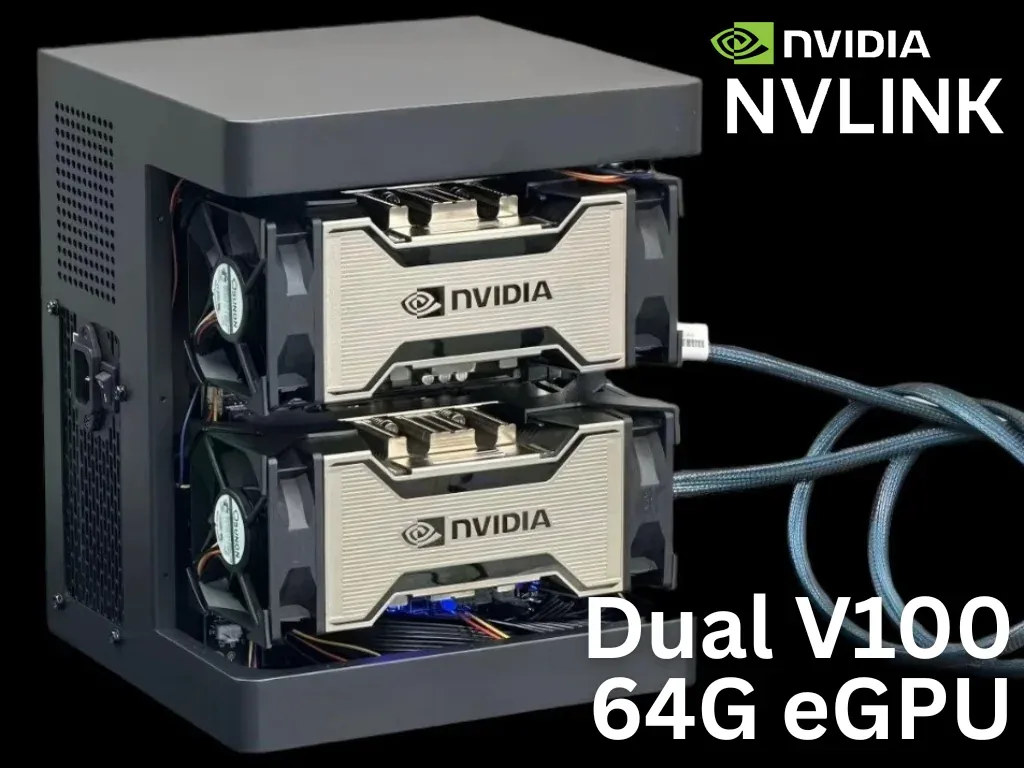
再来看很多人反复提到的 V100。就这么一个玩意,配上一个洋垃圾平台,在闲鱼上就能卖到 15000 元。两张 32G 的 V100 凑成 64G 显存,妥妥的都是智商税。你也只能跑 Qwen 27B,也跑不了其他更大的模型,然后速度还慢。你花 15000 元,我靠,这个钱你不如买张 4080S 32G,随便配一个洋垃圾平台。我可以说,无论是跑大模型,还是跑 ComfyUI,都吊打这两张 V100。难道就是因为它这个造型看起来比较敦实吗?
我并不是说买这些卡的都是交了智商税,或者说这些人都是傻逼。论坛确实也有很多关于 2080 Ti、V100 的帖子,数量还不少。讲实话,如果你在看我的视频之前已经买了这些卡,属于“49 年加入国军”,现在想抢救一下、利用一下它,尤其是已经买了双卡的,那值不值得继续折腾呢?我认为还是值得的。虽然它跑 ComfyUI 很糟,但是回退到 FP16 跑 AI 大模型,比如跑 Qwen 27B,如果优化好了还是能玩的。只是你花了重金,然后只买到了 50% 的功能,心里面也是不痛快的。
下面给大家讲一些常识,就是 V100、RTX 8000 和 2080 Ti 到底属于什么水平。V100 是 SM 7.0,Volta 架构,第一代 Tensor Core;RTX 8000 和 2080 Ti 是图灵架构,属于 SM 7.5。
然后到了 3090 和 RTX A6000,它们属于安培架构。最重要的一点来了:到了 3090 这一代之后,就支持非常重要的 BF16 了,它的 FP32 原始算力也还是够看的。
当然,到了 4090 这一代又有提升,它支持 FP8、INT4。然后到了 5090,包括 RTX Pro 5000、6000,现在又支持 NVFP4,这是很重要的一个提升。但是这些提升都没有 BF16 重要,因为我们在跑本地小模型的时候,最重要的就是能够返回 BF16 来计算。至于能够实现全链路的 FP8 推理有没有提升?有,但是提升并没有那么明显。有没有 BF16,这才是质的区别。
因为 ComfyUI 也好,SGLang 也好,它们都针对 BF16 进行了大量优化。如果没有 BF16,V100 也好、RTX 8000 也好、2080 Ti 也好,在很多时候内核就会 fallback 到 FP16 上面计算,体验就非常糟糕。
这是 GPT 给我总结的:V100 和 RTX 8000 为什么这么尴尬?两者都没有原生 BF16。安培架构现在已经成为事实上的最低优化目标,这也是为什么我强调你一定要买 3090,或者买 7900 XTX 之后的卡。它们是 AI 世代的守门员,都原生支持 BF16。然后 3090 还是最后一代支持 NVLink 的个人消费卡,这一点非常好。
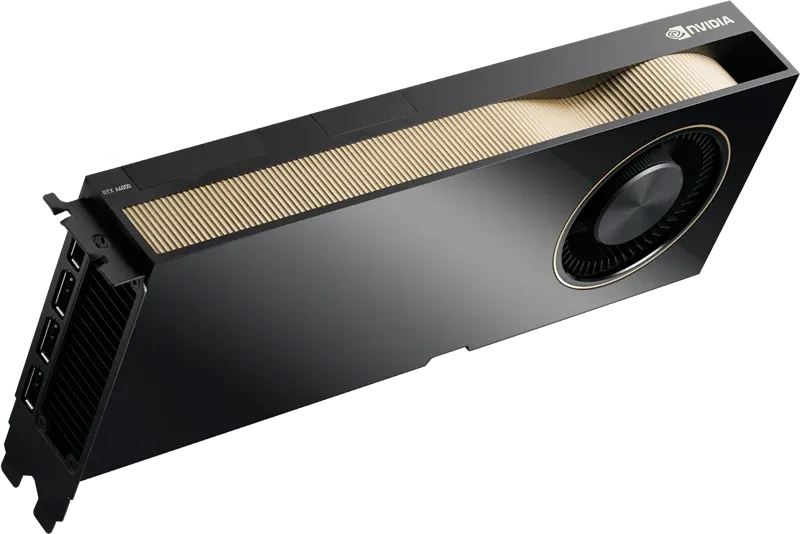
再跟大家讲一下一些硬件型号的区别。比如 RTX A6000,它是安培架构的卡,支持 NVLink,也支持 BF16,但是不支持 FP8,也不支持 NVFP4。它跟 3090 是同代的,拥有 48G 显存,价格也不便宜,但是由于支持 NVLink,所以也可以玩一玩,因为 NVLink 就值回票价了。
RTX A6000 跟 RTX 6000 Ada 还不一样。RTX 6000 Ada 是 Ada 架构的,跟 4090 同代,也是 48G。实际上你可以把它理解成 4090 48G 的官方版本。这张卡支持 FP8,比如跑 Qwen 27B,用 FP8 来推理也是可以的。有一些 ComfyUI 模型的主节点也可以用 FP8 来推理,只不过质量损失比较大,大部分时候还是要用 BF16 来推理。所以 4090 这一代相对于 3090,升级是有的,但是没有那么夸张。
5090 相比 4090 的升级就比较明显了。Blackwell 架构这一代的专业卡就是 RTX Pro 6000,Pro 6000 是十几万一张的卡,那肯定是吊打前面的这些卡。大家把型号搞清楚:RTX A6000 是 3090 同代,RTX 6000 Ada 是 4090 同代,RTX Pro 6000 是 5090 同代。
最后总结一下我的意见,很简单:V100 也好,2080 Ti 也好,它们现在单卡基本上都是废物。RTX 8000 48G 确实可以买回来玩 Qwen 27B,但是如果你还想用它画图、生成视频,那就想多了,速度一定慢得跟狗一样。
所以这些洋垃圾,2080 Ti 也好、V100 也好、RTX 8000 也好,现在就不要去碰了。这个时候再买这种卡,就是“49 年加入国军”。如果你已经有了,那就优化一下它们,忘掉这些卡即将被淘汰这件事,继续折腾、继续玩下去,我认为再玩个一年两年没问题。
最后我必须说一下,第一,我不是什么硬件都买了;第二,我也不是什么硬件都懂。很多时候我的表达也会有错误。我们论坛现在有几千人注册,每天都有大量帖子。我也让 AI 帮我总结了论坛讨论的各种型号,大家可以从不同话题的热度上来看一看。比如 7900 XTX 的帖子,拉了几轮都拉不完;再看看 2080 Ti 的帖子。如果 2080 Ti 真的像有些人想的那样有性价比,论坛的人都是傻子吗?
如果我的评论中有什么不当的地方,让你不爽了,还是欢迎你到论坛来发帖。很多时候我看到真实的测试数据,会给你们点赞,甚至给你们置顶。
-
GTX 960 不支持 NVLink,连 SLI 都不支持,别折腾了。
NVLink 是特定核心才有的:2080 / 2080 Ti、3090 / 3090 Ti、Titan V、V100、RTX 8000 这些。960 是 Maxwell,既没有 NVLink 也没有 BF16/FP16 加速,两张插一起只能各跑各的。
真想体验 P2P / NVLink,最低从 2080 Ti 起步。但要注意 Turing 和 Volta 一样没有 BF16,SGLang、ComfyUI 的新算子支持都差。主楼说 RTX 8000 / V100 是智商税,技术上是对的:显存大但架构老、无 BF16,同样的钱优先 3090 / 7900XTX / R9700。



