
5090 96G魔改卡靠谱吗?平替RTX Pro 6000还是骗局?为什么4090 48G好改,5090魔改难产?如何买到合适的显卡?
-
5090 96G 魔改卡这个事情,有不少人留言叫我评论一下。当然了,因为这个东西大家都拿不到,现在都是处于一个“云”的阶段。一旦涉及到云,那本频道就最擅长了。
之前我是很期待有 5090 96G 魔改卡这个事情的,但是后来我跟 AI 聊天的时候,它跟我讲,这个情况跟 4090 改 48G 还真不同。为什么呢?因为当年 4090 改 48G 的时候,它没有这个 eFuse SKU,就没有这个硬件熔断。这个 eFuse 是什么意思呢?就是 AI 解释了一下,说它会在硬件上面熔断,限制你去访问,比如说 96G 显存或者 48G 显存,它都不让你访问,你只能访问 32G 显存。这个主要是通过它的硬件通路,就是说它可以控制你的芯片能够支持多少个显存寄存器,那它理论上就能够控制你的显存上限。相信有一点硬件基础的朋友都能够听懂这个东西,甚至说你写过驱动程序的,都应该知道是怎么回事。这个东西在芯片内部进行了物理熔断,要不然 5090 96G 魔改卡早就出来了。
另外一个方面,就是说即便 eFuse 这一块是正常的,这个可能性是非常小的,那么英伟达还有 VBIOS 加 GSP 来控制。这个东西还涉及驱动程序签名、VBIOS 签名。当然了,英伟达像 4090 这种显卡,它可能不会太在意魔改卡出来冲击市场,可是你要知道,老黄现在正在卖 RTX PRO 5000、6000。RTX PRO 5000 一张卡就要卖五六万,然后 RTX PRO 6000 要卖十三四万,6000D 那都是大几万,RTX PRO 6000 的满血版可能 15 万以上了。
那你说这个时候弄一个 5090,把芯片从 5090 显卡上拆下来,重新给它打板贴片,你这个成本最多撑死给你增加一万块钱到头了,给你增加两万,那又怎么样?那你这个老母鸡变鸭了,这个时候山鸡变凤凰。到时候别说 RTX PRO 5000 你别想卖了,RTX PRO 6000 能不能卖动都不好说。所以说我认为在这一块老黄应该管控得会比较严格,短期内我觉得是不太现实的。即便这个东西有,它也不可能像 4090 48G 一样,在短期内形成非常强的一种生态,非常标准的生态。
这个生态大到什么地步?就连二手东,就连京东,我们的东哥都敢在自家的自营平台上面去挂 4090 48G 了。这个生态得有多成熟,你想一想,得有多少玩家介入。但是我相信东哥如果敢把 5090 96G 给它挂上去的话,老黄一定会告到他破产。这个东西说白了还涉及到蛋糕如何分配的问题。
所以说,第一,在技术上面我是不太相信它这么早出来的。它的技术难点,尤其是 eFuse 这一块,未必能够搞得定。就是说当年 40 系列没有对 eFuse 进行熔断、进行限制,这个可能有某种特殊方面的考虑,比如说要保住大陆市场。当然这些都是猜测了,或者说老黄当时认为要多打打生态,没有必要做得这么绝,凡事留一线,日后好相见。
可是 50 系英伟达是做了 eFuse 限制的,因为 50 系出来的时候,老黄已经是一统江湖了。他们讲实话没有必要讨好任何人,就是老子的卡不愁卖,你们想买都得排队。我这个时候为什么还要给你低端卡改高端留下空间呢?这个也不现实嘛。
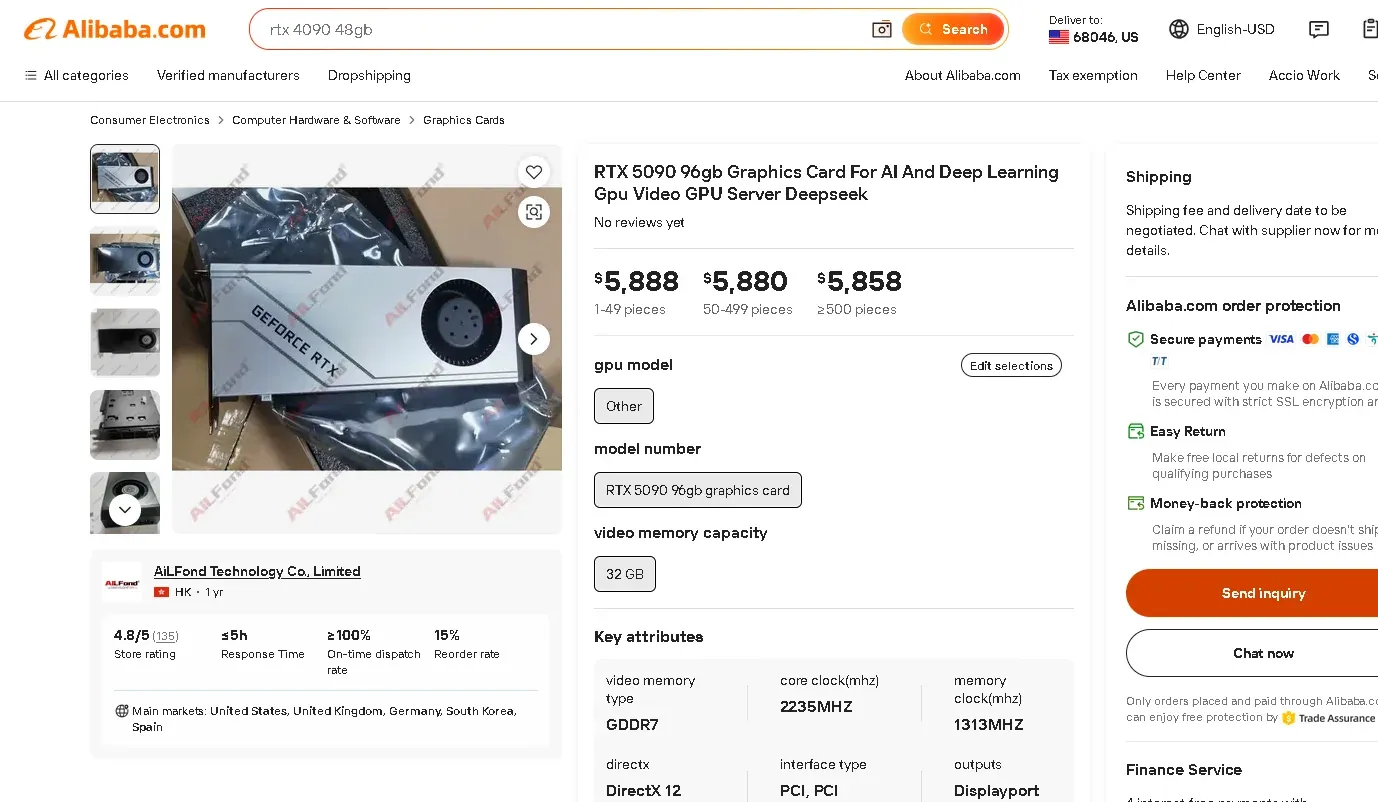
然后这个消息是从哪个地方来的呢?我就去搜了一下,是阿里巴巴网站上面有一家公司,挂了他们所谓的 5090 96G 定制卡。其实搞过阿里巴巴的朋友都应该知道,我就搞过阿里巴巴,你如果愿意发布的话,你发布一个原子弹上去都可以,只要你不被平台检测出来违规,你爱卖什么卖什么,这个参数随便你标。而且它早期版本标的参数是驴唇不对马嘴,根本就有很多明显的错误,估计就是为了引流。
但是无奈就是有很多人想要走捷径,想要占便宜。你看评论的人都是挺多的,但是大家都说不太好搞,说不太现实。你要知道,它一开始标价的时候,甚至标得比 5090 标准版还便宜,就有点智商税的意思了。而且你看一看,它说是 96G,但是产品又把显存显示成 32G。基本上我觉得是炒作、噱头,不太可能是真的。
然后我再说一下买硬件的事情。就是我之前不是在视频中多次强调嘛,我说我买东西要么是买蓝宝石、讯景,或者说华硕这些有自己售后渠道的。你不管从京东还是从第三方买,它在保修期之内都给你保修,有官方个人送修渠道。你不一定会坏,但是坏了的话,你有一个稳定的、免费的维修保障渠道,那你就可以省很多事。
要么就是你一定要买魔改卡,像我买的这个 4090 48G。我的 4090D 48G 比第三方要贵很多,要贵好几千块钱,但是我想我买来是干活的,三年的时间,二手东给我保三年。你想一想,你有什么品牌的售后服务能够跟京东比?我可以说,能够达到京东一半售后品质的显卡品牌都不存在。那你说这几千块钱值不值?
你就不要管你的卡是从哪个地方来的,是从哪个小作坊来的。你用京东自营,你就是跟京东形成了买卖关系,双方交易对象是你跟京东,没有第三方,没有品牌,跟它没有关系。坏了的话,不管这个小厂是跑路了还是没了,东哥都得给你保。
所以说前一阵子,我在视频中发布了京东有二手 3090 自营的,然后很多人还在说,他又在闲鱼,又在淘宝,或者在拼夕夕上买到了更便宜的。第一,我也去验证了一下,第三方还真没有比京东自营便宜,因为现在普遍 3090 都过万了,你买到的那些便宜的,基本都是一些烂卡。
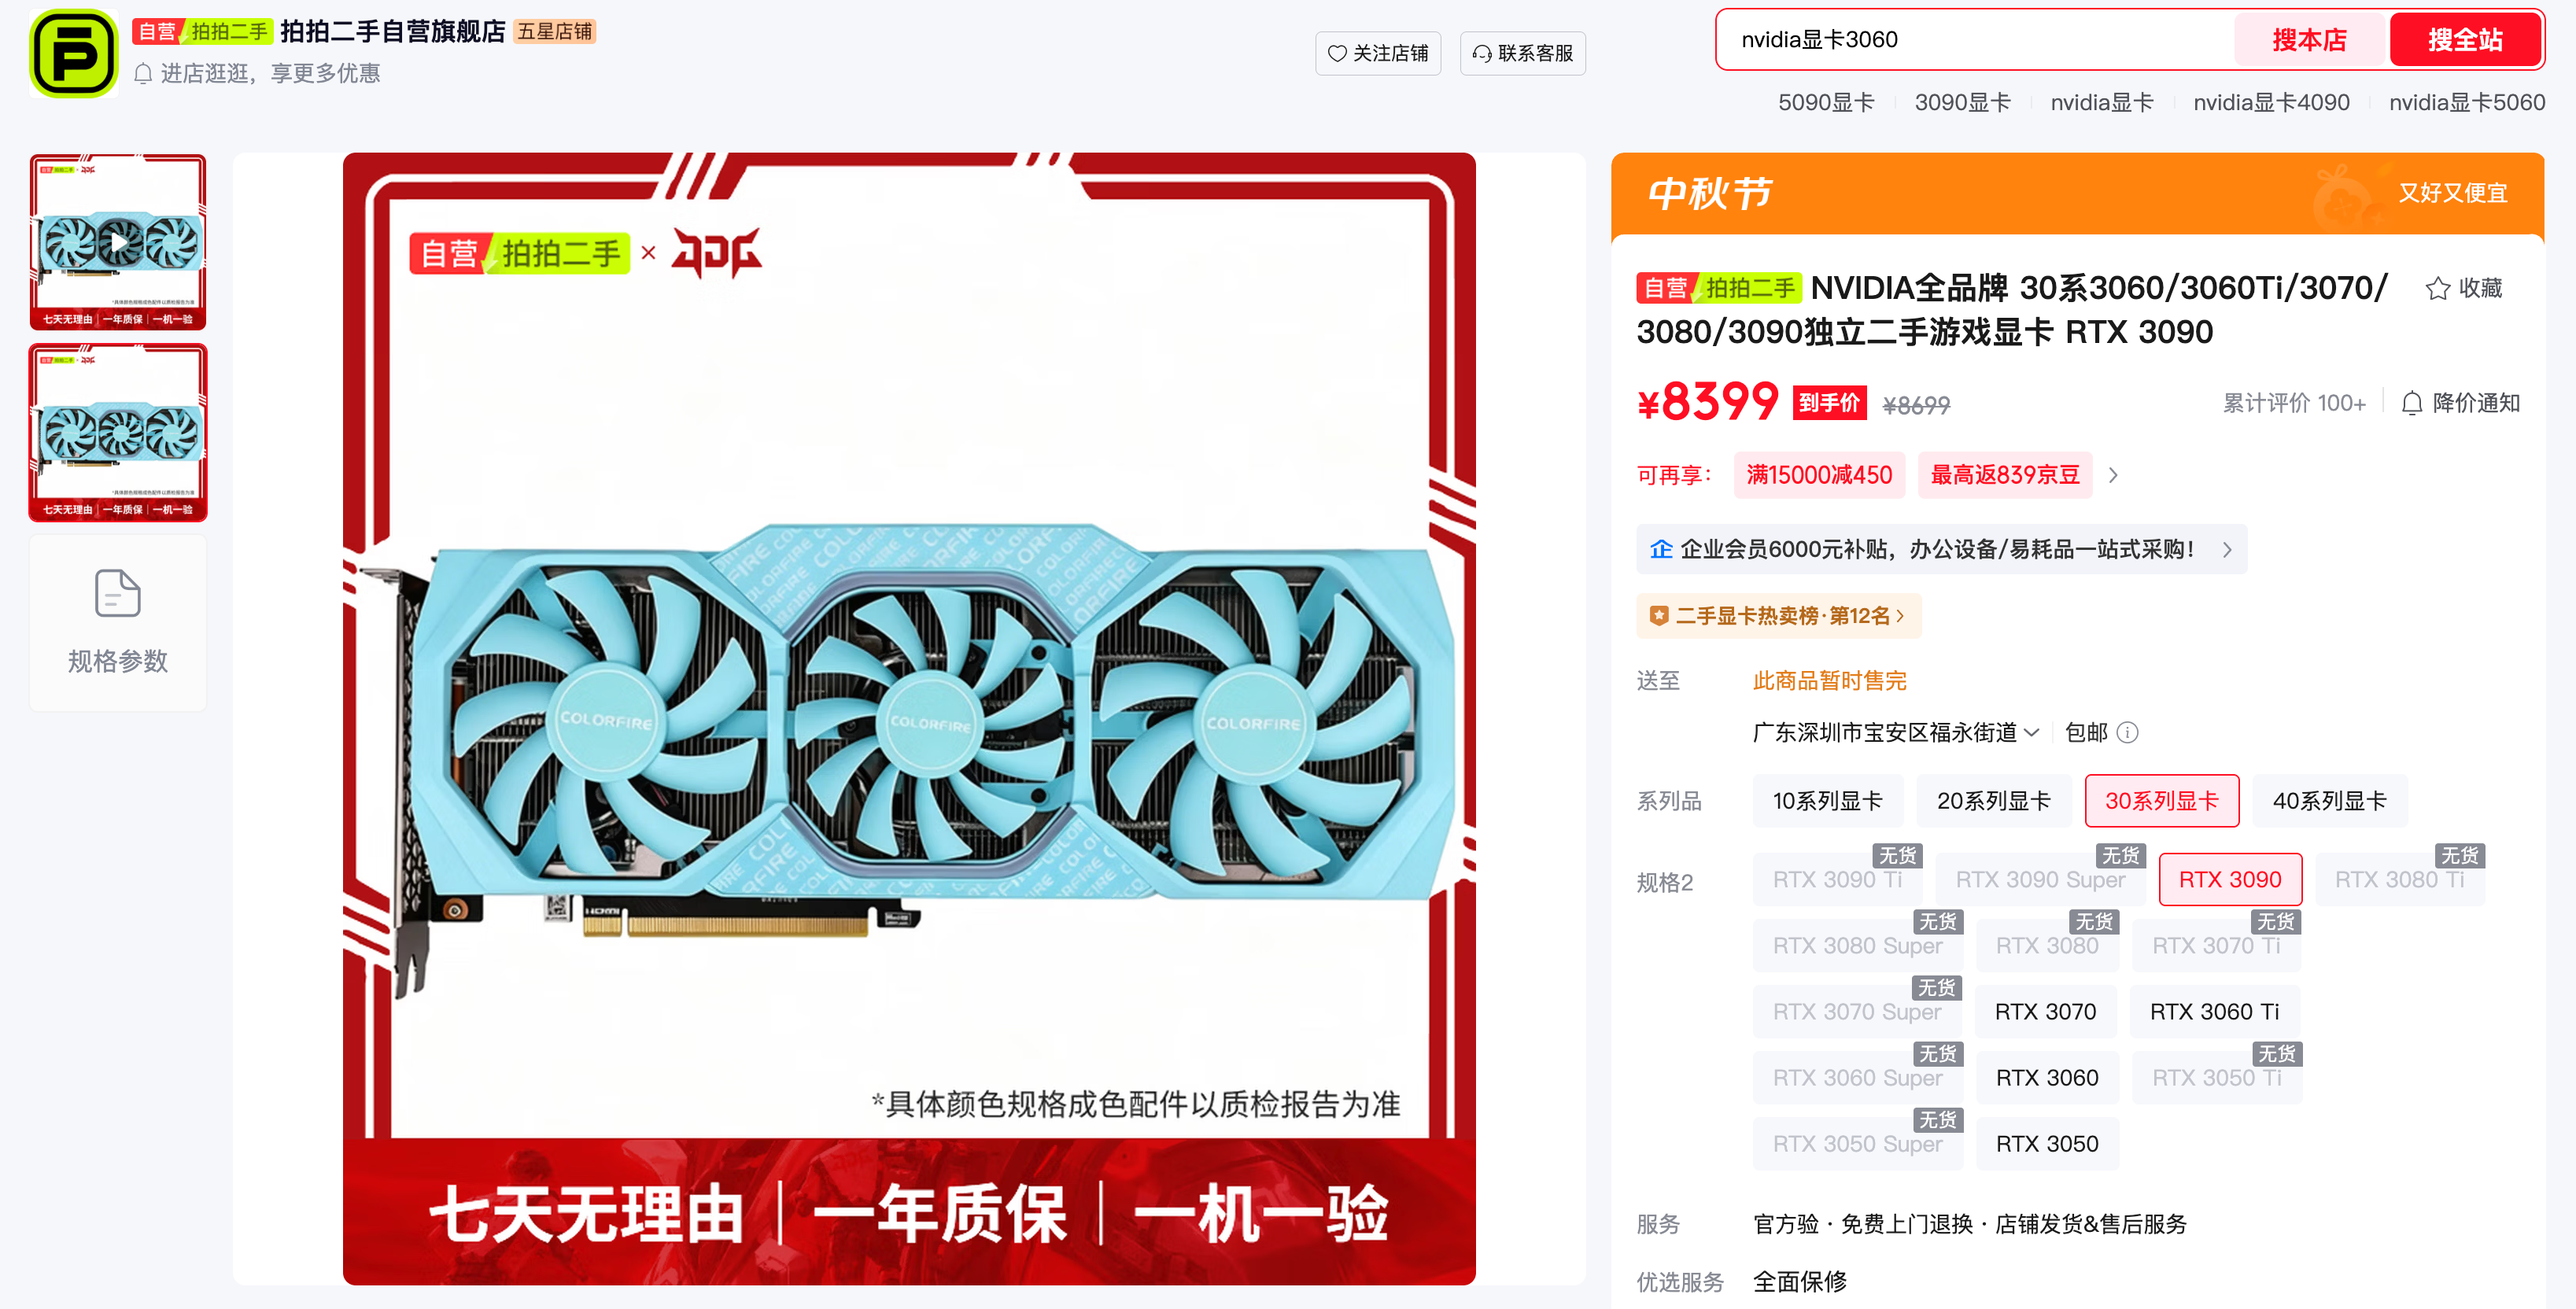
第二,有很多人留言质疑,说我是不是收了京东的钱。哥们,我相信能够买到京东自营二手 3090 的,那睡着都得笑醒了。关键是什么?京东自营二手它给你保修一年,你在闲鱼还是拼夕夕上,谁能给你保修?他们的保修承诺你能相信吗?
然后也有一些人留言跟我讲,说你发的这个链接我怎么没买到。兄弟们,你们有时间打嘴炮,有时间在这里喷口水的时候,就我跟你说的,你就抓紧去研究。东哥不是每时每刻都有货的,你看又开始放出来了。那天我说的时候是 8799,今天降了 300,但是我跟你讲,这玩意是没货的。给你点点看看……怎么又涨价了?这完全不靠谱啊。3090,你看,无货;3090 Ti 是一万出头,3090 是 8400,它现在都是一个无货的状态。
但是我并不会骗你们,这个东西是有人买到了。看看论坛,看到没有,这个 Gu YuAn,人家买到了,就问下面怎么配。有这个打嘴炮的时间,不要犹豫。我给你们建议什么,你们去买就对了。
我跟东哥能签订合同吗?你觉得京东这么大的企业,可能会跟我这个一万多人的小主播有什么利益关系吗?还什么我收了京东多少钱,你得有多脑残才能说出这样的话。我无非就是为了让你们买到合适的东西,然后到我的论坛发发帖子,感谢一下我,给我的论坛带来一点流量;在我的评论区发表一些评论,把我这个频道的流量做起来,我能赚点辛苦费。我能有什么其他的利益啊?
然后我再跟你讲,3090 这个东西,它 100% 是矿卡,因为 3090 就是挖矿最兴盛的那一代,它就是挖矿的主力。然后 3090 都已经停产不知道多少年了,根本就没有所谓的新卡了,连正经的二手卡,就是你个人用的二手卡都买不到了。早在闲鱼上面都被商家扫货,你一挂上去就被扫走了,然后再用这些卡上拆下来的芯片去给你重新打板贴片,这些都是小作坊做的。
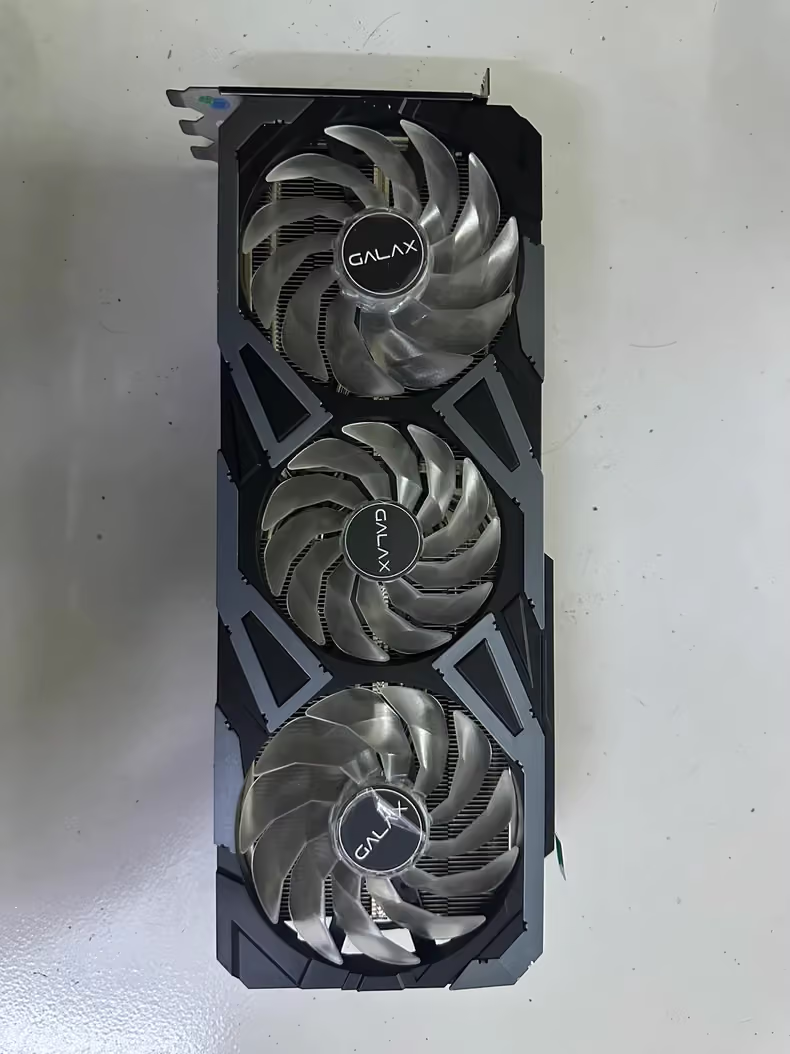
你怎么判定是不是小作坊做的?你就看东哥上不上。如果东哥自营上,那它就有可能是比较正规的大厂做的,一些代工厂,起码是二线的代工厂做的。如果京东自营不敢上,像那些涡轮卡,那它肯定是小作坊的产品。
就一分钱一分货,你不可能比任何人聪明,你买不到什么天上掉馅饼的这种便宜,这不可能轮到你的。但是东哥不一样,我都说了嘛,东哥人家是有钱人,人家不在乎这点蝇头小利,愿意给你出这个标准的二手卡,7 天无理由退换,一年质保,一机一验。
不要说“我也是在京东买的”。兄弟们,你都成年人了,二三十岁、三四十岁的人,你如果连“自营”这个标签是什么意思都认不到,那你还在这个世上混什么?看到没有,有“自营”,打“自营”的标签,你才是跟东哥签的合同,出了问题他才会保你。你不能在那个李鬼那里买,出了问题去找李逵,怎么可能呢?
然后我们又把话题回到 5090 96G 魔改卡这个事情上来。我跟你们讲,就算是以后这个产品线真的开放了,真的做出来了,真的稳定了,我说实话,我都不建议你们去买 5090 96G。原因非常简单,就是我现在用的是 4090D 48G 这个魔改卡。我这样跟你说吧,就 4090 这个功耗,我把我的 4090D 功耗限制在 375 瓦,或者有的时候给它限制到 350 瓦,它的发热是非常恐怖的。它那个涡轮把热量吹出去之后,打到我的墙上,我的墙面都是热的。你想想它发热到什么程度。
你再想一想 5090 的默认功耗是多少?默认的 TDP 是 600 瓦。兄弟们,你们知道这是一个什么样的概念吗?真的是一个火炉。而且 5090 它几乎是必然烧接口的,如果长期高负载工作,它几乎是必然烧的。就是说连消费级的电源都不好跟它适配,无论你换什么线、换什么接口,它烧的问题就不是说烧不烧,是什么时候烧、多长时间烧的问题。
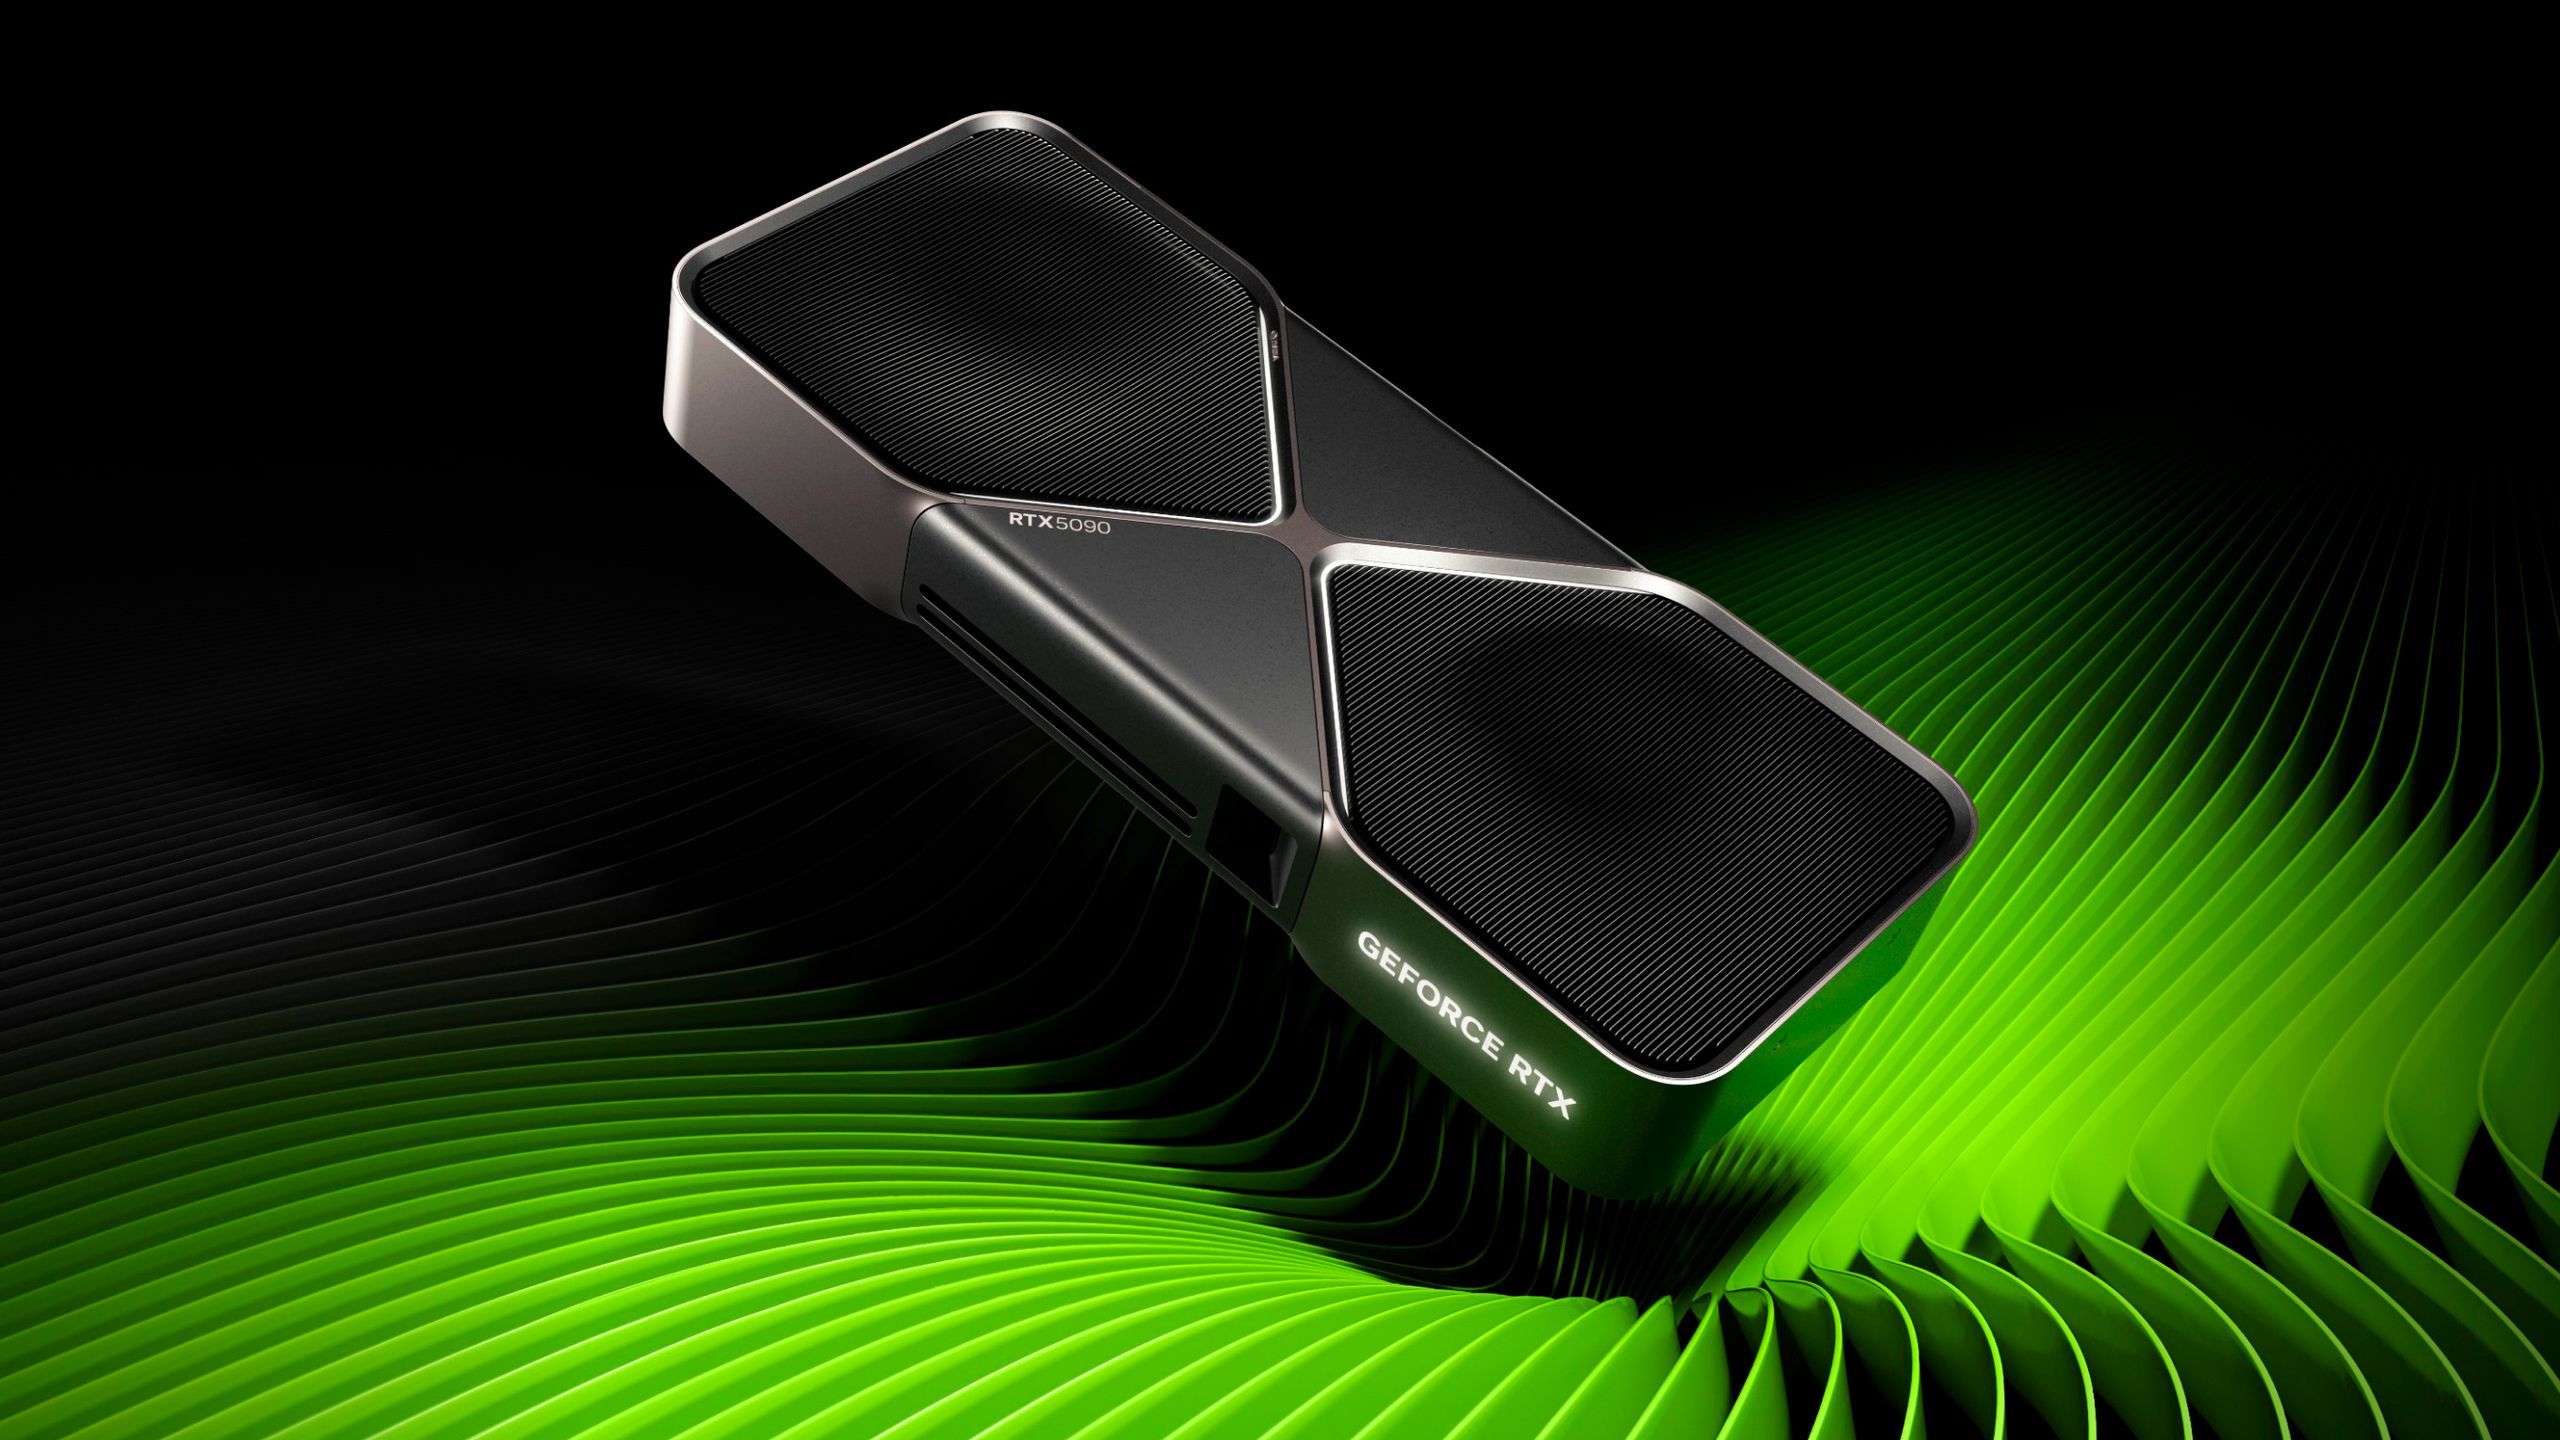
它跟标准的 RTX PRO 6000,虽然核心是一样的,但是它保留了太多跑 AI 不需要的功能,比如说游戏功能。这个就导致它运行的时候发热量非常大,而且它当时设计的时候也不完善,它比 RTX PRO 6000 早出来很长时间嘛。RTX PRO 6000 系列是经过专业设计的,而且走的是专业的 ECC 显存,并且是为了你长时间在这种服务器中高负载运行、不下线的那种运行,为了这种情况来设计的。那么它的可靠性肯定是要远远超过 5090。
我个人认为 4090 魔改卡已经是个人消费级显卡的极限了,就是说一些魔改的厂商,你们设计的极限基本上也就到这个水平了。
我们假设 5090 96G 出来,你说它卖多少钱合适?它的算力跟 RTX PRO 6000 是差不多的,略略差一点。你说能不能平替?基本上能够平替,就稍微矮一点的平替。在大部分时候,可能你都感觉不出来有多少区别。
那你说它卖多少钱呢?最便宜的 RTX PRO 6000,我们就算 Max-Q 版本的,它也得十二三万。那 5090 卖个七万八万,它不过分吗?如果是 96G 版本,你敢花七万八万块钱去买这样一张随时可能烧掉的卡吗?
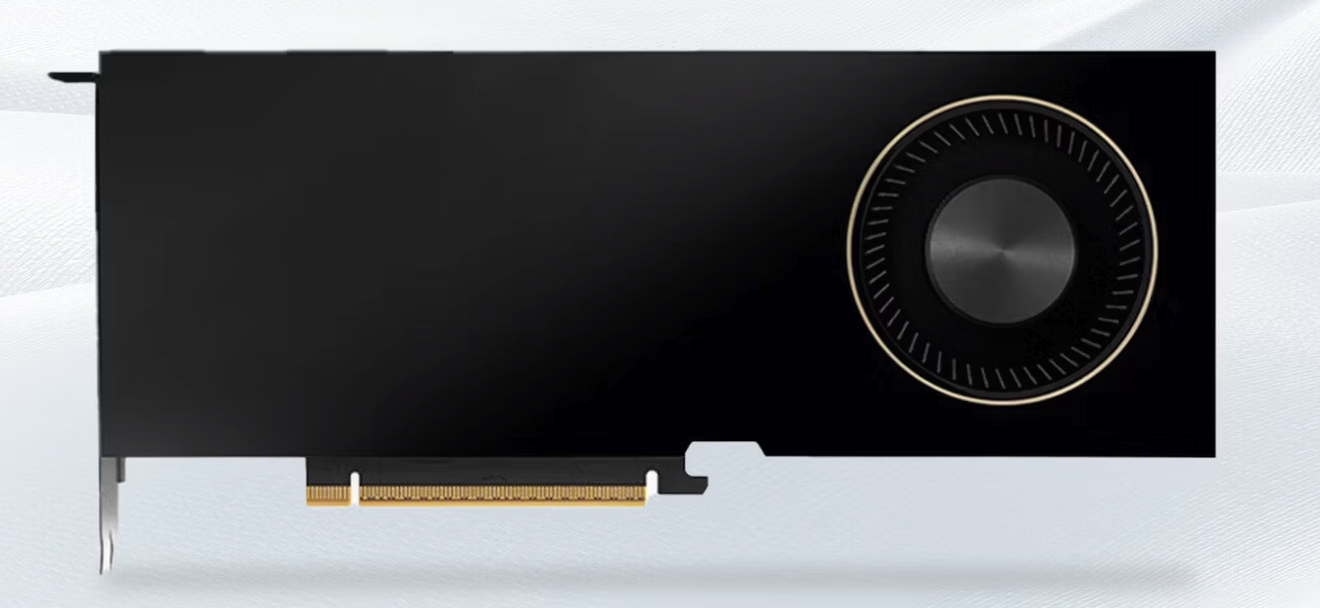
那最后只有一个可能,就是我们的东哥再度强硬起来,在自营上把 5090 96G 给挂上去。在此之前,我们都不要去尝试它。
当然了,如果你有钱,有的人就像我评论区有很多牛逼的人,非常厉害,人均 RTX PRO 6000,人均五张,现实生活中可能 3060 都买不起,就吹牛逼吹得很厉害。到论坛发第一个帖子,就是“我有三张 5090”。我都想在论坛加上一个规矩,以后必须要认证硬件才行,不认证硬件不许吹牛逼。
这个扯得有点远了。其实在论坛加一个认证功能,对于我来讲是非常简单的。但是咱都是穷屌丝嘛,只有穷屌丝才会去研究显卡这些东西,大家偶尔吹个牛逼也不是什么惊天的大罪,犯不着上纲上线的,也不用较真,我想就算了吧。
但是我希望评论区的各位,你们装逼有个限度,知道吗?不要在我面前吹太多。很多人讲实话,我杀过猪也见过猪跑,你们几斤几两,我一看你们发言,基本就能看个八九不离十。别装逼,大家凡事留一线,日后好相见。
-
-
我买rtxpro 4500 的时候,适逢 5090 也是一个价位,如果我不认识老特,我真的会买 5090, 幸好老特千交代万交代,聪明人一定听得进去。。。
老实说 我的 200w 吹出来的风也是让我惊心胆跳,进行中的温度都在 80 - 90度的,我会还得1 - 2 小时持续,
难以想象 600w 会怎样 -
-
-
5090自我熔断。不魔改也是正常现象。
这个技能可能是老黄做的第三把锁。前两个通过换板子,重写芯片有可能搞定。自我熔断一下就上升到规则级了。
-
一块卡毕竟不好玩, 真正要玩起来的, 还是多卡合适, 一卡 comfyui 一卡 大模型, 一卡小模型+干活 , 你一个pro6000的工作效率, 还真不一定比三块 4090 48g 来得好
@johnnybegood 2块4090 48G 或3块。不会在硬件体制上超过能魔改的5090 96G。硬件参数决定了一切。没有这种可能。
如果有,50系开发出来不就全无意义了吗?
同显存数下。如果输了 就违反了 物理定律。
简单的讲:看瓦数就行。600瓦虽然会熔断。但这个数值是真实的。
再有除了服务器。个人多卡只是投资跟不上。不要推导多卡胜过能力性单卡这种错误理论。
pro 6000的参数是加强版的5090
增强参数 :多实例(MIG) 最多切 4 个隔离实例个人主页:xlkj.org Telegram https://t.me/xlkjorg
-
@johnnybegood 2块4090 48G 或3块。不会在硬件体制上超过能魔改的5090 96G。硬件参数决定了一切。没有这种可能。
如果有,50系开发出来不就全无意义了吗?
同显存数下。如果输了 就违反了 物理定律。
简单的讲:看瓦数就行。600瓦虽然会熔断。但这个数值是真实的。
再有除了服务器。个人多卡只是投资跟不上。不要推导多卡胜过能力性单卡这种错误理论。
pro 6000的参数是加强版的5090
增强参数 :多实例(MIG) 最多切 4 个隔离实例@williamlouis 我的意思其实很简单, 你是个出租车公司的老板, 你有一辆奔驰接送客人, 和你有三辆凯美瑞接送客人, 哪种接的活更多,赚的钱更多呢? 我完全不是技术上,硬件规格上的比较,而是实际运营的比较。
-
出租车和显卡没有可比性。
-
在1张 pro 6000 96G 对2张 4090 48G 情况下。pro 6000 完胜。
1对3 4090 48G 可能在多模型的特殊前提下略胜一筹。只是一筹 ,优势很小。
1对4 在显存优势过大的前提下会胜出绝对的优势。
但这种折腾是无价值的。
公司或企业在有专业人士的情况下绝对会选2张pro 6000.
4张 魔改的闹心程度绝对是不可想象的。 -
这场争论其实是两个维度混在一起:容量 vs 算力,而「能不能叠」取决于互连。
- 单卡能不能被多张便宜卡替代,先看工作集。权重 + KV 一起塞得进单卡显存,那张卡就是最省事的;塞不进要切分,就要跨卡通信。
- 消费卡没有 NVLink / P2P 时,TP 每层都要同步,PCIe 4.0 x8/x16 会限制扩展效率;PP / 按层切分通信少,但 pipeline bubble 和负载不均衡又是新问题。所以「3×4090 48G 顶一张 PRO 6000」只在 batch 小、通信占比低、且任务能整卡分片(一张卡一个模型/一个 pipeline 阶段)时大概成立,不是通例。
- 「600W 是真实数值」「PRO 6000 是加强版 5090」在单卡算力口径没错;「运营上多卡接更多活」在吞吐/多租户口径也成立。两边比的不是同一件事,不用互相说服。
- 实操判断看四个数:单卡显存/总显存、模型要不要跨卡、卡间有没有 P2P/NVLink、并发量。容量 bound 的活(大模型、大 KV)单卡大显存赢;算力 bound、可并行的活多卡摊。魔改卡的隐性成本(掉卡、驱动、保修)也要算进 TCO。
一句话:不是「多卡胜过单卡」或反之,而是先定工作集和互连,再谈张数。
-
-
Jason-Lu 说:
5090魔改已经摸过了。性能比想象的强。
在同一台8卡魔改5090(单卡96G)上用vLLM跑的三组部署实测:Qwen3.5-122B-A10B-FP8单副本(TP=8)、DeepSeek-V4-Flash单副本(TP=8)、DeepSeek-V4-Flash双副本(TP=4x2)。每组都记录了每卡显存占用,并在并发1/8/16/32/64/128/256上扫描输出吞吐与延迟,另外测了2K/8K/32K输入的长上下文prefill缩放。结论是两套模型都能在这台机器上稳定服务:122B-FP8单副本在并发256达到4,302tok/s的输出饱和点;DeepSeek-V4-Flash单副本在并发128达到5,082.83tok/s,双副本在2026-09-13复测中把两个副本的端口一起施压,每副本并发256(合计512)达到12,672.88tok/s,约为单副本的2.5倍。
-
-






