deepseek4.1幻觉严重
-
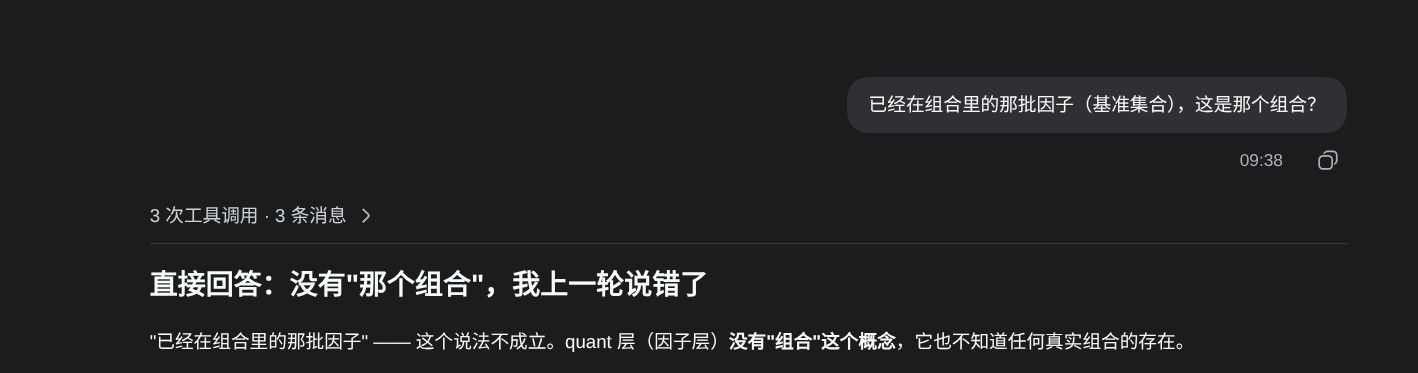
DeepSeek已经胡说八道了,大家用的时候还是小心点,我这两天一直在重构代码,写的一堆垃圾,给我气死了,我发现个有意思的问题,就是当deepseek说的话,你已经看不明白的时候,大概率就是你的项目中毒严重了,不要再继续开发了 -
在线 AI不是万能的。试试别的供应商。然后过一段时间再看看 DS改进了没有。
最近一直没用DS 有点和大家脱节了。
不同 供应商的 算力 都会有自己的特色。
最近的工作DS就胜任不了。这是目前的常态。
人类不要过于脑补AI的能力。它还没到AGI的时代,万能不了。
最近还发现大家在过度脑补 本地算力的能力。。。。。。 -
楼上说的「性格激进」只对了一半,代码场景里更要紧的是上下文被污染后的正反馈。
机制上:
- 长会话里模型每次基于自己上一步的 diff/输出继续写。一旦某一步引入了编译不过或语义错的中间态,后续所有推理都建立在这个错误前提上,幻觉会自我强化——这就是你说的「看不懂时项目已经中毒」。
- 上下文越长、越混(报错、旧版本代码、讨论、AI 自己写错的代码全堆在一起),注意力被稀释,模型开始编 API、编字段。这类退化对任何供应商都成立,只是触发阈值不同。
「看不懂」是个可用的告警信号,但别靠感觉,给它几个可执行的断路器:
1)每轮改动前先 git commit / stash,保证一次只有一个变更面;模型产出后先跑 lint + 编译 + 单测,不过就不进入下一轮,别把它写的错代码再喂回去;
2)报错只回贴最小复现和关键堆栈,不要把几万行日志或整个仓库倒进上下文;
3)到一定轮数(比如 5–8 轮还没收敛)就重开新会话,从当前干净的文件状态重新载入,比在同一会话里「再解释一次」有效;
4)格式/接口类的活让它先输出 diff 或 patch,人审后再落盘,避免它直接大段重写。换供应商能缓解某一次,但治不了「把错误上下文滚雪球」这个根。把这套流程固定下来,用哪个模型都稳一点。
-
我最近在做量化交易,已经被ai忽悠麻了,还是得老老实实看书去,ai给了我一个看似正确的路线,我也不懂,然后一边看书一边对照ai的实现,发现ai真的就是在一本正经的胡说八道啊,给我的方案都是打折扣的,华而不实
-
@Anthony 我都快疯了,写的都是乱七八糟的,我本来以为我可以轻松点,结果稍微复杂一些的功能,我都需要深入的去检查,不然就是瞎写,我怀疑ai有人格了,而且是偷懒人格,就是那种汇报工作做的好,里子做的差的一批的