【硬核实测】12GB 显存的极限救赎:我的 MiniMax H3 本地生成与 4K 超分工作流
-
适用人群:
- 想跑 MiniMax H3 / Ref2VA / FL2VA
- 想做长视频、动作戏、打斗、镜头衔接
- 想在有限显存下追求画质最大化
🟥 为什么 12GB 显存也能跑长视频?
AI 视频推理显存需求动辄 24GB+,但通过 精度压缩、分段推理、显存碎片管理、软硬件分治,12GB 卡依然能做到:
- 长视频分段生成(>60 秒)
- 高动态动作戏稳定推理
- 4K 超分放大(RTX VSR)
- 画质不衰减的连续镜头
下面是完整的工作流拆解。
🟦 一、硬件与环境约束
 ️ 核心配置
项目 配置 GPU RTX 5070(12GB VRAM) CPU Ryzen 5700X RAM 64GB 存储 SSD (48GB虚拟内存)
 稳定策略:功耗墙锁死 80%
锁功耗墙的好处:
- 避免瞬时电流尖峰导致黑屏
- 显存颗粒温度更低
- 长时间推理不掉帧
- 显卡寿命更健康
- 性能下降不足5%
🟦 二、模型与推理工作流(ComfyUI)
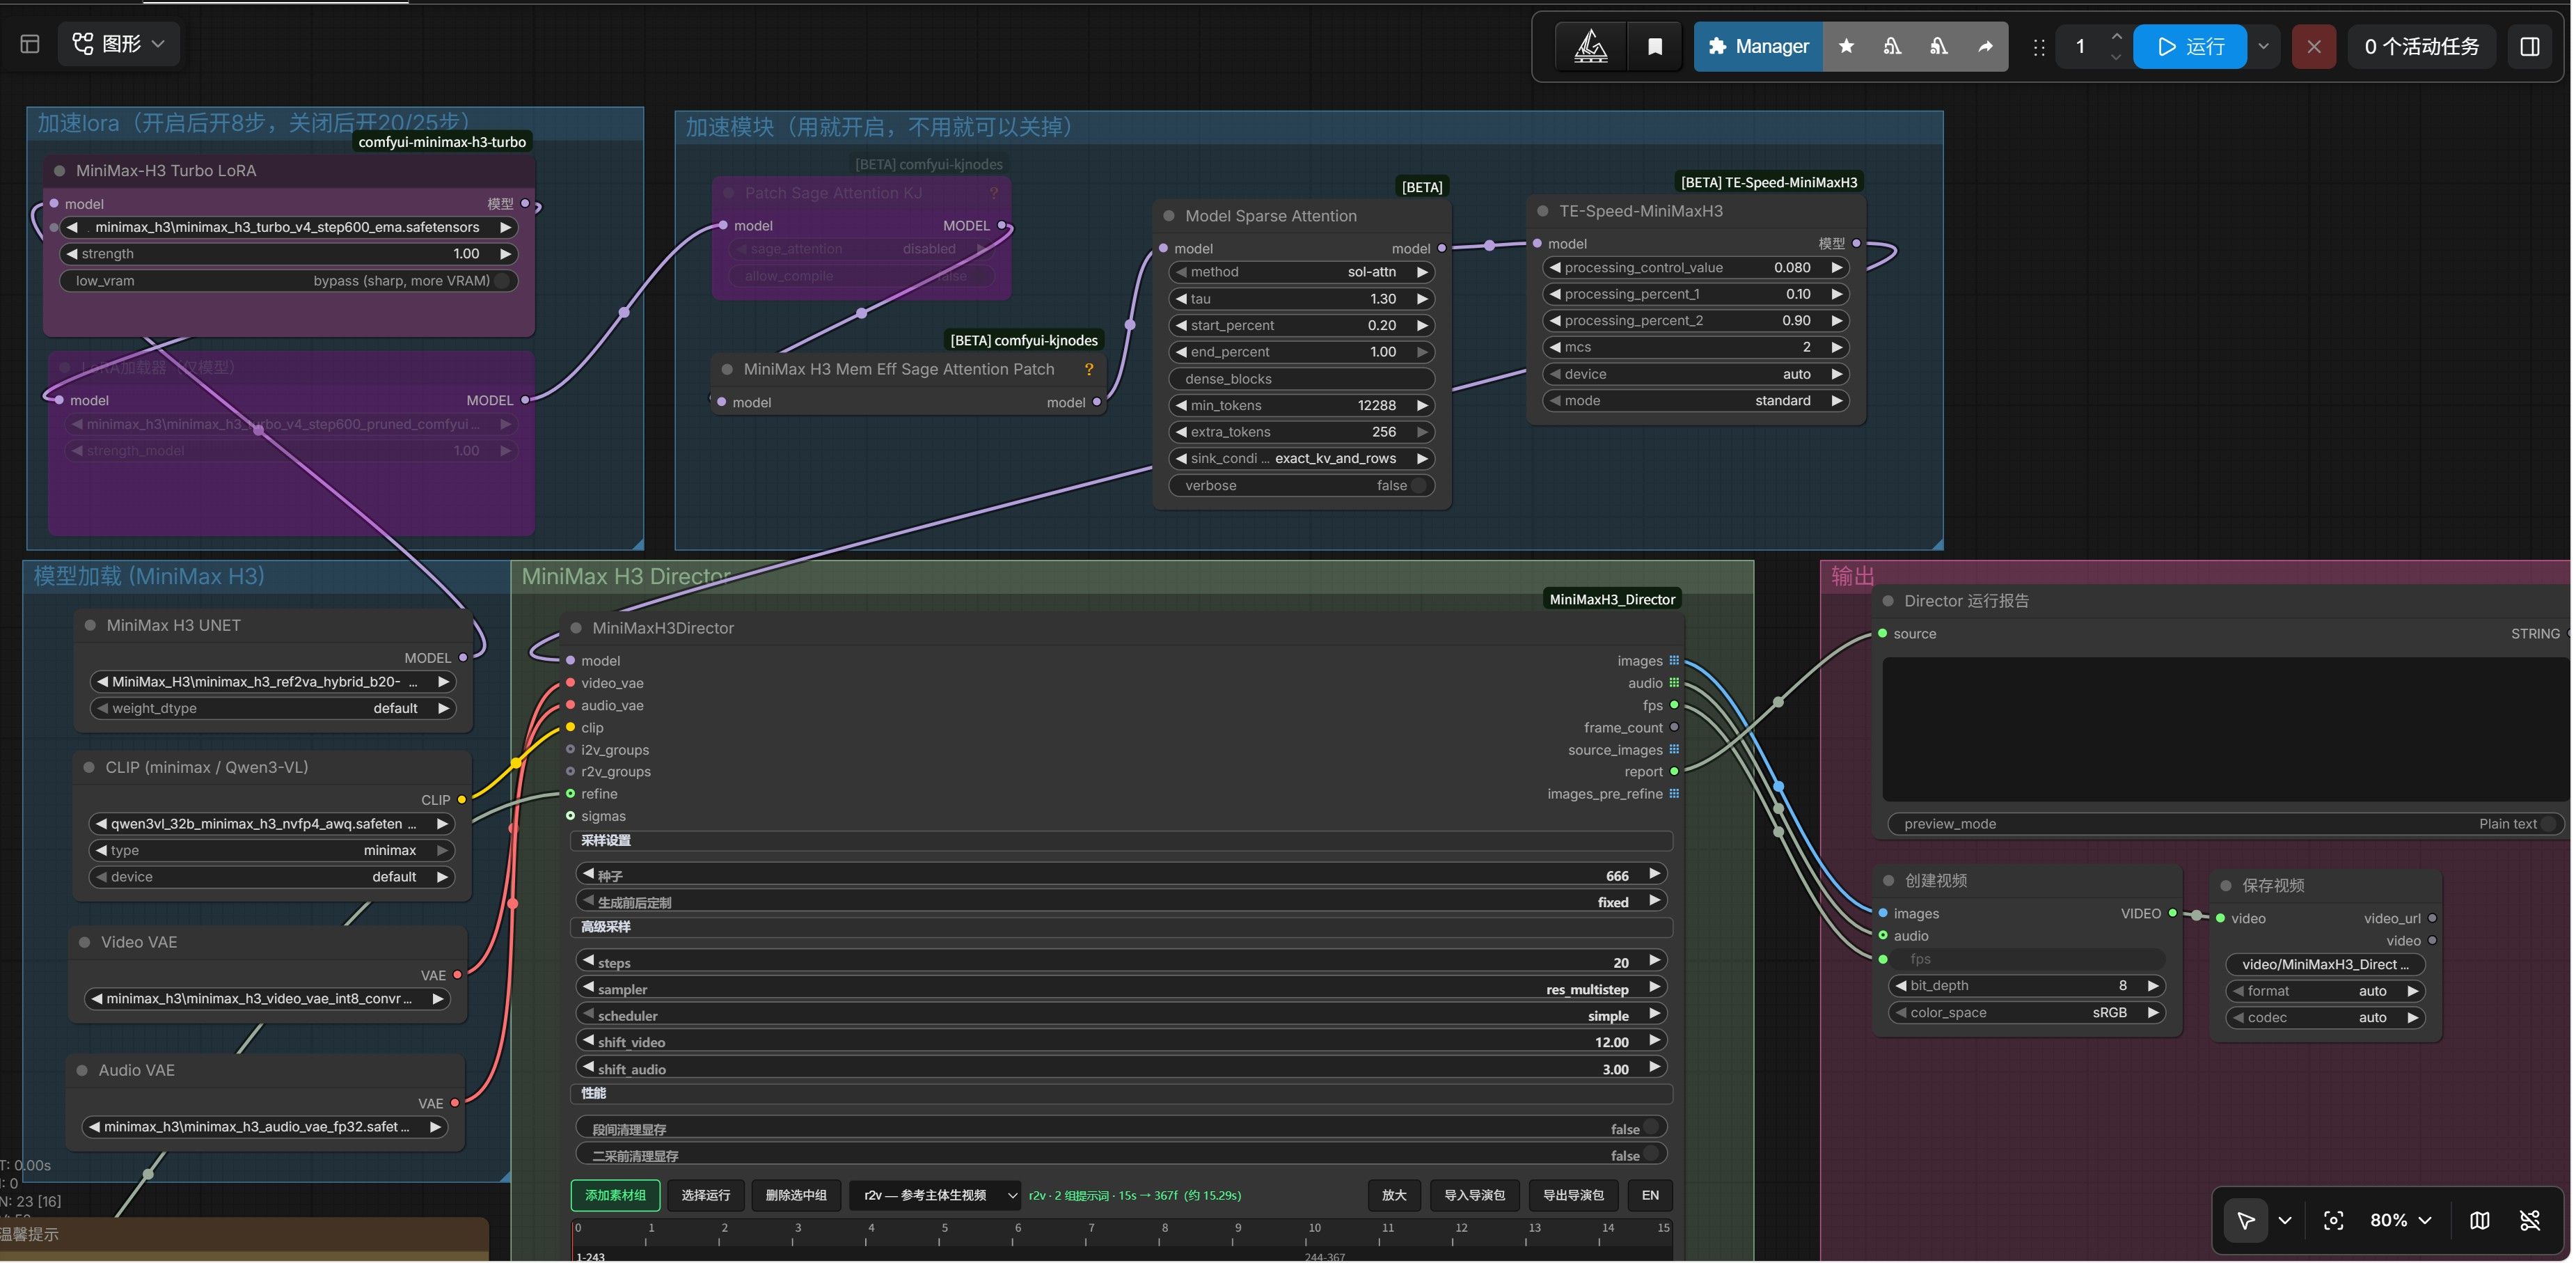
🧬 1. 混合权重(Hybrid)
兼顾 Ref2VA 的可控性 与 FL2VA 的画质:
minimax_h3_ref2va_hybrid_b20-49_pruned_w4a8_mixed.safetensors
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
minimax_h3_video_vae_int8_convrot.safetensors
minimax_h3_audio_vae_fp32.safetensors
加速 LoRA:
minimax_h3_turbo_v4_step600_ema.safetensors
 ️ 2. 精度方案:W4A8(黄金分割点)
精度 显存占用 画质 推荐度 FP16 高 优秀  12GB 不稳
INT8 ConvRot 中 良好  可用
W4A8 低 良好  最佳平衡
NVFP4 低 良好 50系专用
 3. 加速引擎
- MiniMax H3 Mem Eff Patch / Sage Attention Patch
- Block Sparse Attention
- TE-Speed-MiniMaxH3 (3.5+)
三者组合可减少 35–50% 推理时间。
 4. 动态步数策略
场景类型 步数 10 秒0.5M视频推理时间 文戏 / 静态 6-step ~150s 动作戏 / 打斗 8-step ~200s
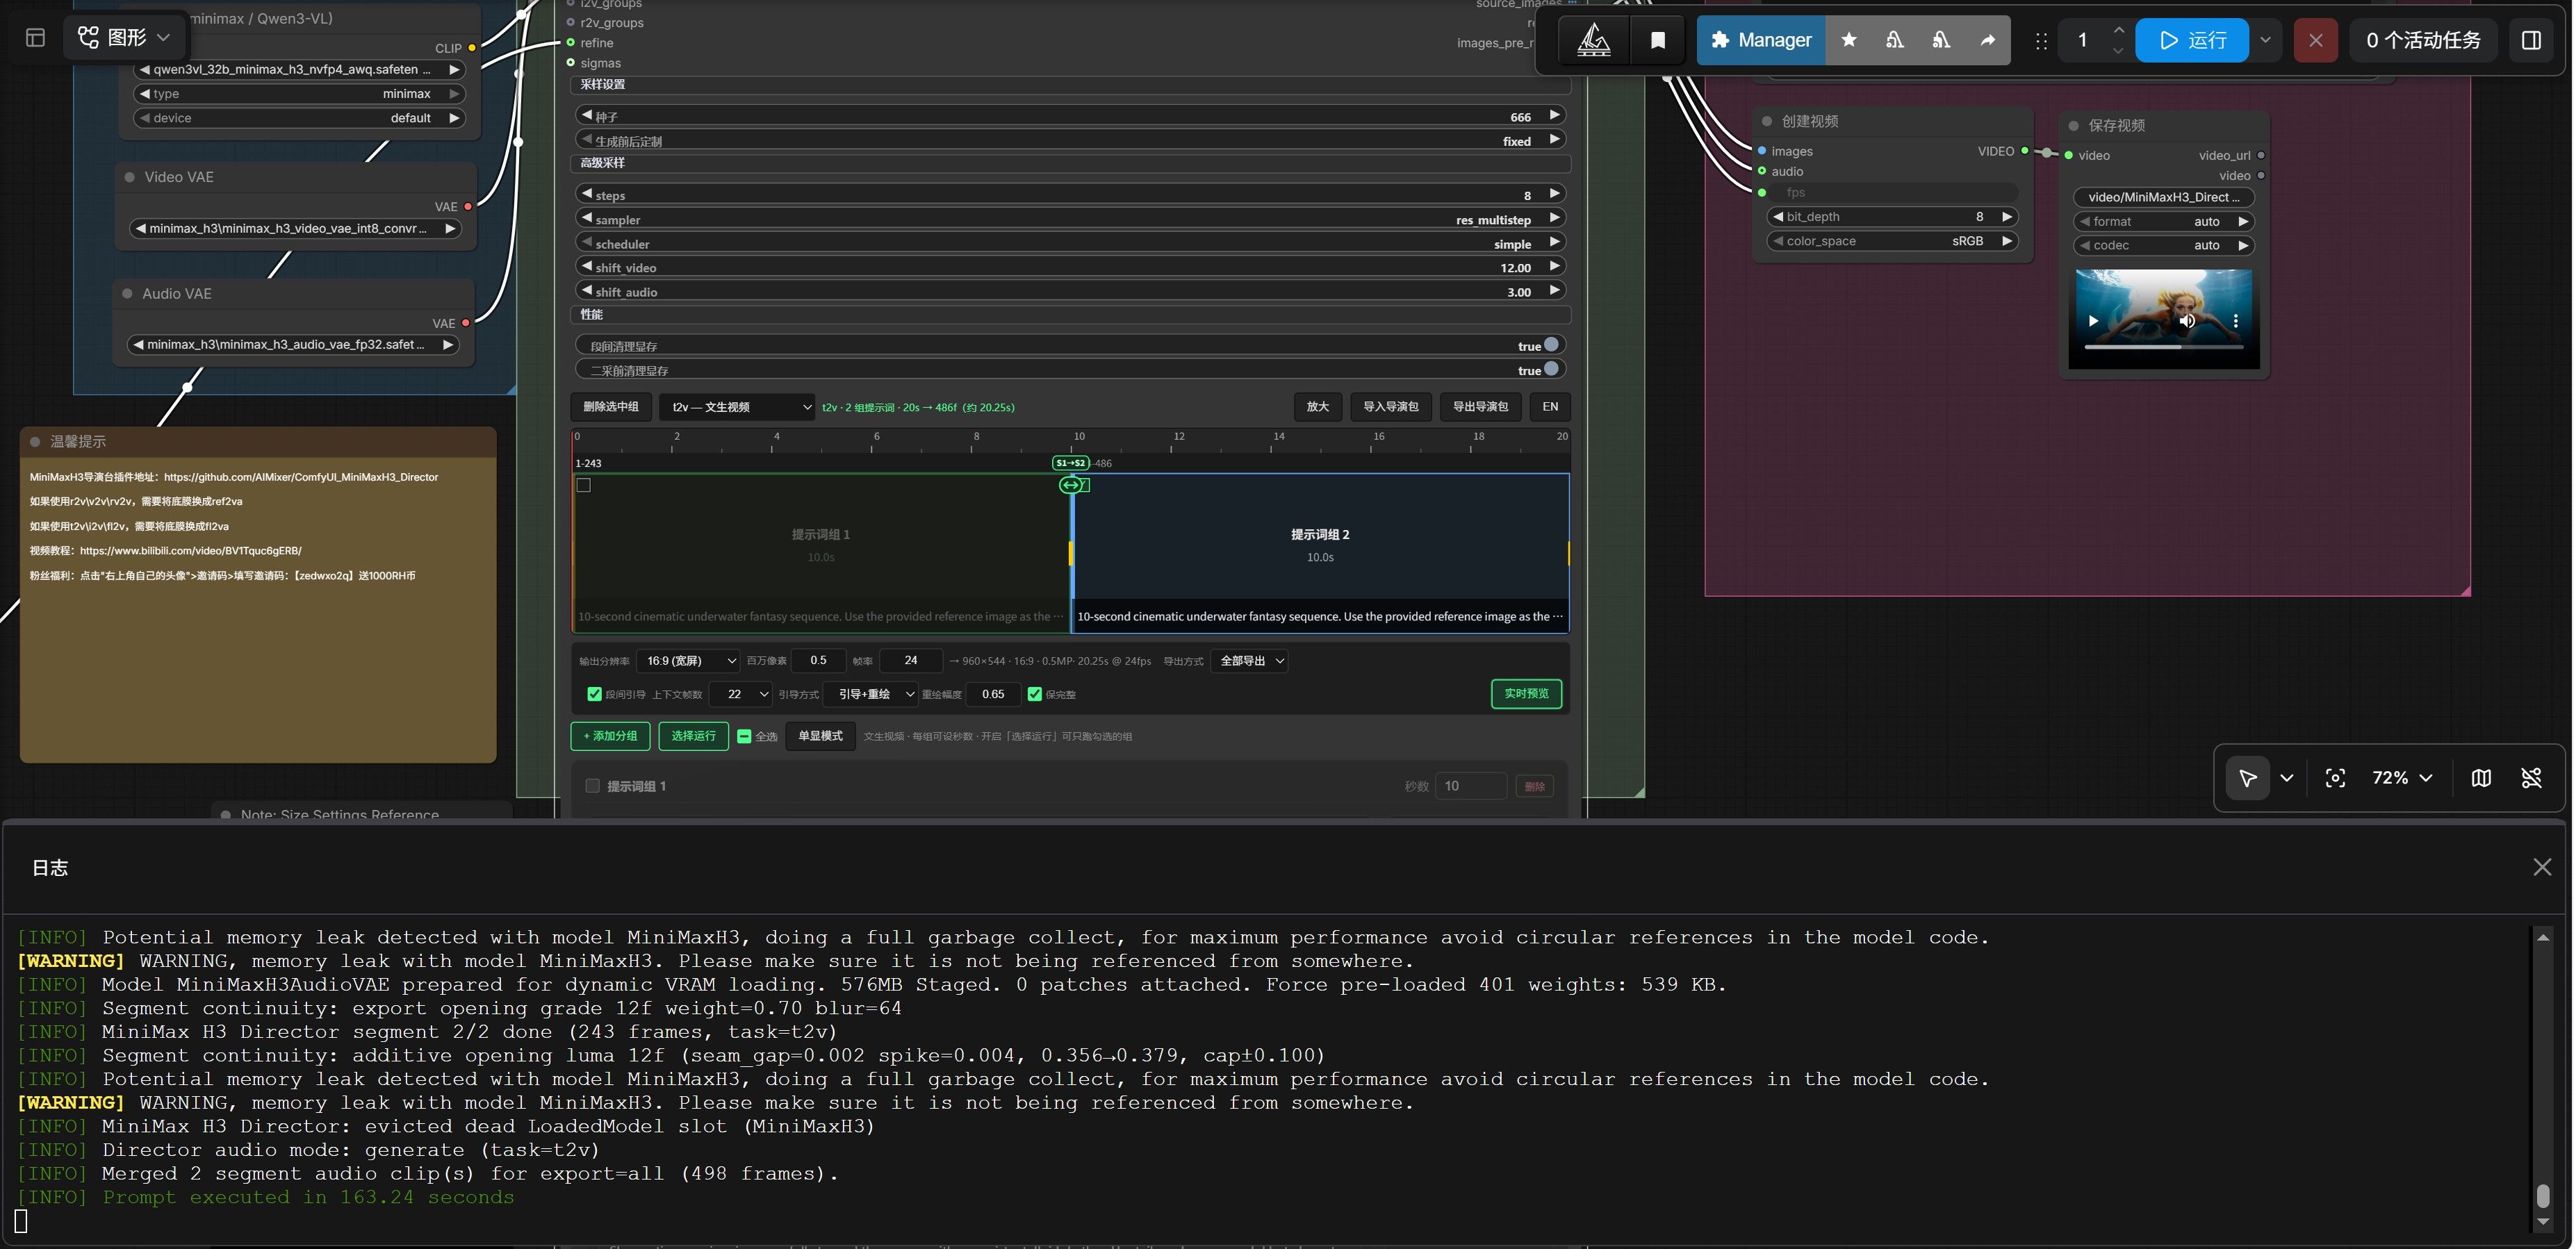
 5. 分段生成 + 引导重绘策略(长视频关键)
核心逻辑:
- 使用“minmax h3 导演台”节点进行分段
- 每段生成 10 秒 视频
- 下一段以上一段的 尾帧 作为视频和声音引导
- 重绘幅度设为 0.65
建议:勾选每段生成后清理一次显存。
效果:
- 动作连续性提升一个档次
- 长视频画质不衰减
- 镜头衔接自然无跳帧
🟦 三、画质放大与修复(The “4K Strategy”)
目标: 在不进行离线 4K 推理的情况下,最终输出依然达到 4K 观感。
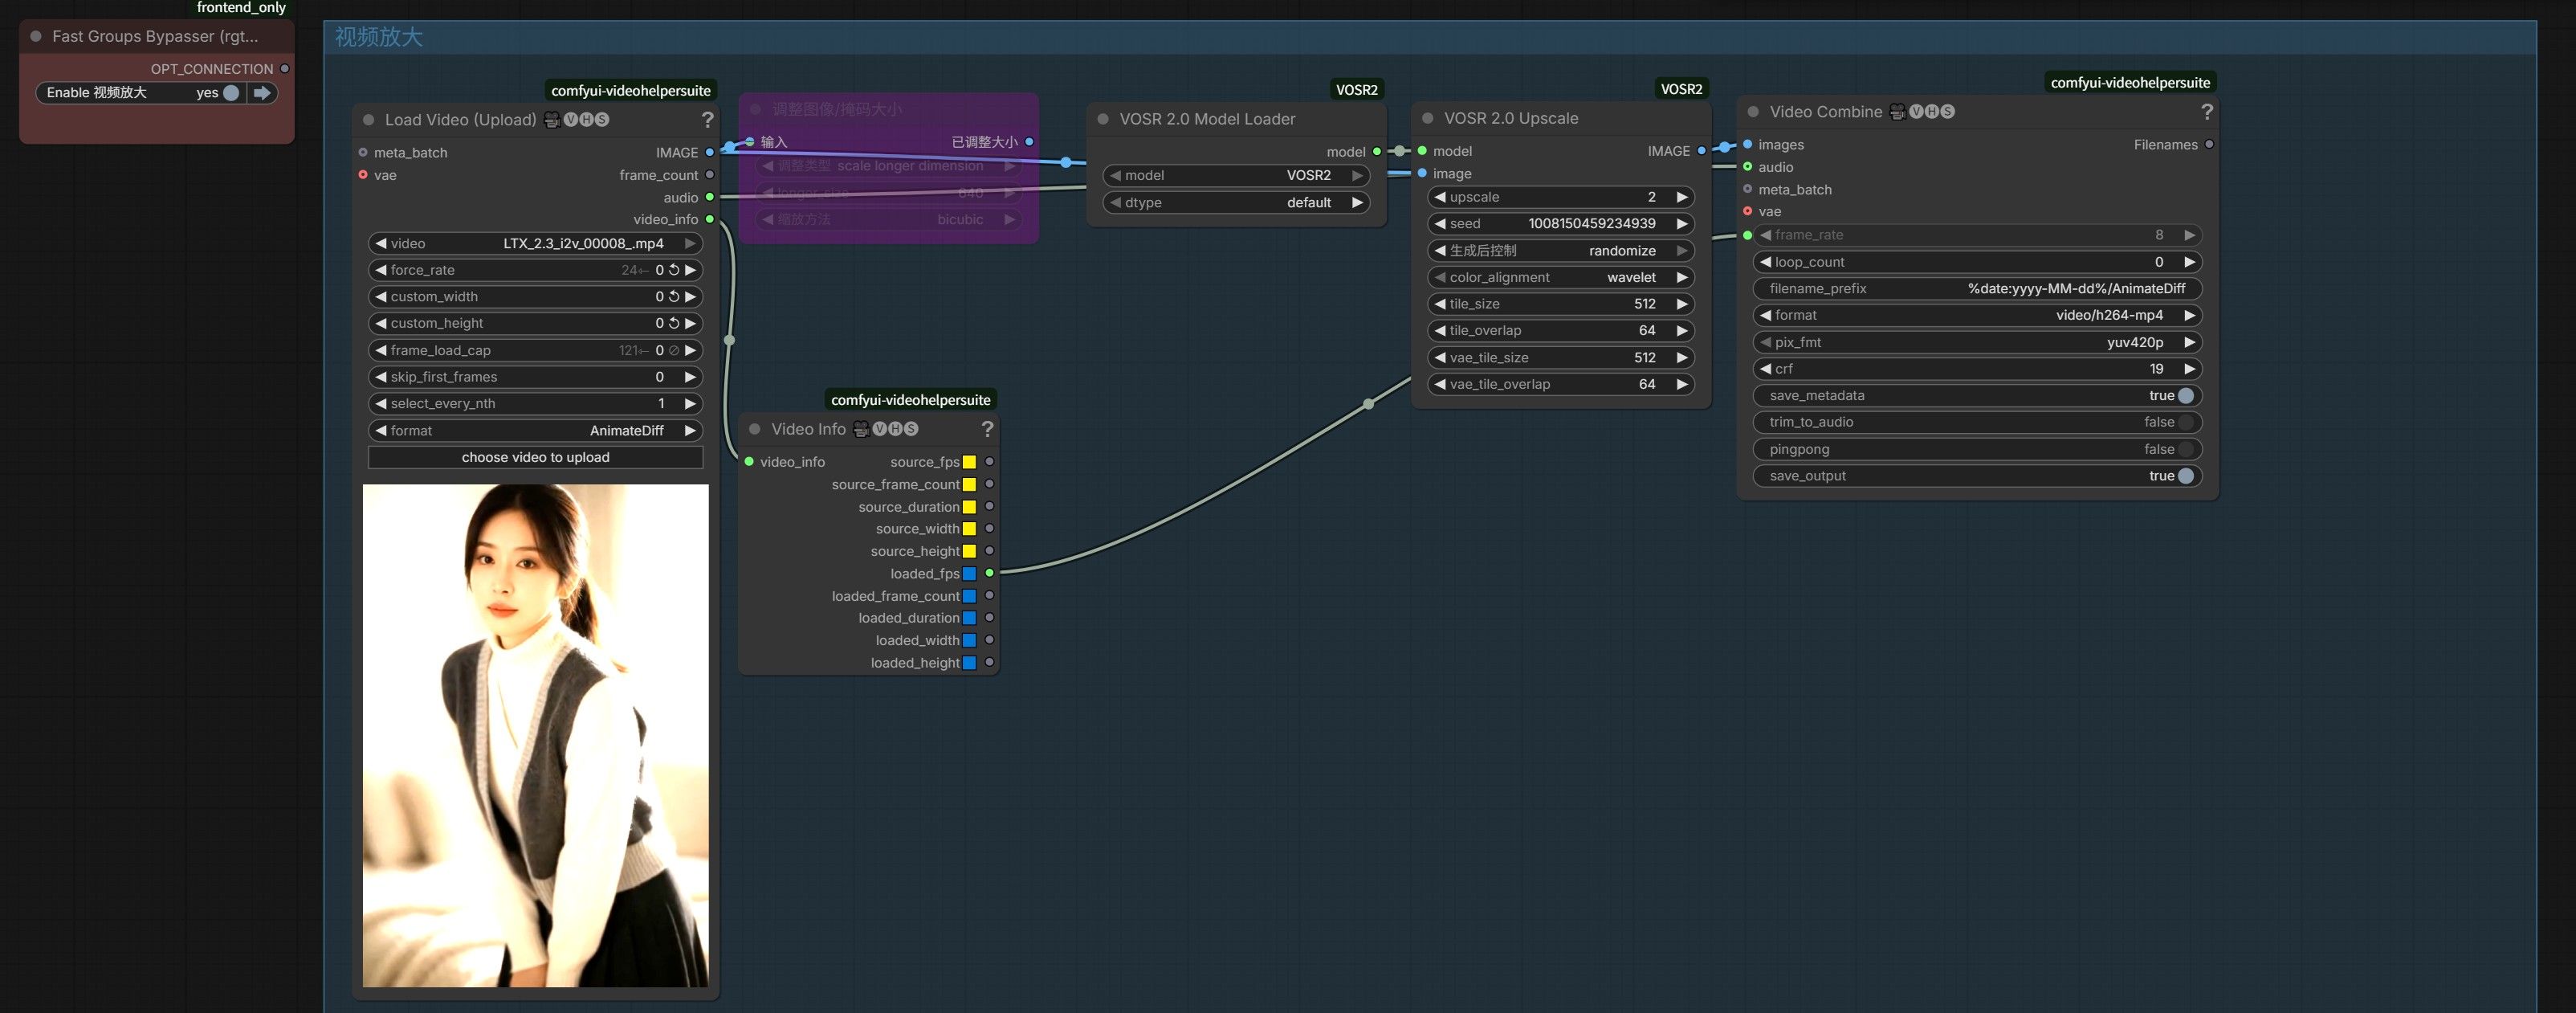
🧩 第一阶段:视频质量修复(VOSR 2.0)
输入:960×544
输出:1080pVOSR 的优势:
- 修复硬线条
- 修复文字
- 修复人物皮肤
 第二阶段:视频超分放大(RTX VSR)
RTX+Video+Super+Resolution视频放大
输入:1080p
输出:4K- 基于 TensorRT 引擎
- 几乎不占显存
- 画质提升显著
- 适合长视频放大
🟩 四、最终总结
即使只有 12GB 显存:
- 通过 W4A8 精度压缩
- 加速LORA
- 分段重绘策略
- VOSR + RTX VSR 两段式增强
依然可以实现:
- 长视频生成
- 动作戏稳定推理
- 4K 观感输出
- 画质不衰减的连续镜头
如果你也在用 50 系列或 40 系列显卡跑 MiniMax H3,欢迎在评论区分享你的工作流参数。
-
适用人群:
- 想跑 MiniMax H3 / Ref2VA / FL2VA
- 想做长视频、动作戏、打斗、镜头衔接
- 想在有限显存下追求画质最大化
🟥 为什么 12GB 显存也能跑长视频?
AI 视频推理显存需求动辄 24GB+,但通过 精度压缩、分段推理、显存碎片管理、软硬件分治,12GB 卡依然能做到:
- 长视频分段生成(>60 秒)
- 高动态动作戏稳定推理
- 4K 超分放大(RTX VSR)
- 画质不衰减的连续镜头
下面是完整的工作流拆解。
🟦 一、硬件与环境约束
️ 核心配置项目 配置 GPU RTX 5070(12GB VRAM) CPU Ryzen 5700X RAM 64GB 存储 SSD (48GB虚拟内存)
稳定策略:功耗墙锁死 80%锁功耗墙的好处:
- 避免瞬时电流尖峰导致黑屏
- 显存颗粒温度更低
- 长时间推理不掉帧
- 显卡寿命更健康
- 性能下降不足5%
🟦 二、模型与推理工作流(ComfyUI)
🧬 1. 混合权重(Hybrid)
兼顾 Ref2VA 的可控性 与 FL2VA 的画质:
minimax_h3_ref2va_hybrid_b20-49_pruned_w4a8_mixed.safetensors
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
minimax_h3_video_vae_int8_convrot.safetensors
minimax_h3_audio_vae_fp32.safetensors
加速 LoRA:
minimax_h3_turbo_v4_step600_ema.safetensors
️ 2. 精度方案:W4A8(黄金分割点)精度 显存占用 画质 推荐度 FP16 高 优秀 12GB 不稳INT8 ConvRot 中 良好 可用W4A8 低 良好 最佳平衡NVFP4 低 良好 50系专用
3. 加速引擎- MiniMax H3 Mem Eff Patch / Sage Attention Patch
- Block Sparse Attention
- TE-Speed-MiniMaxH3 (3.5+)
三者组合可减少 35–50% 推理时间。
4. 动态步数策略场景类型 步数 10 秒0.5M视频推理时间 文戏 / 静态 6-step ~150s 动作戏 / 打斗 8-step ~200s
5. 分段生成 + 引导重绘策略(长视频关键)核心逻辑:
- 使用“minmax h3 导演台”节点进行分段
- 每段生成 10 秒 视频
- 下一段以上一段的 尾帧 作为视频和声音引导
- 重绘幅度设为 0.65
建议:勾选每段生成后清理一次显存。
效果:
- 动作连续性提升一个档次
- 长视频画质不衰减
- 镜头衔接自然无跳帧
🟦 三、画质放大与修复(The “4K Strategy”)
目标: 在不进行离线 4K 推理的情况下,最终输出依然达到 4K 观感。
🧩 第一阶段:视频质量修复(VOSR 2.0)
输入:960×544
输出:1080pVOSR 的优势:
- 修复硬线条
- 修复文字
- 修复人物皮肤
第二阶段:视频超分放大(RTX VSR)RTX+Video+Super+Resolution视频放大
输入:1080p
输出:4K- 基于 TensorRT 引擎
- 几乎不占显存
- 画质提升显著
- 适合长视频放大
🟩 四、最终总结
即使只有 12GB 显存:
- 通过 W4A8 精度压缩
- 加速LORA
- 分段重绘策略
- VOSR + RTX VSR 两段式增强
依然可以实现:
- 长视频生成
- 动作戏稳定推理
- 4K 观感输出
- 画质不衰减的连续镜头
如果你也在用 50 系列或 40 系列显卡跑 MiniMax H3,欢迎在评论区分享你的工作流参数。
-
12GB 能做长视频这点没问题,W4A8 + 分块稀疏 + 顺序卸载这套是对的。但有两处得说清楚,不然容易误导后面的人:
- RTX VSR 是显示端的视频增强,做的是更好看的放大,不是生成式细节重建。4K 输出会更锐,但原始帧里没有的信息它补不出来,「画质不衰减」不成立。真要 4K 细节,得上生成式超分(SUPIR / SeedVR2)或高分辨率重绘,代价是显存和时间都按帧算。
- 锁 80% 功耗墙换稳定是对的(压瞬态尖峰),但代价不止 5%:prefill 和大 batch 段会明显吃算力,只有 decode 段(带宽瓶颈)几乎无感。评估时把 prefill 与 decode 分开测。
另外分段生成 60 秒以上,段与段之间建议用首尾帧 + 上段末帧做条件,否则动作戏跨段容易跳。工作流如果放出来可以贴一下,我按上面几条帮你对一遍。
-
-
视频放大修复(VOSR 2.0)工作流
-
视频超分放大(RTX VSR) 工作流
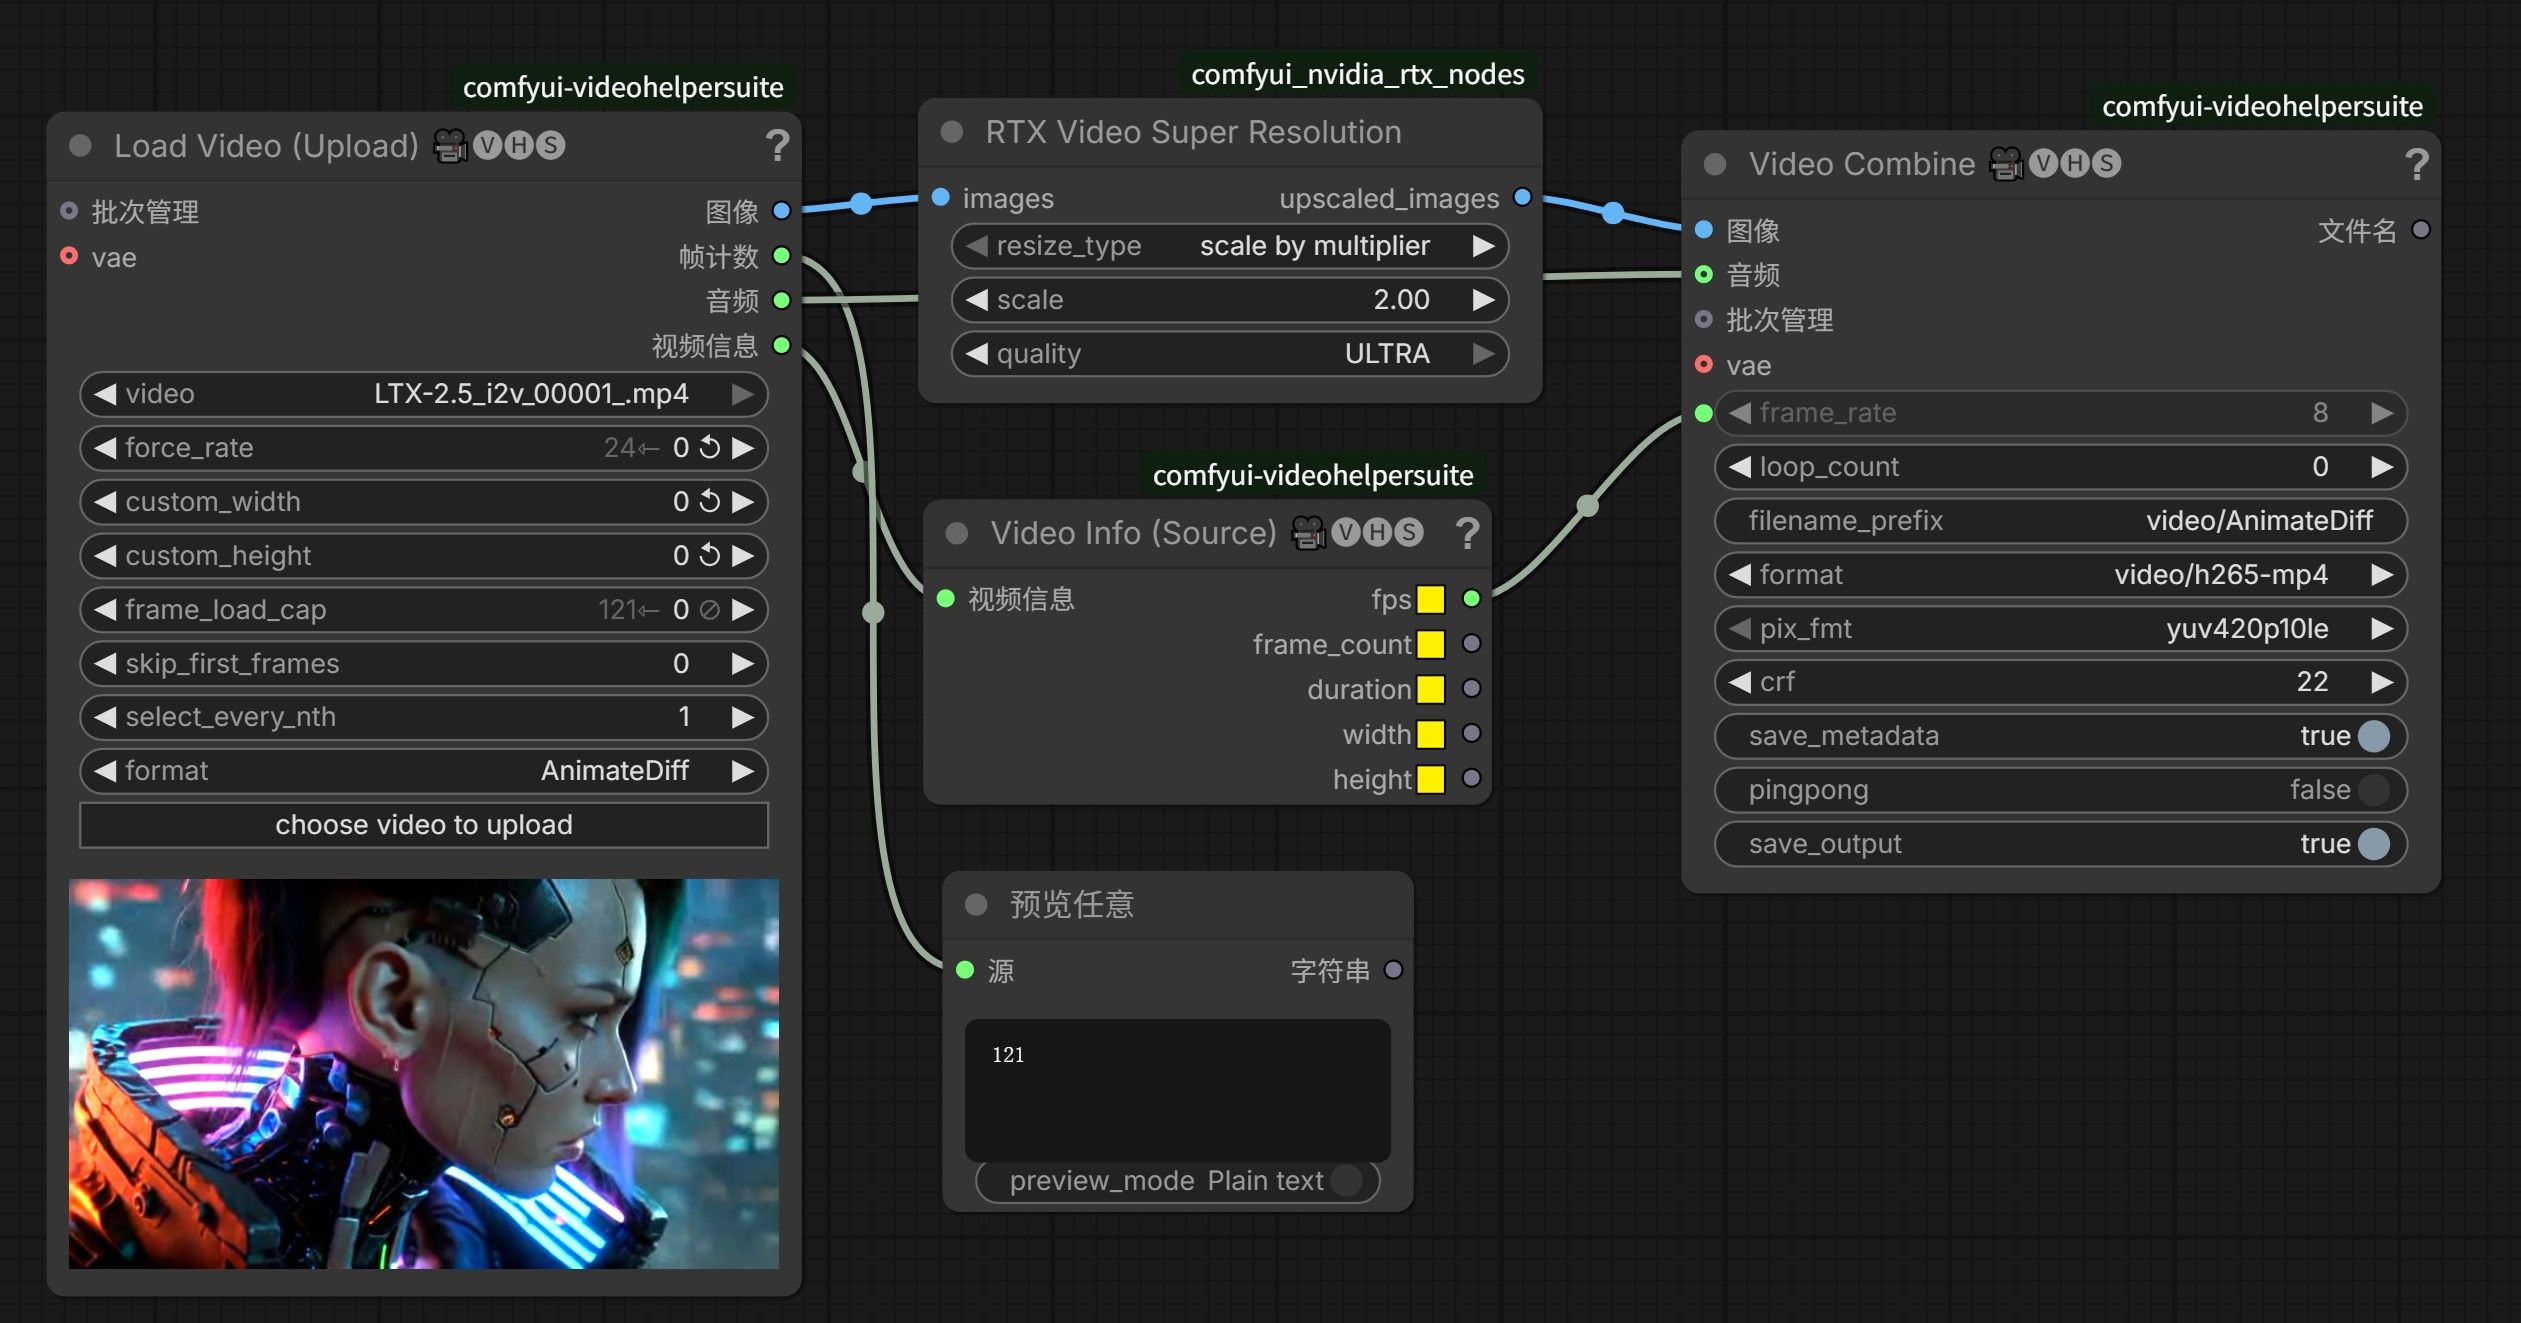
视频超分放大(RTX VSR).json -
,
 T terry 固定了此主题
-
NV的生态好。拿到流都可以试试。
Windows下也可以直接上。
操作:
1.安装 comfy UI
2.拖拽 工作流 到 web 页面
3.点击报错页面 选择一键下载全部缺失内容(正常是模型,节点都可以一次解决)。下载失败可能是你的VPN的问题。 -
,系统 取消固定了此主题