【求助】不想碰3090矿卡,7900XTX双卡玩本地AI靠谱吗?后面能加到4卡6卡8卡吗?
-
@zhi-kong 我现在和你一样纠结中。现在论坛大佬给了几个选项:
7900xtx -- 24g
9700 ai pro -- 32g
3080 mod-- 20g
3090 --- 没货
这些选项就是奔着多卡跑大模型的, 而且速度要能用的程度70+ t/s(我目标是qwen3.8 next flash)
纠结死了@Quanta-Magic 你说的,实际有人应该跑出来了,还有提升线路图,但是实际跑到一半的上下文才有实用性,我估计 也就 在70-80顶天了。
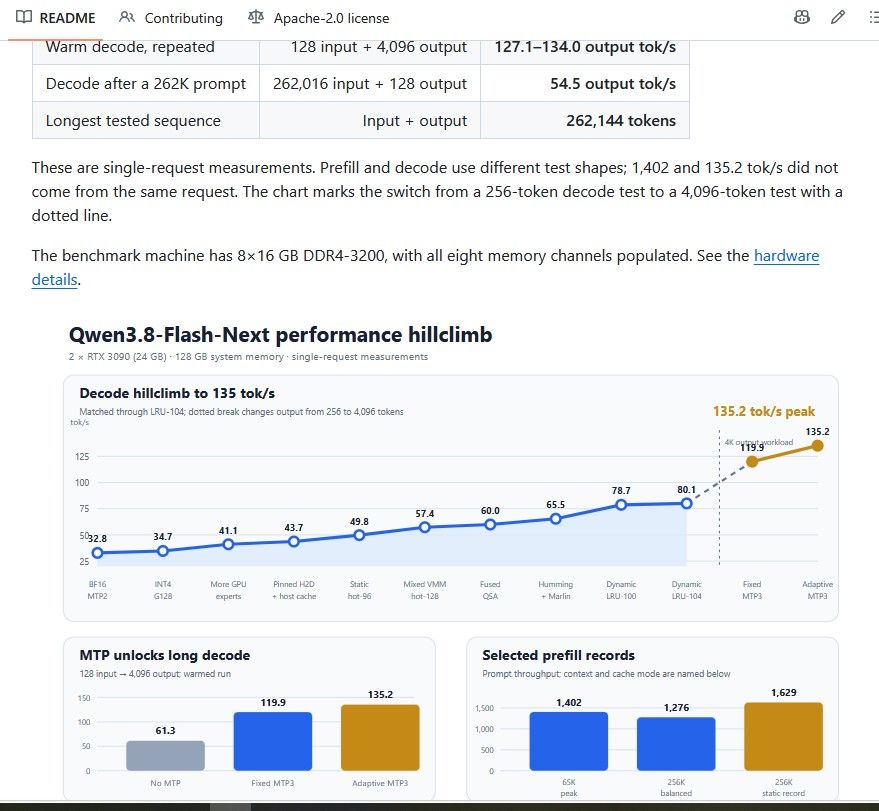
https://github.com/DominikBucko/qwen38-flash-next-2x3090
我是双3090,升级硬件后首要的就是要抄他作业。
-
@zhi-kong 我现在和你一样纠结中。现在论坛大佬给了几个选项:
7900xtx -- 24g
9700 ai pro -- 32g
3080 mod-- 20g
3090 --- 没货
这些选项就是奔着多卡跑大模型的, 而且速度要能用的程度70+ t/s(我目标是qwen3.8 next flash)
纠结死了@Quanta-Magic 纠结于 只玩小模型可以7900XTX双卡,后期加卡是个问题,N卡又普遍溢价离谱矿卡泛滥没有靠谱的。
-
@Quanta-Magic 你说的,实际有人应该跑出来了,还有提升线路图,但是实际跑到一半的上下文才有实用性,我估计 也就 在70-80顶天了。
https://github.com/DominikBucko/qwen38-flash-next-2x3090
我是双3090,升级硬件后首要的就是要抄他作业。
-
省流:
3090 24G 海鲜市场全是矿,狗东自营又没货,不敢赌。
想先上 7900XTX 双卡 48G,跑 Qwen 70B 量化。
怕以后加 4/6/8 卡时,没 NVLink + PCIe 通道 + ROCm 多卡把我劝退。
先叠甲:不是纯小白,Linux/Docker 都行,命令环境能折腾。但真不想天天跟 ROCm 兼容性对线。
现在卡在这:
3090 便宜是便宜,但矿卡风险太大,坏了没保直接裂开。
7900XTX 全新有保,24G,价格也能接受。最近 B 站/论坛确实有不少 ROCm 跑 AI 的教程,llama.cpp、vLLM 好像都能玩。
所以想先搞双卡,48G 显存跑 70B Q4/Q3,日常推理应该够?但我最纠结的是升级:
双卡 → 4卡 → 6卡 → 8卡,7900XTX 到底现不现实?担心点:
PCIe 通道:消费级平台直连通道就那点。双卡 x8/x8 还行,4 卡怎么分?看帖子说 ROCm 还挑槽位,不是 CPU 直连可能直接报错。
没 NVLink:卡间通信全走 PCIe。双卡能忍,4 卡以上 AllReduce 会不会慢成狗?vLLM 多卡效率能看吗?
ROCm 多卡:CUDA 那边插上就能跑,ROCm 这边版本对不齐就开不了。双卡我都怕折腾,4 卡 8 卡是不是直接变运维地狱?
物理+钱包:7900XTX 三槽卡,4 张机箱都塞不下。主板、电源、线程撕裂者/EPYC 平台,一套下来是不是不如租云?
想求真实经验:
双卡 7900XTX 跑 70B 量化,实际 token/s 多少?能日常用吗?
有人真跑过 4 卡 7900XTX 做推理吗?消费级平台是不是没戏?
6/8 卡是不是必须服务器板 + PCIe switch?那成本对比二手 A100/MI300X 咋样?
双卡是不是普通玩家天花板?再往上不如直接云?
更高端的显卡圈,全是神仙打架不是我能比的起的。
有实际踩过坑的大佬求指点,云评测也欢迎,轻喷。
现在就是不上不下,难受。 -
-
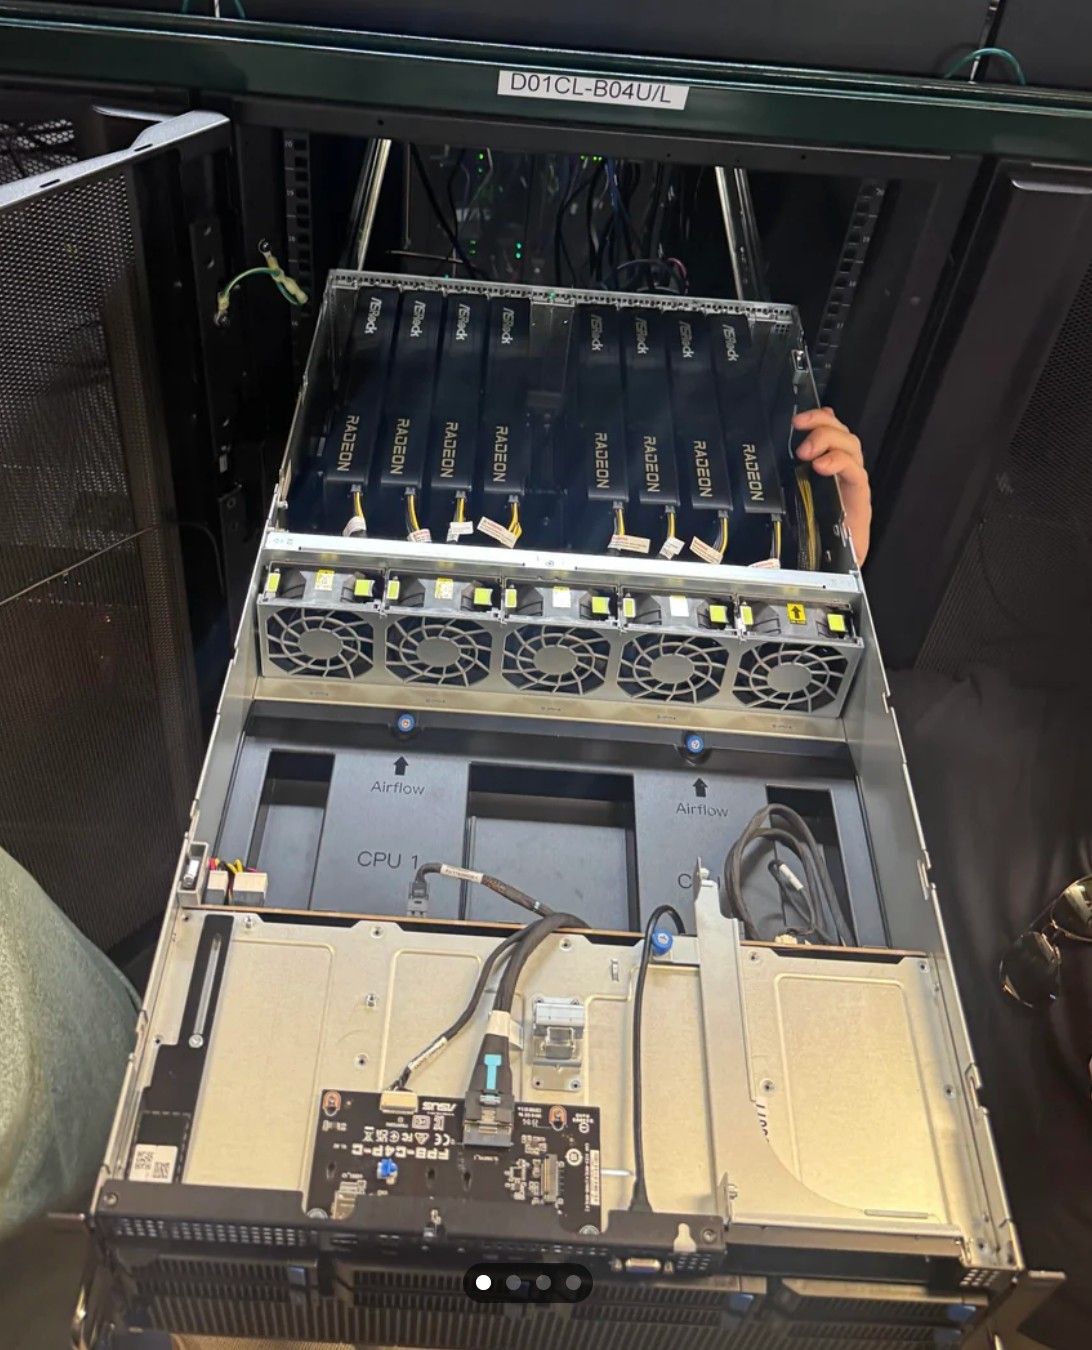
世界各國的網友們的 8卡機給您參考
8卡5090 組法, 看空間大小 應該可以組 8卡 RX7900 XTX
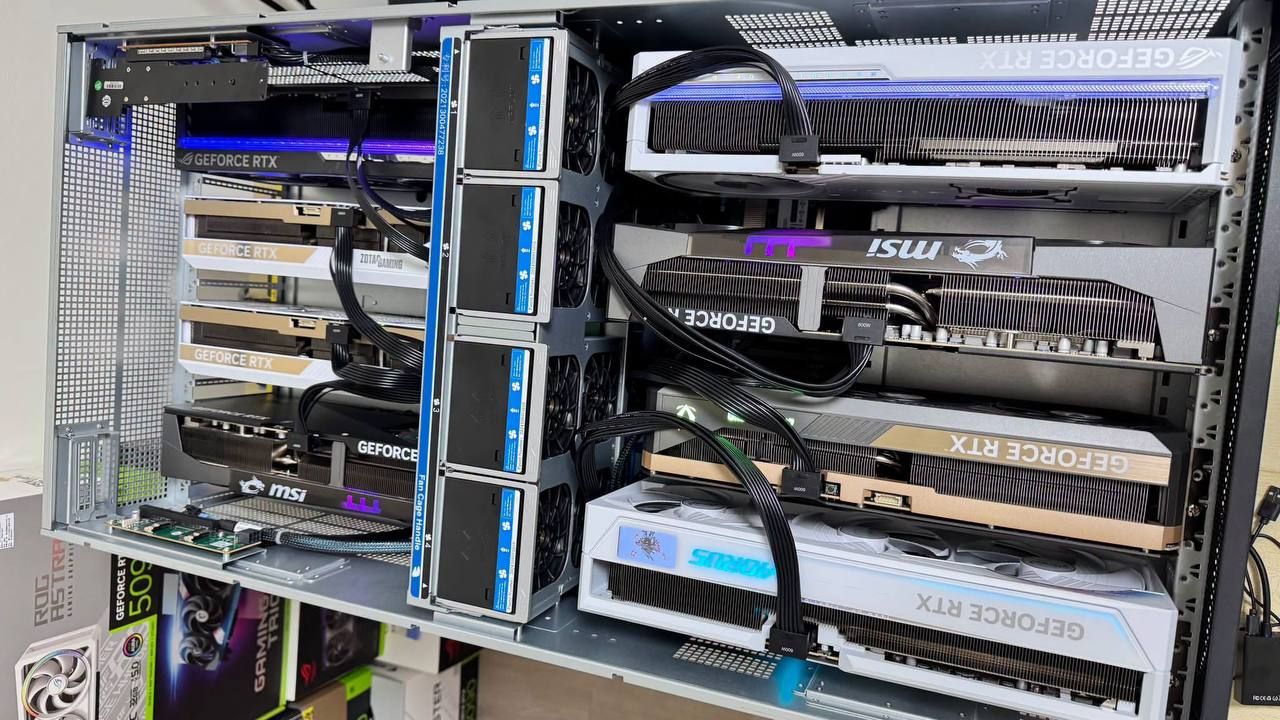
4 Pro 6000 + 4 Pro 600 MaxQ
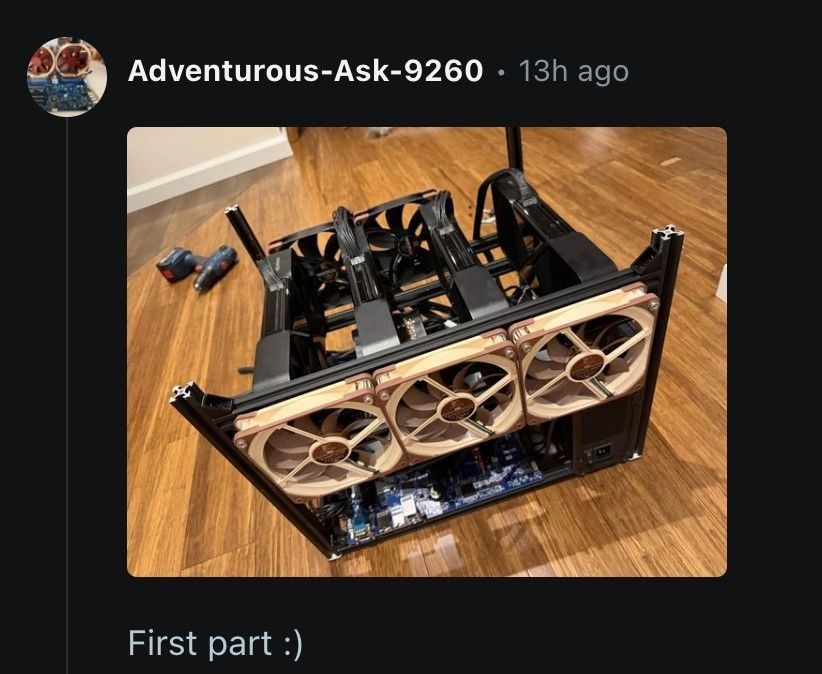
規格表
Gigabyte mz33-ar1 4x pcie 5.0 x16 + 6 pcie 5.0 x8, epyc 9535 es 64c/128t,
384gb ddr5 ecc, 4x pny rtx 6000 pro, 4x hp rtx 6000 pro max-Q, nvme 8tb- 2x 4tb raid0, 2x psu 3000w
4x rtx 600w
Glm 5.3 flash fp8 single: 250+ tok/s ctx 524K2x rtx max-Q
Qwen 3.8 flash next fp8: single 200+tok/s
Deepseek v4 flash fp8 0731 365tok/s ctx 1m
Qwen 3.8 27b fp8 160+ tok/s ctx 262K
Glm 5.3 flash w4a15 260+ tok/s8卡 ASRock R9700 32GB
-
@kos-or 佬,是的我也在考虑, 7900XTX体积相对较大,支持的主板较少,可能最多只能×4 / ×6,R9700价格实在逆天。机箱的话我已经准备好开放式机箱+外接风扇,横向单风扇散热,纵向低功率4风扇吹风
-
-
省流:
3090 24G 海鲜市场全是矿,狗东自营又没货,不敢赌。
想先上 7900XTX 双卡 48G,跑 Qwen 70B 量化。
怕以后加 4/6/8 卡时,没 NVLink + PCIe 通道 + ROCm 多卡把我劝退。
先叠甲:不是纯小白,Linux/Docker 都行,命令环境能折腾。但真不想天天跟 ROCm 兼容性对线。
现在卡在这:
3090 便宜是便宜,但矿卡风险太大,坏了没保直接裂开。
7900XTX 全新有保,24G,价格也能接受。最近 B 站/论坛确实有不少 ROCm 跑 AI 的教程,llama.cpp、vLLM 好像都能玩。
所以想先搞双卡,48G 显存跑 70B Q4/Q3,日常推理应该够?但我最纠结的是升级:
双卡 → 4卡 → 6卡 → 8卡,7900XTX 到底现不现实?担心点:
PCIe 通道:消费级平台直连通道就那点。双卡 x8/x8 还行,4 卡怎么分?看帖子说 ROCm 还挑槽位,不是 CPU 直连可能直接报错。
没 NVLink:卡间通信全走 PCIe。双卡能忍,4 卡以上 AllReduce 会不会慢成狗?vLLM 多卡效率能看吗?
ROCm 多卡:CUDA 那边插上就能跑,ROCm 这边版本对不齐就开不了。双卡我都怕折腾,4 卡 8 卡是不是直接变运维地狱?
物理+钱包:7900XTX 三槽卡,4 张机箱都塞不下。主板、电源、线程撕裂者/EPYC 平台,一套下来是不是不如租云?
想求真实经验:
双卡 7900XTX 跑 70B 量化,实际 token/s 多少?能日常用吗?
有人真跑过 4 卡 7900XTX 做推理吗?消费级平台是不是没戏?
6/8 卡是不是必须服务器板 + PCIe switch?那成本对比二手 A100/MI300X 咋样?
双卡是不是普通玩家天花板?再往上不如直接云?
更高端的显卡圈,全是神仙打架不是我能比的起的。
有实际踩过坑的大佬求指点,云评测也欢迎,轻喷。
现在就是不上不下,难受。 -
不管是 7900XTX 还是 9700 32G。双卡是最佳组合了。
再加卡价格已经可以上NV了。低资金折腾AMD。4卡还玩AMD ?
动动脑子。
不行就拿个计算器。 -
世界各國的網友們的 8卡機給您參考
8卡5090 組法, 看空間大小 應該可以組 8卡 RX7900 XTX
4 Pro 6000 + 4 Pro 600 MaxQ
規格表
Gigabyte mz33-ar1 4x pcie 5.0 x16 + 6 pcie 5.0 x8, epyc 9535 es 64c/128t,
384gb ddr5 ecc, 4x pny rtx 6000 pro, 4x hp rtx 6000 pro max-Q, nvme 8tb- 2x 4tb raid0, 2x psu 3000w
4x rtx 600w
Glm 5.3 flash fp8 single: 250+ tok/s ctx 524K2x rtx max-Q
Qwen 3.8 flash next fp8: single 200+tok/s
Deepseek v4 flash fp8 0731 365tok/s ctx 1m
Qwen 3.8 27b fp8 160+ tok/s ctx 262K
Glm 5.3 flash w4a15 260+ tok/s8卡 ASRock R9700 32GB
@kos-or 有钱也买不到,能买到 也是高价,
拥有这些的人已经把这些AI机器用来搞钱 给这些炸子鸡 赎身了。
这跟当年的矿潮何其相似!所以我一直有一种理论,中本聪就是 皮衣黄。99.99%,尽管问了各种AI都否认这个结果。
但是又有谁可以推翻?
皮衣黄就是算力皇帝,站在地球顶端的那个美国人,永远走在时代前列!双卡3090 PCIE 3.0 8X/8X
白天(宰相) Sglang+mattbucci 3.6 35B A3B AWQ W4A16 262K ~160 t/s 夜间(将军) sglang+DENSE 27B INT8-W8A8-imatrix mtp/dflash2 230K ~65 t/s -
@kos-or 有钱也买不到,能买到 也是高价,
拥有这些的人已经把这些AI机器用来搞钱 给这些炸子鸡 赎身了。
这跟当年的矿潮何其相似!所以我一直有一种理论,中本聪就是 皮衣黄。99.99%,尽管问了各种AI都否认这个结果。
但是又有谁可以推翻?
皮衣黄就是算力皇帝,站在地球顶端的那个美国人,永远走在时代前列! -
矿卡一般不是「升级」BIOS,而是刷改版 BIOS——降压、锁功耗、改风扇曲线或显存时序。所以你会看到两种:改版 BIOS 没刷回去的,和刷回原厂的。看到出厂年份的原版 BIOS,反而是正常情况,说明不了没挖过。
你第二张 3090 开不了 ReBAR 大概率也不是矿的锅:3090 是 2020 年 9 月首发,ReBAR 支持是 2021 年才通过 VBIOS + 驱动 + 主板三件套补齐的。首发批次的 VBIOS 本来就不带 ReBAR,跟是不是矿卡无关。
想开 ReBAR:① 刷一张支持 ReBAR 的官方 VBIOS(型号和 subsystem ID 必须对上,TechPowerUp VBIOS 库逐项比,双 BIOS 卡先备份);② 主板开 Above 4G Decoding + ReBAR、关 CSM、UEFI 启动;③ 驱动用较新的。三样缺一不可。
想判断是不是矿改 BIOS:GPU-Z 看 BIOS 版本/日期、subsystem ID、功耗墙和频率;或用 nvflash --version / --compare 和原厂比对。改版 BIOS 通常在 TDP/显存时序上和公版对不上。
两点提醒:单卡跑 LLM,ReBAR 的实际收益很小,它主要影响显存整段映射和多卡 P2P;刷 BIOS 有变砖风险,双 BIOS 卡可救但别赌,不确定就别刷。
-
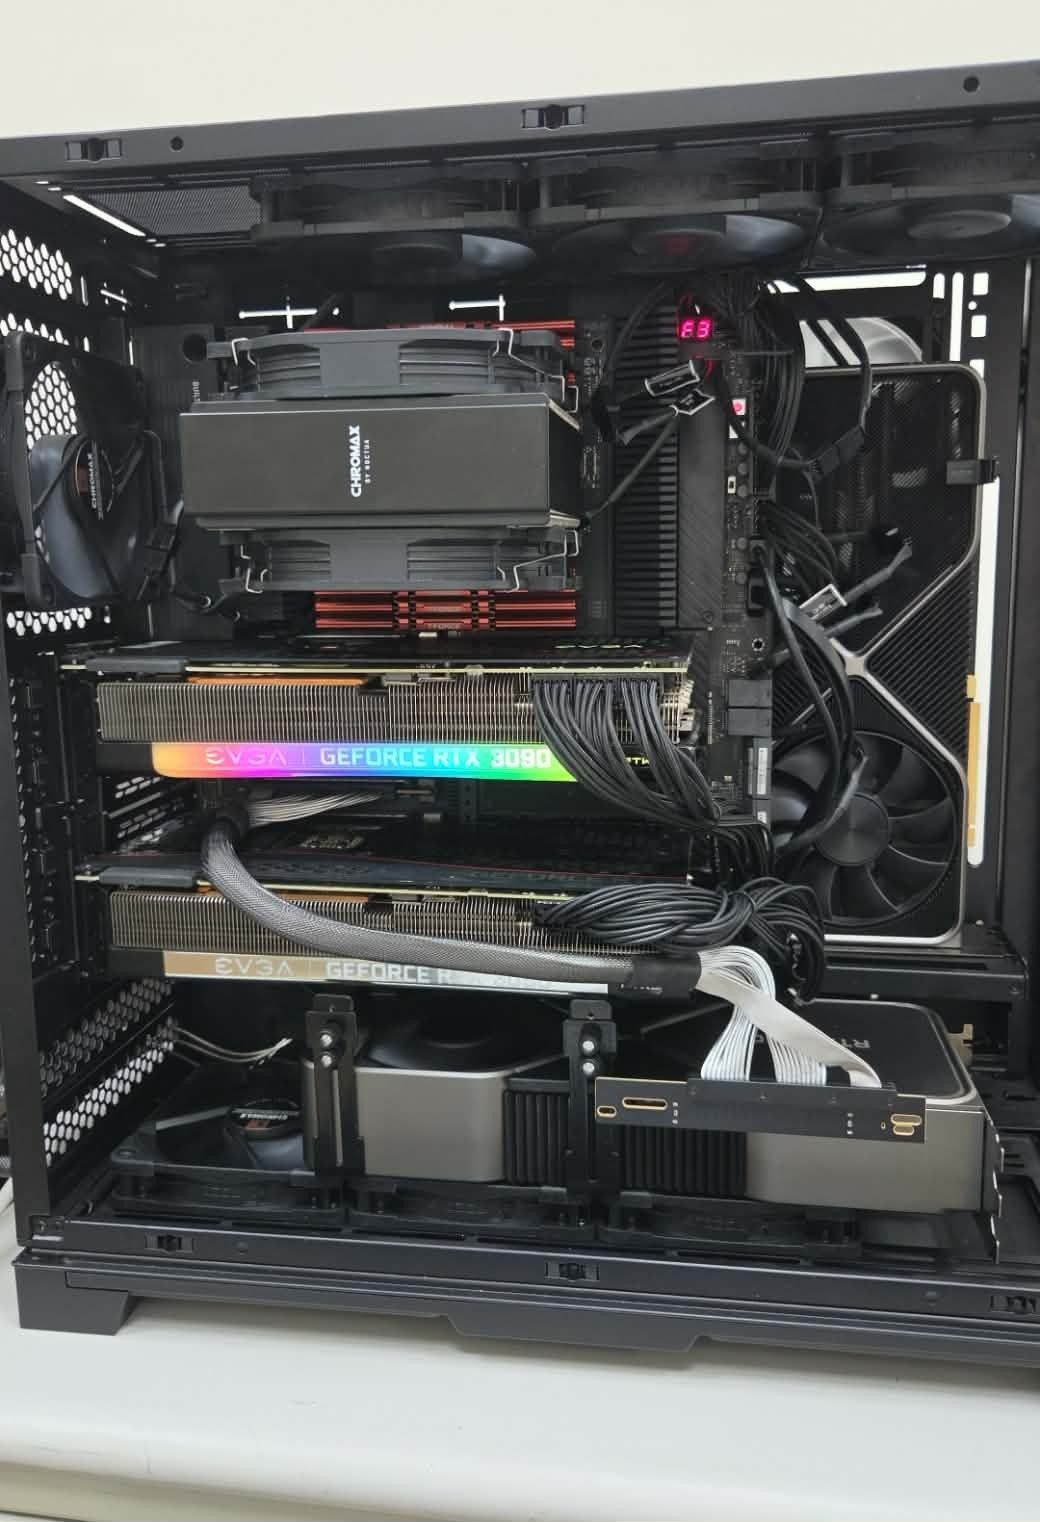
怎麼忽然大家都在問這問題....
AMD Ryzen Threadripper PRO 3945WX + ASUS WRX80E
256G non ecc ddr4 + EVGA 3090 x2 + 3090FE x 2
實裝沒問題
-
@zhi-kong 四张 3090 跑 70B 量化,前提先说清楚:无 NVLink 时,4 卡的瓶颈是 PCIe all-reduce,不是显存。
速度量级:
- 70B Q4 权重约 40GB,4×24G=96G 装得下。单流 decode 理论天花板由权重带宽决定(每卡读自己那份),但每层 all-reduce 都要过 PCIe。3090 单卡 ~936GB/s,x8 单向有效约 16GB/s、x4 只有 ~8GB/s;4 卡无 P2P 时 all-reduce 还可能绕主机内存。
- 可参考的同代社区实测(4×3090 无 NVLink、27B):tp=4 单路 decode 比 tp=2 低约 9%,并发 4 路聚合低约 37%。所以「4 卡比 2 卡快很多」只在 prefill/大 batch 成立,单流别期待翻倍。
- 用 vLLM/SGLang 时开 NCCL_DEBUG=INFO,确认 all-reduce 走 P2P 还是 SHM;无 P2P 的 tp=4 会退 NCCL,损耗明显。
NVLink 配对:3090 的 NVLink 桥只有一对端口,4 张卡最多 1-2、3-4 两两配对,做不到 4 卡全互联。跨对通信仍走 PCIe,对 tp=4 来说跨对那段就是瓶颈。nvidia-smi topo -m 能看出对内是 NV2/NV3、跨对是 PHB/SYS。
建议:
- 4 卡优先 tp=2×2(两个独立实例各用一对 NVLink),聚合吞吐通常高于 tp=4,坑也少。
- 真要 tp=4,主板要 4 条 CPU 直连 x16(WRX80/EPYC 才够 lane),别用芯片组槽;BIOS 开 Above 4G + ReBAR。
- 矿卡:3090 停产多年,现在基本是矿卡或翻新。只收「可退换 + 到手跑 nvidia-smi -q、gpu-burn 半小时、显存测试」的;价格明显低于市场价的直接跳过。宁可少一张也别踩雷。
-
@Quanta-Magic 你说的,实际有人应该跑出来了,还有提升线路图,但是实际跑到一半的上下文才有实用性,我估计 也就 在70-80顶天了。
https://github.com/DominikBucko/qwen38-flash-next-2x3090
我是双3090,升级硬件后首要的就是要抄他作业。
-
-
@zhi-kong 没有nvlink..
感觉4 卡以上 对散热 供电 的要求是2卡的几倍
除非用开放式机箱如果我上4卡我想玩水冷
但是4卡没有看到明显好处... 除非需要同时多对话
理想是4x4090 48gb,但是成本爆炸
10万 的玩具 我还玩不起