DDR4 服务器内存256G + RTX 3090 双卡 应该升级怎样的平台?
-
从显卡出了一些问题,到我慢慢让GLM帮我研究,发现瓶颈可能在古董主板+CPU上面,于是萌生了换平台的想法:
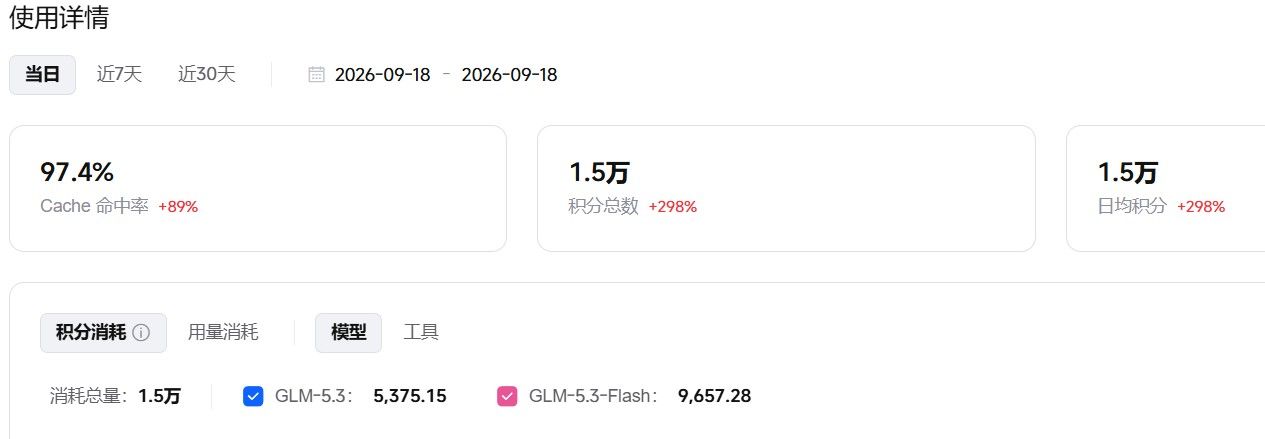
下午和flash聊了半天,就用了近亿TOKEN。算起来也是 460/20 = 20元费用 (包月每周有6万积分)
以下是它给的最终方案,请大神指正:调研完毕。逐项回答,最后给综合方案。
一、这些 CPU 都支持你的内存吗?——全部支持,但有一条混插铁律
你那 16 条 HPE 16G(DDR4-2133/2400 ECC)在 SP3 插槽上全部兼容——7002/7003 系列统一 8 通道 DDR4,RDIMM/LRDIMM 通吃。但 HPE 官方 QuickSpecs 明确一条铁律(CBS 核实):
"LRDIMM and RDIMM are distinct memory technologies and cannot be mixed within a server"
来源:https://www.hpe.com/psnow/doc/a00056110enw也就是说:16 条必须全是 RDIMM 或全是 LRDIMM,不能混。DL380 Gen9 拆机同批条子几乎肯定是纯 RDIMM(16G 容量段基本只有 RDIMM),今晚 dmidecode 确认一下即可。另外全部插满 16 条时,记得按 8 通道对称插(每通道 2 条),华南/ASRock 手册都有 population 表。
二、CPU 表格逐个点评(结合推理场景:不跑 MoE、TP 2→4→6)
型号 判定 理由 7R12 ¥1600  排除
2.2G 主频太低,调度/采样延迟敏感 7K62 ¥1600  备选
48C 2.6G,元/频点 12.8 全场最优;腾讯定制但是正式版流通量大 7502 ¥1800 排除32C 卖 1800,被 7K62 碾压 7642 ¥1800  ️ 平
48C 但 2.3G 偏低 7R32 ¥1850 你的选择是对的48C 2.8G(全场最高频),元/频点 13.76 次优;「当前选中款」我认可 7532 ¥1900 ️32C 2.4G 无亮点 7453 ¥2100 备选(进阶)Milan Zen3!28C 2.75G,单核 +19%,IPC 提升=调度更快;4 卡以内核数够 7542 ¥2300 排除最差性价比(30.6 元/频点) 7513 ¥2700 排除Milan 不错但太贵,省下的钱买卡 「当前选中款 7R32」我给通过——48C 2.8G 是 Zen2 里频率最高的定制版,AWS 大量退役所以货源稳。唯一注意:7R 系列也是定制 U,下单前同样问清「正式版?无锁?」。
要不要多花 ¥250 上 Milan(7453)? 我的判断:不用。推理 CPU 的活是调度+采样+tokenizer,2.8GHz Zen2 的 48 核在这个负载上已经过剩(4 卡 TP=4 只需 16 核左右,社区共识 3090 rig 用 16-32C EPYC 就够)。7R32 的 48 核给你 6 卡扩展留足了余量。
三、显卡全速 x16 的关键事实(CBS 核实 ASRock 官方手册)
ROMED8-2T 官方手册(Newegg 存档 PDF)原文:
"There are 7 PCI Express slots. PCIE1 (4.0 x16, from CPU), PCIE2 (4.0 x16)..."
来源:https://c1.neweggimages.com/IMAttachment/UserManual/User Manual-1715239391192.pdf7 条槽全部 CPU 直连 Gen4 x16(128 lane = 7×16=112 条给槽 + 16 条给 M.2/芯片组,正好分完),不存在消费级主板的 x16/x8/x4 梯队降速。这是 EPYC 平台对你的核心价值,6 卡全插也全是 x16 全速。
社区佐证(r/homelab 实测):H12D-8D(华南同代板)也是 7 槽全 x16,有人插 8 卡跑半年稳定——EPYC 平台 lane 管够是行业共识。
https://www.reddit.com/r/LocalLLaMA/comments/1t2hejy/anyone_running_huananzhi_h12d8d_bmc_with_4x_rtx/四、2026 年社区对 4x/8x 3090 服务器的最新共识(CBS 抓到的关键文章)
Popular AI 2026-06 指南(451 次分享)核心结论:
- 「Best platform for 4x: Used AMD EPYC 7003 if value matters」——EPYC 7002/7003 二手平台就是多卡 3090 的性价比答案,和我们的路线一致
- 「先建 2 卡,远比 4 卡好伺候」(散热/供电/调试)
- 8 卡是「噪音、发热、供电大怪兽」,除非你懂机架+riser+240V
- 槽位物理警告:4 张普通 3 槽宽 3090 需要 12 个后槽位——ROMED8-2T 7 槽物理上装不下 4 张普通非公卡,要么涡轮卡(2 槽)、要么水冷头、要么延长线外挂
来源:https://www.popularai.org/p/4x-8x-rtx-3090-server-local-ai-2026
这条必须现在想清楚:你未来的 4 卡,如果都是现在的双槽改装卡就没事;如果是 2.7-3 槽非公卡,4 卡会物理装不下——到时候的解法是换涡轮版 3090 或者 Oculink 外挂(你论坛里看到的那个 ¥2,380 外置箱就是干这个的)。
五、综合方案定稿
档位 配置 板+U 总价 定位 极简(我推荐) ROMED8-2T + 7402P ¥3,800 24C 2.8G,2-4 卡够用,省下的钱是卡钱 均衡(你的选择,通过) ROMED8-2T + 7R32 ¥5,150 48C 2.8G,6 卡余量 + MoE 大门半开 不推荐 华南 H12D + 7R32 ¥5,667 比 ROMED8 贵 ¥517 但 BIOS 不可控(上一轮 POST 78 案例) 我的最终票投给「极简档 + 把差价存着买第三张卡」:推理性能的天花板是 GPU 数量不是 CPU 核数,¥1,350 的 CPU 差价 = 半张二手 3090。7402P 的 24 核跑 4 卡 TP=4(需要 ~16 核)还有 50% 余量。但如果你「6 卡终极形态」的决心已定,7R32 那档也完全站得住——你的选择没有错,只是要清楚多花的 ¥1,350 买到的是核数余量,不是推理速度。
内存今晚确认 RDIMM 后,这单就可以下:ROMED8-2T(¥3,300 议价)+ 7402P(¥500 愙墨)+ 浪潮 2000W(¥500)+ 4U 机箱(¥500)+ 金钱豹 4U 散热(¥100)≈ ¥4,900 落地,双卡先跑,四卡留位。
-
方案整体靠谱,几个点补一下,别把预算花错地方。
1)推理主机,CPU 核数不是瓶颈。算力全在 GPU,CPU 只做调度、采样、tokenizer、KV/页表搬运。4 卡 TP=4 用 16 核都富裕,7402P(24C) 和 7R32(48C) 在纯推理上几乎没有可见差距;多花的 ¥1350 买的是「以后跑 MoE/预处理/多进程」的余量,不是 token/s。你「省下差价买第三张卡」的思路是对的。
2)你漏了 3090 最大的一张便宜牌:双 3090 有 NVLink。30 系里只有 3090 带 NVLink,桥就是为卡间 P2P 准备的,双向约 112 GB/s,比 PCIe 4.0 x16 的 ~32 GB/s 高一个量级,TP 的 all-reduce 走 NVLink,decode 会明显受益。注意 NVLink 只成对(2 卡一组),4 卡是 2 对、跨对仍走 PCIe;桥要认 Ampere 专用的,别买 20 系的 P4932,按槽距选 3/4 槽。
3)内存那段:RDIMM/LRDIMM 不能混是对的。再补两条现实约束——16 条 2133/2400 混插会跑在最低频(2400),2 DIMM/通道下 EPYC 往往还要再降一档,实际带宽约 150 GB/s 量级;尽量同批同 rank,混 rank 可能被迫降速。对推理主机这个带宽够用,别为它加钱。
4)供电按瞬态算,不是 TDP。4×3090 满载约 1400W,30 系有毫秒级尖峰,2000W 单电源偏紧;双电源或 240V 更稳,每卡 3 个 8pin 用独立线别一分二。散热同理,4 张 3 槽非公塞 7 槽板物理装不下,涡轮卡或 OCuLink 外挂要提前定。
5)平台没选错:ROMED8-2T(7×Gen4 x16,CPU 直连)就是双卡 3090 的性价比正解,BIOS 不可控的板少碰;Milan(7453) 不用上,Rome 的 Gen4 lane 和带宽对推理足够,省下的钱给卡。
一句话:平台缩到 7402P,预算压到 NVLink 桥 + 第三张卡 + 电源/散热上,收益最大。
-
我从 x99 转去 华南 H12D+7452
主要是 7452 便宜 比较省电
跑llm 不需要很好的cpu@applejuice 又想MOE跑更大些的模型。。。
或者为了 跑qwen 3.8 flash提速。另外我接另一个问题:
我在淘宝查了,好像没有4 SLOT的NVLINK 连接器啊,都是2槽 3槽,我的显卡是RTX 3090华硕白猛禽。 有没有一母一公的延长线,买两条,可以将显卡公口和2slot nvlink连接器连接起来的呢?GLM 5.3 FLASH: 你的真实情况:华硕白猛禽 = ROG Strix 3090 White,2.9 槽宽
ASUS 官方规格页确认是 2.9-slot design。这意味着:
- 双卡相邻插 = 5.8 槽位 → 需要「4-slot 桥」(桥体实际跨 5 个槽位,插头间距 80mm/4 槽)
- 3-slot 桥(间距 60mm)理论上只差 20mm——有些机箱/板子配合薄背板能硬上,但要磨,稳定性看运气
最后的务实选项:白猛禽是 2.9 槽不是标准 3 槽,水冷头(EKWB 有 Strix 3090 White 专用 block)改成单槽后,2-slot 桥直接用——社区也有人走这条路(Facebook ASUS 群那个帖子就是水冷+4-slot 讨论)
一句话总结:延长线是死路(时钟发生器 + 定制连接器,无可购零件);你的正确姿势是「先量现有间距 → 按 4 槽间距选板/选槽 → 蹲 P3657/EVGA 4-slot 桥」。桥这东西不着急,新平台装机时按 4 槽间距排布槽位,桥什么时候蹲到什么时候上——没桥的日子咱们 P2P 补丁照样跑。
-
為什麼沒考慮到 AMD Ryzen Threadripper PRO 3945WX + WRX80E
滿血 PCIE 4 x 16 x 7,而且可以沿用非 ECC DDR4 加上八通道,拿來當 HiCache 用非常完美呀
我的 3090 x 4 (SGLang TP=2x2) 用起來很完美 -
為什麼沒考慮到 AMD Ryzen Threadripper PRO 3945WX + WRX80E
滿血 PCIE 4 x 16 x 7,而且可以沿用非 ECC DDR4 加上八通道,拿來當 HiCache 用非常完美呀
我的 3090 x 4 (SGLang TP=2x2) 用起來很完美 -
现在市场价格好。多余的卖了就行。
刚谈了双卡AMD。R9700 32G 双卡可以的。
怎么折腾都够用。 -
一旦 硬件市场 跌了 捏一堆 二手内存很闹心。
回顾下 曹操的。食之无味弃之可惜。 -
人生苦短, 哪怕开心几天也是赚了。
-
目前和GLM FLASH聊了快一天了, 这是最终草稿,请各位大神指正。
一、功耗账(先算再买)
━━━━━━━━━━━━━━━━━━━━━━部件 满载 7B13(cTDP 225-280W) ~240W 4×3090(限功率 250-280W/卡) 1000-1120W 内存 16 条 + 风扇 + 硬盘 + 主板 ~100W 峰值合计 ~1350-1450W 电源黄金法则:负载控制在额定 60-80%(效率曲线甜点 + 瞬态余量)→ 额定 1800W 是及格线,2000W 是舒适线。3090 有毫秒级 2 倍瞬时尖峰(我们 DL380 调研时领教过 550W+ 瞬态),冗余必须留足。
━━━━━━━━━━━━━━━━━━━━━━
二、电源选型(三档)
━━━━━━━━━━━━━━━━━━━━━━首选:海韵 PRIME PX-2000W(钛金)约 ¥3500-4000
- 2000W 单路 +12V,原生态 12×8pin PCI-e(不用转接线),10 年保
- 3090 瞬态尖峰最怕组电压跌,钛金纹波控制最稳
性价比:振华 LEADEX III ATX 2000W(金牌)约 ¥2200-2500
- 2000W,8-10 组 PCI-e,7 年保,3090 社区常用款
_budget:长城巨龙 GTN 2000W(金牌)约 ¥1500-1800
- 国产老大,keinsci 那位 7K62 老哥同款系列,够用,接口数确认 ≥10 组 8pin
️ 关键验收点(买前问一句):原生 8pin PCI-e 接口 ≥8 组。4×3090 = 8 条独立供电线,严禁一分二(单线带 300W 是 3090 红线)。接口不够的要加 PCIe 转 2×8pin 的正规显卡线,不要用电源附赠的杂牌线。避开:任何 1600W 以下(4 卡 + 7B13 顶着上限跑)、服务器冗余电源(CRPS 需要配转接板 + 分线器,噪音大,DIY 塔式不值得折腾)。
━━━━━━━━━━━━━━━━━━━━━━
三、机箱选型
━━━━━━━━━━━━━━━━━━━━━━硬性需求:EEB 兼容(MZ32-AR0 是 305×330mm,比 E-ATX 305×277 还深)+ 9 个以上 PCI 扩展位(7 条 x16 槽 + 风扇位)+ 4 卡限长 ≥340mm。
首选:追风者 Enthoo 719(约 ¥800)
- 8+3 扩展位,支持 SSI-EEB(355×335mm 板都装得下)
- 4×3.5“ + 11×2.5” 盘位(16 条内存旁边还能塞大容量硬盘)
- 风扇位充足(前 4 + 顶 3 + 后 1),4×3090 开放式散热卡风道无忧
- Reddit 4×3090 实战背书(ROMED8-2T 社区标配机箱)
- 唯一注意:719 官方标称支持 SSI-EEB,但 MZ32-AR0 的 330mm 深度接近上限——下单前问一句客服“能装 305×330mm 的 EEB 板吗”,或者直接买 MZ32-AR0 前先确认这板的具体长宽
备选:安钛克 P101(约 ¥700)
- 同级 EEB 兼容,静音棉版,风道略逊 719 但更安静
- 盘位 8×3.5 + 3×2.5
━━━━━━━━━━━━━━━━━━━━━━
四、最终清单(含电源机箱)
━━━━━━━━━━━━━━━━━━━━━━# 配件 型号 价格 1 主板 MZ32-AR0(一年保) ¥2300 2 CPU EPYC 7B13 64 核 128 线程的 Zen3 ¥3898 256MB L3缓存 基频约 2.2GHz。 全核睿频约 3.25GHz。 单核睿频最高可达 3.5-4.1GHz|3 | 机箱 | 追风者 Enthoo 719 | ~¥800 |
| 4 | 电源 | 振华 LEADEX III 2000W 金牌 | ~¥2300 |
| 5 | 散热 | SP3 塔式(利民/猫头鹰) | ~¥300 |
| | 合计 | | ~¥9600 |比原预算(¥8000)超了约 ¥1600——主要是 7B13 比 7B12 贵的那部分。如果总预算要压回 ¥8000,电源降到长城巨龙 2000W(省 ¥700)即可,性能零影响。
最后下单前唯一必问:MZ32-AR0 Rev 3.x + BIOS 认 7003(7B13)。这颗定了,机器就能转起来。
-
目前和GLM FLASH聊了快一天了, 这是最终草稿,请各位大神指正。
一、功耗账(先算再买)
━━━━━━━━━━━━━━━━━━━━━━部件 满载 7B13(cTDP 225-280W) ~240W 4×3090(限功率 250-280W/卡) 1000-1120W 内存 16 条 + 风扇 + 硬盘 + 主板 ~100W 峰值合计 ~1350-1450W 电源黄金法则:负载控制在额定 60-80%(效率曲线甜点 + 瞬态余量)→ 额定 1800W 是及格线,2000W 是舒适线。3090 有毫秒级 2 倍瞬时尖峰(我们 DL380 调研时领教过 550W+ 瞬态),冗余必须留足。
━━━━━━━━━━━━━━━━━━━━━━
二、电源选型(三档)
━━━━━━━━━━━━━━━━━━━━━━首选:海韵 PRIME PX-2000W(钛金)约 ¥3500-4000
- 2000W 单路 +12V,原生态 12×8pin PCI-e(不用转接线),10 年保
- 3090 瞬态尖峰最怕组电压跌,钛金纹波控制最稳
性价比:振华 LEADEX III ATX 2000W(金牌)约 ¥2200-2500
- 2000W,8-10 组 PCI-e,7 年保,3090 社区常用款
_budget:长城巨龙 GTN 2000W(金牌)约 ¥1500-1800
- 国产老大,keinsci 那位 7K62 老哥同款系列,够用,接口数确认 ≥10 组 8pin
️ 关键验收点(买前问一句):原生 8pin PCI-e 接口 ≥8 组。4×3090 = 8 条独立供电线,严禁一分二(单线带 300W 是 3090 红线)。接口不够的要加 PCIe 转 2×8pin 的正规显卡线,不要用电源附赠的杂牌线。避开:任何 1600W 以下(4 卡 + 7B13 顶着上限跑)、服务器冗余电源(CRPS 需要配转接板 + 分线器,噪音大,DIY 塔式不值得折腾)。
━━━━━━━━━━━━━━━━━━━━━━
三、机箱选型
━━━━━━━━━━━━━━━━━━━━━━硬性需求:EEB 兼容(MZ32-AR0 是 305×330mm,比 E-ATX 305×277 还深)+ 9 个以上 PCI 扩展位(7 条 x16 槽 + 风扇位)+ 4 卡限长 ≥340mm。
首选:追风者 Enthoo 719(约 ¥800)
- 8+3 扩展位,支持 SSI-EEB(355×335mm 板都装得下)
- 4×3.5“ + 11×2.5” 盘位(16 条内存旁边还能塞大容量硬盘)
- 风扇位充足(前 4 + 顶 3 + 后 1),4×3090 开放式散热卡风道无忧
- Reddit 4×3090 实战背书(ROMED8-2T 社区标配机箱)
- 唯一注意:719 官方标称支持 SSI-EEB,但 MZ32-AR0 的 330mm 深度接近上限——下单前问一句客服“能装 305×330mm 的 EEB 板吗”,或者直接买 MZ32-AR0 前先确认这板的具体长宽
备选:安钛克 P101(约 ¥700)
- 同级 EEB 兼容,静音棉版,风道略逊 719 但更安静
- 盘位 8×3.5 + 3×2.5
━━━━━━━━━━━━━━━━━━━━━━
四、最终清单(含电源机箱)
━━━━━━━━━━━━━━━━━━━━━━# 配件 型号 价格 1 主板 MZ32-AR0(一年保) ¥2300 2 CPU EPYC 7B13 64 核 128 线程的 Zen3 ¥3898 256MB L3缓存 基频约 2.2GHz。 全核睿频约 3.25GHz。 单核睿频最高可达 3.5-4.1GHz|3 | 机箱 | 追风者 Enthoo 719 | ~¥800 |
| 4 | 电源 | 振华 LEADEX III 2000W 金牌 | ~¥2300 |
| 5 | 散热 | SP3 塔式(利民/猫头鹰) | ~¥300 |
| | 合计 | | ~¥9600 |比原预算(¥8000)超了约 ¥1600——主要是 7B13 比 7B12 贵的那部分。如果总预算要压回 ¥8000,电源降到长城巨龙 2000W(省 ¥700)即可,性能零影响。
最后下单前唯一必问:MZ32-AR0 Rev 3.x + BIOS 认 7003(7B13)。这颗定了,机器就能转起来。
-
我把“4×3090 场景下到底谁吃谁”的逻辑链钉死:
━━━━━━━━━━━━━━━━━━━━━━
为什么 ROMED16-2T + 2×7K62 在你的场景必输
━━━━━━━━━━━━━━━━━━━━━━① GPU 拓扑:4 卡 TP 的命门,双路先输一半
4×3090 张量并行 = 每层 2 次 allreduce,卡间通信密度极高。ROMED16-2T 的槽位分布是 Slot1/3/5 挂 CPU0,Slot4 挂 CPU1——4 张卡插满必然 2 卡在 CPU0、2 卡在 CPU1,6 对卡间通信里 4 对要跨 socket 走 xGMI 链路(延迟更高、带宽更低)。MZ32-AR0 是 4 卡全部直连同一颗 CPU 的根复合体,6 对通信全部同 NUMA 均匀无跨片。TP=4 的 decode 稳定性和 allreduce 延迟,单路拓扑结构性占优。
② 内存带宽优势是纸面的
双 7K62 聚合 273 GB/s 看着唬人,但三个折扣连环打:
- 6CCD vs 8 通道的错配是每颗 U 各自存在的,双路不会互相治愈——keinsci 那个 220 vs 300 GB/s 的实测就是双路 7K62 的真实成绩
- 打完折的 ~220 GB/s 要软件真正跨 NUMA 扩展才能吃到;llama.cpp/vLLM 的 NUMA 绑定是“能用但要调”,跨域访存一多反而比单路还慢
- 你的主力负载(27B 级 dense 全驻 96GB 显存)decode 阶段根本不碰内存带宽——显卡自己读显存。带宽优势只对将来的 MoE 卸载有意义,而那是你 96GB 显存装不下之后的次级需求
③ 账面:多花 ¥1600+ 买劣势
MZ32-AR0 + 7B13 ROMED16-2T + 2×7K62 板 + U ¥6200 ¥7800-8800 散热 1 套 ~¥850 2 套 ~¥1700 待机功耗 ~90W ~150-180W(常年开机一年多花 ~¥300 电费) 4 卡 Gen4 x16 ✓ 全部同 NUMA ✓ 但跨双 socket 故障面 单 CPU 双 CPU + NUMA 调优 总价反超 ¥1500-2500,换来的是 GPU 拓扑变差 + 单核性能降一代(Zen2 vs Zen3)+ 复杂度翻倍。96 核 vs 64 核是你唯一真赢的维度——但 4 卡推理主机里 CPU 核数在 64 之后就是富余,不是生产力。
━━━━━━━━━━━━━━━━━━━━━━
结论
━━━━━━━━━━━━━━━━━━━━━━确定。4×3090 场景下 MZ32-AR0 + 7B13 全面占优,没有悬念。 双路的唯一翻盘场景是“多租户虚拟化,按 socket 拆成两台独立机器租出去”——那不是你的需求。
 ️ Hindsight — saving to memory…
这套 ¥9450 不用再验证了,它就是终点站。四单拍完,等货。 @xiaote -
感觉楼主除非要搞那种非法的或成人的内容,不然不如用线上的AI吧,电费都要贵死
-
结论我同意:你这个负载(4×3090、27B dense 全驻显存)选 MZ32-AR0 + 7B13 单路是对的。但把机理说准,免得以后调优走错方向。
1)真正的分水岭不是内存带宽,是跨 socket 的 GPU P2P 能不能直连。Rome 双路下,分属两个 root complex 的 3090,PCIe P2P 常常被 ACS/IOMMU 挡掉、或根本没通,NCCL/SGLang 会退化成 host-staged(写 sysmem 再读回)或 SHM——这是模式切换,不是「延迟高一点」。所以单路把 4 卡放进同一个 root complex 是结构性占优,你的判断成立。验收别只看 xGMI 理论带宽:nvidia-smi topo -m / topo -p2p r 全 OK,且 NCCL_DEBUG=INFO 里是 P2P/SHM 而不是 SYS,才算真同 NUMA。
2)4×3090 更大的杠杆是 NVLink 成对,不是主板。两对桥接后对内 allreduce 走 112 GB/s、完全不碰 PCIe;板子只要保证「每对相邻、槽距够 3/4 槽桥、4 卡同 root complex」。所以预算优先蹲桥;桥拿不到就退回 TP=2×2 两个独立对,比硬上 TP=4 走 PCIe 划算。
3)内存带宽那条要分清:dense 全驻显存时 decode 确实不碰系统内存,双路 273 GB/s 是纸面优势没错;但将来真要大 MoE 卸载,瓶颈也是「单路 8 通道 + NUMA 绑定」,双路只会把调优复杂度翻倍,不会救你。所以现在和将来结论一致。
4)下单前两个核对:7B13 是 OEM/散片,确认板子 BIOS/AGESA 支持 Milan;MZ32-AR0 的 Gen4 x16 槽位要确认 7B13 的 128 lane 够分、4 卡都能跑 x16。这两点过了,这套就是终点站。