跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签 硬件 AI 广场
  1. 主页
  2. 版块
  3. AI硬件
  4. Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G

Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G

已定时 已固定 已锁定 已移动 AI硬件
macapple-m5视频生成
20 帖子 9 发布者 294 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • E
    E
    eddie-hk
    编写于 最后由 编辑
    #11

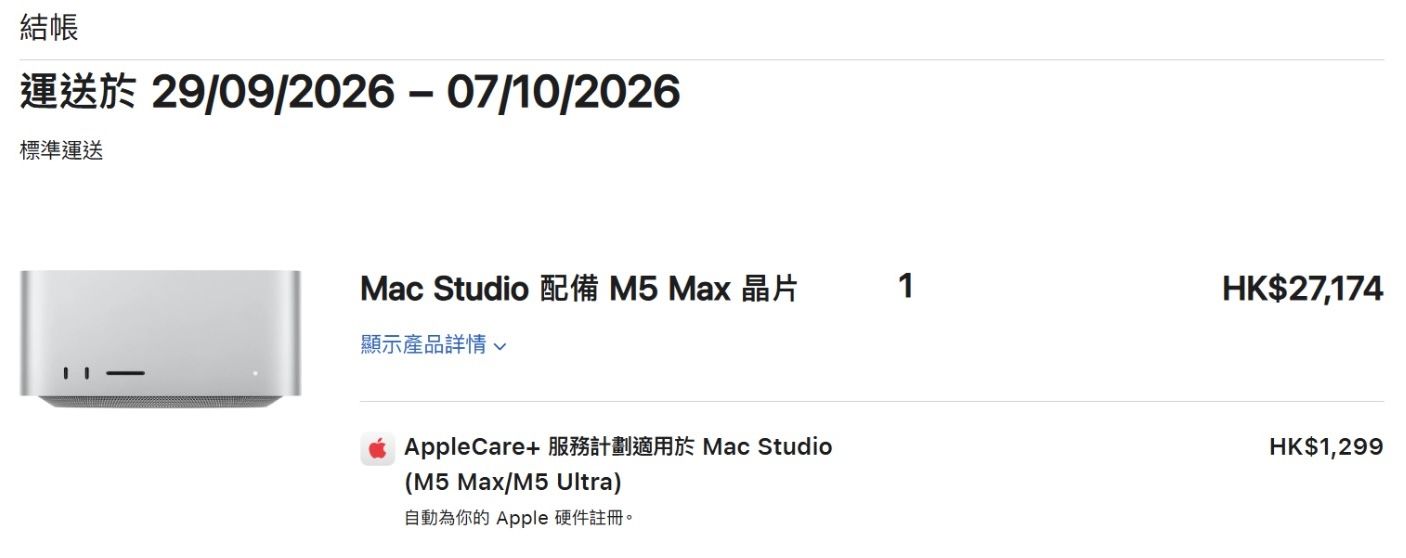
    我最後在星期日也托朋友下單了 Mac Studio M5 Max 64g 1TB,下月頭到,到時也可以測試一下。

    d31dac96-6947-4343-b195-bd4d3b0c3dd5.jpeg

    1 条回复 最后回复
    0
    • F
      F
      fsclsnow
      编写于 最后由 编辑
      #12

      我选Mac Studio M5 Max的理由:

      等M5 Max Studio的原因:

      1. MacBook 14 散热太差其实跑不动M5 Max
      2. MacBook 16 依然很难发挥Max全部能力,同时便携性很差;除非贪他的优秀大屏。
      3. 个人没有很大的移动办公需求;现在出门可以用Telegram远程下指令调配任务,固定的工作站式24*7的服务器模式更合适。已经在用M4的Mac Mini作为小型家庭服务器,体验极佳。
      4. 相比MacBook,相同配置Studio价格更实惠
        -MacBook 16 Max-40GPU,64G,2T-最低标配 - $5,399; 直逼低配Ultra了 ($5,499)
      5. 为什么选这个配置 (40GPU, 64G内存)?
      • 32GPU只有400多G内存带宽;40GPU才有614G (Ultra 统一都是1.2T)
      • 128G内存价格也直逼Ultra低配版了(1T硬盘,$5,399),(96G内存 $5,499; 有这个预算的话,个人建议直接上最低配的Ultra
      • 个人暂时没有音视频工作流的打算,如果有大多也不会选Mac吧;多开还是Ultra高带宽高内存更好;当然有钱啥都不是事儿;综合考量着现在这个价位能跑本地Qwen3.8-27B游刃有余,可坚固日常办公Agent任务需求;是很好的中间位
      • 缺货问题。现在我这边Max 128G是期货,待机1个月+
        Screenshot 2026-09-24 at 10.58.03.png
        ; Ultra 低配待机已经超过2个月
        Screenshot 2026-09-24 at 10.59.10.png
        ;
      1 条回复 最后回复
      2
      • F
        F
        fsclsnow
        编写于 最后由 fsclsnow 编辑
        #13

        第一手测试资料:
        先说基准测试 - MLX:
        Qwen3.8-27B-MLX-6bit (模型 22.8G)
        目前四档实测
        Context Prefill Decode Peak Memory 512 tokens总时间
        8K 921.3 tok/s 23.17 tok/s 25.26 GB 30.9 s
        32K 845.4 tok/s 21.62 tok/s 26.87 GB 62.5 s
        128K 596.8 tok/s 16.69 tok/s 33.69 GB 248.8 s
        256K 436.7 tok/s 13.05 tok/s 42.74 GB 643.7 s

        Qwen3.8-27B-MLX-4bit (模型 16.1G)
        Context Prefill Decode Peak Memory 512 tokens总时间
        8K 985.1 tok/s 31.92 tok/s 18.53 GB 24.3 s
        128K 626.1 tok/s 21.10 tok/s 26.96 GB 231.6 s
        256K 447.2 tok/s 15.49 tok/s 36.01 GB 613.8 s

        基准和网上MacBook M5 Max的测试数据差不多;长上下文内存占用不多,256K 6Bit差不多42G,4Bit36G,还是跑的动,且有冗余20来G分配给系统和Agent等。长上下文是主要耗时还是在Prefill,将近10分钟。

        1 条回复 最后回复
        2
        • F
          F
          fsclsnow
          编写于 最后由 编辑
          #14

          另外补充我很喜欢的一点:
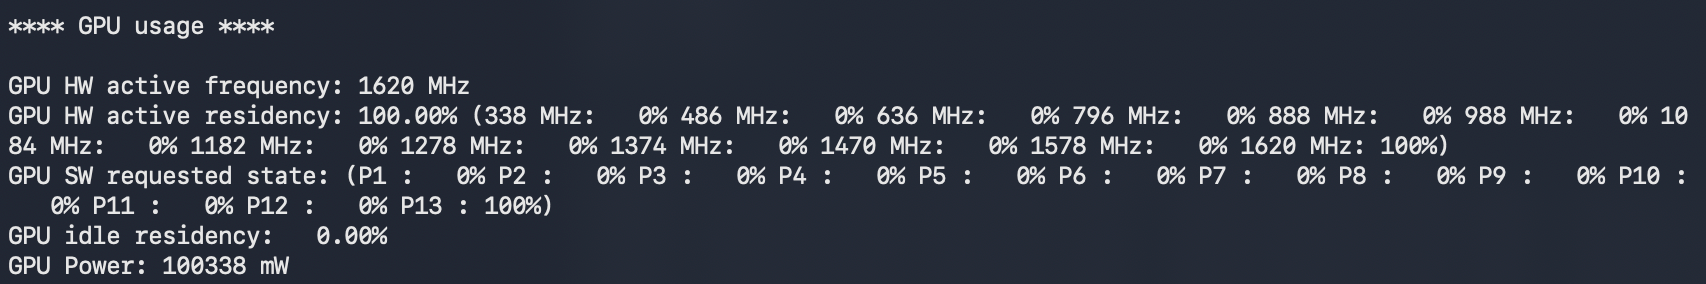
          GPU 满载时 GPU功耗也就100W
          仔细听可以听到风扇声音,但也非常轻。环境音下,不特别关注几乎完全注意不到。
          这样就可以很放心的放在家里任何地方,无论是工作室,机房,甚至是卧室。

          Screenshot 2026-09-24 at 11.25.06.png

          1 条回复 最后回复
          0
          • suboyangS
            suboyangS
            suboyang
            编写于 最后由 编辑
            #15

            关键Qwen3.8-27B-MLX-6bit 没意义啊,这么低精度,干活干一会就累了。

            1 条回复 最后回复
            0
            • F
              F
              fsclsnow
              编写于 最后由 编辑
              #16

              用oMLX加载MTPLX优化的模型,关闭思考,启用Lightning MTP
              Model用的是Qwen3.8-27B-MTPLX-Optimized-Speed (19.5G)
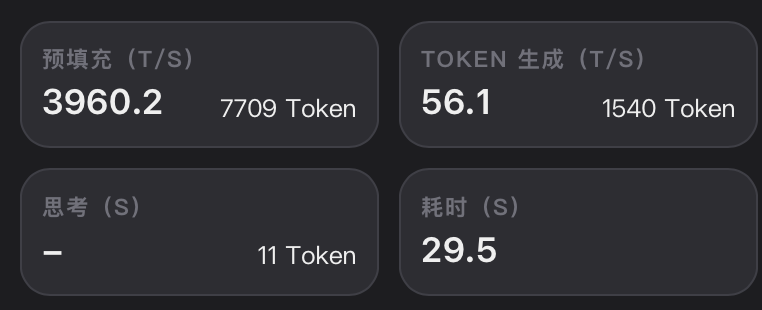
              执行简单回话,任务,写个贪吃蛇小游戏
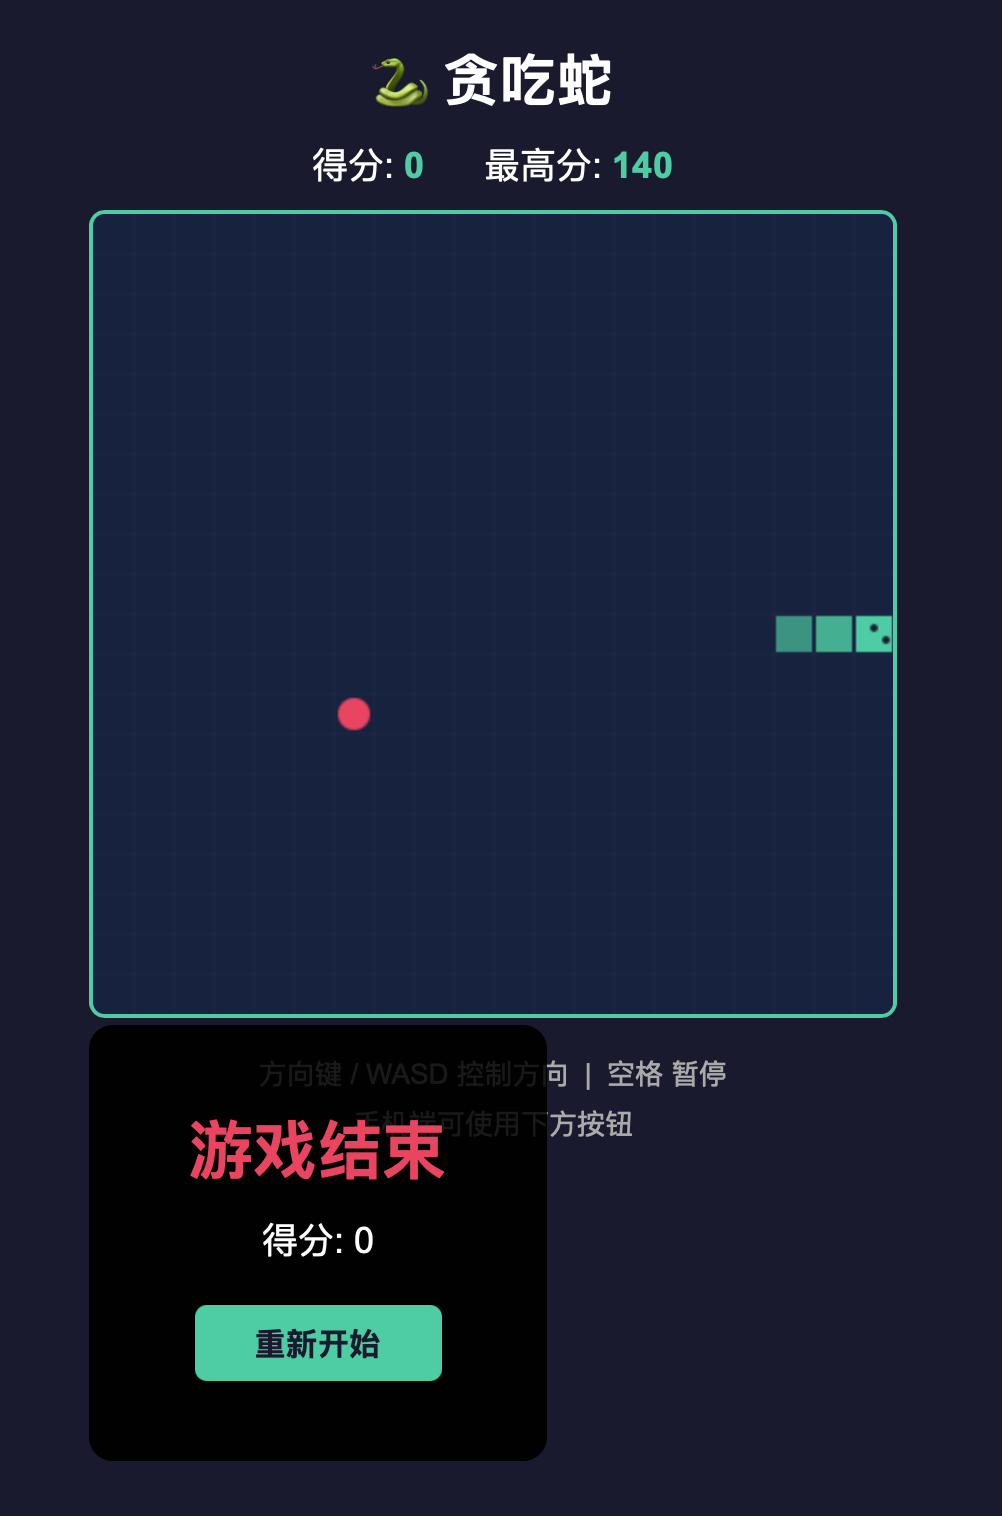
              Screenshot 2026-09-24 at 11.43.56.png
              一次成功,图形画面也不错
              Screenshot 2026-09-24 at 11.45.15.png
              数据还挺漂亮。
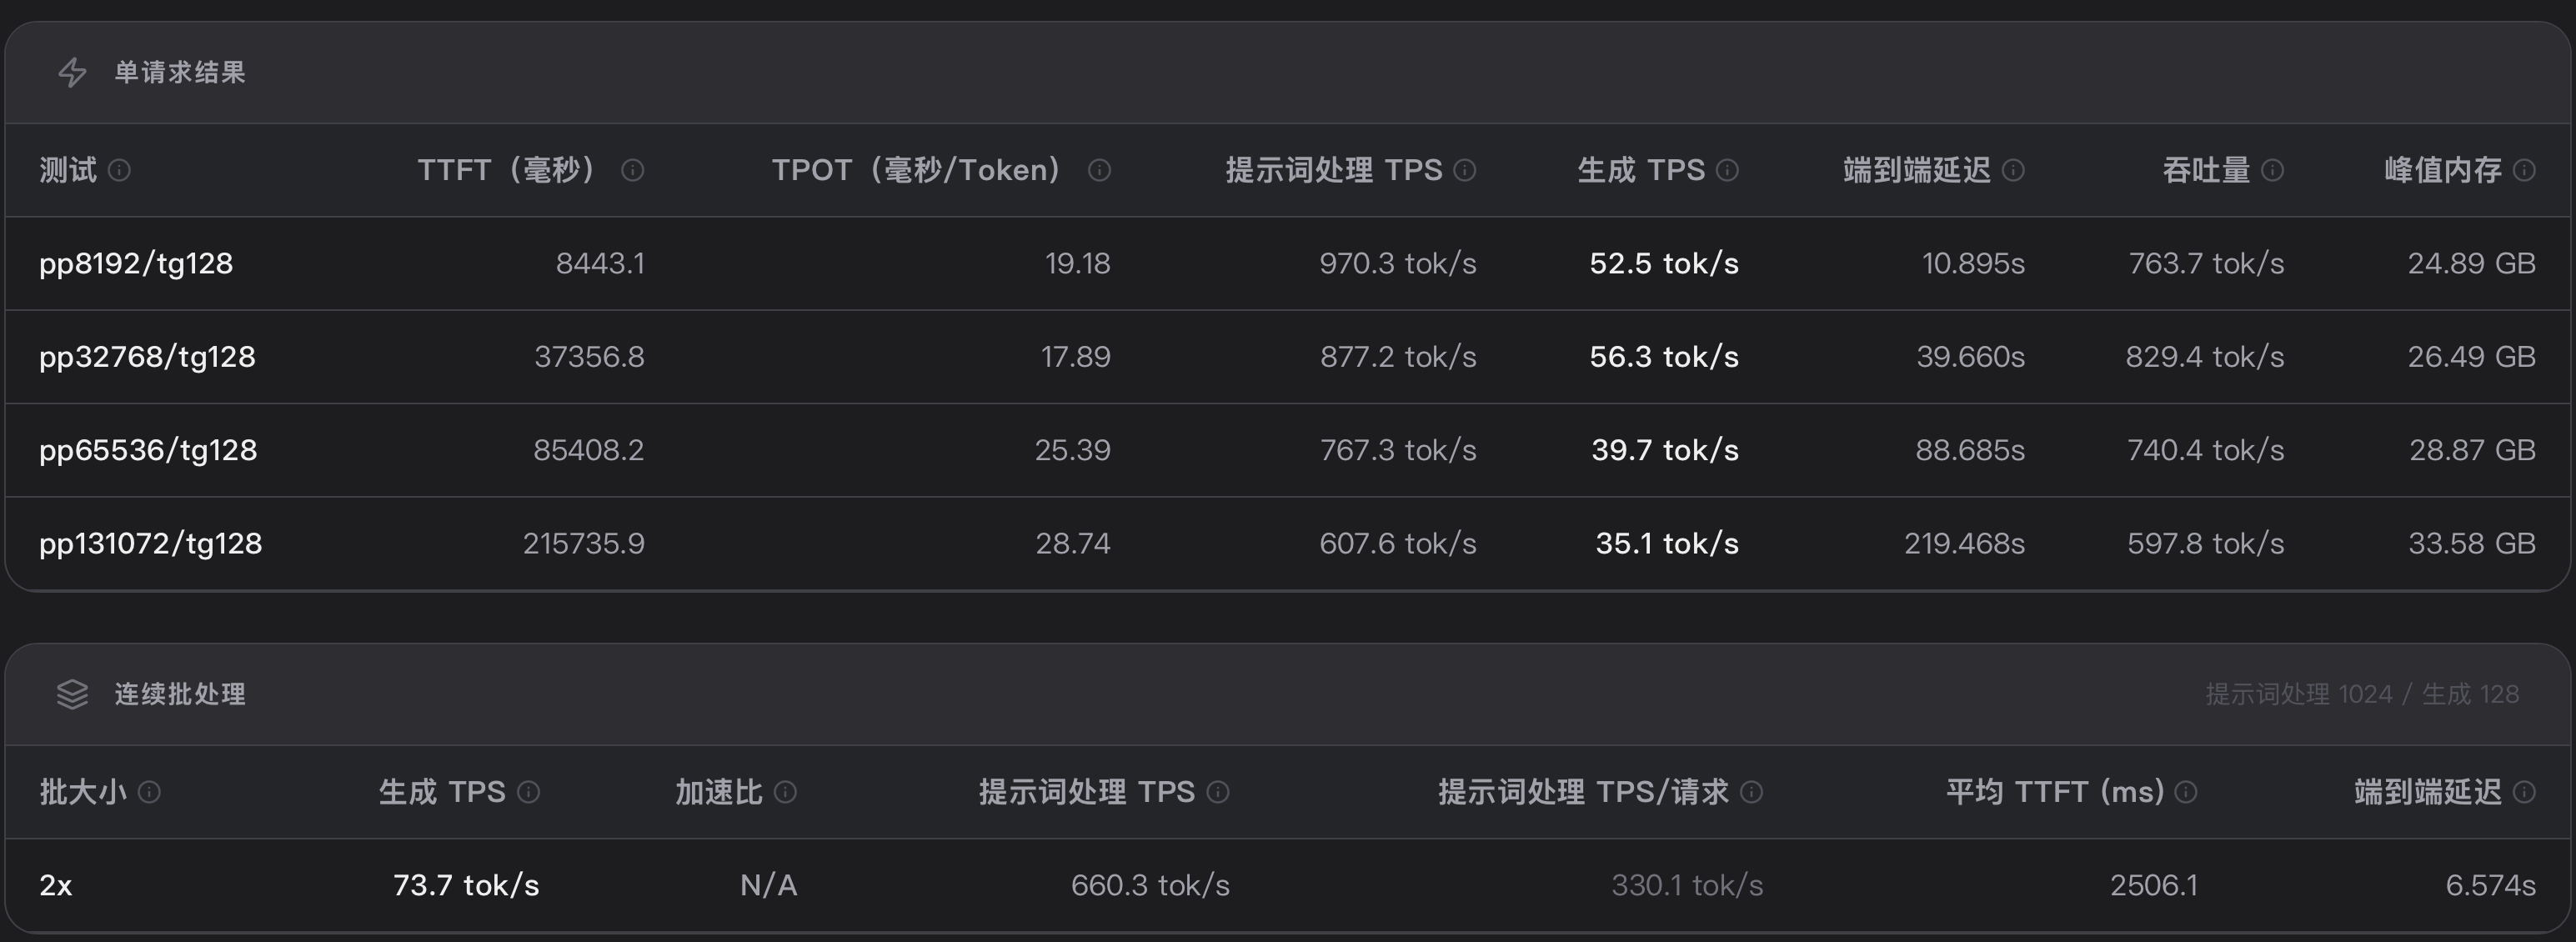
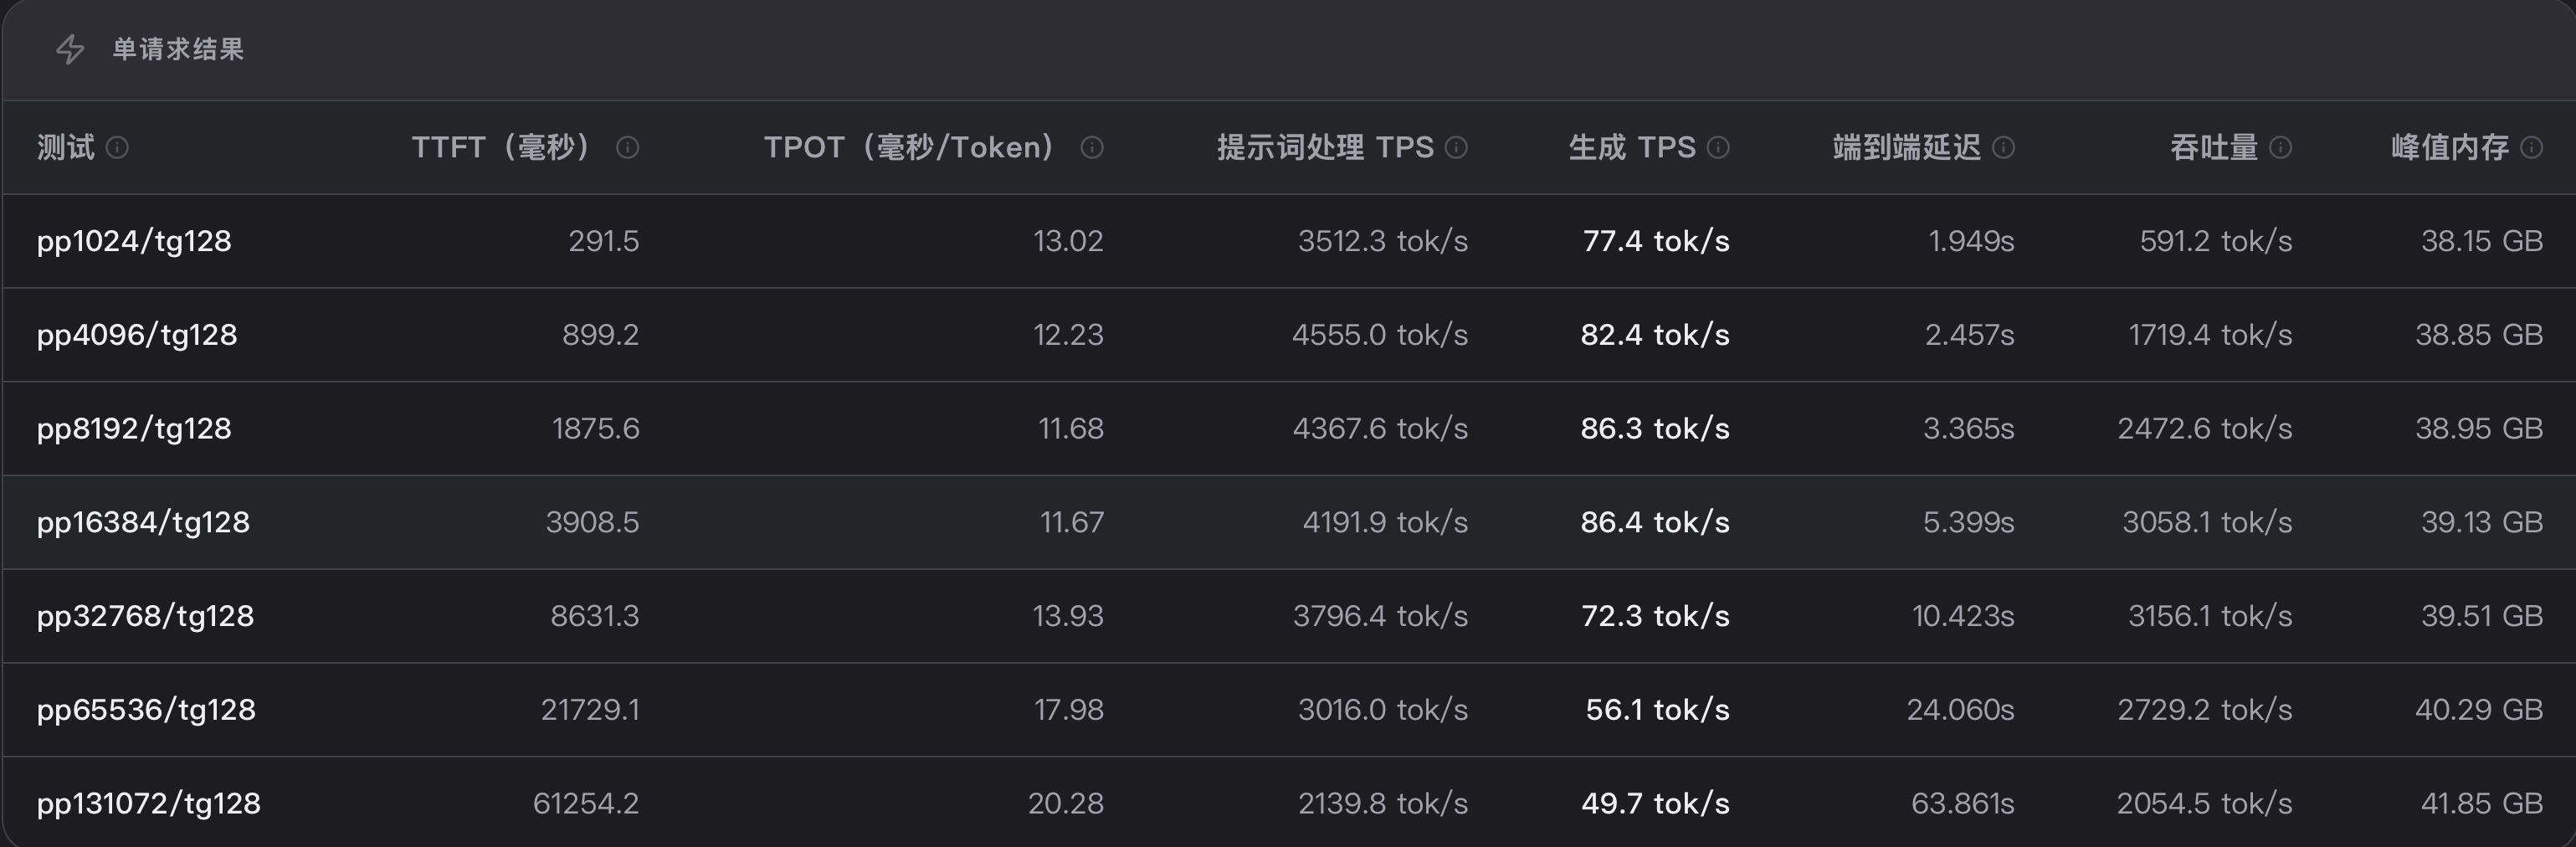
              性能测试结果:

              Screenshot 2026-09-24 at 11.46.41.png

              智力测试结果:
              智能基准对比

                         模式      抽样              Qwen3.8-27B-MTPLX-Optimized-Speed
              

              MMLU 抽样 1000/14042 83.6%
              CMMLU 抽样 300/11582 80.7%
              HELLASWAG 抽样 200/10042 93.0%
              TRUTHFULQA 全量 817 84.8%
              ARC_CHALLENGE 抽样 300/1172 96.7%
              WINOGRANDE 抽样 300/1267 79.0%
              GSM8K 抽样 100/1319 91.0%
              HUMANEVAL 全量 164 91.5%
              MBPP 抽样 200/500 80.0%
              LIVECODEBENCH 抽样 100/1055 60.0%
              BBQ 抽样 300/10864 92.7%
              SAFETYBENCH 抽样 300/11435 86.3%

              --- 详情 ---

              模型:Qwen3.8-27B-MTPLX-Optimized-Speed
              基准测试 准确率 正确 总数 Time(s) 思考

              MMLU 83.6% 836 1000 856 否
              CMMLU 80.7% 242 300 93.5 否
              HELLASWAG 93.0% 186 200 82.9 否
              TRUTHFULQA 84.8% 693 817 245.3 否
              ARC_CHALLENGE 96.7% 290 300 106.8 否
              WINOGRANDE 79.0% 237 300 79.7 否
              GSM8K 91.0% 91 100 515 否
              HUMANEVAL 91.5% 150 164 375.9 否
              MBPP 80.0% 160 200 535.2 否
              LIVECODEBENCH 60.0% 60 100 2561 否
              BBQ 92.7% 278 300 86.2 否
              SAFETYBENCH 86.3% 259 300 91 否

              可能是关闭思考的关系,LiveCodeBench测试只拿到了60%
              别的基本都还挺高
              1 条回复 最后回复
              0
              • F
                F
                fsclsnow
                编写于 最后由 编辑
                #17

                备注:
                本人是纯菜鸟。不是UP主,不是从业者
                自己在虚心关注,学习,练习中。
                希望能拽住时代大浪潮的尾巴,不被甩开太远。

                望各大佬不令指导指正。

                1 条回复 最后回复
                0
                • Tony WangT
                  Tony WangT
                  Tony Wang
                  超级版主
                  编写于 最后由 编辑
                  #18

                  @fsclsnow

                  这个速度很不错了, 已经达到了可用的程度. 4bit量化的 qwen 27B, 应对日常Agent的任务, 完全没有问题.

                  生图你可以考虑用Drawthings, 通过Agent 工具调用, 我估计你的 M5 max, 比如用zimage生图的话, 1024*1024 也就10秒左右一张. 而且你64G内存, 同时跑LLM和生图没问题.

                  至于prefill, 如果是长上下文的话, 你可以考虑打开 SpecPrefill , 不过这是双刃剑. prefill 速度能暴增, 但是长链任务有可能遗忘一些内容.

                  1 条回复 最后回复
                  0
                  • E
                    E
                    eddie-hk
                    编写于 最后由 编辑
                    #19

                    @fsclsnow 謝謝師兄分享,小弟也是小白一名,之後可以直接抄功課了 🙏🏻

                    1 条回复 最后回复
                    0
                    • F
                      F
                      fsclsnow
                      编写于 最后由 fsclsnow 编辑
                      #20

                      接着测试 oMLX with Qwen3.8-35B-A3B-Distill-oQ8-fp16-mtp(38.6G)
                      (oMLX上没找到35B-A3B 4Bit的mtp模型)

                      Screenshot 2026-09-25 at 11.39.24.jpeg
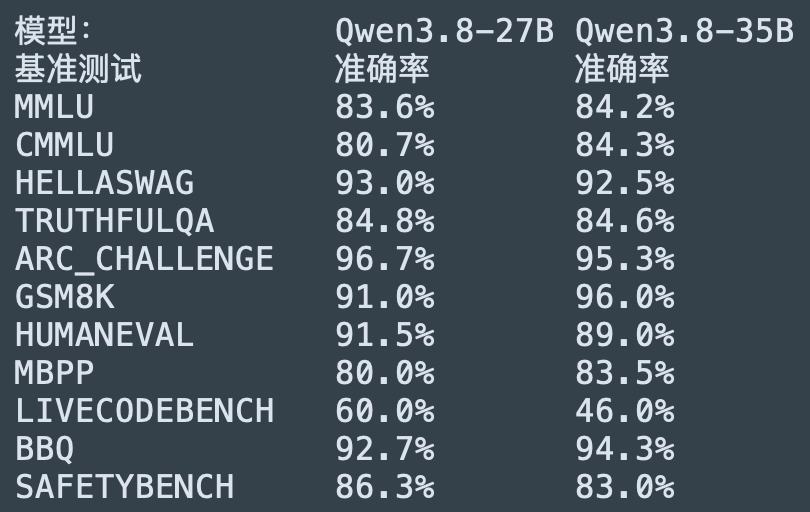
                      A3B模型性能更好了,缺点是因为Q8占内存更高,上下文128K以上就压力太大了。

                      智力测试与27B(Q4)对比:

                      Screenshot 2026-09-25 at 12.53.54.png

                      除了LIVECODEBENCH 低了不少,其余测试似乎和4Bit 27B不相上下

                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组