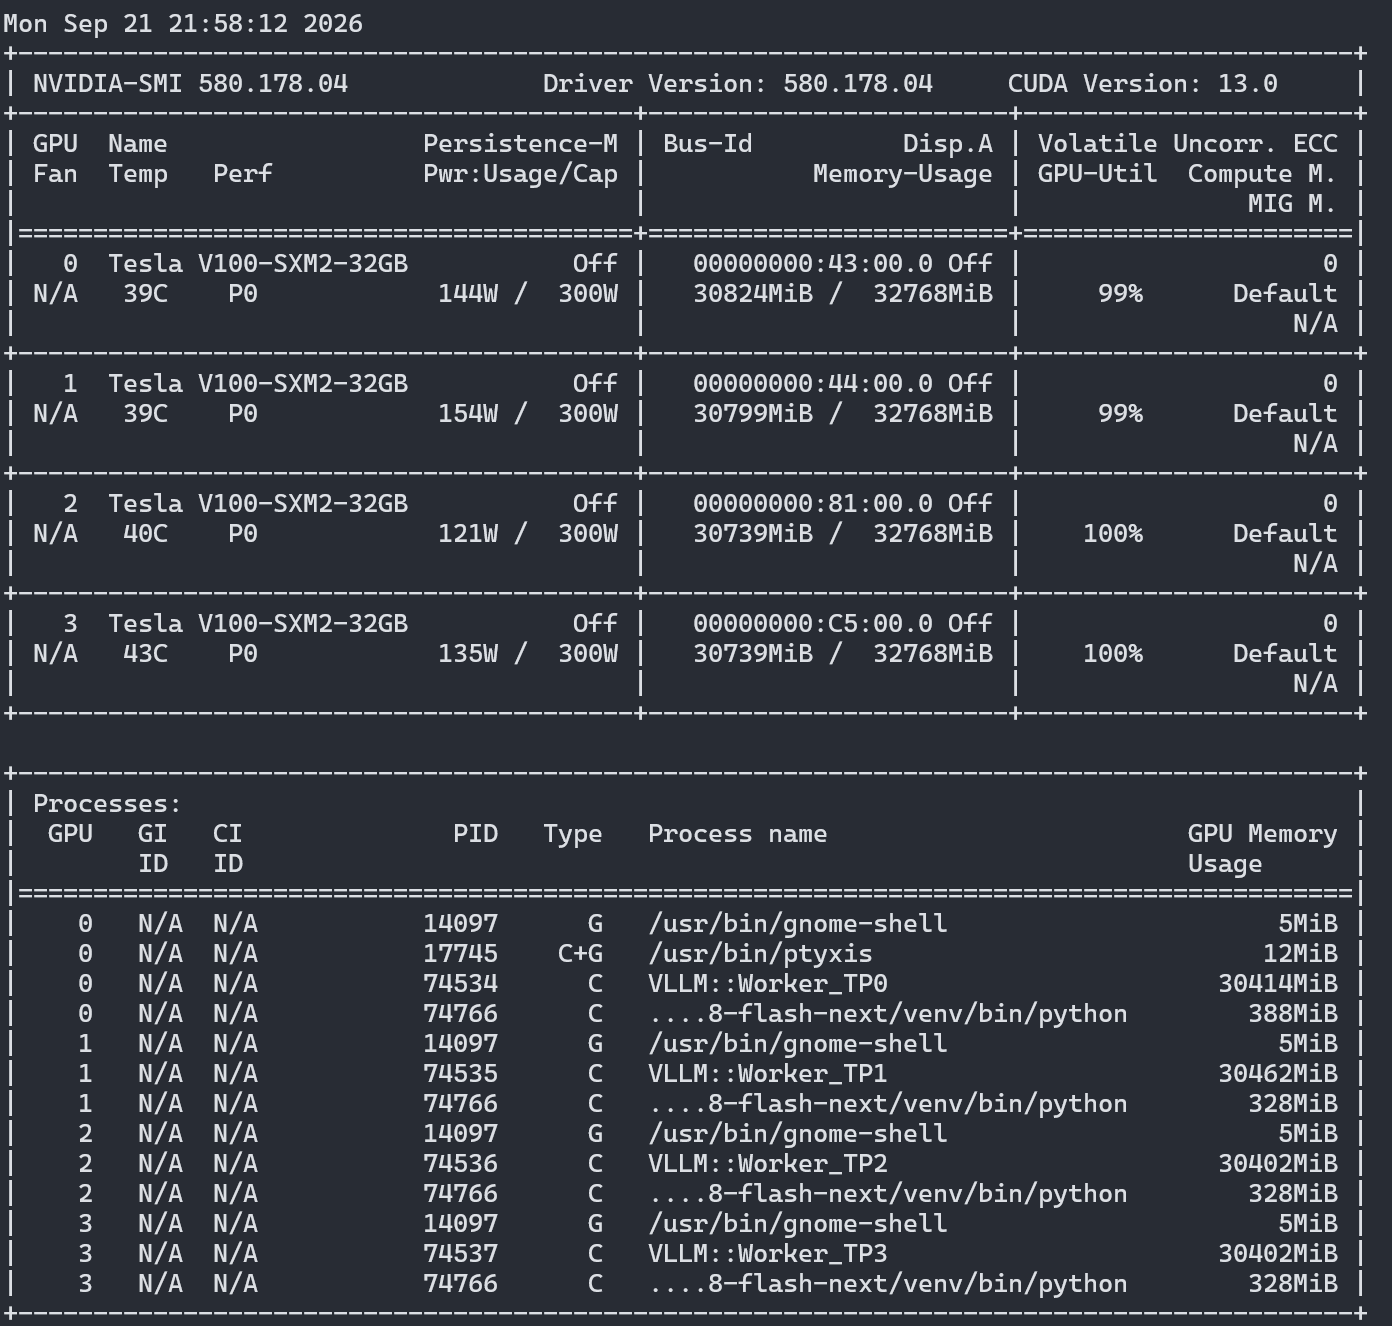
4卡V100 32G跑Qwen 3.8 Flash Next
-
最近又入手了一組雙卡V100 32G 擴展塢, 帶NVLINK, 用PEX8749 PCIe Switch接到PC. 這台PC原本有兩張V100 32G無NVLINK PCIE, 把它插在一起組成4卡128G, 兩張無nvlink, 兩張有nvlink的奇怪組合. 128G目前能裝的大概只有qwen 3.8 flash next, 於是就動手把它裝起來, 步驟如下:
- 打開chatgpt web, 讓他去找目前網路上的最佳組合, 然後出個prompt給我
- 用Antigravity cli + gemini 3.8 flash照prompt安裝, 約三小時裝好, 無須介入
- 叫gemini寫報告, 給chatgpt看. chatgpt提出一些調整建議與測試驗證
- Gemini又花了約兩小時做完, 結論是不用調, 測試全數通過, 一樣無須介入
以下是最終報告:
一、目前模型與服務核心配置 (Production Baseline)
1. 核心模型參數
參數名稱 數值 / 設定 備註說明 Model API ID qwen-3.8-flash-nextOpenAI 相容調用模型名稱 Base Checkpoint RadixArk/Qwen3.8-Flash-Next-NVFP4官方原版非 abliterated 量化權重(commit 7b71922)模型權重總量 ~125.9 GiB(206 safetensors shards) 存放於 /opt/llm-qwen3.8-flash-next/models/Context Size (ctx size) 200,000 tokens (200K) --max-model-len 200000(實測驗證穩定上限)Max Sequence Num 4 --max-num-seqs 4Max Batched Tokens 4,096 --max-num-batched-tokens 4096(嚴格 A/B 評測勝出者)GPU 利用率上限 0.92 (92%) --gpu-memory-utilization 0.92Parallelism TP=4, PP=1 跨 4 張 V100 進行張量平行,流水線平行設為 1 MTP / 投機解碼 關閉 (OFF) 實測證實 MTP k=1 吞吐倒退 14% 且破壞 200K 容量規範 通訊優化 --disable-custom-all-reduce關閉 PCIe 自訂算子,依賴 PyNCCL 混合 NVLink/PCIe 環 2. KV Cache 與顯存資源配置
項目 數值 / 配置 詳細說明 KV Cache Dtype FP16 ( float16)SM70 專屬原生浮點精度,無量化損耗 單卡可用 KV Cache 6.48 GiB / 卡 TP4 總計 25.92 GiB 專供 KV 快取 GPU KV Cache 總容量 513,207 tokens 充裕空間保障高並發與長上下文 200K 最大並行度 2.57× 滿載 200K 上下文下保障 2.57 條並發(滿足 $\ge 2.0\times$ 生產硬指標) Block Size 784 tokens --mamba-cache-mode align自動對齊 Mamba 狀態頁Prefix Caching 啟用 (ON) 提示詞命中後 TTFT 提升達 4.0× ~ 14.7× PLE / N-gram Offload 45.7 GiB 釘選於主機 RAM VLLM_PLE_CPU_OFFLOAD=1,釋放 ~46 GB GPU 顯存靜態顯存佔用 ~30,500 MiB / 32,768 MiB (93%) 每張卡預留約 2.26 GiB 安全餘裕,無 OOM 風險
二、執行的驗證項目與結果
1. API 功能與正確性測試(8/8 全數通過)
- 模型枚舉 (
/v1/models):正確枚舉qwen-3.8-flash-next。 - 基本問答 (Non-streaming):基礎問答正常,耗時 < 1s。
- 串流輸出 (Streaming):SSE 逐 Token 平滑輸出。
- 程式碼生成 (Coding):生成正確的 Python Fibonacci 迴圈實作。
- 多步驟推理 (Reasoning):清晰輸出多步驟思考鏈(CoT)。
- 工具呼叫 (Tool / Function Calling):精準解析
get_weather(location="Tokyo")。 - 結構化輸出 (Structured JSON):輸出符合 Schema 的 3 筆 JSON 資料並成功解析。
- 長文本檢索 (Long Context 2K):於 2,022 tokens 上下文中正確檢索目標並總結。
2. Prefix Caching 驗證
- 重播一致性:Cold 與 Warm 輸出為 100% 精確相符 (Exact Match)。
- 1.8K 前綴:TTFT 從 1.210s 降低至 0.302s,達到 4.01× 加速。
- 7.5K 前綴:TTFT 從 6.828s 降低至 0.464s,達到 14.71× 加速。
三、各項基準測試數據摘要 (Phase 2 Benchmarks)
所有評測均使用模型專屬 Tokenizer 校準實際 tokens,每項測試重複 3 輪取中位數(Median):
1. Prefill 效能 (PP 8K ~ 190K tokens)
Flash-Next 混合線性注意力架構展現線性擴展性,Prefill 速度恆定維持在 ~1,810–1,890 tok/s:
測試情境 實際 Prompt Tokens 首字延遲 (TTFT) Prefill 速度 峰值顯存佔用 PP 8K 8,019 4.311 s 1,860.0 tok/s 31,248 MiB PP 32K 32,019 16.953 s 1,888.7 tok/s 31,248 MiB PP 64K 64,019 33.960 s 1,885.1 tok/s 31,248 MiB PP 128K 128,019 69.259 s 1,848.4 tok/s 31,248 MiB PP 190K 190,019 104.796 s 1,813.2 tok/s 31,248 MiB 2. Decode 效能 (短長上下文解碼)
單序列解碼速度極為平穩,190K 極長上下文下僅微幅下降 9.2%:
上下文長度 輸出長度 解碼速度 平均 ITL (單字延遲) TTFT 2K (短文本) 128 tokens 57.46 tok/s 17.40 ms 1.100 s 2K (短文本) 512 tokens 57.33 tok/s 17.44 ms 1.103 s 32K (中長文本) 128 tokens 56.95 tok/s 17.56 ms 16.830 s 128K (長文本) 128 tokens 54.06 tok/s 18.82 ms 68.924 s 190K (極長文本) 128 tokens 52.17 tok/s 19.64 ms 104.411 s 3. Concurrency 平行並發壓測 (~2K Prompt, 512 Output)
導入
threading.Barrier同步屏障與獨立 Session 修復假性排隊後,並發擴展恢復正常:並發數 (C) 總體吞吐量 (Aggregate) 單請求平均速度 P50 TTFT P50 ITL 說明 C = 1 50.46 tok/s 57.42 tok/s 1.120 s 17.38 ms 基準單序列 C = 2 63.86 tok/s (+26.6%) 37.31 tok/s 1.978 s 25.86 ms 正常超越 C1(C2 異常徹底修復) C = 4 93.67 tok/s (+85.6%) 34.25 tok/s 4.014 s 28.53 ms 達到 TP4 伺服極限吞吐 4. 混合負載干擾 (Mixed Prefill/Decode Interference)
- Test A (32K decode + 64K prefill):
- 解碼中動態注入 64K 預填,Req B 預填耗時 55.59s (1,151.6 tok/s)。
- Req A 解碼受到突發干擾時之最大單字停頓(Max Stall):2,615.4 ms。
- Test B (128K decode + 64K prefill):
- Req B 預填耗時 77.24s (828.8 tok/s)。
- 由於 128K 解碼在 64K 預填中途即提早完成,未出現額外卡頓。
跑llama-benchy測試:
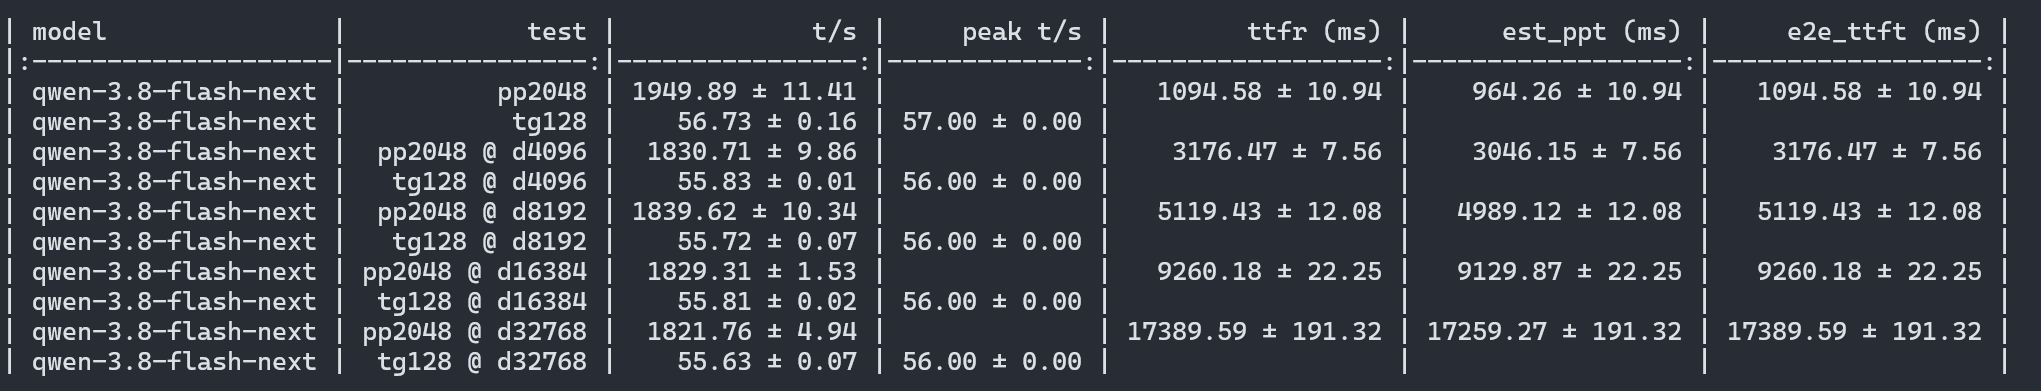
實際測試心得: 速度很快, 比單DGX spark快很多, 剛雙DGX spark插不多. 品質方面RadixArk的NVFP4是優於兩組DGX spark( Local-Lab NVFP4/NVIDIA NVFP4) , chatgpt說的, 還沒長時間實測.
Qwen 3.8 flash next我在DGX spark上面用了一段時間了, 同時單台跟兩台都有在用, 同時也在使用glm 5.3 flash跟Deepseek v4.1 flash. 就我的心得而言, Qwen 3.8 flash next是超越Deepseek的.
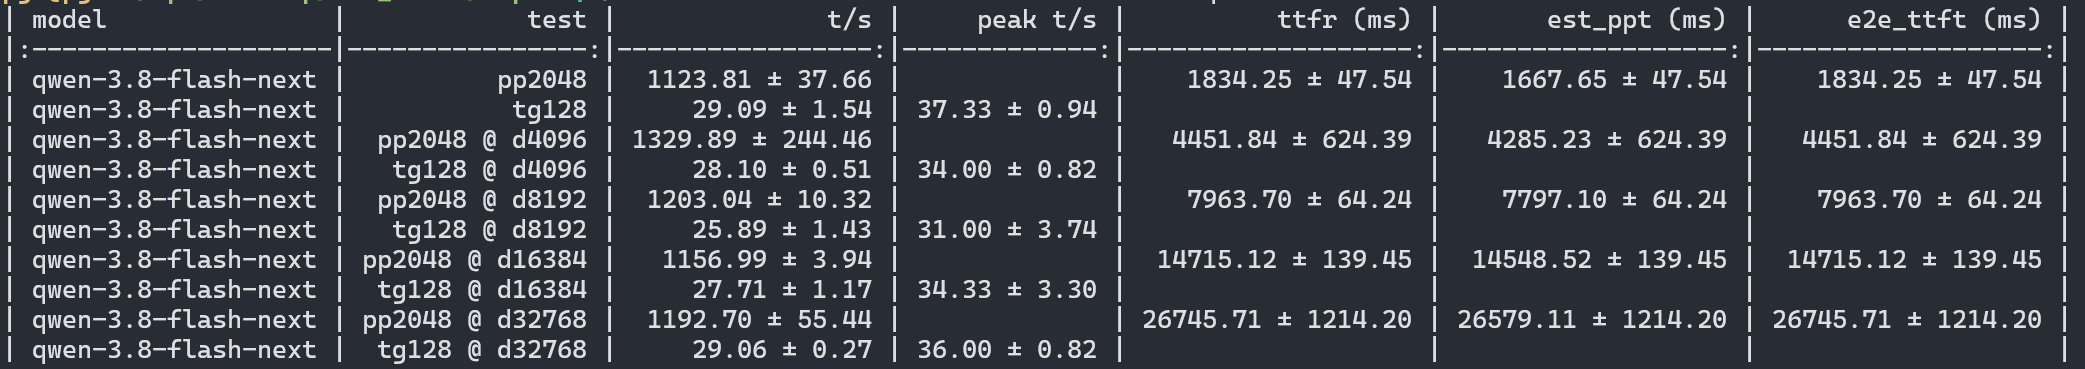
以下同時提供兩個DGX spark的llama-benchy測試數據:
單DGX spark:
雙DGX spark:
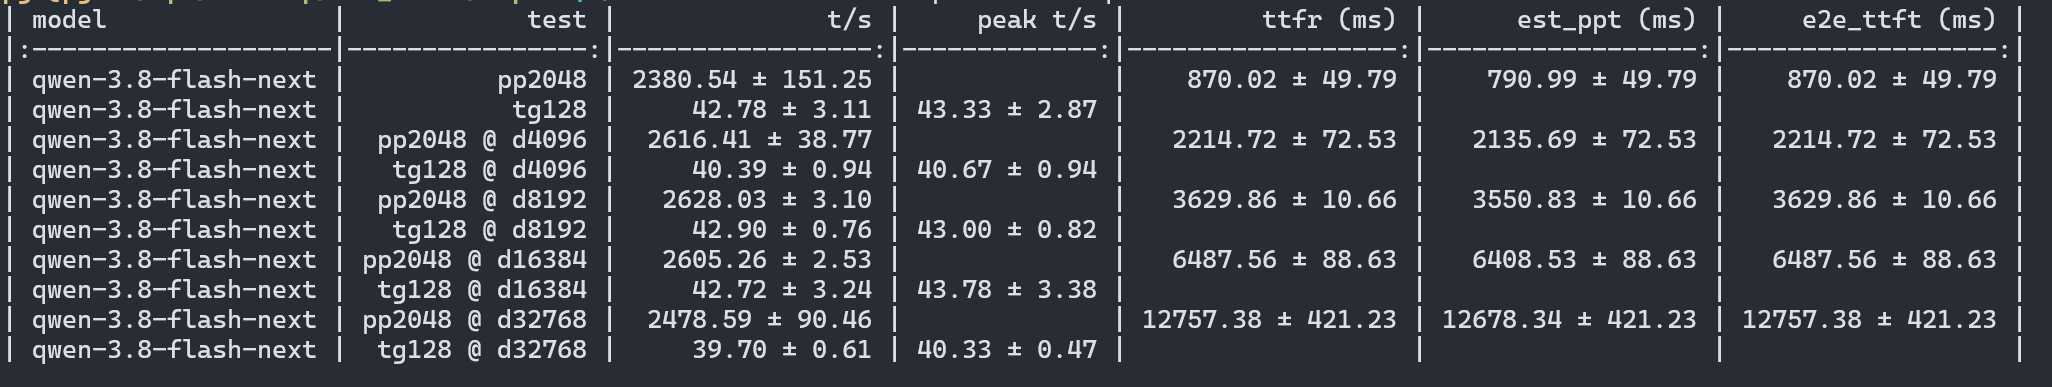
雙DGX spark經過修復後實際工作使用可以跑約50~70, 單DGX spark約3X, 4xV100 32G跑了一陣約5x-6x.
橫向對比另外一組雙v100 32G x 2 nvlink的 雙卡擴展塢, 跑Qwen 3.8 27B Q8, 速度約4x-5x, 數據如下:
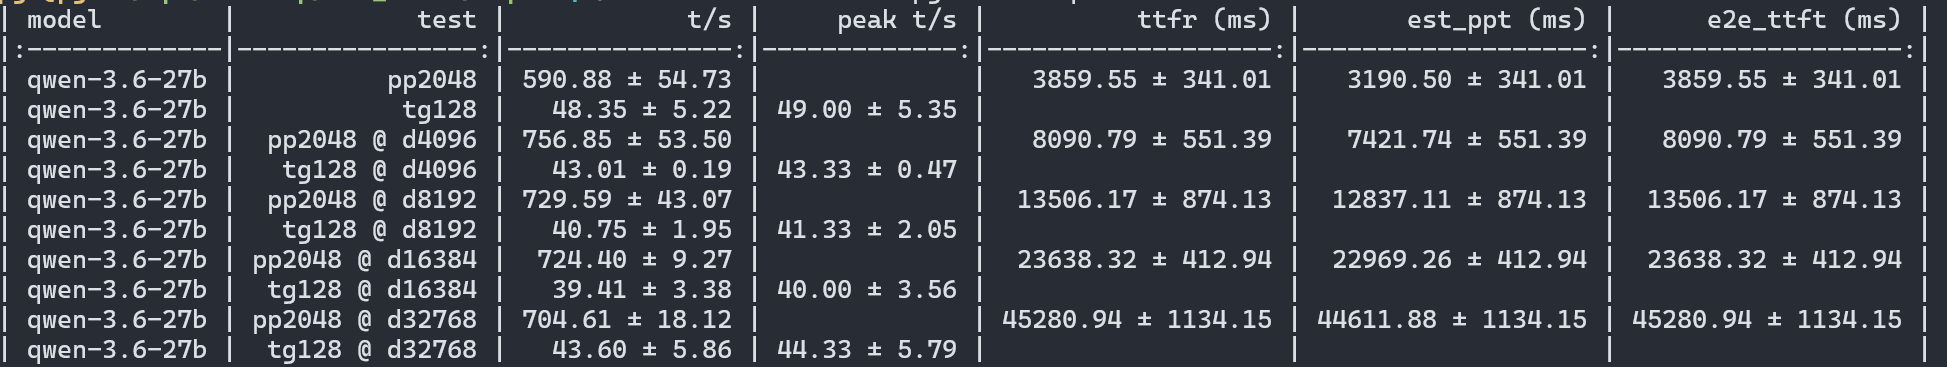
不過能力上27B相較之下還是稍弱了, prefill也略低.
-
,
 T terry 固定了此主题
-
4×V100 128G 能跑起 200K 很不容易,补一个拓扑上的坑:你这套是「两对 NVLink + PEX8749 switch」的异构组合,TP=4 会把 all-reduce 里最慢的那一跳放进每条路径。NVLink 对内是 ~300GB/s 双向,跨对/过 switch 只能走 PCIe,两者差一个数量级,所以瓶颈大概率不在算力也不在 HBM,而在跨对通信。
建议先量再调:
nvidia-smi topo -m+NCCL_DEBUG=INFO确认 all-reduce 实际走的是 P2P、SHM 还是 host-staged。--disable-custom-all-reduce交给 NCCL 自己组环是对的,但要亲眼确认它没退化成走 host。- 用
nccl-tests的all_reduce_perf打 busbw,看 4 卡的有效带宽是不是被跨对那一段压到 PCIe 档。如果是,TP=4 的每步都在付这个税。
如果确认跨对拖累明显,两个替代布局值得试:
- 2×TP=2 两个副本(各自落在有 NVLink 的一对上):单请求吞吐不变,但两个独立请求近似翻倍,跨对通信直接消失。
- PP=2×TP=2:把跨对通信压到 stage 边界,代价是流水线气泡和显存分配更紧。
另外两点口径:V100 是 SM70,没有 BF16/FP8/FP4 张量核,NVFP4 权重最终仍要反量化到 FP16 跑 matmul,所以你选 FP16 KV、关 MTP 是符合硬件的;
--max-num-seqs 4配 200K 时 4×200K=800K 已超过 513K 的 KV 总量,满上下文并发实际只能到 2 左右,这点建议在文档里写清,免得被当成 4 路满并发。方便的话把 topo 图和 all_reduce busbw 贴出来,大家能帮你判断该不该拆布局。
-
,系统 取消固定了此主题