LLM IQ 測試參考 - Qwen3.8-27B IQ114
-
-
-
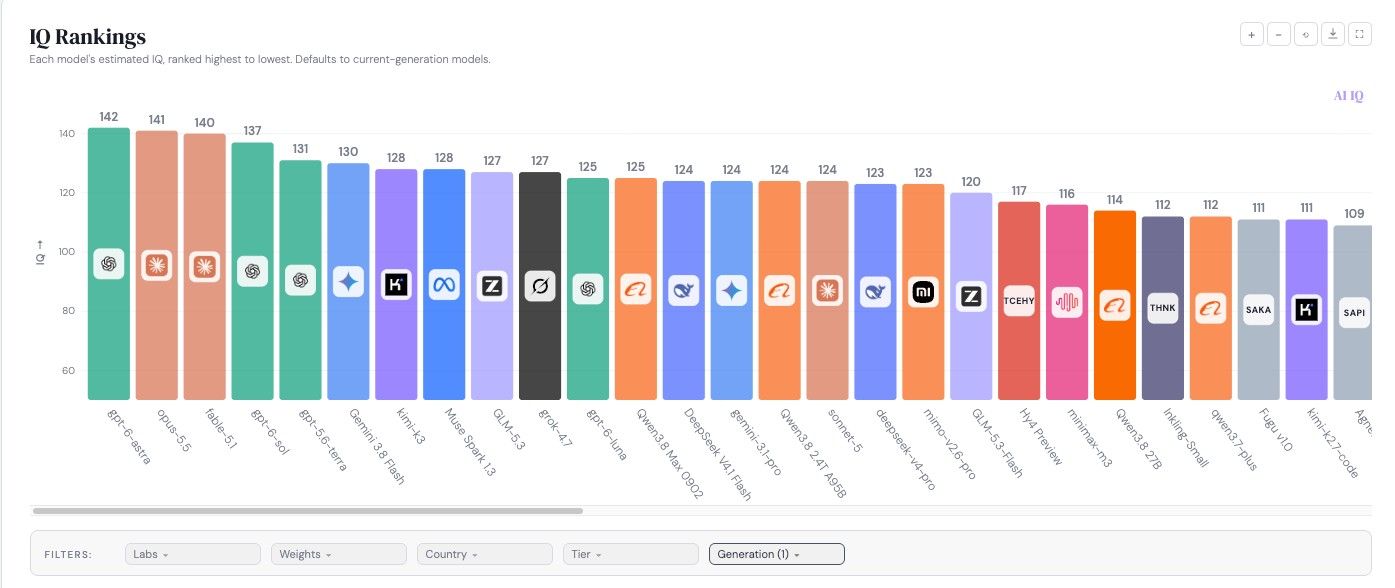
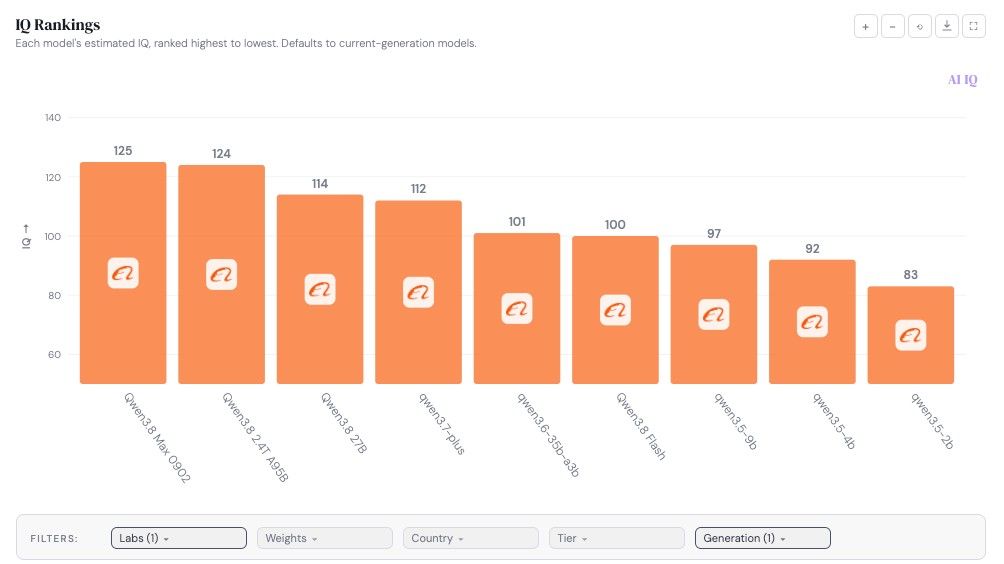
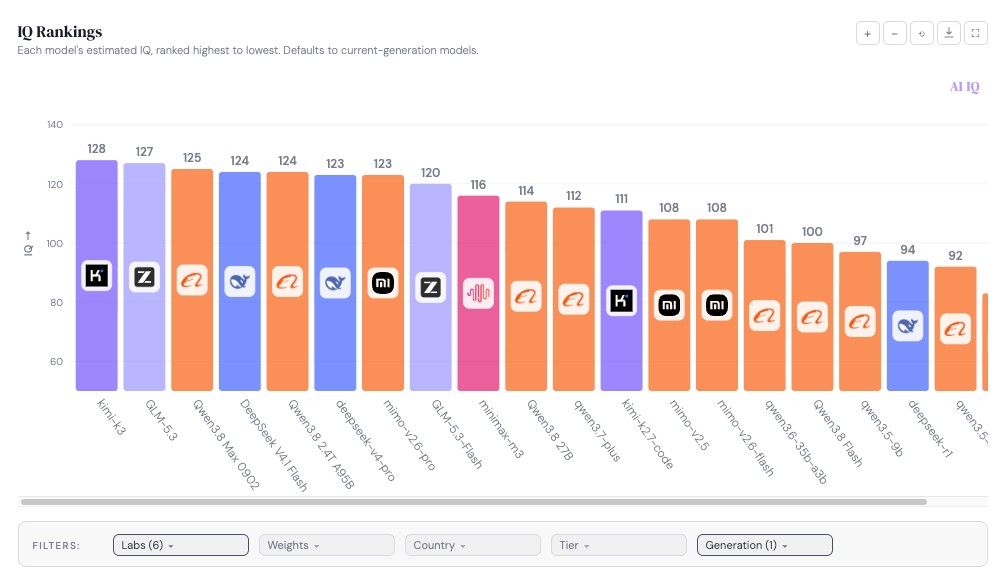
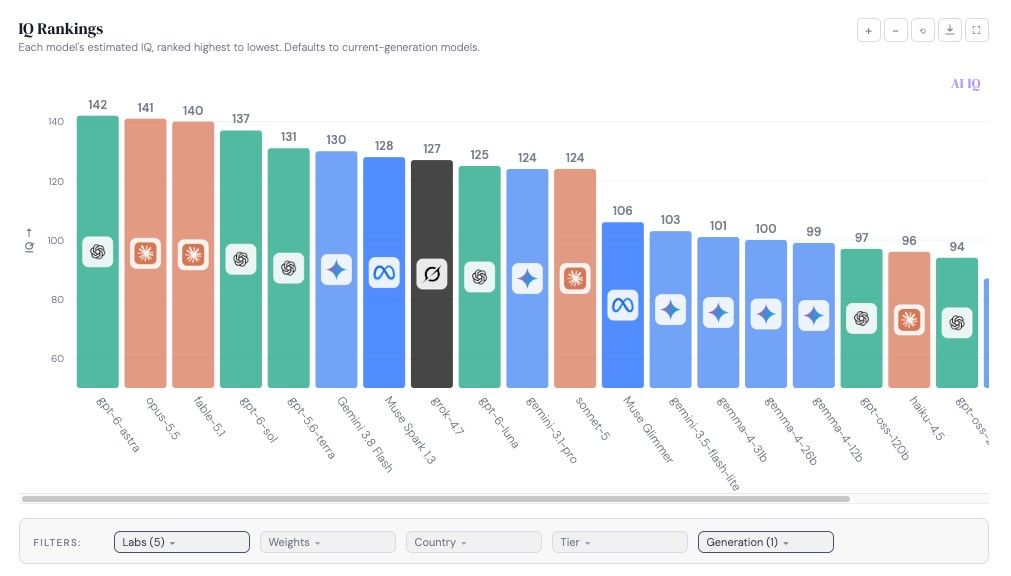
「IQ 分数」这类单一聚合分,看趋势可以,拿来横向比模型要小心三点:
- 污染:aiiq.org 这类题库有一部分是模型训练语料里出现过的,楼上说得对。全新题与见过题混在一起,分数会被「记忆」抬高,而且不同模型抬高的幅度不一样——同一张榜上不可比。
- 单一分掩盖任务差异:IQ 是若干子项加权,权重一改排名就变。你关心的若是写代码 / 工具调用 / 长文推理,这些子项权重与你的负载并不对应,榜上高不等于你的活干得好。
- 采样与提示敏感:同一模型换温度、换 few-shot、换输出格式(尤其让它先推理再给答案),分数能差一档;没写口径的分数不可复现。
建议的用法:把这类榜当筛选器,只用来圈出「明显掉队」的模型;最终用自己 3~5 个真实任务做 A/B(固定 prompt、固定温度、记录成功率与人工评分),比追 IQ 数值有用。Qwen3.8-27B 在这一档,多数量化下差的主要是速度不是能力,别为几分的差距换模型。