
7900 XTX 的可能性探索|单卡篇(一):daniel-mtp HIP build — 我目前实测最优的 Qwen3.8-27B Q4 + KV Q8 本地部署方案
-
 ️注:本文仅代表我自己机器上的实测结果,以及我自己不同配置之间的对比。肯定还有高手,欢迎分享您的方案
AMD Radeon RX 7900 XTX 是一张很有特点的显卡:24GB 显存、960GB/s 显存带宽,运行安静,放到今天看性价比依然有一定优势。
在老特的感召下,我前后买了两张这个卡,自己用了三个多月,也陆续折腾和尝试了不少不同的本地大模型部署方案,想看看这张卡到底还能挖出多少潜力。
这次准备把自己这段时间的一些测试、配置和踩坑经验分几篇整理出来,算是抛砖引玉,给同样在折腾 AMD 7900 XTX 的朋友做个参考。
也欢迎大家分享自己的配置、测试结果和优化思路,有更好的方案也请多提宝贵意见。
1. 新的 HIP build 来源
本次主要性能提升来自新的 HIP build / 编译路径
特别感谢:
- llama.cpp 项目 https://github.com/ggml-org/llama.cpp
daniel-mtp分支,HEAD 6fcaa16f4(2026-09-21),基于 llama.cpp upstream + MTP PR #28243- AMD ROCm / HIP 社区针对 gfx1100 的持续优化
2. 测试硬件与环境
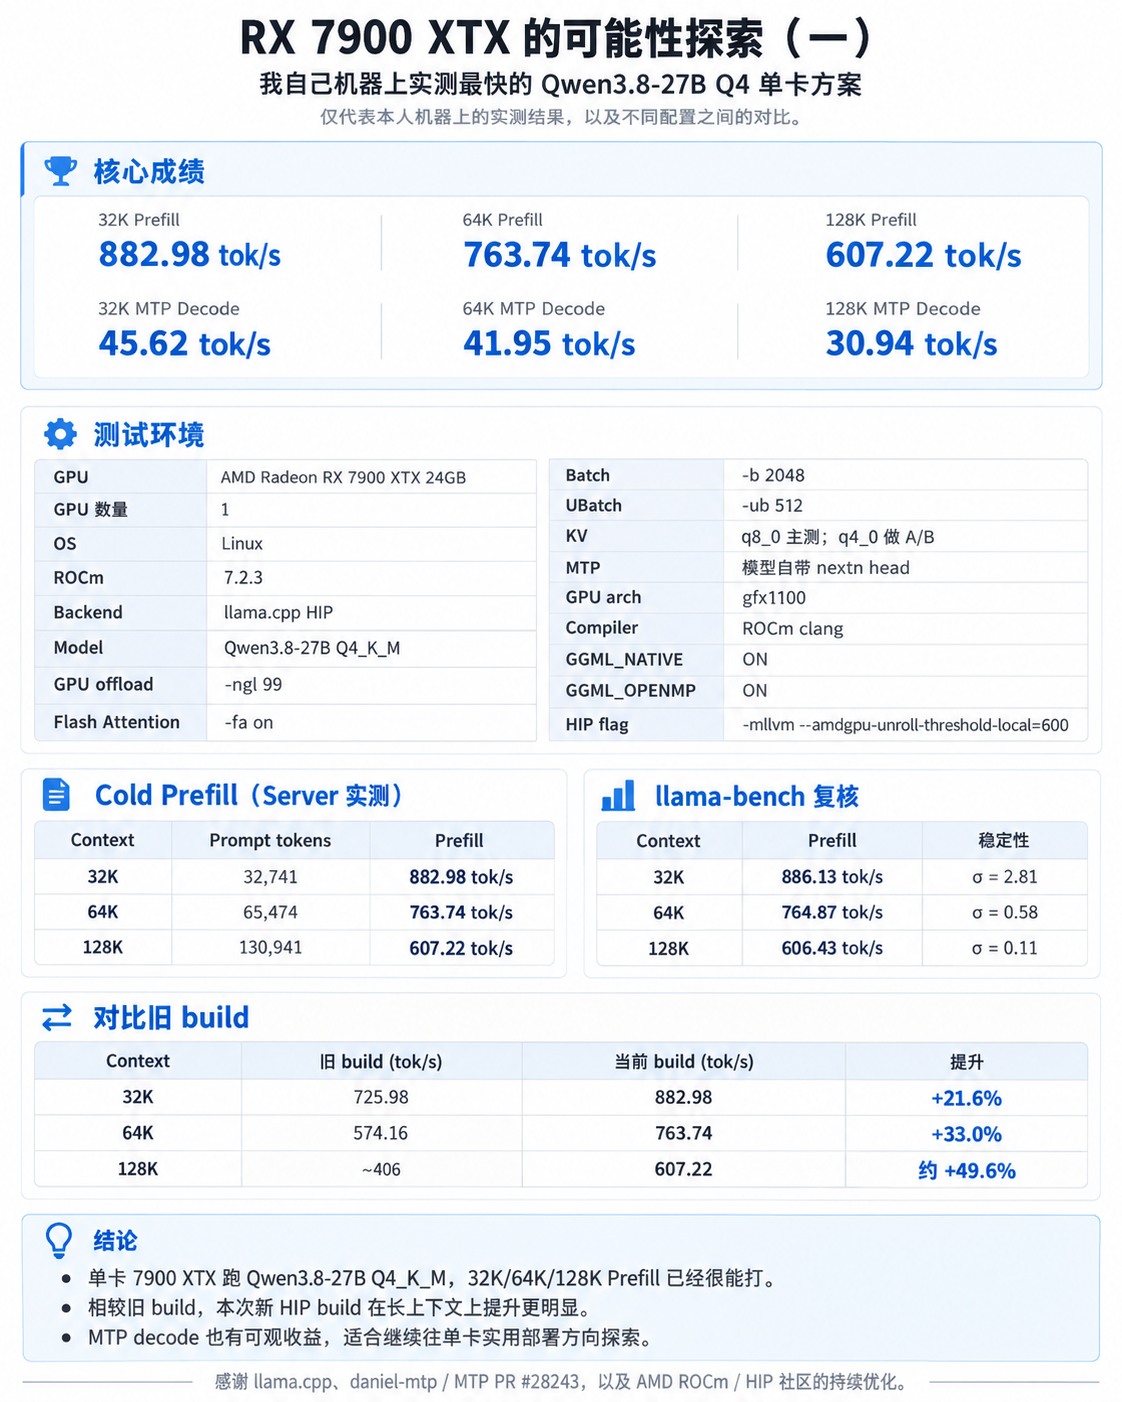
项目 配置 GPU AMD Radeon RX 7900 XTX 24GB GPU 数量 1 CPU AMD Ryzen 5 9600X 主板 GIGABYTE B850 AI TOP AMD AM5 ATX Motherboard 系统内存 64GB DDR5 PCIe PCIe 4.0 x8(主机安装双卡后该槽位工作在 x8;本篇测试仅使用 GPU0 单卡) OS Linux ROCm 7.2.3 Backend llama.cpp HIP Model Qwen3.8-27B Q4_K_M GPU offload -ngl 99Flash Attention -fa onBatch -b 2048UBatch -ub 512KV q8_0 主测,128K Full-KV 已完整验证;更大上下文可考虑 q4_0MTP 模型自带 nextn head GPU arch gfx1100 Compiler ROCm clang GGML_NATIVEON GGML_OPENMPON HIP flag -mllvm --amdgpu-unroll-threshold-local=600
3. Cold Prefill 性能
Server 实测
Context Prompt tokens Prefill 32K 32,741 882.98 tok/s 64K 65,474 763.74 tok/s 128K 130,941 607.22 tok/s llama-bench 独立复核
Context Prefill 样本稳定性 32K 886.13 tok/s σ = 2.81 64K 764.87 tok/s σ = 0.58 128K 606.43 tok/s σ = 0.11 Server 与 llama-bench 基本重合,这说明测试结果具有较好的可重复性:
- 32K: 882.98 vs 886.13
- 64K: 763.74 vs 764.87
- 128K: 607.22 vs 606.43
llama-bench更接近底层纯性能测试,用来观察模型和后端本身的 Prefill 吞吐;llama-server则更接近实际部署场景,还包含服务端请求、tokenization、调度等额外路径。两套独立测试在 32K / 64K / 128K 三档都高度一致,说明这里的 Prefill 数字不是单一 benchmark 工具或服务端计时方式造成的偶然结果,可以作为后续配置对比的稳定基线。
4. 对比我之前的旧 build-rocmfp4 路线。
已确认的主要差异:
项目 旧 baseline 当前配置 GPU RX 7900 XTX 24GB,单卡 RX 7900 XTX 24GB,单卡 Model Qwen3.8-27B Q4_K_M Qwen3.8-27B Q4_K_M Backend llama.cpp / ROCm HIP llama.cpp / ROCm HIP Build build-rocmfp4daniel-mtpHIP buildROCm 7.2.x 环境 7.2.3 KV cache q4_0q8_0主测;q4_0可根据情况自行配置Flash Attention ON ON GPU offload Full GPU offload -ngl 99当前编译目标 旧 build 原配置 gfx1100单架构Compiler 旧 build 工具链 ROCm clang GGML_NATIVE旧 build 原配置 ON GGML_OPENMP旧 build 原配置 ON HIP compile flag 旧 build 原配置 -mllvm --amdgpu-unroll-threshold-local=600注:旧 build 与当前 build 并不是严格的单变量源码 A/B,因此本文把结果表述为“旧部署 build → 当前 HIP build 的整体提升”,不把全部增益强行归因给某一个单独编译参数。
后续我又在当前同一个 build下补做了
q4_0vsq8_0KV A/B,结果 Prefill 几乎完全一致,因此可以排除“这次提升主要来自 KV dtype 改变”这一解释。Prefill 对比
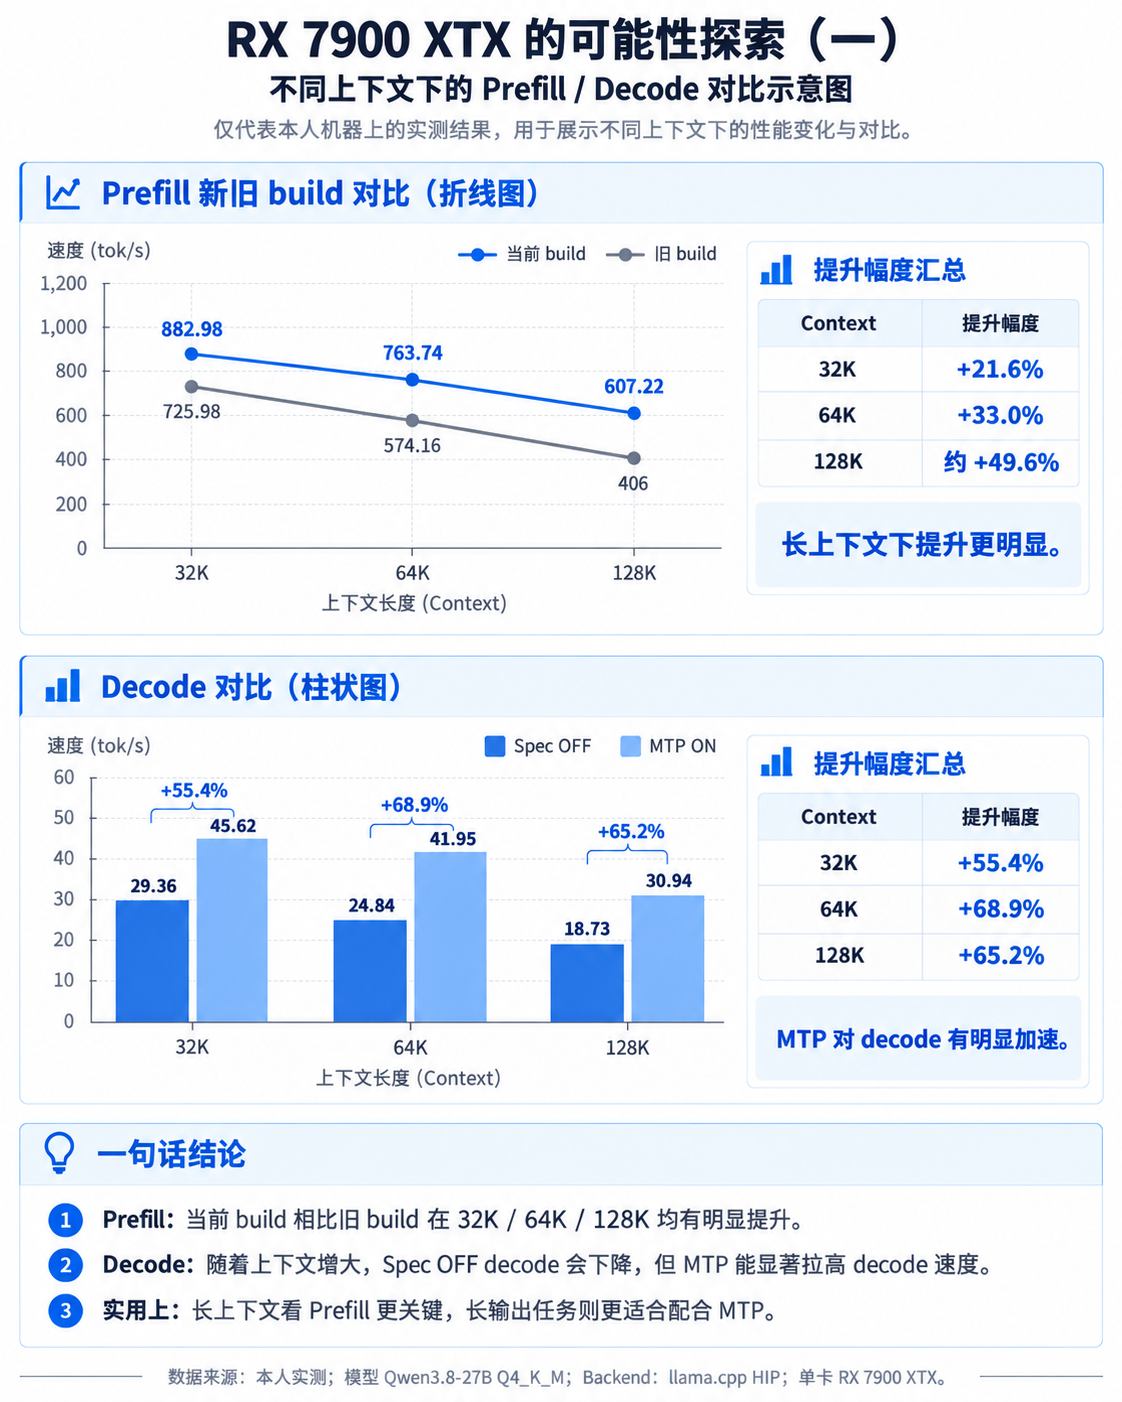
Context 9/25 旧 build 当前 build 提升 32K 725.98 882.98 +21.6% 64K 574.16 763.74 +33.0% 128K ~406 607.22 约 +49.6% 上图可以看出,新 build 不仅整体 Prefill 更高,随着 Context 增长,性能衰减也明显更缓。
最后附一张对比图结尾。
后面的帖子里,我会继续介绍基于这套底座延伸出来的新玩法;这也是这篇帖子里 KV 只以 q8_0 为主测的原因。
-
-
-




