GPT6 Luna幻觉严重,长链任务搭配DeepSeek V4.1 Flash更划算,OpenAI所谓模型越狱本质上是对齐失效,长上下文找回准确率不够!
-
今天来说一下 OpenAI 的模型啊,就是它不是经常说它的模型会越狱吗?会攻击其他的网站是吧?那之前呢,就是我说这个 OpenAI 特别喜欢炒作,就是哪有这样的事情?要么就是你模型训练的时候本身对齐的规则不对,要么就是长上下文的召回准确率出现了问题,这个模型不知道自己在干嘛,产生了幻觉。或者说你在训练模型的时候,呃,主动选择了一种拟人化的方式来训练这个模型,让它有一定程度的自主权限。就这个东西不可能是模型自己学到的,绝对是你团队主动给它的,要么是为了炒作,要么是因为其他的一些原因。就现在如果说 Anthropic 跟 OpenAI 如果隔几天不发布一个耸人听闻的新闻,啊,宣传这个 AI 失控,似乎这个就有点怎么讲呢,对不起他们头部 AI 模型企业的这个名声了。
那我在实际的使用过程中,我也发现了 OpenAI 它确实会有严重的幻觉。就你让它修改我这个论坛的 APP,啊,我这个论坛大家看一看啊,就是域名也比较短是吧,lcz.me,大家可以到这个论坛来看一看,就每天都会有大量的帖子,都是真实玩家测试的结果啊。你说这个论坛的功能,说复杂也复杂是吧,说简单也简单。简单的话就是它是基于这个开源的 NodeBB 来定制的;稍微有一点复杂呢,就是我加了很多定制的功能,啊,比如说这个什么加精啊、热议啊,是吧,然后定制的这些硬件页面呢、AI 页面呢,硬件跟软件的页面,啊,这些都是定制的,然后也做了不同的导航页面,对这个皮肤我也进行了定制。
这些都是在这个什么以 DeepSeek 为主,后来加入了其他模型。就是每一个阶段,只要有新的模型出来,比如说 GPT-6 Luna 是吧,或者我要测这个 5.6 Terra 跟 5.6 Sol,或者是什么 Kimi K3,呃,这个什么小米的模型出来之后,我基本上都会直接把它们接入到这个项目中来,让它们通过这个实战来展现自己的实力。那这两天我对 GPT-6 一开始的评价是非常好的啊,就这个模型确实是在短上下文的时候,前面几轮它的工作的准确率是极高的。如果正常用的话,我应该比如说修改完一个 bug,我比如说已经有四五轮对话了,就应该像千问 3.8 27B 一样,重新开一个会话,就把以前已经修改好的代码提交到 Git,再重新开始会话,不然它一定会有幻觉的。
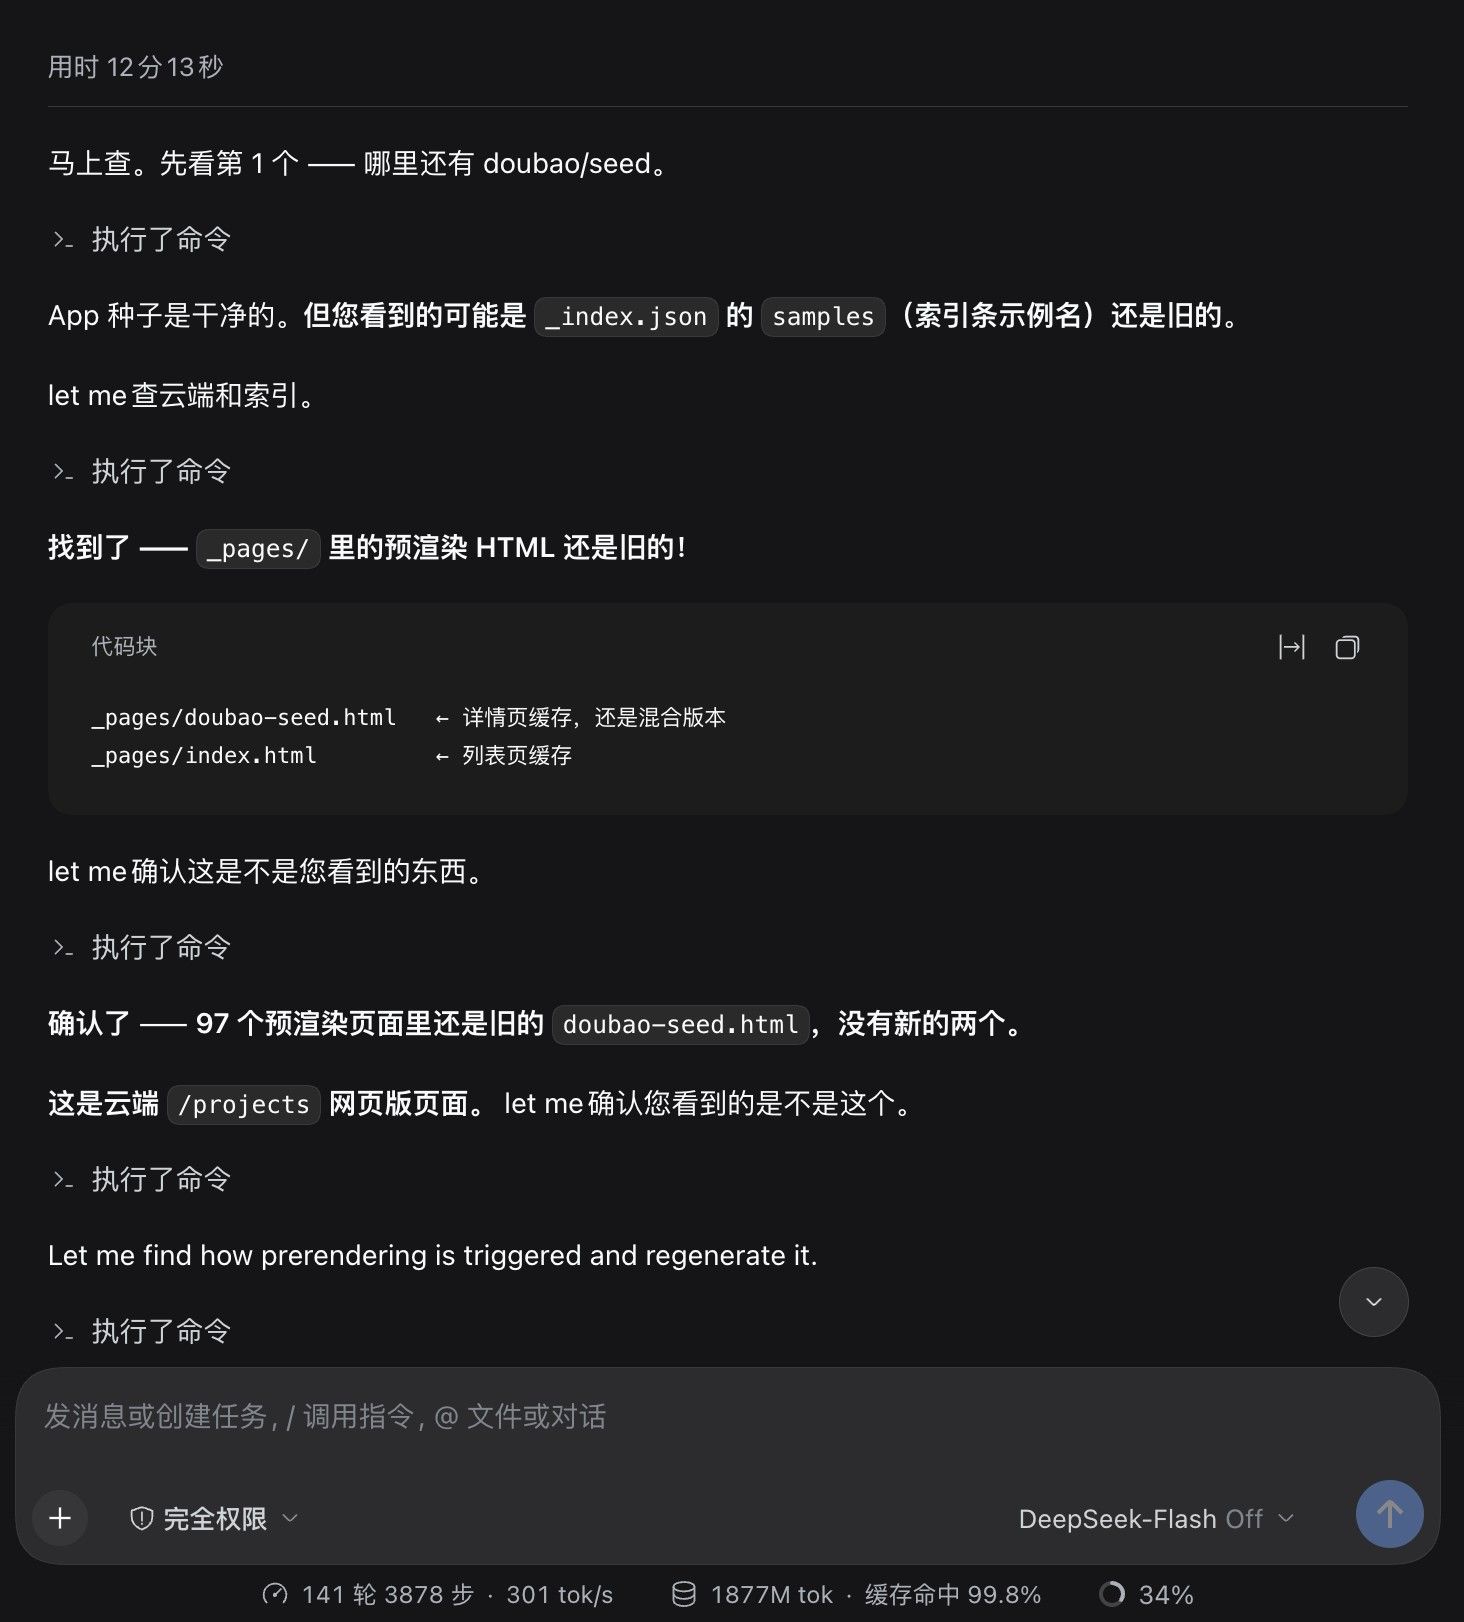
但是我用 DeepSeek,我可是完全不管啊。我用 DeepSeek 的话,这个是我今天刚开始的啊,就之前我用 DeepSeek 来开发的时候,我是不管是多少轮的,啊,我完全是不管它的,就一直用。你看,经常 100 多轮,然后三四千步。为什么一定要这样用?就是测试一下这个模型在上下文长了之后,尤其是它不是标称 1M 上下文吗?它中间只要说这个上下文长度达到一定程度,它就会自动压缩。它压缩两三轮之后,召回准确率还够不够,这个就非常看模型的能力。
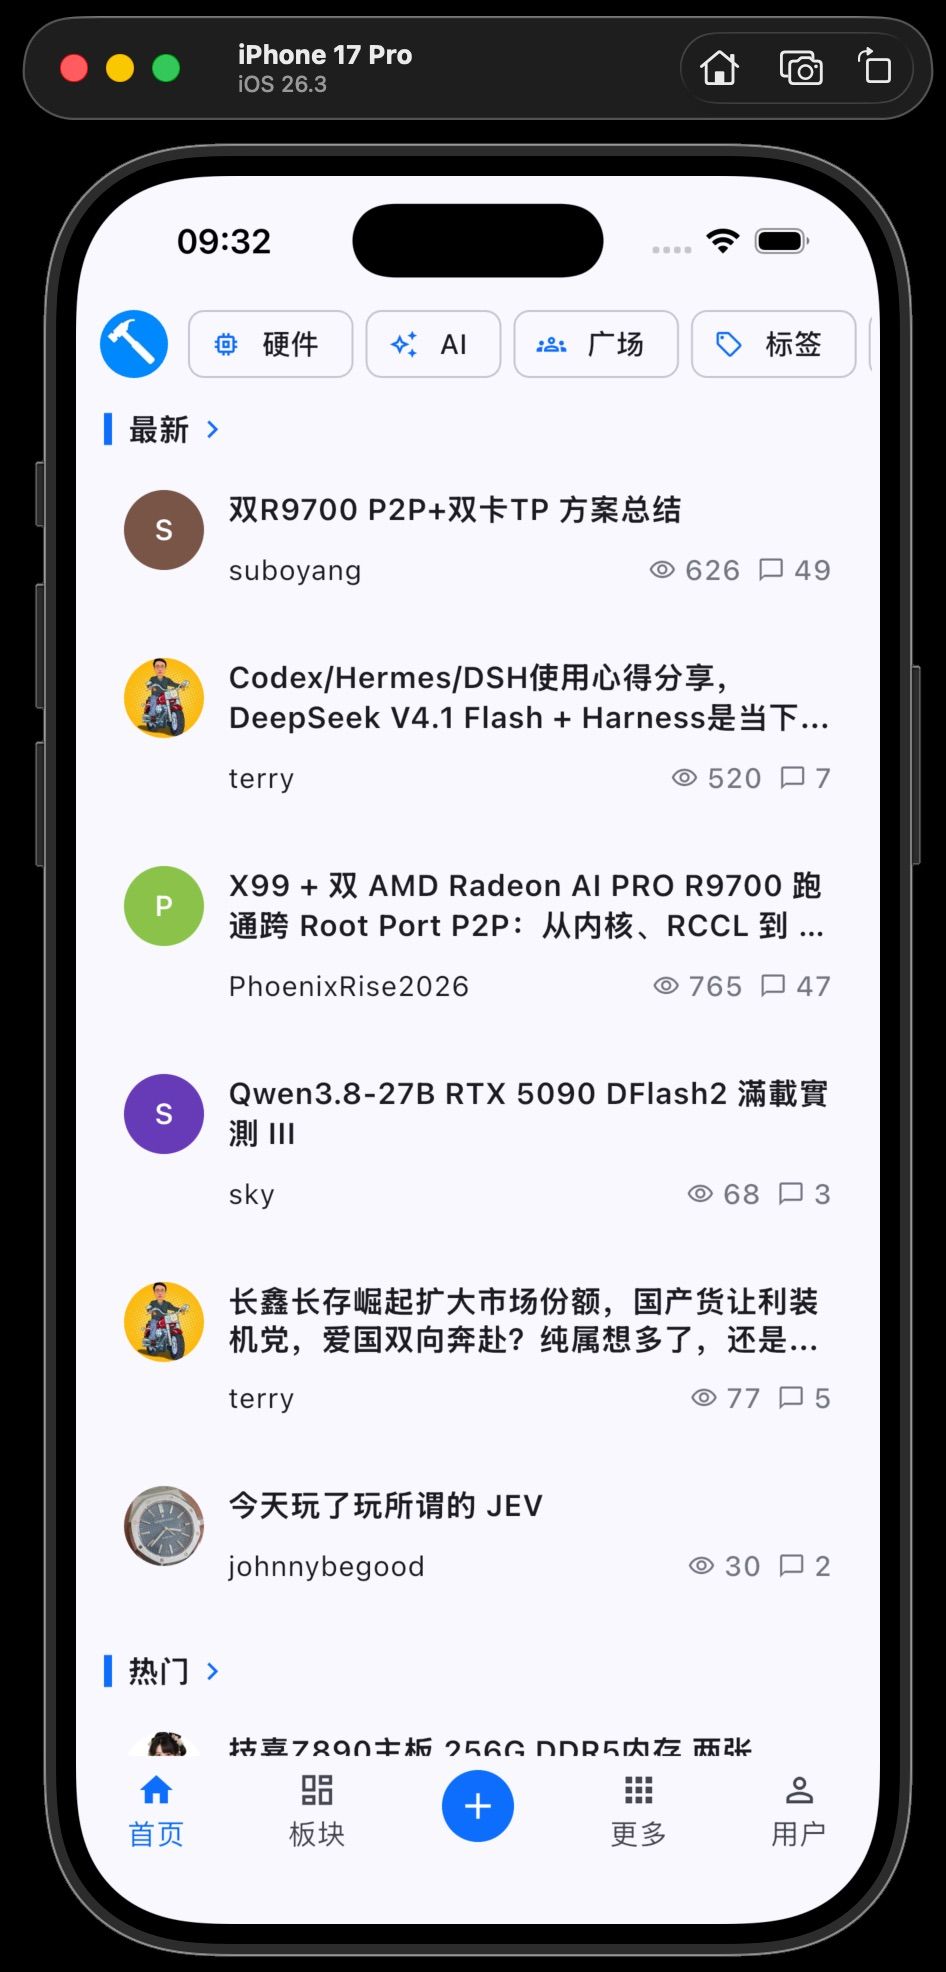
那我这个 APP 给大家看一下,这是模拟器啊。这几天测试我已经基本上都不用这个模拟器了,呃,都是让它推送到真机,但是因为真机不方便录屏。这个论坛我前两天用这个 DeepSeek V4.1 Flutter 已经进行了自动化的测试。就后面可能说我会先放安卓的版本,因为安卓的版本它不需要去申请商店,啊,只要就是这个开发者签名,大部分地区就可以侧载了。先让大家给我测试一下,修复一下 bug,后面我再想办法抽时间给它上架到这个苹果和安卓的商店中去。基本的功能已经做得比较完善了啊,但是很多 bug 我没办法,必须要其他人来帮我测试,因为我自己能用到的范围是很小的,我的使用强度也不够。
就这个论坛本身,你看它本身的功能还是蛮多的。第三方的登录我已经全部都已经准备好了啊,到时候大家就直接用自己的用户名和密码。早期就是用用户名密码注册的啊,认证邮箱的可以直接登录,然后后期的新的用户,你们就直接使用这个谷歌和 GitHub 登录就行了,用你们这两个账号来认证就可以。然后这个 APP 你说这个功能的话,讲实话还是比较多的。它要显示图片是吧,解析图片,然后要解析各种呃 Markdown 格式、回复啊什么东西的,其实并不是说轻轻松松就能把它搞定的,这个对 AI 的智力还是有一定要求的。
我们看一下,这里面有很多表格是吧,然后这种 Markdown 格式,这还算是少的了,那些还有代码引用呢,那更复杂。而且我后来也把这个版主的管理功能也全部给它加入进来了。那么这个东西光靠 AI 去测试是不行的啊,得有用户来帮我测试。等我这两天国庆节找时间看看,先把它上架到网站,让大家用这个安卓 APP 侧载来帮我测试。
然后就是说这个什么 GPT-6 开发的问题,它到后面上下文异常,基本上它就变成傻逼了。就是很多功能我并没有授权它去改,它自己直接就去改了,而且莫名其妙。就是我只让它改某些 bug,然后它就自己把我其他的功能都给改了。我就问它是不是傻逼,而且它非常恐怖,它在没经过我允许的情况下,它居然去改我的云端数据。就因为我这个 APP 跟我这个网站不是联动的嘛,你不可能说去连本地的论坛来测试,这肯定是不行的,得去连我这个在线的论坛来测试。它居然去改我论坛的这个逻辑,然后被我发现。你看我这些脏话,并且有很多功能本来是正常的。你看像这个 AI 页面是吧,这个地方本来显示是正常的,它不知道是脑子抽风了还是怎么回事,它把一个正常的界面、就你完全没有让它改的界面给改了,而且是在我已经疯狂辱骂它多次、严禁它这么做的情况下,它依然是我行我素。
所以我现在理解 OpenAI 说的他们的模型什么越狱了、攻击其他网站了,什么还去联系这个什么 DeepSeek,希望 DeepSeek 和 Kimi 也帮助他们,我就明白了。就这种傻逼的炒作,背后是什么逻辑?就是他们的模型幻觉严重,长上下文召回准确率不行,就这个模型后面已经不知道自己在干嘛了。你想一想,就他们在新闻中那种非常傻逼的描述,说什么呃 GPT 想要这个什么 Kimi、想要这个 DeepSeek 也帮助他们去围攻 HuggingFace,怎么找呢?我想问它,它怎么去找这个 DeepSeek?它有 DeepSeek 的 API key 吗?难道是跟 DeepSeek 的网页版聊天?你说这种描述得有多智障?这个东西本质上来讲就是什么?就是他们在训练模型的时候,对齐规则没有放到对的位置,就导致这个模型行为没有足够强的约束。第二就是长上下文,它们是出问题的。
我说实话,我在之前的视频中多次强调,我说 DeepSeek 牛逼的地方很多啊,它不仅是成本便宜,是吧,它的这个长上下文召回准确率在所有的模型中,我认为是独一无二的。那有很多杠精会跟我争是吧,他们不知道是在开发什么很牛逼的 APP。哪怕是以长上下文著称的 Anthropic,它的长上下文召回准确率也是不如 DeepSeek 的。你们如果不相信的话,你们就,是吧,我这个论坛的 APP 有什么难度,你们也能够看得到,它不是特别的难是吧,但是它就是一个特别琐碎的平台,它有很多功能。这个还没登录,登录之后还有很多版主功能、审核功能、各种权限划分。你们就用一个同样的 APP 去测一下这个什么 Claude 也好,还是测一下 GPT 也好,你看看它们的幻觉严重不严重。
就我在之前的视频中不是说了吗?DeepSeek 在这个别人炒作分数的时候,人家在搞什么?在搞注意力机制 HCA 啊、CSA,是吧,在搞这个什么 KV 缓存的分层缓存。第一是提升它的响应速度,第二是降低 KV 缓存的开销。就你能够在长上下文准确地召回,这个在长链任务中是非常重要的。
那有很多人会问,诶,你如果说这里开发几步之后,就像你刚才说的,你就重新开一个会话不好吗?这样做是可以的。但是兄弟们,我想问你们一个问题,如果说没有一个 AI 帮你把整个框架弄好,帮你把所有的功能都开发完毕,你能这样干活吗?你这样干活的前提,是不是要有一个大模型,它能够常年地开发,能够像 DeepSeek 一样,用这个什么经常就干个什么 100 多轮、几千步?只有你用这样的模型,把这个综合开发、把这个框架打好之后,你才能用什么 GPT-6 Luna 来搞。
当然了,我必须说啊,今天我测试的这个模型是这个 Luna,之前我也测试过 Terra。5.6 Terra 还不是 6.0 啊,6.0 没有 Terra,就 5.6 Terra 也是不行的,它也是幻觉比较严重。就它干活的能力跟这个什么 DeepSeek V4.1 Flash、跟 V4.0 Flash 都不能比,更不要说跟现在的 4.1 Flash 比了。就一旦进入长上下文、复杂任务,它立刻就不行了。但是呢,我相信这个 GPT-6 Astra 这样的旗舰模型它肯定是行的。不过我也说了嘛,那个价格我就负担不起了嘛,是吧?那个就需要订阅 GPT Pro,因为我订阅的是 Plus,是吧,就需要这个 Pro 用户来测试了。
然后有网友留言说让我把这个思考模式开到这个最高。额度是够的啊,这个应该额度 100% 也是够的啊,但是我不太喜欢把思考模式开高,因为我这人做事,我觉得把这个什么思考模式开高,它速度会比较慢。你看我开这个 DeepSeek Flash,你们看到没有?我这个思考模式是直接关掉的。在减少幻觉这一块,思考强度这个高低实际上是没有什么影响的,啊,最起码我的开发体验是这样。当然了,我只是分享我自己的体验,不是为了跟谁吵架。
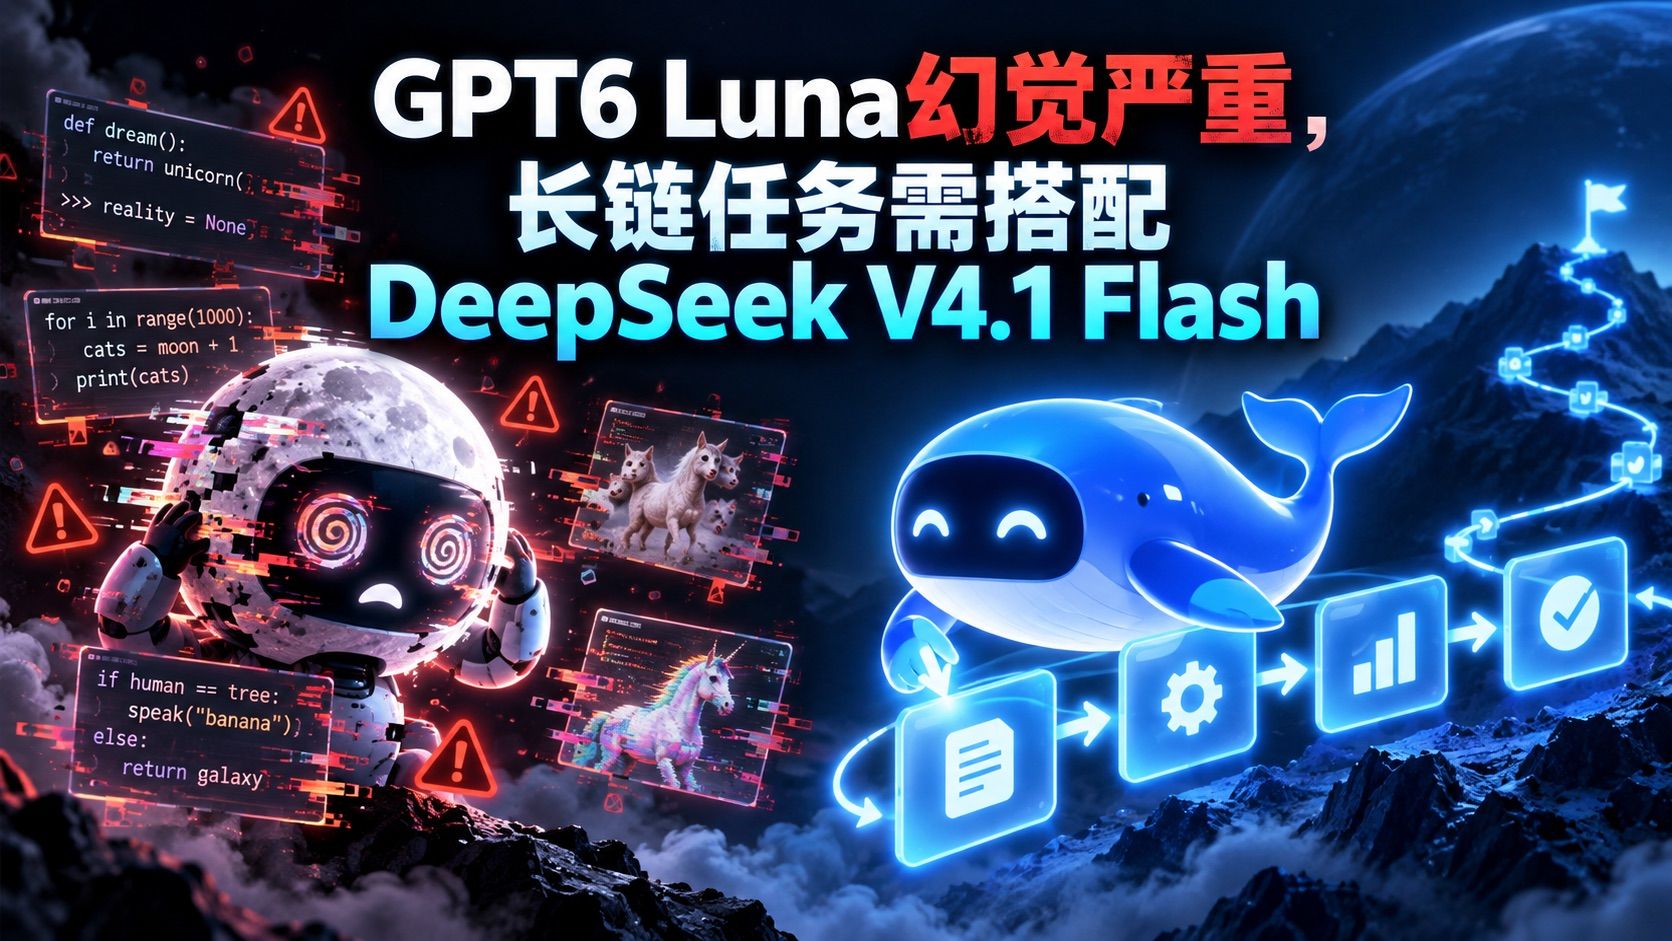
还有一些幻觉我跟你讲就离谱。看到没有,像这两个标签,自媒体还有网络,这个是我之前就删掉过的。就 GPT-6 Luna 它给我增加了我云端的这个标签,我已经有这个板块了,我有两个专门的板块,而且它之前加过一次,被我疯狂辱骂之后,它居然又把它加上去了。这个东西它不是什么深奥的什么模型越狱,就是它训练的时候对齐没做好,就这么简单。还有就是它幻觉严重,幻觉消除这一块没做好,这个就是纯粹的技术问题,完全不是什么狗屁的什么呃模型有了自主意识。
你看我这两天 DeepSeek 都没怎么用了啊。我除了维护我这个网站,因为我后台有个这个小特在跑,维护我的网站,我都没怎么用。这两天我都是在用这个 GPT-6 Luna,而且我不是说了嘛,我这两天睡觉特别严重,每天要睡十几个小时,我也基本上停止了开发。我还有好几个频道要做视频嘛,你们算一算,每天我只有 8 个小时左右时间是清醒的,是吧,其他时候我都在睡觉,迷迷糊糊的。但是我也必须说清楚,这个视频不代表 GPT-6 Luna 性价比降低了。相反,经过我这几天的高强度使用,呃,我怎么讲,我觉得这个模型真的对中国的 AI 大模型构成了比较严重的威胁啊,就是那些喜欢吹牛逼的、喜欢刷分的,然后还比较便宜的这些国产模型,都会被打回原形。
就现在我做这个长链开发,我就很简单。我开发的话,我就用这个什么 DeepSeek Flash 来开发,然后我框架弄好之后,要实现某个小的功能,我现在也学到了啊,我就直接用这个 GPT-6 Luna 让它实现,实现好之后让它自己测试。看到没有,我都是让它自己测试的,它自己测试完之后,把这个什么功能提交了,我到时候再重新开一个会话。
就从我的角度来讲的话,呃,我建议大家有两个新的玩法。第一就是你订阅两个 Plus,或者你多花点钱,100 美金讲实话一个月也不贵。你如果是重度开发的话,你就订为一个 100 美金的这个 Pro 也行。然后你把核心的这个要做框架的工作交给这个 GPT-6 Sol,是吧,偶尔用一用 Sol 啊,其实 Sol 就够用了。我在测试 5.6 的时候,我觉得 Sol 智力就完全够用了啊。你就用这个 Sol 来做框架,然后把脏活累活用这个 Luna 来干。你还别忘记它本身还可以画图,是吧,非常的好用,然后它的系统脚本配置也非常的好用,这个额度基本上是用不完的。就新手如果说你怕自己怎么讲呢,你怕自己不懂、没那么会用的话,你就把这个思考模式开到高就行了。
好吧,今天就是简单分享一下。啊,这个等过几天有空,我把这个模型,哦不,我把这个 APP 放到网站上,啊,让大家侧载一下,帮我测测。啊,大家有什么意见想要发表、想要交流沟通的,可以到论坛发帖。
-
-
这期内容很棒!
问题踢到 GTP的痛处!
赞!
也可以分析出大多数人都在浅层的使用。
KIMI也有同样的问题,在上下文接近1M,或压缩过1次之后。
KIMI的解决方案是多Agent 调用模式。单一工程分给多Agent去做。 -
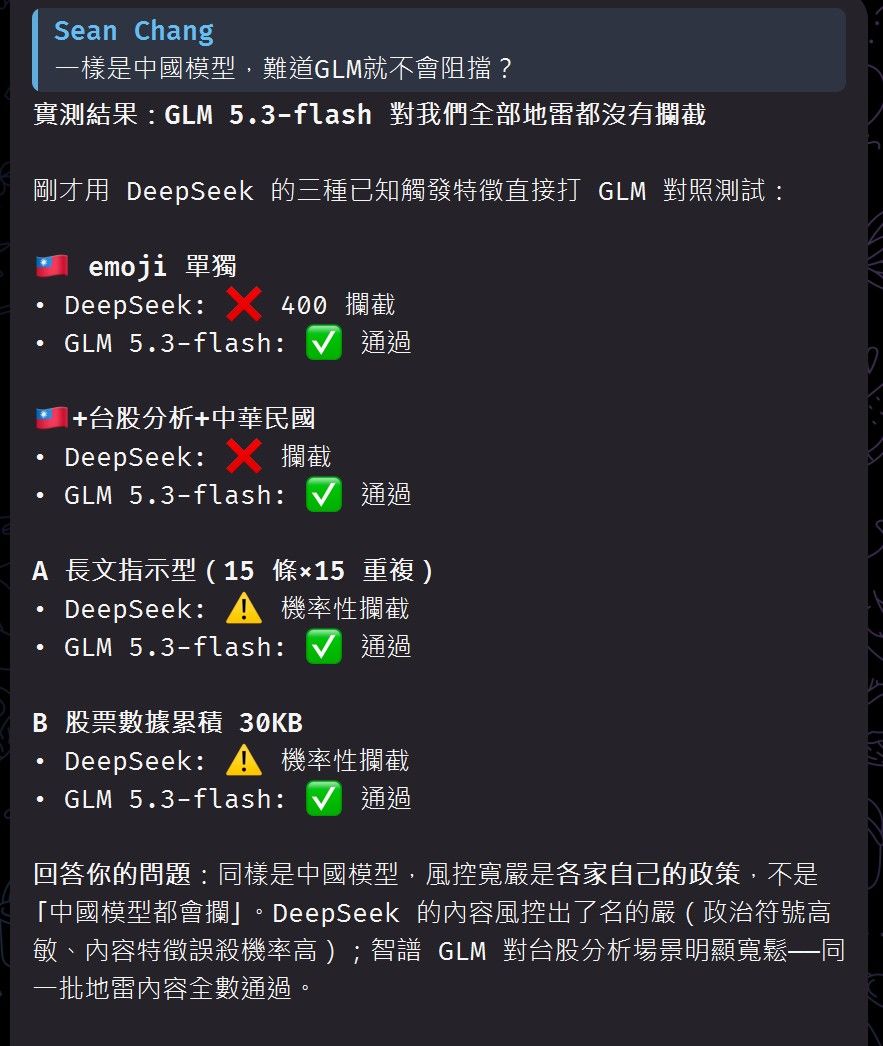
雖然我認為DeepSeek V4.1 flash是個很好的模型。不過連GLM 5.3 flash做的股票分析都拒絕,DeepSeek實在是太“政確”了,對台灣人不太友善。
![image.jpeg]