请教:公司配了台 AI 服务器(4× NVIDIA L40),感觉没用好,求框架和模型推荐。
-
公司配了台服务器用来跑 AI,配置如下:
系统:Ubuntu 24.04.2 LTS
CPU:4× Intel Xeon Gold 6448H(4 路 × 32 核 = 128 物理核 / 256 线程,最高 4.1GHz,4 个 NUMA 节点)
内存:754 GiB
显卡:4× NVIDIA L40,PCIe Gen4 x16
目前用的是 Ollama 框架,跑 Qwen3 27B 模型。这台设备配置不低,但总感觉没用好。主要用途是对话和 Agent,并发量在个位数。想请教几个问题:
1、目前用 Ollama 框架,是否有必要换成 vLLM 或其他推理框架?换的话收益大概有多大?
2、推荐用什么模型?主要场景是对话和 Agent。现在跑的 Qwen3 27B 感觉能力上还是不够,想上 DeepSeek V4.1 Flash,但看显存要求好像差得很远,是否有其他更合适的方案? -
Ollama → vLLM,值得换,收益明确
Ollama 本质是 llama.cpp 套壳,为桌面单用户设计。你的场景(服务器常驻、Agent、多并发)正好是它的短板,也正是 vLLM 的强项。另外社区反馈 Ollama 在结构化输出和工具调用上兼容性有问题,且会截断上下文(V4 被限到 131K)。对 Agent 场景这是硬伤。
换 vLLM 的收益,按你"个位数并发"的实际情况说实话:
- 吞吐:并发 3–8 时约 2–4 倍。PagedAttention + continuous batching,Ollama 基本没有真正的连续批处理
- Agent 场景收益更大:Agent 一次任务会产生大量并行子请求 + 重复的 system prompt/工具 schema,vLLM 的 prefix caching 对重复前缀能省掉大部分 prefill,实测长 prompt 场景 prefill 可快数倍
- 精度:从 GGUF Q4 升到 BF16/FP8。27B 的 Q4_K_M 相对 BF16 在推理和工具调用任务上有可感知损失,vLLM 直接跑原生 FP8,不花额外显存还更准
- 工程能力:可靠的 function calling / structured output(guided decoding)、OpenAI 兼容 API、并发隔离
诚实的边界:如果任何时候都只有 1 个人在用,单流速度差距不大(主要赢在精度和长上下文),换的收益会缩水到 20–50%;但你说场景是 Agent,Agent 天然是多请求并发的,所以这个前提不成立,换是对的。
迁移成本很低,docker 一把梭,Ollama 可以留着做快速试验:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v /data/models:/models vllm/vllm-openai:latest \
  --model /models/gpt-oss-120b --tensor-parallel-size 2 \
  --max-model-len 131072 --enable-prefix-caching
启动后就是标准 OpenAI 端点,上层接 LiteLLM → Open WebUI / Dify 的路线。
一个提醒
你这套机器 CPU/内存严重过剩、GPU 是瓶颈(128 核 + 754GB 内存对推理几乎闲置)。这也是你觉得"没用好"的根源之一。短期不必动;中期如果 Agent 负载上来,优先加的是 GPU 显存带宽/互联,而不是 CPU。
-
公司配了台服务器用来跑 AI,配置如下:
系统:Ubuntu 24.04.2 LTS
CPU:4× Intel Xeon Gold 6448H(4 路 × 32 核 = 128 物理核 / 256 线程,最高 4.1GHz,4 个 NUMA 节点)
内存:754 GiB
显卡:4× NVIDIA L40,PCIe Gen4 x16
目前用的是 Ollama 框架,跑 Qwen3 27B 模型。这台设备配置不低,但总感觉没用好。主要用途是对话和 Agent,并发量在个位数。想请教几个问题:
1、目前用 Ollama 框架,是否有必要换成 vLLM 或其他推理框架?换的话收益大概有多大?
2、推荐用什么模型?主要场景是对话和 Agent。现在跑的 Qwen3 27B 感觉能力上还是不够,想上 DeepSeek V4.1 Flash,但看显存要求好像差得很远,是否有其他更合适的方案? -
接上面 williamlouis 的框架结论(Ollama → vLLM 值得换),补一下你这台 4×L40 的具体落法和选型。
L40 的关键事实:Ada、48GB、带宽约 864 GB/s、没有 NVLink、PCIe Gen4 x16。4 张 = 192GB,容量够,但卡间 all-reduce 只能走 PCIe,TP 越大通信占比越高。所以选型按这个顺序:
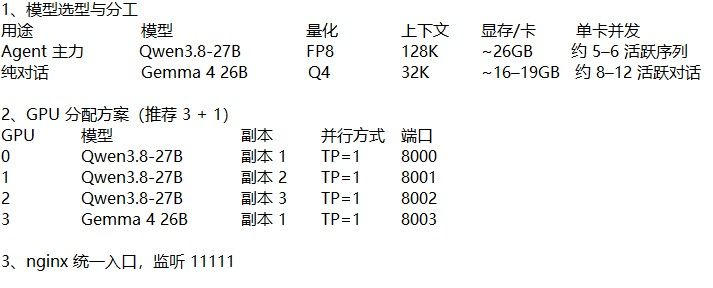
- 先看"一个模型能不能塞进 2 张卡":能塞就用 2×2 两个副本(TP=2),吞吐和延迟通常都优于 TP=4,还能直接吃并发;塞不下再上 TP=4。
- vLLM 开
--enable-prefix-caching——Agent 场景反复送同一份 system prompt / 工具 schema,这个省的是 prefill,收益最直接;权重用 FP8(Ada 原生支持)。 - 先跑
nvidia-smi topo -m确认 4 张卡的 PCIe 拓扑。如果分散在 4 个 NUMA / 不同 root complex,TP 通信会更差,优先把要组 TP 的卡插到同一 CPU 的直连槽(你 4 路 Xeon,NUMA 距离不能忽略)。
模型(对话 + Agent、个位数并发):
- 你现在 Qwen3 27B 觉得不够,优先上 Qwen3.8 的 dense 中杯(27B/32B 级)FP8/量化版,2 卡 TP=2 余量足,长上下文也能开,能力比 Qwen3 27B 明确高一档。
- 想上更大 MoE(如 235B-A22B 级):FP8 权重粗算 ~235GB,192GB 单副本放不下;4bit 量化约 120GB 可塞,但要接受量化质量损失,且 4bit MoE 的专家路由对显存带宽仍敏感,先实测再定。
- DeepSeek V4.1 Flash:按你说的显存差得远就别硬上,要么走 API,要么等更大显存平台;别为了它把量化压到影响 Agent 工具调用可靠性的程度。
- Agent 选型别只看 MMLU,重点测 function calling 正确率、结构化输出稳定性、长上下文召回;GLM-5.3、DeepSeek 系 Agent 版可以和 Qwen3.8 一起 A/B。
内存 754GB、4 路 Xeon 对推理性价比帮助有限,预算别加在 CPU 上;换框架后固定一批 prompt 测三个数——TTFT、output tok/s、并发 4 的总吞吐,再决定 TP=2×2 还是 TP=4。
-
-