
交作业:单卡RTX 5080 Qwen3.8-27B 在Windows 跑 WSL2 + NInfer v1.5 实测
-
测试时间:2026 年 9 月 29 日。平台:Windows 11、WSL2 Ubuntu 24.04、RTX 5080 16GB。
项目 本机结果  模型文件
qwen3_8_27b.ninfer,约 15.33 GiB;SHA-256 与模型仓库公布值一致 实际运行WSL2 Ubuntu 24.04 编译 NInfer v1.5;RTX 5080 可加载权重并生成中文和代码 完整功能配置98,304 上下文/KV、Q4 KV、MTP-3、视觉 2048 token、CUDA Graph、prefill chunk 1792;服务启动并完成短文本请求  ️ 模型卡推荐的 128K 全功能配置
131,072 上下文/KV + 视觉 + CUDA Graph + chunk 1792,因运行时显存预留不足,未能启动 128K 纯文本配置131,072 上下文/KV、Q4 KV、MTP-3、chunk 512,关闭视觉与 CUDA Graph;启动并完成短回答 更接近模型卡的 128K 配置131,072 上下文/KV、Q4 KV、MTP-3、CUDA Graph 保持开启;关闭视觉、chunk 64;启动并完成短回答  单次短请求
关闭 thinking 后,三类提示词的服务端解码速度为 72.8 / 122.5 / 82.4 token/s;口径见下文 98K 长输入基准同一官方 fixture 的前 96,000 token + 2,048-token 输出:prefill 1,514.63 token/s、decode 104.18 token/s;预热 1 次、正式测量 2 次  官方固定基准
模型卡报告 118,001-token 输入 + 2,048-token 输出:prefill 1,374.383 token/s、持续 decode 112.215 token/s;见第七节的口径对照 **容量边界:**98K 档已完成 96,000-token 长输入基准。128K 精简档目前只验证了 131,072-token KV 分配和短回答,尚未发送接近 128K 的实际长提示词。
一、测试平台与模型
项目 配置 CPU / 内存 Intel Core i5-12490F,6 核 12 线程;系统内存约 32 GiB 显卡 NVIDIA GeForce RTX 5080, nvidia-smi显示 16,303 MiB 显存系统 Windows 11 + WSL2 Ubuntu 24.04;WSL 内核 6.18.33.2-microsoft-standard-WSL2驱动与工具链 Windows NVIDIA 驱动 617.14;WSL CUDA 13.4;NInfer v1.5 源码 Release 构建, sm_120a模型 ninfer-5080/Qwen3.8-27B-RTX5080,文件 16,461,267,456 bytes 校验 SHA-256: c4a7e9ab593a7f42d58208fa0065d67a82d61921107686cc9f6ed1ec6b050e21NInfer 源码 v1.5 release commit: e4edd6d5c5f9f7996de0f3d9f6c311e883452580这个
.ninfer文件是 NInfer 的模型格式,测试时直接由ninfer-serve加载。模型主体采用混合 Q3/Q4/Q5 量化;模型卡写明约 3.953 BPW,并提供 128K、MTP-3、视觉的推荐配置。模型卡二、Windows 上怎样搭建
首先启用 CPU 虚拟化,安装 WSL2 和 Ubuntu 24.04。模型文件放在本地;Ubuntu、编译器和 Linux 源码副本在 WSL 的虚拟磁盘内。国内网络环境下,本次把 Ubuntu apt 源切换到清华 TUNA 镜像。CUDA 采用 WSL 中的 NVIDIA 驱动桥接,Linux 内只安装编译所需的 CUDA 13.4 开发包,没有另装 Linux 显卡驱动。
在 WSL 内确认 GPU 可见:
nvidia-smiNInfer v1.5 源码用 Ninja 构建:
cmake -S /root/ninfer-src -B /root/ninfer-src/build -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DNINFER_BUILD_APPS=ON \
  -DNINFER_BUILD_BENCHMARKS=OFF \
  -DCMAKE_CUDA_ARCHITECTURES=120a
cmake --build /root/ninfer-src/build -j --target ninfer ninfer-serve
三、短提示词成绩单
表中数据来自 98K 全功能配置。三题均为单请求、单并发、temperature 0.2、
reasoning_effort: "none",每题只测一次;计时和解码速度以 NInfer 服务端request_done为准。提示词类型 输入 token 输出 token TTFT 服务端解码 服务端总耗时 状态 中文解释推测解码 44 336 243 ms 72.8 token/s 4.86 s 完整输出 Python 按扩展名分组 45 706 149 ms 122.5 token/s 5.92 s 完整输出 20 项检查清单 53 164 185 ms 82.4 token/s 2.17 s 完整输出 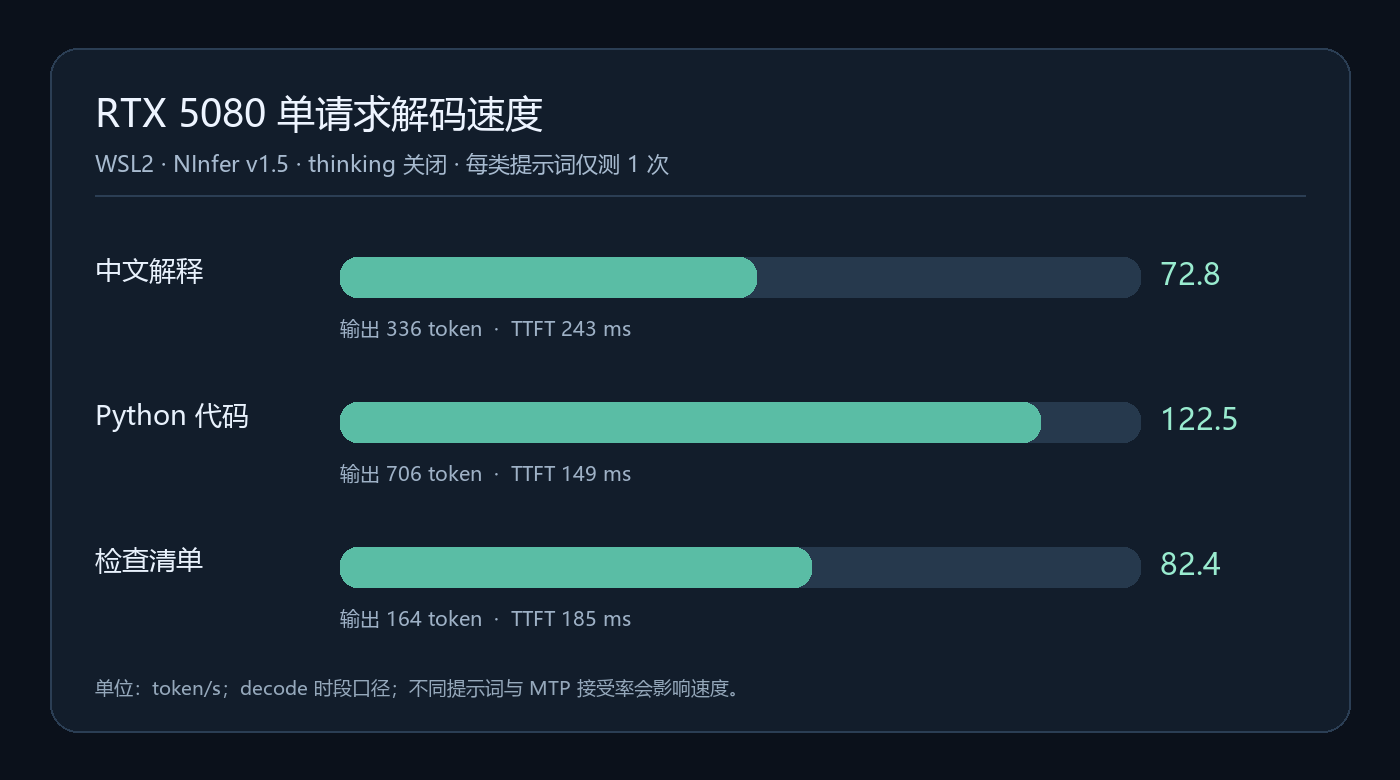
**图 1 口径:**解码速度为首 token 之后的生成 token 数除以 decode 时段;不是包含加载、预填充和网络的端到端速度,也不是模型仓库的 118,001-token 固定基准。MTP 接受率和文本可预测性会影响数值,不能把三题当作同一工作负载的重复测量。
四、98K 长输入:
pp96000+tg2048短问答不足以说明接近容量时能否正常推理,因此我又用项目的
ninfer_bench测了一次长输入。语料来自官方固定 fixtureninfer_bench_118001.ids,取其前 96,000 个 token;请求 2,049 个生成 token,其中首 token 归入 prefill,后 2,048 个计入 decode。总 token 位置为 98,049,低于 98,304 的上下文/KV 容量,留出 255-token 空间。项目 本机 98K 实测 输入 / decode token 96,000 / 2,048 预热 / 正式测量 1 / 2 次 上下文 / KV 98,304 / 98,304,Q4 group64 Prefill chunk / MTP 1792 / draft 3 CUDA Graph / embeddings 开启 / host-mapped Prefill,2 次均值 1,514.63 token/s Decode,2 次均值 104.18 token/s 每轮总耗时均值 83.07 秒 MTP 草稿接受率 72.54%;0 次 fallback 两次正式测量的 prefill 分别耗时 63.23 / 63.53 秒,decode 分别耗时 19.85 / 19.47 秒。这个结果证实 98K 档能够完成接近上限的 token 序列处理;fixture 是构造的 token 语料,不能代表长文检索或问答准确率。
五、一个实际踩坑:thinking 吃掉输出预算
服务默认开启 thinking。最初给代码题和清单题各 768 个输出 token,两次都全部用在
reasoning_content,最终message.content为空,并以输出上限结束。改为reasoning_effort: "none"后,两题分别完整输出 706 和 164 token。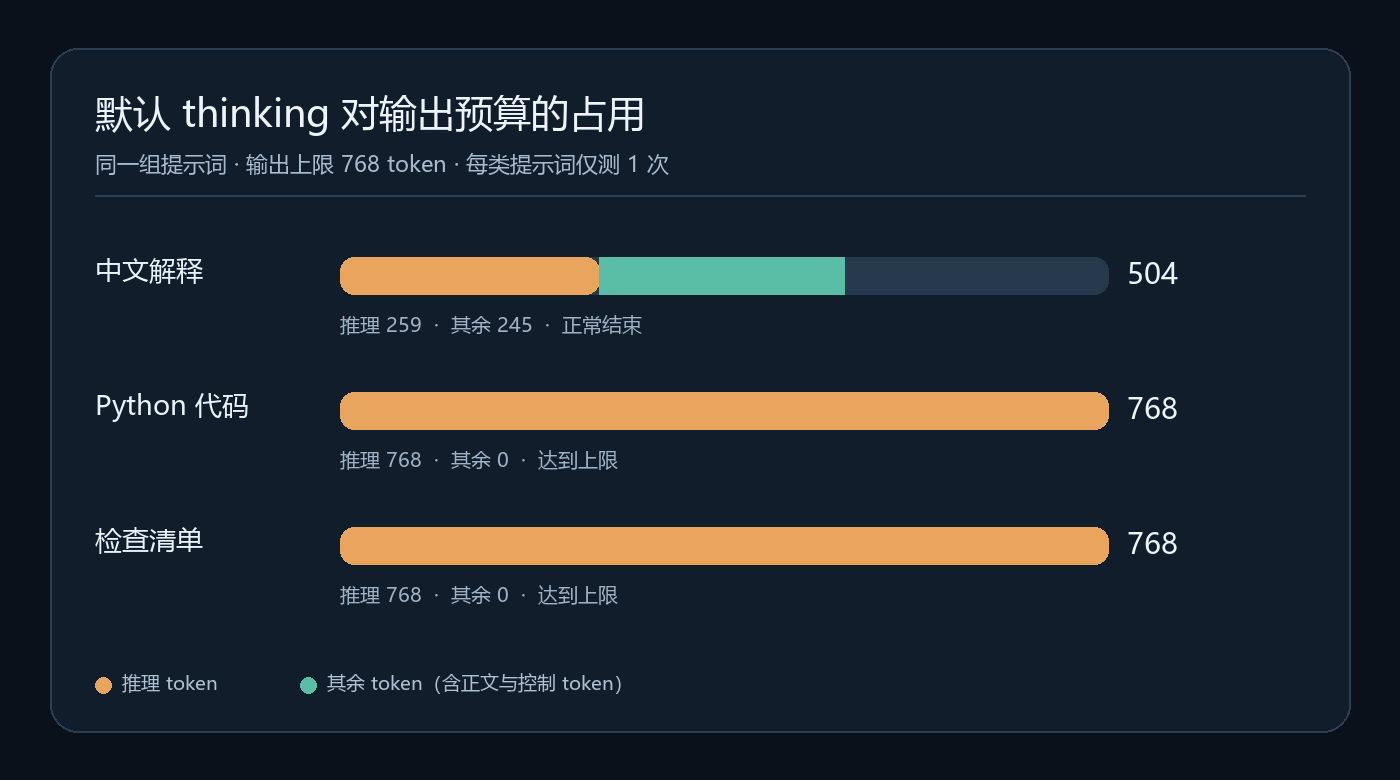
这不表示模型不能写代码,而是这组短请求的输出上限不足以容纳默认思考过程。需要展示最终答案或测普通对话速度时,明确设置 thinking 模式;需要研究推理链时,则给足输出预算并单独报告推理 token。
六、为什么 128K 会卡在显存上
模型卡推荐同时使用 131,072 上下文、131,072 Q4 KV、MTP-3、视觉 2048、CUDA Graph 和 chunk 1792。模型卡推荐配置
关闭浏览器后按模型卡参数启动,模型权重已完成加载,但引擎还需要预留 2,938,879,232 bytes,可用容量只有 2,757,591,040 bytes,短缺约 173 MiB。将 chunk 降到 256、保留视觉和 CUDA Graph,仍差约 115 MiB。可见本机瓶颈是权重加载后的运行时显存预算。
98K 全功能配置可以正常启动。关闭视觉、关闭 CUDA Graph、将 chunk 改为 512 后,128K 纯文本配置也已启动,并返回短回答
128K配置已启动。进一步保留 CUDA Graph、把 chunk 降至 64,同样完成 128K KV 分配并返回我可以回答你提出的问题。,启动日志显示空闲约 215 MiB。这个配置仍保留 Q4 KV 与 MTP-3,但 64-token 的 prefill 分块远小于模型卡推荐的 1792,且没有视觉;不能用它的启动成功来替代模型卡完整配置的验证。七、官方固定基准与本机结果怎么对照
模型仓库的 v1.5 基准记录给出了固定 fixture
pp118001+tg2048:118,001-token 输入、2,048-token 生成,预热 1 次、测量重复 2 次。基准采用 131,072 上下文/KV、Q4 KV、chunk 1792、MTP-3、CUDA Graph、host-mapped embeddings;报告 prefill 1,374.383 token/s,持续 decode 112.215 token/s。模型卡另有视觉 2048-token 的服务配置;这两个ninfer_bench结果测量的都是文本路径。对照项 项目官方 v1.5 基准 本机 WSL2 测试 GPU / 模型文件 单卡 RTX 5080 16GB;同一 .ninfer文件单卡 RTX 5080 16GB;SHA-256 与官方文件一致 实际基准配置 128K 上下文/KV;chunk 1792;Q4、MTP-3、CUDA Graph、host-mapped embeddings 98K 上下文/KV;chunk 1792;其余同左 工作负载 固定 118,001-token 输入 + 2,048-token 输出 同一 fixture 前 96,000 token + 2,048-token 输出 工具 / 重复次数 ninfer_bench;预热 1 次、测量 2 次相同工具与次数 Prefill 1,374.383 token/s 1,514.63 token/s,2 次均值 Decode 112.215 token/s 104.18 token/s,2 次均值 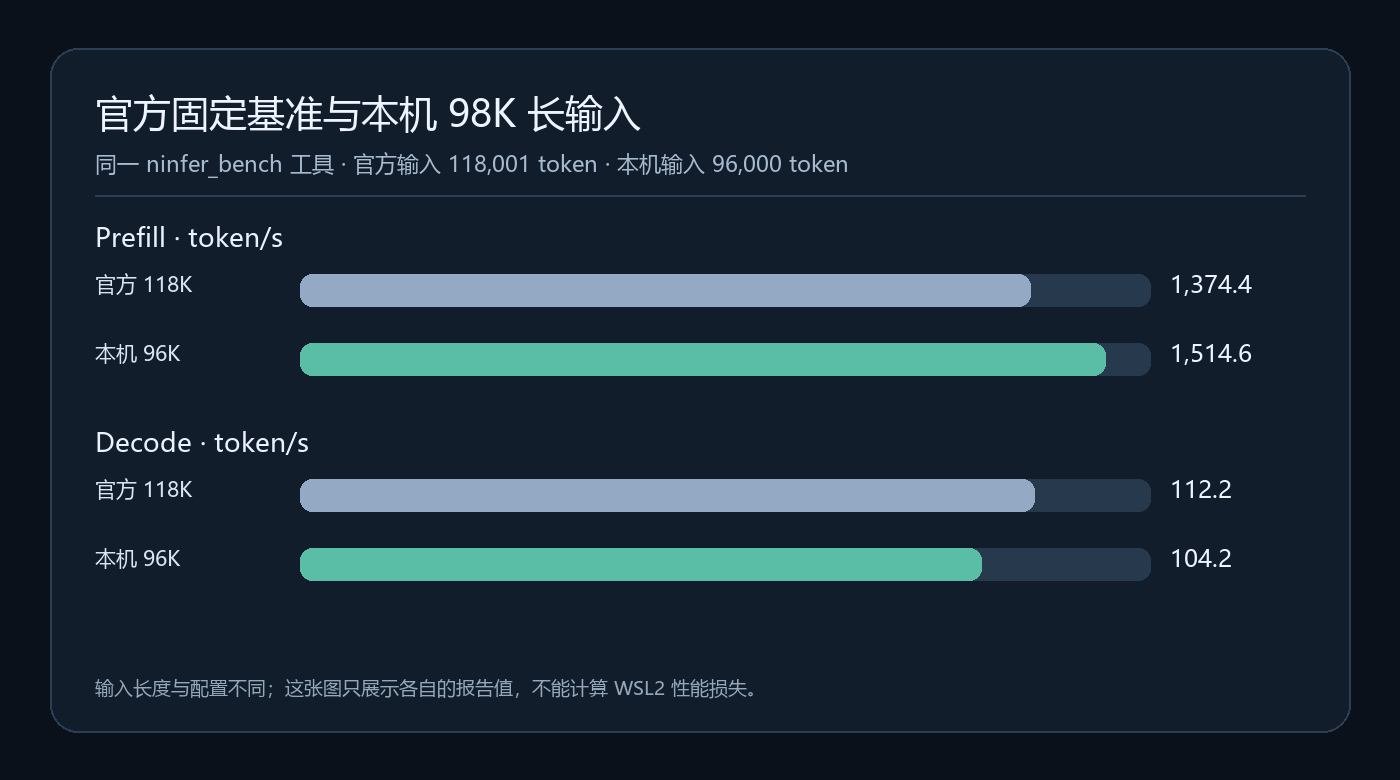
这次对照使用同一基准工具、同一语料的前缀、相同输出长度和重复次数,比短问答更接近官方口径。输入长度仍不同:官方是 118,001,本机是 96,000;128K 与 98K 的 KV 配置、GPU 空闲显存和驱动环境也不完全相同。因此,图 3 只能展示各自配置下的报告值,不能据此计算 WSL2 的性能损失。若要严格同条件对照,需在本机以相同 118,001-token 输入运行完整 128K 配置;目前的显存预算尚不允许那套配置启动。
八、结论与复现边界
这台 Windows 主机通过 WSL2 成功运行了 Qwen3.8-27B 的 .ninfer 文件。98K 档完成了 96,000-token 输入 + 2,048-token 输出的长序列性能测试,已具备个人日常写作、代码辅助和资料整理的生产力使用价值,重要输出仍需人工复核。128K KV 分配在纯文本、较小分块配置下可启动并完成短回答。后续应在原生 Ubuntu 系统下,尽量按照模型卡推荐配置,实测 128K 长上下文的速度与稳定性。当前长序列基准证明了本机 98K 档的容量和速度,尚不能说明长文问答准确率,也不能据此估算 WSL2 相对原生 Ubuntu 的性能损失。
