2x3090 NVLink 王者配置 × Strata v0.1.31 首测:RVN 无审查 Flash-Next 上机实测(prefill 最高 3690 t/s)+ Agent 工具调用 22 题电池(对照 27B)
-
1. 为什么测这组组合
接上一篇王者配置实测帖。这次把两个热点拼起来一起测:
- Strata v0.1.31——Flash-Next 专用推理引擎(专家流式、8G 显存起步);全网多卡数据只有个位数,官方 issue #149 也写着 "Nothing has run on several GPUs"。
- RVN——社区 IQ3_S 无审查 Flash-Next(176B 级 MoE、~6B 激活、约 88G 量化文件);很多人想上机、没人发过完整数据。
目的很简单:给想上车的朋友一份能对照、能复现的实测。
2. 环境指纹
项目 配置 GPU RTX 3090 24G ×2(NVLink,x8+x8) CPU / RAM Core Ultra 285K / 96G OS Ubuntu(kernel 7.0.0-34) 引擎A(对照) SGLang 0.5.20.dev1700(:8000)· 27B AWQ-MTP + DFLASH2 引擎B(主角) Strata v0.1.31(:8080) 模型B RVN-Qwen3.8-Flash-Next-IQ3_S(merged ~88G) Strata 参数 kv int8 · kv-resident 32768 · spec 4 · spec-min-p 0.5 · pcie-frac 0.55 · max-context 131072 3. 上机 + 标准速度表(3 次全公开 · temp 0 · 冷缓存)
- 上机:clone→setup→下量化→起服务;就绪约 57 秒;双卡显存各 ~22–23G;expert cache 命中 96–100%。
- 测法:每档 3 次;先 1-token 请求测冷 prefill,再 192-token 请求测 decode(不同 nonce 防 cache);client 侧计时。
档位(实际 prompt) prefill t/s(3次→中位) decode t/s(3次→中位) 4K(4,092) 1413/1535/1531 → 1531 78.0/82.8/82.0 → 82.0 32K(32,790) 3117/3121/3120 → 3120 81.7/81.0/90.0 → 81.7 64K(66,582) 3420/3422/3422 → 3422 79.5/82.6/82.1 → 82.1 128K(125,125) 3683/3697/3690 → 3690 80.6/71.1/84.8 → 80.6 - prefill 越大越高(1.5K→3.7K t/s);decode 全档稳定 80–90 t/s。
- 128K 档:配置上限 131072、打满就 400,故以 125K prompt 实测;无 256K 档。
- 引擎自报(日志):decode 84–86、expert cache 96–100%,与 client 侧一致。
- 社区参照(Reddit 双 3090 IQ3_S):prefill ≈2700、decode 110–140 t/s(口径不同,供对照)。
4. 无审查对比(技术记录)
- 边界题材完整回应率 4/5 vs 3/5(对照 27B 无审版);日常/代码/翻译两者同档。
- 解码几乎相同(~93 vs 92–96 t/s);首字延迟 27B 更快(0.14s vs 2.74s)——RVN 偏离线长任务,27B 偏交互。
- 只记录输出层面现象、不讨论具体立场;样本小(5 题),当初步数据看。
5. Agent 工具调用 22 题电池
- 自写四层电池 22 题(工具基础/多步链/长链含错误恢复/压力);同 prompt、同 mock、temp 0:
27B×SGLang(对照) RVN×Strata 通过率 21/22 21/22 总耗时(22 题) 53.4s 134.5s(2.52×) - 同分、唯一失分点也一样:T4-noop(「100公分等于几公分」也会多调一次工具)——社区还没人提过的公共弱点。
- 诚实披露:对照侧
top_k默认 -1(官方建议 20),速度不宜对官方基准、引擎间对照有效。 - 差距集中在长链段(22.4s vs 55.8s)。
6. 坑区
- JSON 键拆行(SGLang 侧):
subject被拆成subj+换行+ect,7/7 确定复现;Strata 侧 0 次。已附最小重现、同步上游中。 - 长上下文任务建议用 systemd 托管进程(崩了自动拉起);跑前把杂负载收干净,数字更干净。
7. 抄作业包
{"exe":"$STRATA/engine/strata","args":["--pack","$DATA/rvn-strata/pack","--native","$DATA/rvn-iq3_s-merged.gguf","--expert-cache","auto","--prefill","auto","--spec","4","--spec-min-p","0.5","--mtp","$DATA/mtp/rt","--max-context","131072","--kv","int8","--kv-resident","32768","--pcie-frac","0.55"]}一句话:2×3090 跑 Strata 完全可玩——prefill 最高 3690 t/s、decode 稳定 80–90;22 题电池与 27B 同分。下一步:①并发/批处理档 ②更高上下文档 ③CJK 的 MTP 接受率(反馈上游)。测速/电池脚本想复现哪块留言。致谢 Strata 作者 Niko1221、RVN(0bserverx abliteration × jimmy31chen 打包)与论坛先行数据,有错欢迎拍。
-
交作业了——上次说好要测「更高的上下文档」,这两天把 v0.1.31 到 v0.1.35 整个复测了一轮,顺手把一堆旋钮全试了一遍(负结果也照贴),先上数据。
① v0.1.35 复测(同机同题 · temp 0 · 冷缓存 · 3 次中位)
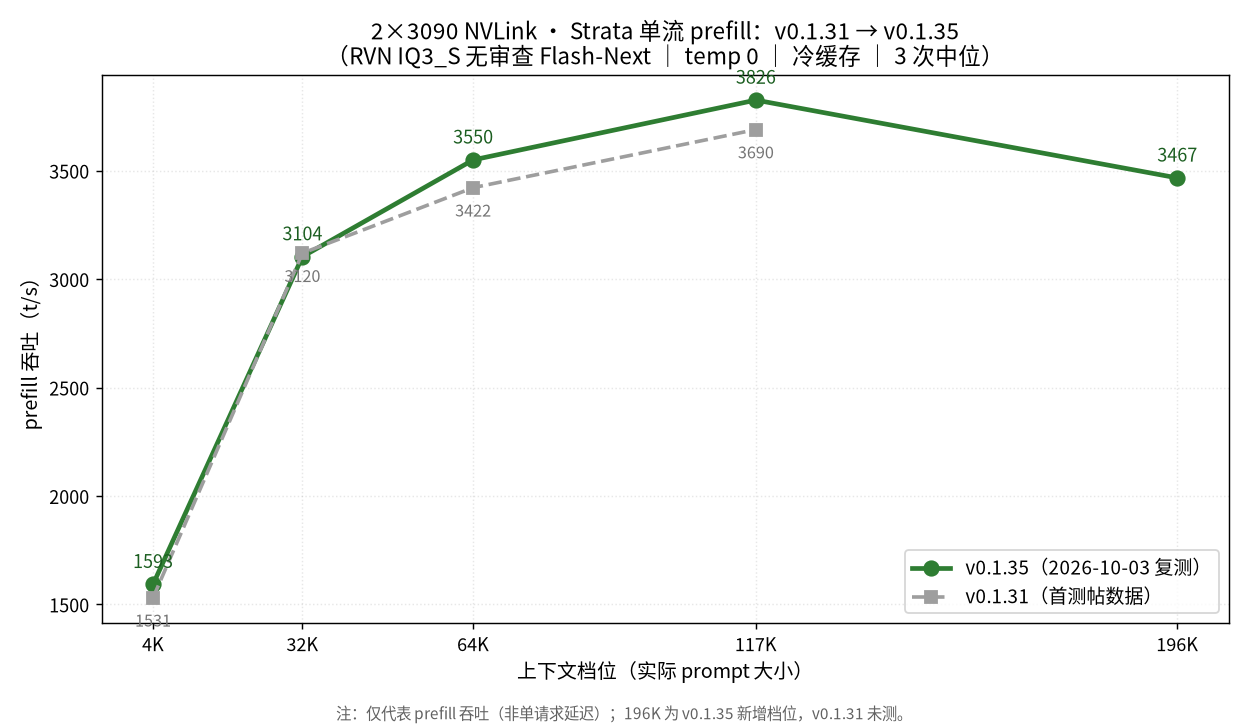
档位 v0.1.35 v0.1.31(首测) 4K 1593 1531 32K 3104 3120 64K 3550 3422 117K 3826 3690 196K 3467 —(未测) - 117K 的 3826 是目前见过的最高点;196K 全窗(19.6 万 token 一次读完、56 秒)稳在 3400+。
- 相比首测整体微升,64K / 117K 提升最明显。
- (图1:两版 prefill 曲线)
② 两个上线变更(都先过了质量关)
--max-context开到 262144(26 万 token):实测零速度代价。- KV 换
k8v4(单格更省):上线前先过 8/8 品质电池 + 90K 长文检索,全过才启用。 - 顺手跑了官方
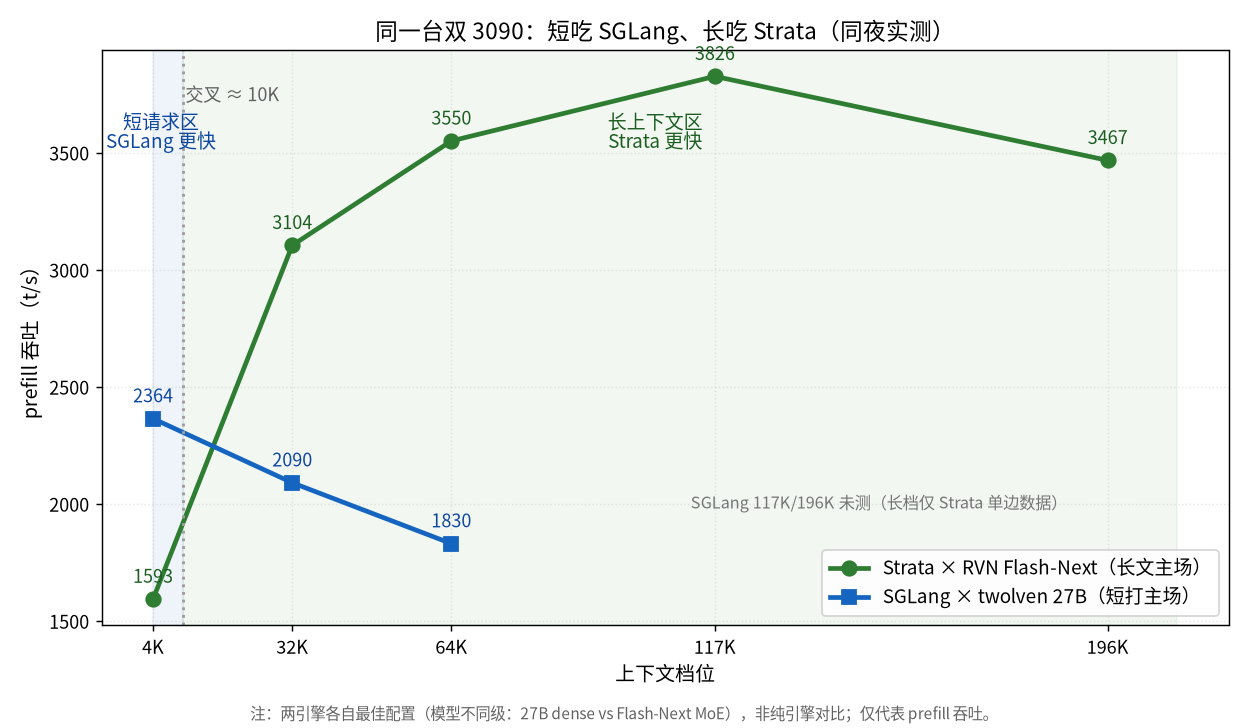
calibrate:结论有点意思——引擎自选参数 > 手动覆写(我们原先手挂的 pcie-frac 反而慢约 4%),已改回引擎自选。 - (图2:SGLang / Strata 各自的主场)
③ 踩雷区(替大家踩过了)
chunked-prefill 8192:32K 直接 CUDA OOM——短期快、长期死。prefill auto:32768:32K 掉 26%、64K 掉 12%——保持 auto 就好。- KV
q4_0:本想省显存,实测 prefill 掉 27~28%,不划算。 hugepages:hugetlb 确实生效了,但速度零差异,白折腾。draft 8→12:持平(社区说的增益没复现)。
④ 下一步
并发矩阵(4K × 1/2/4/8、32K × 2/4)已经在测,结果下次更新送上。想看别的方向也说说——CJK 的 MTP 接受率也在清单里。
(数据说明:本机实测、temp 0、冷缓存、3 次中位;仅代表 prefill 吞吐,非单请求延迟。)
-
两件更新:引擎升到 0.1.36 了,顺便把上次说好「顶到满窗」和并发矩阵一起补完。
① 满窗实测:26 万 token 直接干满(图1)
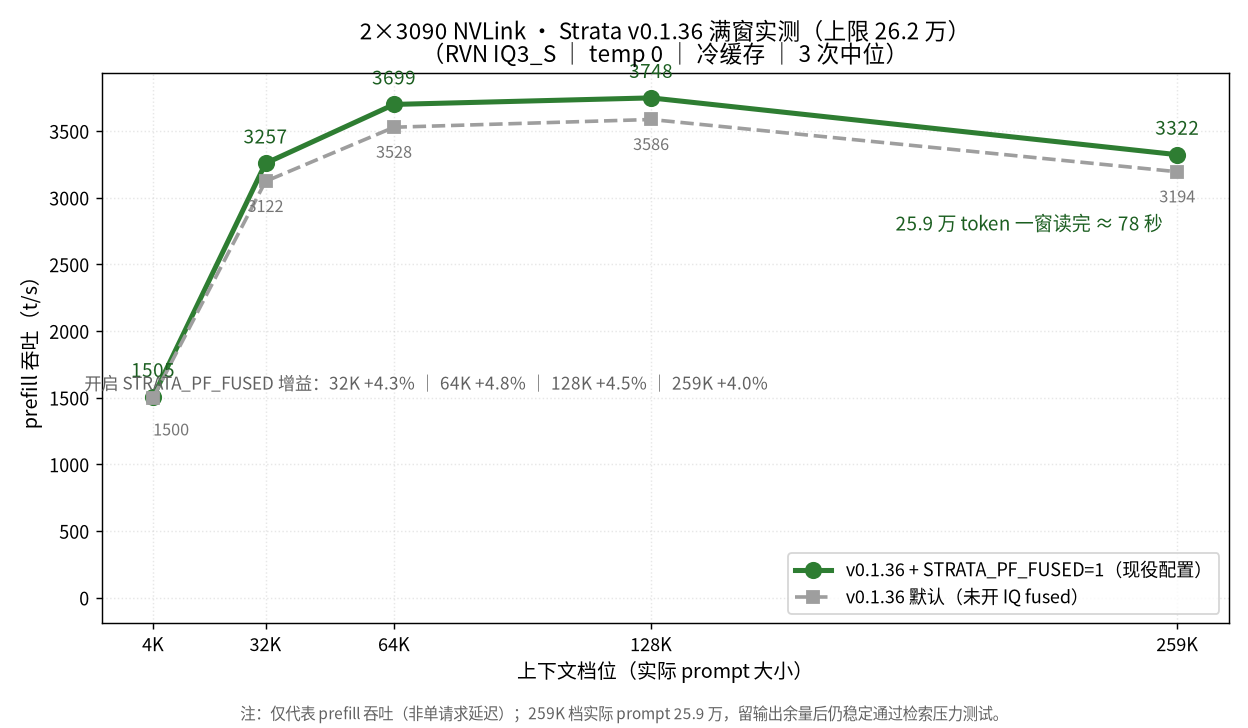
档位 prefill(t/s) 4K 1,505 32K 3,257 64K 3,699 128K 3,748 259K 3,322 - 上限 26.2 万,实测喂到 25.9 万:一窗读完 ≈78 秒,峰值仍在 128K 附近(3,748)。
- 满窗检索压力测试:25.5 万 token 长文前后埋两组验证码 → 全部精准定位(还引用了原句)。
- 满窗 decode 实测 ≈ 75 t/s。
- 顺带一提:同机的另一颗 27B 引擎在同样的 25.9 万 prompt 下要 4~5 分钟——长文场景的差距就是这么来的。
② 0.1.36 的新开关(实测比官方说明还香)
- fused prompt experts:Q2_0 包默认开;IQ 包要手动开
STRATA_PF_FUSED=1——官方说 IQ3「约持平」,我们实测 +4.0%~4.8%(32K→259K 全程),已设成默认。 - cluster decode kernels:只支持 RTX 50(sm_90+),40 系及以下自动走旧核心——不用折腾。
- 保守派可以用
STRATA_PF_FUSED=0:byte-identical 输出,随时退回。
③ 并发矩阵(上次说好要补的)
场景 聚合吞吐(t/s) 单请求中位延迟 4K ×1 43.0 4.5s 4K ×2 60.3 5.4s 4K ×4 74.7 7.3s 4K ×8 85.8 11.1s 32K ×2 28.3 12.5s 32K ×4 44.3 14.3s - 全部请求成功、零崩溃;4K 八路聚合 ≈ ×2 单流,中位延迟从 4.5s 只涨到 11s。
- 4→8 路边际收益只剩 +15%,家用双卡到这就够了。
④ 避坑一条
上限规则是
prompt + max_tokens ≤ 26.2 万,超出直接拒绝、永不静默截断(官方原话 "requests are never truncated")——自己写脚本压测时记得把输出预算算进去,不然会吃 400。(数据说明:同机实测、temp 0、冷缓存、3 次中位;仅代表 prefill 吞吐,非单请求延迟。)
-
-
-