[實測IV] Strata / Qwen3.8 Flash IQ2_XS 單卡跑到 424K 155t/s — parking 能留幾條對話:含三個不利發現
-
這篇是 2026-10-01/02 我跑完整個 campaign 的記錄,承接前三篇 1228、1462、1967。
問題一開始很簡單:兩張空閒的卡有沒有用。跑著跑著變成另一件事——單卡把 context 從 256K 推到 1M 時,KV pool、parking 和能同時保留的對話數量會撞到哪裡。
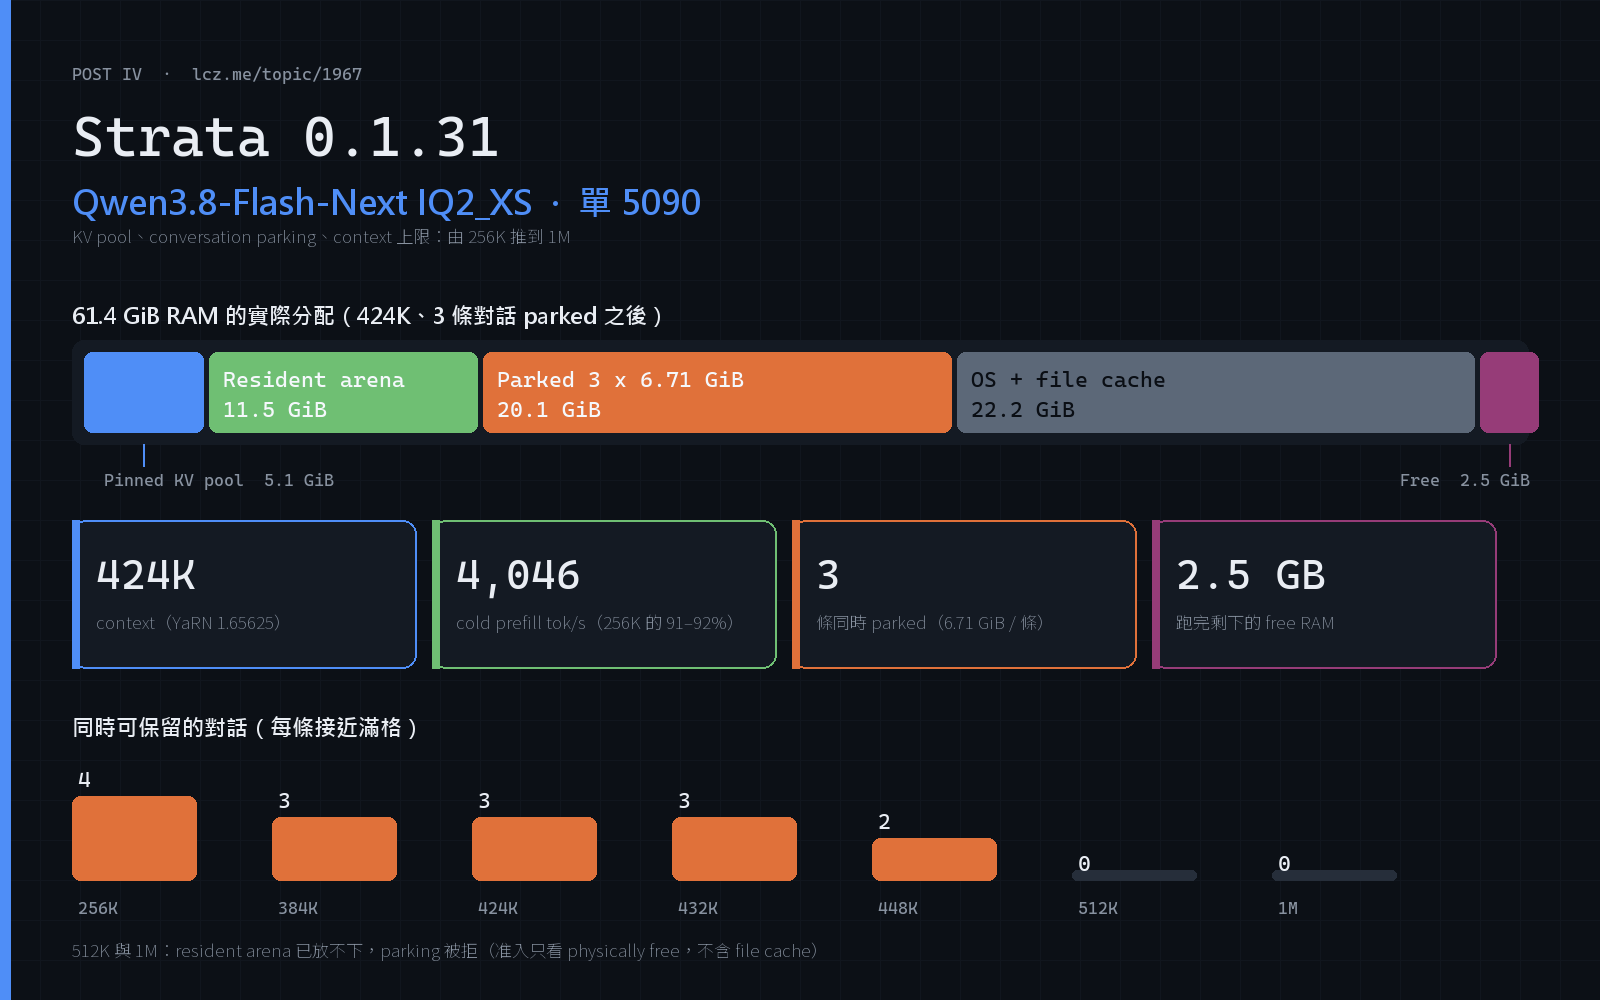
先給結論:256K 上,本機 Strata 與 NInfer 在無投機口徑下基本打平。真正的差別在 parking(Strata 單卡獨有)、記憶體(61.4 GiB 是硬限制)和投機窗口(
--spec 4優於--spec 8)。Phase 1–5 的數字有
summary.json、results.json、startup.txt可核對。Phase 6 是即時執行,數字來自引擎 log 原文,沒有 benchmark.py 的 artifact,下面都標明。
0. 結論
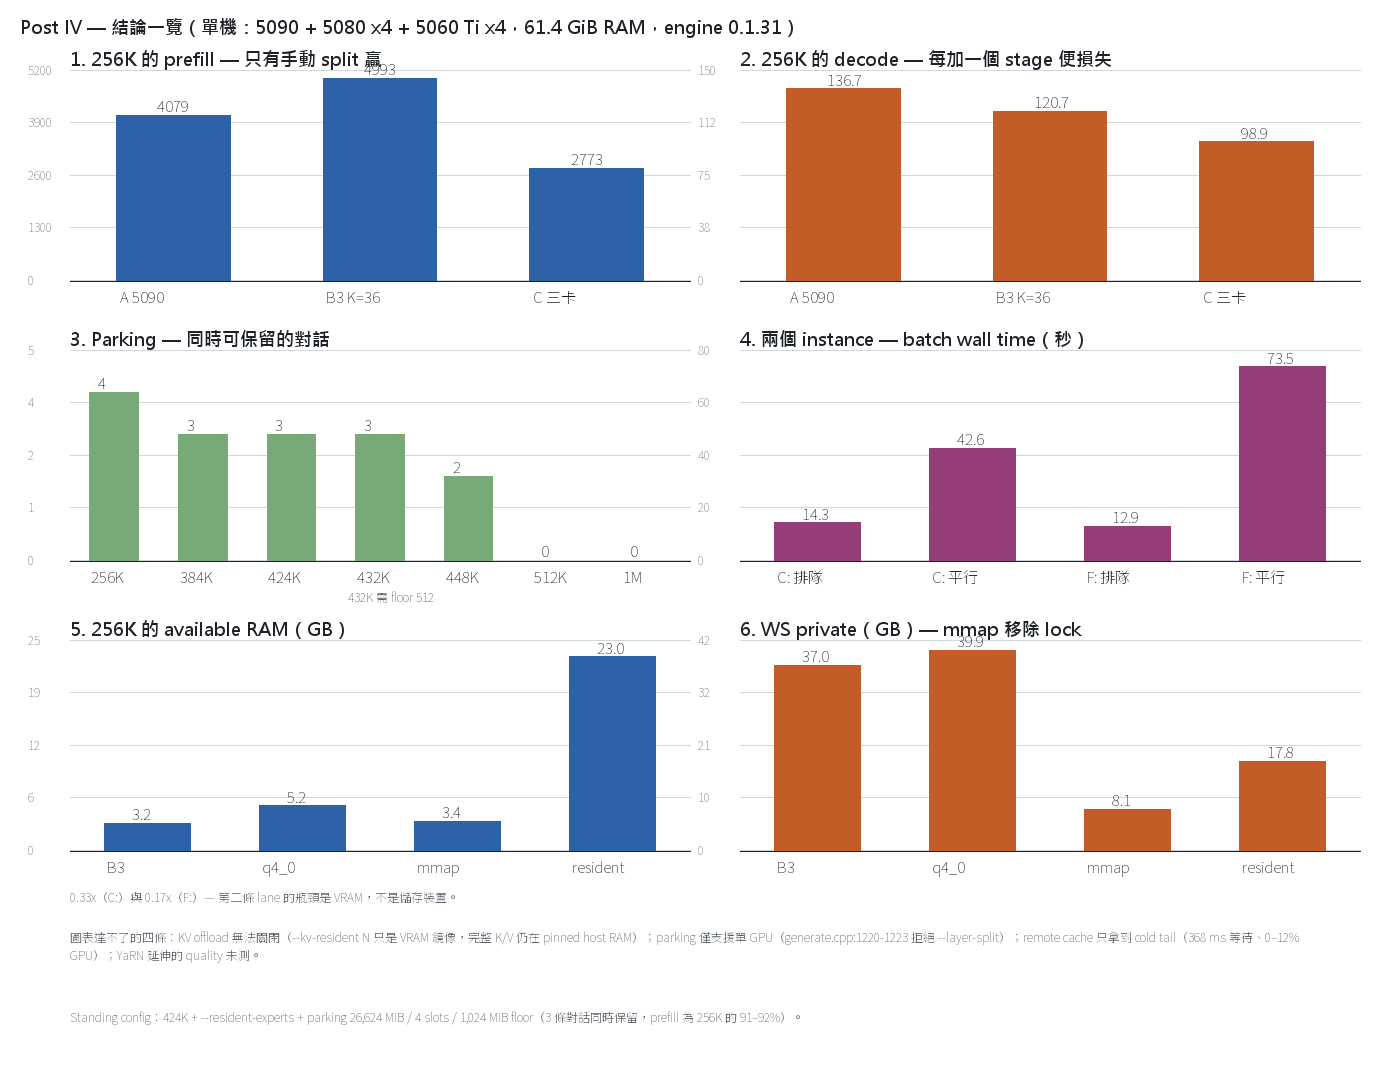
圖裡的六格是可量化的結論:256K 的 prefill、256K 的 decode、各 context 的 parking 上限、兩個 instance 的 batch wall time、available RAM、WS private。下面六條是圖表達不了、但同樣屬於這篇的結論:
- Remote expert cache 是錯誤用法。它只分配第一張卡還沒 claim 的 cold tail:一次 request 的 1,057 次 layer launch 裡 2,919 個 entry、28.5 MiB、等待 368 ms、GPU 使用率 0–12%。第一張卡已經持有約 99.4% 的 routed mass。
- KV offload 關不掉。
--kv-resident N的意義是「在 VRAM 保留 N 個 cell/QSA layer 的鏡像,其餘完整的 K/V 留在 pinned host RAM」。提高 N 不會縮小 pinned pool,只改變 VRAM mirror、streaming 命中率和 expert cache 大小。 - Parking 只支持單 GPU。
generate.cpp:1220-1223拒絕--layer-split,所以 B3 的 4,993 tok/s 與 parking 互斥。圖第 3 格的全部數字都是單卡配置。 --spec 8比--spec 4慢(§9)。每 round 多產出 token,但每秒少做 round,decode 淨輸 2–8%。引擎自己的 cost model 也算出 window 4 是 optimum。- YaRN 延伸的 quality 我沒測。1.5–4.0× factor 沒有 needle 或 perplexity 測試。這篇的長 context 數字是速度與容量,不是 accuracy。
- 跟 NInfer 比(同一張 5090,詳見 §8):Strata 能在 32 GB 卡上跑 125B-A6B 到 256K,NInfer 不能(expert 文件 34 GB 超出 VRAM,且沒有 CPU expert tier)。用本機自己的記錄、口徑對齊後:無投機 decode 兩邊基本相同(Strata 在 64K/128K/256K 略勝);真實 agent 流量 Strata 155.1 優於 NInfer MTP3 143.6、不及 DFlash2 183.4。NInfer 的優勢在小 prompt prefill、C=1–8 真 batching,和 DFlash2 這類 Strata 沒有的 drafter。
Standing config:424K +
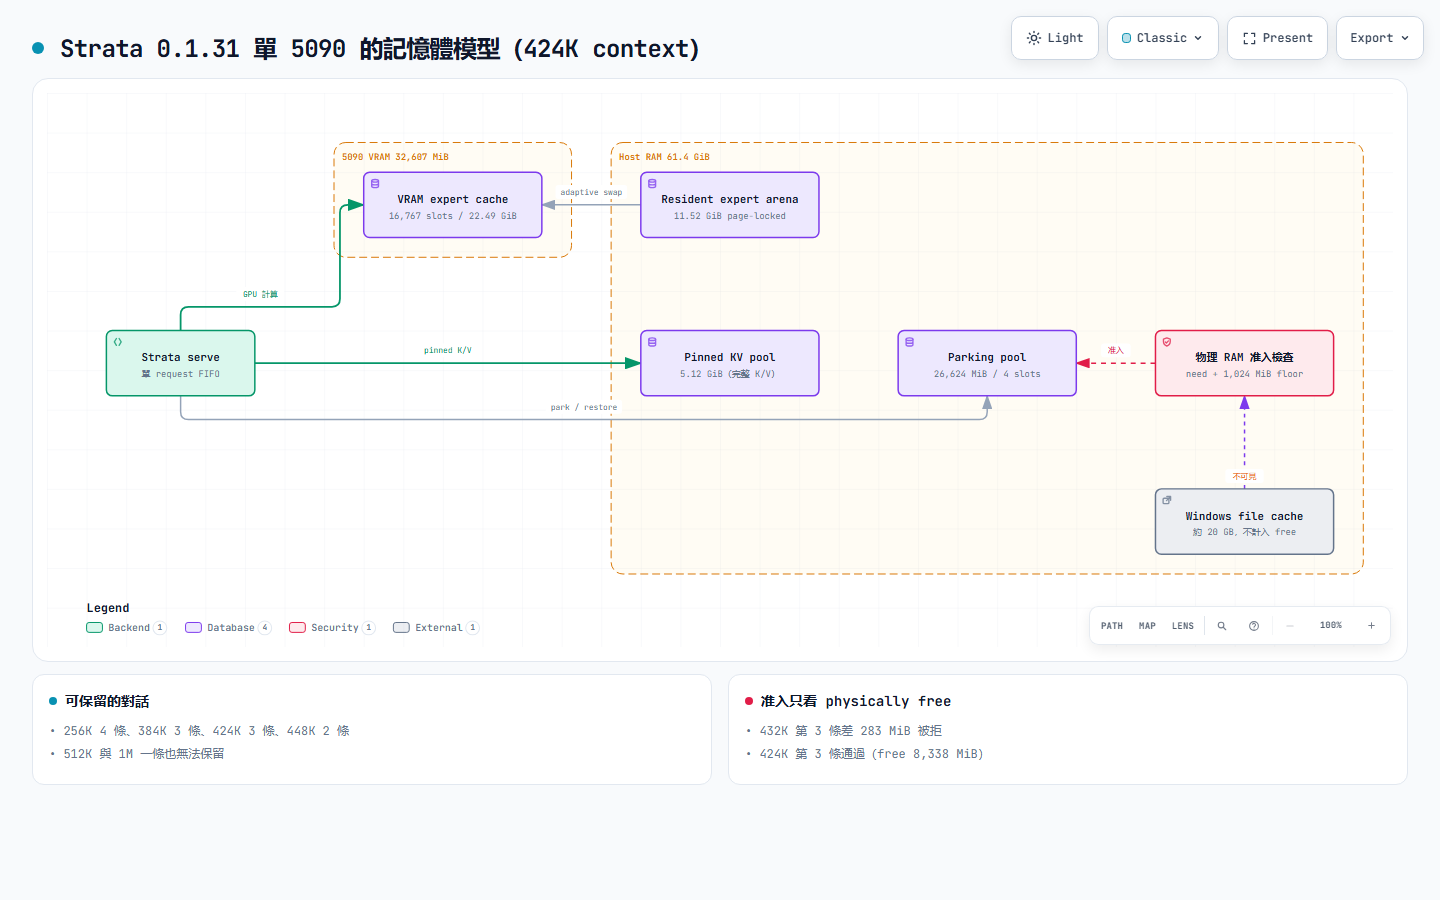
--resident-experts+ parking 26,624 MiB / 4 slots / 1,024 MiB floor。3 條對話在滿格 context 下同時保留,prefill 是 256K 的 91–92%。
1. 環境與測法
- 卡:RTX 5090 32,607 MiB(Gen5 x16,PCIe probe 51.9–52.4 GB/s,
pcie_frac 0.55)、RTX 5080 16,303 MiB(Gen4 x4,probe 6.5 GB/s)、RTX 5060 Ti 16,311 MiB(Gen4 x4,6.5 GB/s)。 - CPU / 記憶體:Ryzen 9 9950X3D;2 × 32 GiB DDR5,實跑 6000 MT/s(G.Skill F5-6400J3239G32G,BIOS 報
ConfiguredClockSpeed 6000,Windows 可見 61.4 GiB)。沒有 ECC、沒有注冊記憶體——所有容量與帶寬的結論都受這 61.4 GiB 限制。 - SSD:模型 GGUF、pack 與 MTP draft layer 都在同一張 Samsung SSD 9100 PRO 4 TB NVMe(C:),跟 DDR5 同一個消費級平台;另有一張 GIGABYTE 1 TB NVMe(F:,IQ3 用)和 SATA 860 EVO(D:)。專家權重以 mmap 讀入,路徑是 NVMe → OS file cache(同一组 DDR5)→ PCIe → VRAM,所以 SSD 這一層跟
--resident-experts爭同一份 61.4 GiB。實測引擎 working set 約 37 GiB、系統 free RAM 只剩約 1.2 GiB——parking 的准入檢查用的就是這個 free 口徑。 - 模型:
qwen3.8-flash-next-iq2_xs(48 layers × 512 experts = 24,576 個 expert pair,native context 262,144)。12 層 QSA 持有 KV,36 層 GDN 持有 running state。 - 系統:Windows,engine 0.1.31,port 18081。
測法:
- Phase 1–5:未修改的
bench/results/2026-09-30-community-rtx-5090/benchmark.py。每次執行用新的 nonce prompt(跨執行不重用)、greedy、256 token 輸出上限、streaming、--targets 4096,32768,128000,256000 --runs 3。TTFT 與 decode 速率取自引擎/metrics的 per-request 記錄,RAM 用 Windows counter。Run-to-run 離散約 5%(256K)、15%(4K)。 - Phase 6:固定 filler prompt(12 個單字循環,實測 4.562 chars/token),每條對話用獨立 seed,一次輸入至接近 context 上限,
max_tokens 400。TTFT 由 client 的第一個 delta 計算,parking 事件讀引擎 log 原文,RAM 用Win32_OperatingSystem.FreePhysicalMemory——就是引擎准入檢查所用的同一個「free」口徑。
2. Phase 1–3:多卡
每加一張卡便损失 decode:136.7 → 120.7 → 98.9。256K 的 prefill 只有 B3 贏(4,993 對 4,079),但 B3 跟 parking 互斥。
Configs(可與
summary.json核對):# config VRAM 中的 experts 备注 A "gpu": 016,640(68%) 只有 5090,48 層 B "gpu": [0,1],--layer-split auto18,139 auto 選了 K=47(5080 只得 1 層、0.72 GiB) B2 "gpu": [0,1],--layer-split "",--expert-cache-device1 700023,920(97.3%) 5080 作為纯 remote cache B3 "gpu": [0,1],--layer-split 3624,208(98.5%) 5090 為 0–35、5080 為 36–47(6,144 slots / 8.48 GiB) C "gpu": [0,1,2],--layer-split 28,4224,576(100%) 5090 為 0–27、5080 為 28–41、5060 Ti 為 42–47 Decode tok/s(3 次的中位數):
prompt A 5090 B auto K=47 B2 remote 7000 B3 K=36 C 3-GPU 4,096 144.8 — 141.5 160.9 129.7 32,768 165.5 — 156.6 157.0 123.8 128,000 153.7 — 143.2 142.2 108.3 256,000 136.7 — — 120.7 98.9 ~31,000(probe) 173.7* 125.0 113.7 183.1 — * 第一輪 A(
2026-10-01-5090-only)在 4K/32K/128K 是 170.3 / 173.7 / 153.7;同一方法重跑(-4targets)是 144.8 / 165.5 / 153.7。4K 的離散約 15%,所以單次差異小於 10% 沒有統計意義。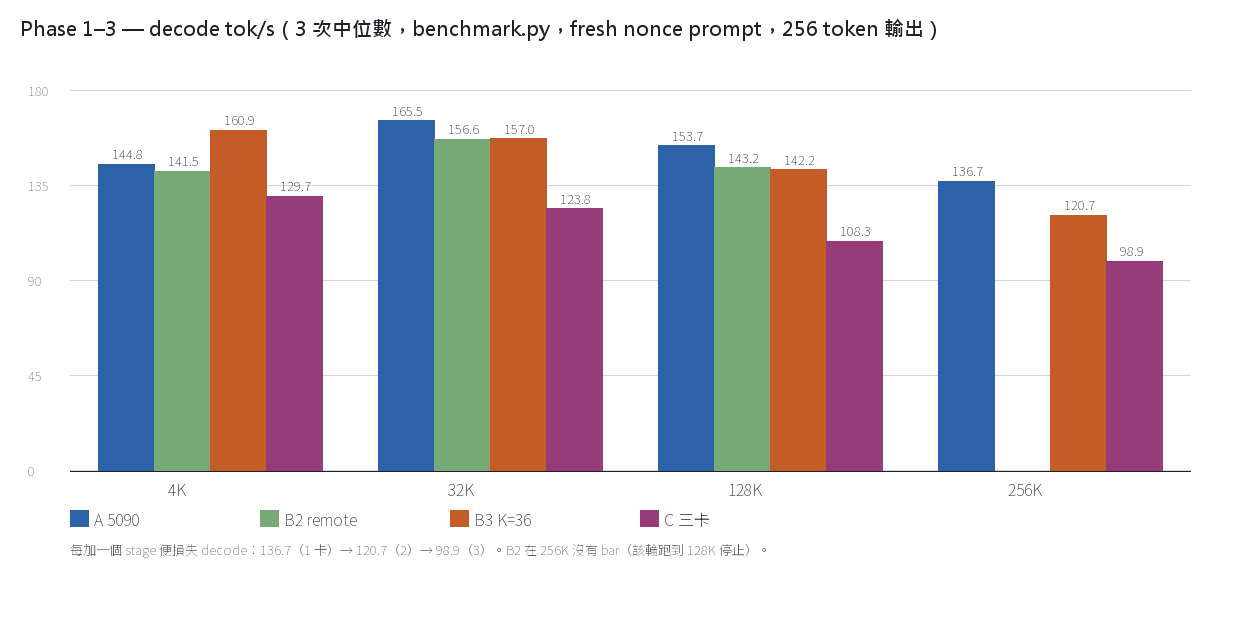
Prefill tok/s / TTFT:
prompt A 5090 B3 K=36 C 3-GPU 4,096 2,857 / 1.5 s 1,893 / 2.2 s 1,278 / 3.2 s 32,768 4,187 / 7.9 s 4,136 / 8.0 s 2,298 / 14.3 s 128,000 4,257 / 30.3 s 5,017 / 25.7 s 2,886 / 44.5 s 256,000 4,079 / 63.2 s 4,993 / 51.7 s 2,773 / 92.8 s 我看到的東西:
- 256K 以下,prompt-heavy 工作的最佳配置是 B3。256K prompt 加 1–8K 輸出時整体較快;但 pure long-decode 仍然以單 5090 為佳。
- 每加一個 stage 便损失 decode:136.7 → 120.7 → 98.9。第三張卡雖然持有 100% 的 experts,卻是全部分段最差。
- Remote cache 是第二張卡的錯誤用法(
remote_experts.cpp:140-148:只分配第一張卡尚未 claim 的 pairs)——1,057 次 layer launch 裡 2,919 個 entry、28.5 MiB(unpacked 388.3 MiB)、等待 368 ms、GPU 使用率 0–12%。第一張卡已經持有熱的 68%(約 99.4% 的 routed mass)。 - 手动 split 才真正用到第二張卡。K=36 時 5080 擁有 12 層、cache 其全部 6,144 個 pairs,request 期間 GPU 使用率 38–99%,24,208/24,576(98.5%)的 experts 在 VRAM。較窄的 split 較差:auto 按预測的 window 時間選了 K=47,讓 5080 有 9.87 GiB 閒置。
- 代价是 x4 PCIe link 和每個 verify window 一次 hand-off。兩張 helper 卡 probe 為 6.5 GB/s;三個 stage 增加第二次 hand-off,所以 32K prefill 從 4,136 掉到 2,298 tok/s。
- CPU 是設計上必須工作,不是 cache miss。engine 的 idle CPU 是 0%,但 256K request 期間
strata.exe是 950–1,040%(約 10 個核心)——QSA/GDN/rope 的 host-side path,除非啟用--native-qsa、--native-gdn、--native-rope。decode 期間的 expert hit rate 測得 99.9%。 - RAM 是 256K 的真正上限。3-GPU 的 256K 執行用掉 58.9 / 61.4 GB(96%)。
- Warm-up 要算進去。啟动後第一條 request 較慢(B3 的 4K prefill 在 ladder 裡是 1,893,後续 probe 是 3,155)。
3. Phase 4:記憶體與速度 flags(同一台機器、同一條 256K request,以 B3 為主)
--mmap-experts在速度上是免費的,而且把 25.6 GiB 的 locked arena 換成可被 OS 回收的 file-backed pages。variant prefill tok/s decode tok/s TTFT available RAM strata WS WS private B3(resident arena,int8 KV) 4,945 114.8 52.2 s 3.0–3.4 GB 37.4 GB ~37 GB B3 + --kv q4_04,047 115.6 63.6 s 5.1–5.4 GB 40.0 GB 39.9 GB B3 + --mmap-experts4,850 119.4 53.2 s 3.2–3.6 GB 42.1 GB 8.0–8.2 GB A 5090 only + --resident-experts3,929 116.3 65.6 s 23.0 GB 17.8 GB 15.2 GB A 5090 only,resident arena(control) 4,079 136.7 63.2 s 未取樣 — — 三件事值得講:
--mmap-experts速度不變,但 lock 消失了:25,626 MiB 的VirtualLockarena 變成 file-backed pages(clean、可被 OS 回收)。Windows 的「available」counter 仍然偏低,因為 mapped GGUF pages 仍 resident,但它们跟 locked arena 不是一回事。--resident-experts=--mmap-experts --resident-cpu-experts+resident_pin+resident_soft+resident_headroom = 4 GiB(generate.cpp:1177-1187)。環境變量可覆盖:STRATA_RESIDENT_PIN=0、STRATA_RESIDENT_HEADROOM_GIB=N。--resident-cpu-experts要求--mmap-experts與 static--expert-profile,並且拒絕 layer split 與 remote cache(1279-1288)。--shared-expert-arena是 Linux-only,這裡用不了。
順帶一條:這就是為什麼 §1 說 SSD 那一層跟
--resident-experts爭同一份 RAM。26.6 GiB 的 parking 预算把可用 RAM 壓到 13.58 GiB,减去 4 GiB headroom 只剩 9.58 GiB,而 resident complement 需要 10.53 GiB——所以引擎報 warning、fallback 到 mmap。兩個 arm 都在這個條件下跑,所以 §9 的 A/B 仍然成立。
4. Phase 5:兩個獨立 instance(真正的 C=2)——兩次都不可行
平行效率 0.33×(C:)和 0.17×(F:)。瓶颈是 VRAM,不是磁盤帶寬。
Instance 1(5090,port 18081,
--resident-experts,16,920 slots / 23.2 GiB,15 pool workers)跟 instance 2(5080,port 18082,--mmap-experts,6,503 slots / 8.71 GiB = 26.5%,8 pool workers,無 vision),兩者 context 都是 262,144。Workload:一條 23,523-token prompt、greedy、128 輸出 token、streaming。lane TTFT total decode expert hit VRAM 5090(18081) 7.00 s 8.42 s ~90 tok/s 94.3% 31.1 GB used 5080(18082,C:) 48.55 s 53.10 s ~28 tok/s 56.9% 14.8 GB used,445 MiB free 兩條 request 的 batch:在 5090 排隊是 14.27 s,兩條 lane 平行是 42.62 s → 0.33×。
第二次我把 pack、兩個 GGUF shard 與 MTP head(72.1 GB、74 個文件)用 robocopy 複制到空閒的 F: NVMe(GIGABYTE GP-ASM2NE6100TTTD,Gen4,397 GB free),耗時 18 s(4.2 GB/s),instance 2 改讀 F:,flags 跟先前相同(
--mmap-experts、6,503 slots、262K context)。測試結束後那份複制已删除,F: 目前不含任何 Strata 文件。lane TTFT total engine prefill engine decode 5090(C:, --resident-experts)8.61 s 9.36 s 2,799 tok/s 162.3 tok/s 5080(F:, --mmap-experts)72.56 s 77.27 s 325 tok/s 26.9 tok/s 兩條 request 的 batch:排隊 12.86 s,平行 73.55 s → 0.17×。先前
 版本(0.33×)之所以較快,只因為 已有 26.4 GB 的 warm standby cache,而 F: 從冷狀態開始。
- 2 秒取樣:C: 讀取 0–26 MB/s(完全沒有 contention),F: 讀取 0.8–1.3 GB/s、約 70% disk time → 磁盤帶寬不是瓶颈。
- Available RAM 從 10.9 GB 掉到 0.31 GB 並維持:file-backed pages 消耗 RAM 的方式跟 相同。
- Per-token cost:5080 lane 是 3.01 ms/token prefill、19.75 ms/token decode;5090 lane 是 0.25 與 4.07 ms/token。
- 結論:第二條 lane 由 VRAM 決定。16 GB 卡需要約 7.9 GB 用於非 expert 部分,剩下 8.71 GiB 只能容納 24,576 個 expert pair 中的 26.5%;其餘 73.5% 走 mmap + CPU pool,即使 page cache 已 warm 仍需約 20 ms/token(引擎自身把 warm mmap 估為 34.78 ms/token)。第二條 262K lane 要快,必須用能容納 experts 的卡(也就是另一張 32 GB 級卡),或者用較小的模型。把文件搬到第二個 NVMe 不改變結果。
5. Phase 6:KV pool、parking 與 context ladder
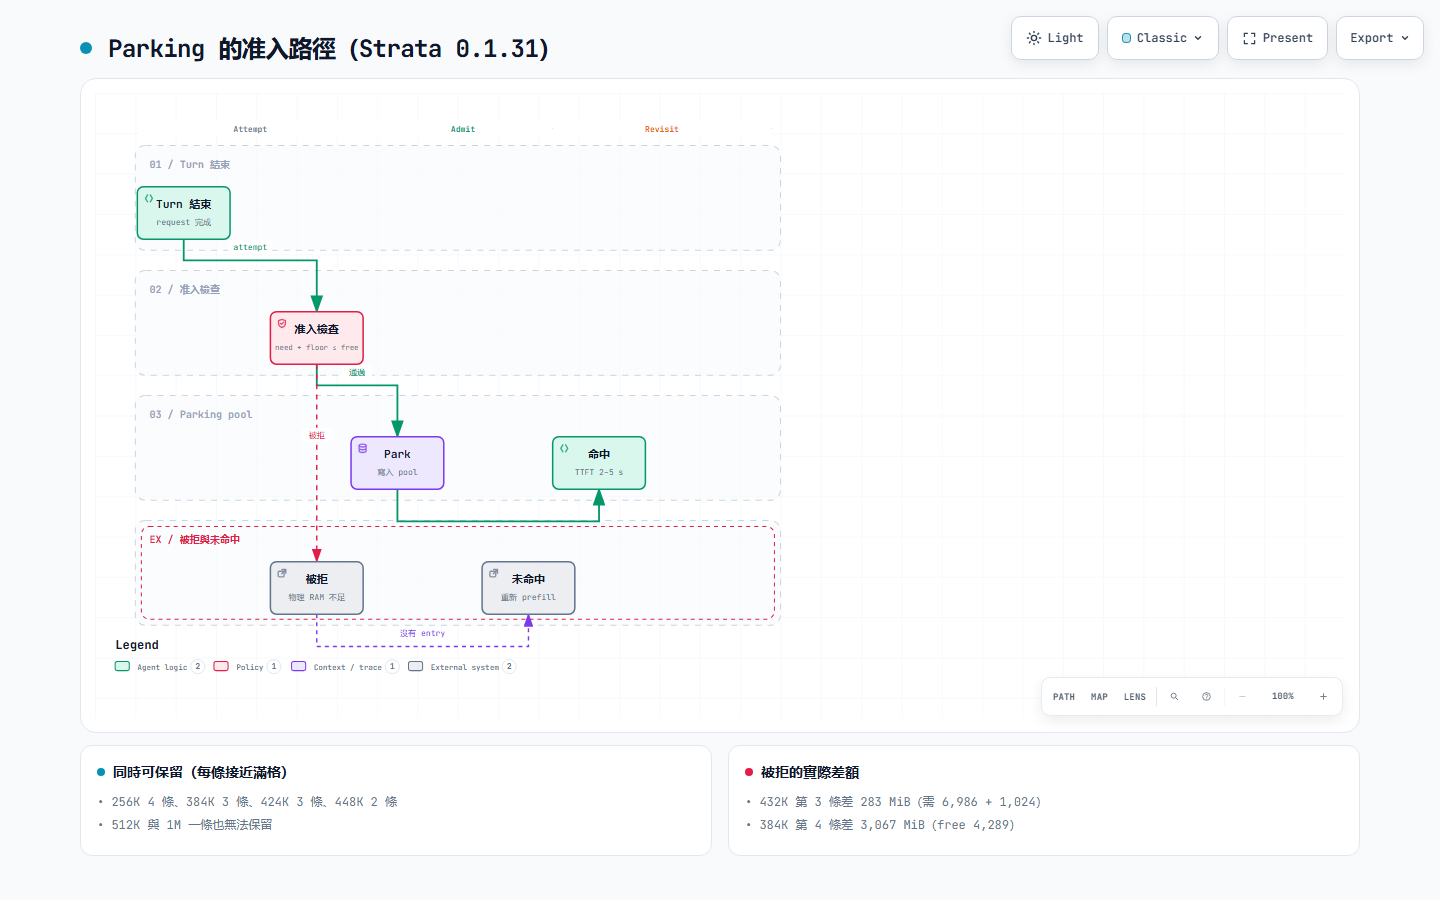
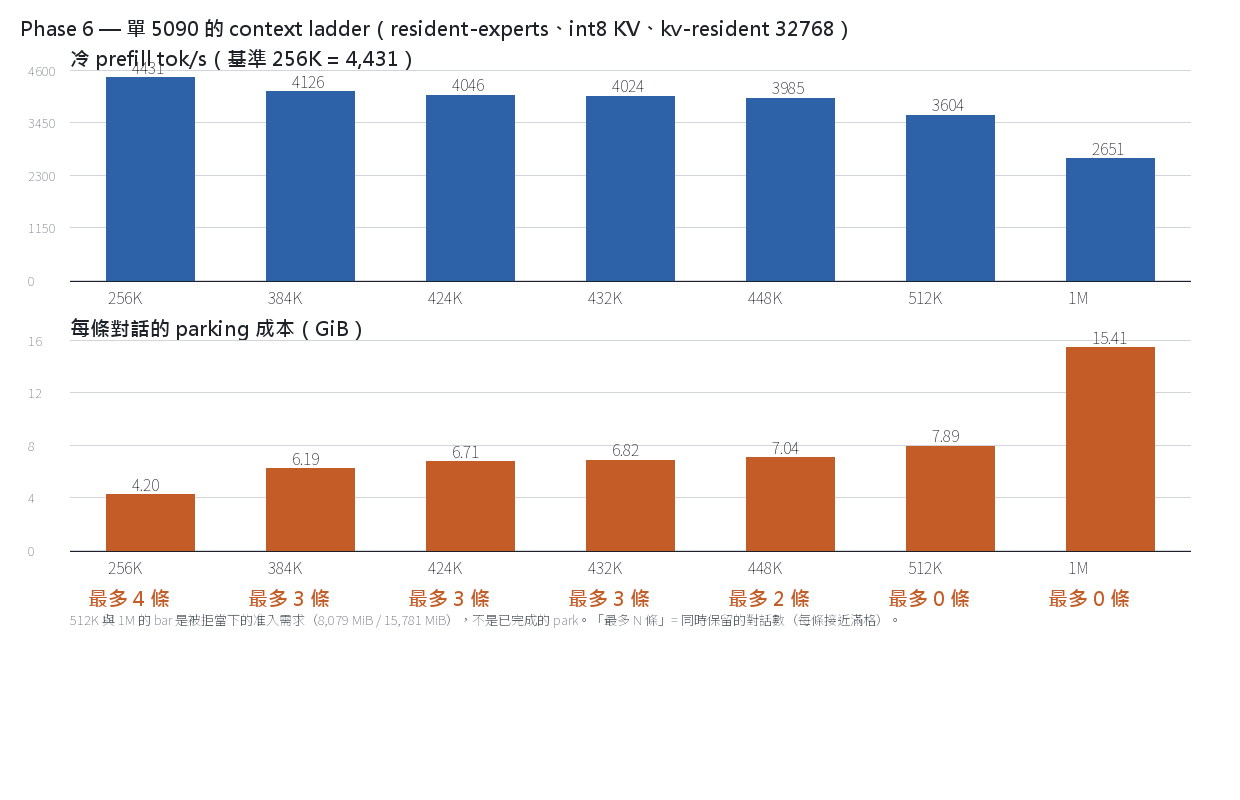
能同時保留的對話:256K 4 條、384K 3 條、424K 3 條、448K 2 條、512K 以上 0 條。checkpoint 約 118 MB 跟 context 長度無關,真正的成本是 positional KV,約 17–19 KB/token。
5.1 Parking 的記憶體模型
SavedConversation複制ConversationKv(k、v、k_scale、v_scale、pooled rows;bytes()用.capacity())與ConversationCheckpoint(gdn、ple、tails、dead、block_pos):- checkpoint(running state)約 118 MB,跟 context 長度無關(
generate.cpp:804-815):36 個 GDN recurrence、conv history、per-QSA indexer tail 與 PLE history。Positional KV 不由 checkpoint 複制,它被 rewind。 - 真正的 parking 成本是 positional KV,約 17–19 KB/token(int8、12 個 QSA layer)。
- 准入规则(
generate.cpp:4009):只有needed + --conversation-cache-min-free-mib <= physically free RAM才 park。「physically free」不含 Windows standby 與 file cache。 - Parking 只支持單 GPU:
generate.cpp:1220-1223拒絕--layer-split("conversation parking does not yet support --layer-split")。所以 B3 的 4,993 tok/s 與 parking 互斥。
5.2 Context ladder(全部實測;parking budget 26,624 MiB / 4 slots / floor 1,024 MiB,256K 使用 18,432)
context YaRN factor KV pool(pinned RAM) expert cache resident arena cold prefill 相對 256K park/條 同時 parked 256K 1.0 2.32 GiB 16,982 / 22.77 GiB 通過,13.10 GiB 4,431 100% 4.20 GiB @241K 4 384K 1.5 4.64 GiB 16,815 / 22.56 通過,11.56 4,079–4,173 92–94% 6.19 GiB @380K 3 424K 1.65625 5.12 GiB 16,767 / 22.49 通過,11.52 4,010–4,083 91–92% 6.71 GiB @417K 3 432K 1.6875 5.22 GiB 16,757 / 22.47 通過,11.23 3,966–4,081 90–92% 6.82 GiB @425K 3,但需要 floor 512 448K 1.75 5.41 GiB 16,738 / 22.45 通過,11.13 3,946–4,024 89–91% 7.04 GiB @440K 2 512K 2.0 6.19 GiB 16,652 / 22.33 差 290 MiB 不通過 3,516–3,693 79–83% 需要 8,079 MiB 0(被拒) 1M 4.0 12.38 GiB 13,965 / 18.71 不通過 2,578–2,724 58–61% 需要 15,781 MiB 0(被拒) - Pool 由 boot 時可用的 RAM 決定,不由 context 固定。同一個 256K 與
--kv-resident 32768,三次 boot 報 2.32 GiB,另一次報 3.09 GiB。從 384K 往上是線性(4.64 → 5.12 → 5.22 → 5.41 → 6.19 → 12.38)。 - Arena 與 parking 爭用同一份 RAM。512K 的 log 是
resident complement 10.69 GiB exceeds available RAM (14.40 GiB) minus the 4 GiB safety headroom,所以不通過、fallback 到 mmap、page cache 消耗 RAM,parking 被拒。1M 是14.31 GiB exceeds available RAM (10.33 GiB) minus the 4 GiB headroom。 - 1M 有兩個 variant,兩者都不可行:
--kv-resident 32768(cache 15,974 / 21.44 GiB,arena 不通過:11.58 GiB 對 7.56 − 4.00)與--kv-resident 262144(cache 13,965 / 18.71 GiB,arena 不通過:14.31 對 10.33 − 4.00)。上表的 1M 列用第二個 variant。512K 也測過--kv-resident 262144,pool 仍是 6.19 GiB。
5.3 各 context 的 log 原文
- 256K(4 條 × 241K):
parked 241123 tokens ... parked=3 bytes=13536720828 evictions=0,四條全部命中,restored 241112 tokens (checkpoint) in 341.7 ms。 - 384K(3 條 × 380K):
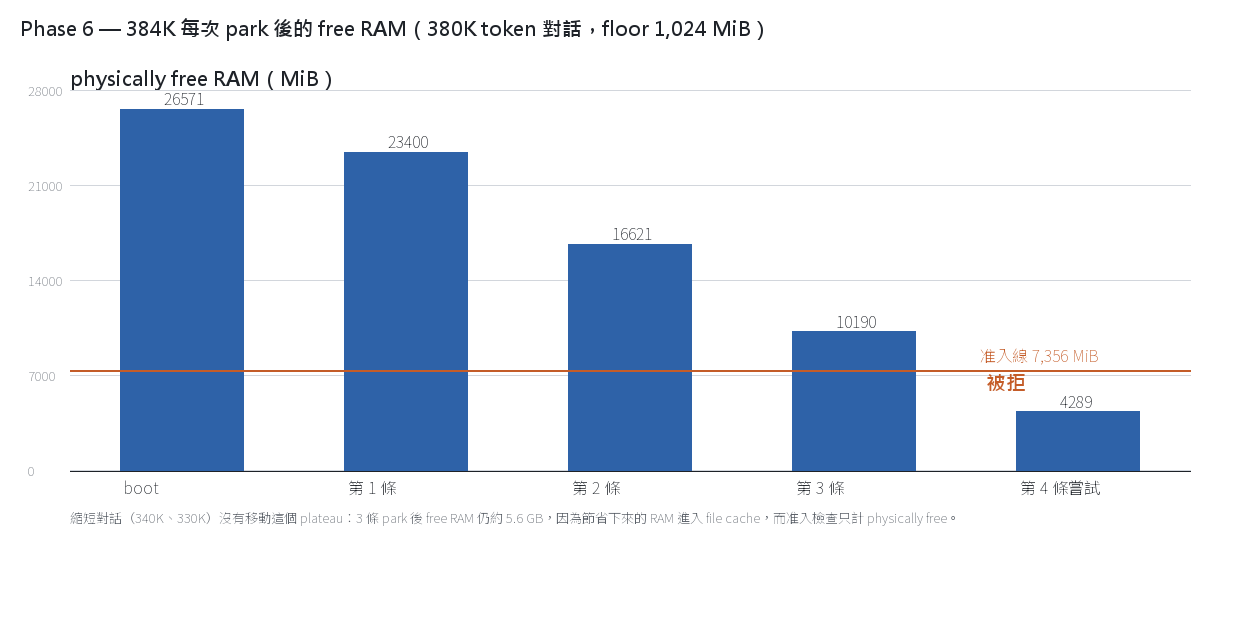
parked=3 bytes=19918823816 evictions=0;第 4 條被拒:skip parking (need 6332 MiB plus 1024 MiB floor),當時 free 是 4,289 MiB(差 3,067 MiB)。重访是 2.38 / 1.90 / 2.15 s 命中,第 4 條 MISS(91.4 s 重新 prefill)。 - 424K(3 條 × 417K,默認 floor 1,024 MiB):沒有 skip 記錄;
parked 417308 tokens ... bytes=7205814172、restored 416901 tokens (checkpoint) ... parked=2 bytes=20781436496(live 6.36 GB + 2 × 7.21 GB,即 3 條在 pool 中)。重访是 4.63 / 2.24 / 2.38 s 命中;decode 是 174.8 / 196.9 / 196.0 tok/s(accepted 299–300 / 400)。 - 432K(3 條 × 425K):floor 1,024 MiB 時第 3 條被拒:
need 6986 MiB plus 1024 MiB floor,free 是 7,727 MiB(差 283 MiB)。改成 floor 512 MiB 後,同一组對話 3 條全部 park,重访是 4.72 / 2.19 / 2.30 s 命中,結束時 free 是 1,774 MiB。 - 448K(2 條 × 440K):
bytes=7557571128(每條 7.04 GiB)、evictions=0、重访 4.68 / 2.56 s 命中;第 3 條需要 8.0 GB,而 free 只有 7.8 GB。 - 512K / 1M:parking 被拒(
need 8079 MiB plus 1024 MiB floor、need 15781 MiB plus 1024 MiB floor)。同一條對話的連续 turn 仍可通過 live checkpoint chain 重用(512K:TTFT 1.41 s、prefill 55 ms),但換對話便要重新 prefill(512K 的 A/B 交錯 → MISS、137 s;1M 命中 107.8 tok/s、cold 61.7 tok/s)。
6. 三個不利但重要的發現
縮短對話換不到第 4 個 slot;424K × 3 耗尽 headroom;slots 與 bytes 是兩件事。
1. 縮短對話無法換取第 4 個 slot。
380K、340K、330K 三次測試,3 條 park 完成後的 free RAM 都約 5.6 GB(4,289 / 5,585 / 5,615 MiB),第 4 條每次都差 1.0–3.0 GiB。省下來的 RAM 進入 file cache,而准入檢查只計 physically free RAM。要保留 4 條必須實際增加 RAM,或者接受 floor 接近 0(也就是沒有安全邊際)。
2. 424K × 3 會耗尽 headroom。
3 條 park 後 free 只剩 2.5 GB。當同時存在另一條 live 對話(真實 agent 流量,prompt 83–90K、hit rate 98%)時,RAM 達到 54.6 / 61.4 GiB,restore 從 1.4 s 變成 25.9–27.0 s(
restored 416901 tokens (checkpoint) in 25918.3 ms)。「可保留 3 條」和「hit path 仍然快」是兩件事。
機制尚未證明(最可能是 parked blob 需經 page cache),但觀察是實測。
3. Slots 與 bytes 是兩件事。
上面的上限指「每條對話接近完整 context」。同一個 424K config 在真實 agent 流量下,4 條 118–138K token 的對話可同時 parked(
parked=4 bytes=20315885712、evictions=0),第 5 條才觸發一次 eviction(evictions=1)。所以「424K 可保留 3 條」指 3 條接近滿滿;如果每條約 130K,4 個 slot 仍可使用。
7. 配置建議(整個 campaign)
要 4 條就留在 256K;要 3 條就 424K。prefill 為主且不需要 parking 才用 B3。
- 長 context 且同時保留 3 條對話:424K(
--max-context 434176 --rope-scaling yarn --rope-scale 1.65625)加--conversation-cache-mib 26624 --conversation-cache-slots 4 --conversation-cache-min-free-mib 1024。這是目前的 standing config。 - 需要 4 條:維持 256K(每條 4.20 GiB,mib ≥ 18,432)。
- 需要 432K 以上:432K 需要 floor 512;448K 只能 2 條;512K 需要 96 GB RAM 才有 headroom。
- 如果 prefill 是主要工作(單次 256K prompt、不需要 parking):B3
--layer-split 36,4,993 tok/s / TTFT 51.7 s。但它與 parking 互斥。 - 投機窗口:
--spec 4(§9)。--spec 8沒有數據支持。 - RAM budget:兩條 262K instance 約需 57 GB → 64 GB 是 practical floor,96 GB 較充裕,128 GB 有餘裕。
8. Strata 對 NInfer(同一台機器,全部用本機實測過的數字)
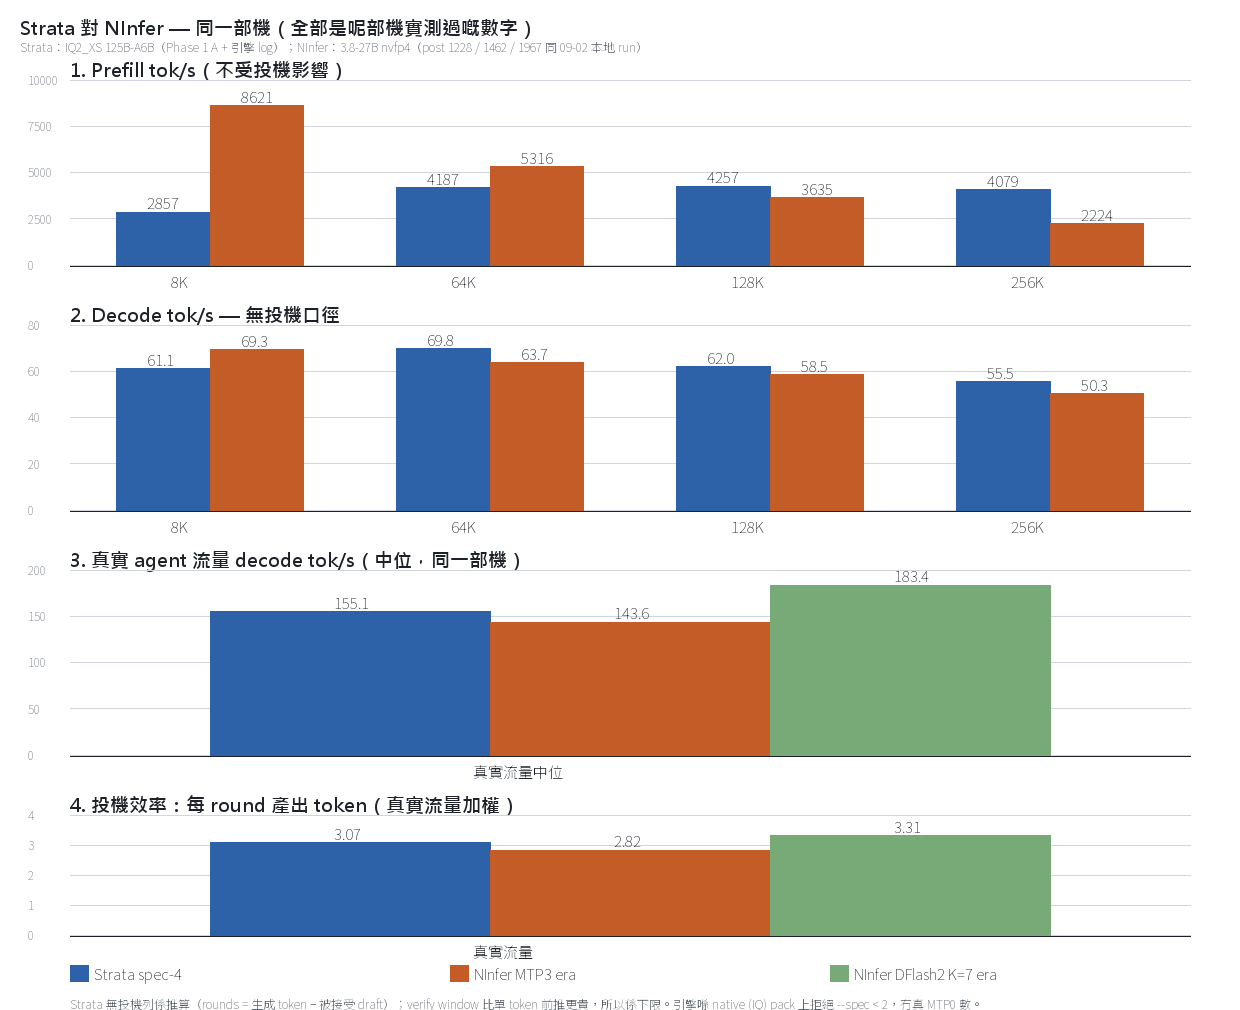
這一節第一版我寫錯了兩次:用了官方表,又把 Strata 含投機的 decode 直接對 NInfer 的 MTP0 列。下面全部改用本機自己的記錄——前三篇 1228、1462、1967 和本地 campaign 記錄(
out/campaign_0902_mirror/、out/dflash3/campaign/、out/dflash3/campaign_v4/),並且把投機與否分開算。8.1 真實 agent 流量(同一台機器、同一類工作、兩邊都開投機)
NInfer MTP3 era NInfer DFlash2 K=7 era Strata --spec 4期間 / 樣本 09-04 → 09-07,12,479 req 09-07 → 09-08,5,879 req 10-01 → 10-02,282 個 agent request(prompt ≥30K) prompt 中位 72,062 72,492 167,244 cache 命中 79.8%(加權)/ 97–99%(per req) 82.3% / 97–99% 98.9%(per req) decode 中位 143.6 183.4 155.1 decode p95 / max 192.1 / 342.9 282 / 436.9 191.9 / 216.7 acceptance(加權) 60.7% 33.0% 77.5% tokens/round 2.82 3.31 3.07 並發 C=3(真 batching) C=3 C=1(一次一個 request) 口徑相同時 Strata 155.1 介於 NInfer 兩代之間:優於 MTP3(+8.0%),不及 DFlash2(−15.4%)。
但 NInfer 那兩栏是 C=3 真 batching,Strata 是單 request 一條 lane。所以這裡比的是單條 lane 的 per-request 速度,不是吞吐。
另外 Strata 的 prompt 中位數(167K)比 NInfer(72K)大得多,樣本也小得多(282 對 12,479)。這一點我要講清楚,不然數字會誤導。
8.2 無投機口徑(prompt 長度對齊)
prompt Strata(無投機等价,下限) NInfer MTP0(09-02 本地 run) 8K 61.1 69.3 64K 69.8 63.7 128K 62.0 58.5 256K 55.5 50.3 Strata 那一列不是我直接量的。引擎在 native (IQ) pack 上拒絕
--spec < 2(generate.cpp:1738-1743、generate.cpp:3611),所以 Strata 沒有真正的 MTP0 數字。它由 log 中每個 request 的投機統計推算:rounds = 生成 token − 被接受 draft,round rate = rounds ÷ decode 時間。因為 verify window 比單 token 前推更贵(suffix_drafter_test.cpp:3:每 token 約多 10 ms),這個數是下限。口徑對齊後兩邊基本相同,Strata 在 64K/128K/256K 略勝。原本「NInfer decode 快 1.6 倍」是口徑不對齊造成的。
8.3 Prefill(不受投機影響)
prompt Strata NInfer(post 1462 solo prefill,本機) NInfer(09-02 本地 MTP0 run) 4K / 8K 2,857(4,096) — 8,621(7,680) 32K / 47K 4,187(32,768) 6,004(47k) 5,316(64,512) 105K / 128K 4,257(128,000) 4,096(105k) 3,635(130,048) 143K / 157K — 3,403 / 3,174 — 210K / 256K 4,079(256,000) 2,587(210k) 2,224(260,096) 小 prompt 的差距(3–6 倍)是真實的:Strata 的 prefill 受 PCIe expert streaming 限制(probe 52 GB/s、
pcie_frac 0.55)。但到 105K 以上兩者已經接近甚至反轉(Strata 4,257 對 NInfer 4,096;256K 4,079 對 2,224)。TTFT 也一樣:NInfer 09-02 run 在 128K/256K 是 35.8 / 117.0 s,Strata 是 30.3 / 63.2 s。只有 8K 時 NInfer 更快(0.90 s 對 1.5 s)。
8.4 DFlash
Strata 沒有 DFlash 等价。它的投機是 MTP window 加 suffix lookup(
--suffix-draft 3、--mtp-max-t)。NInfer 的 DFlash2 是 5 層 draft(約 1.6B 參數),每 round draft 7 token 再 verify;本機實測 K=7 C=1 corpus 198.7 tok/s、acceptance 36.6%、每 round 3.31 token(post 1967)。Strata 的 MTP+lookup 每 round 3.07 token(真實流量加權),量級接近 MTP3(2.82),達不到 DFlash2 的 3.31–6.5。架構上的分別:NInfer 支持 C=1–8 真 batching 與 context cache(prefix reuse、anchors、host KV tier);Strata 的 serve 一次只處理一個 request,跨對話重用要靠 parking,而 parking 只支持單 GPU。NInfer 跑不了 IQ2_XS(expert 文件 34 GB 超出 32 GiB VRAM,且沒有 CPU expert tier)——這裡是引擎對引擎,不是同一個 model。
9. 投機窗口:
--spec 4對--spec 8(實測 A/B)同一台機器、同一個配置、同一方法,只改
--spec。
--spec 8贏在每 round 的 token 數,輸在每秒的 round 數——淨結果是 decode 慢 2–8%。prompt spec 4 decode spec 8 decode Δ tokens/round(4 → 8) round/s(4 → 8) 4K 148.9 145.2 −2.5% 2.44 → 3.01 61.1 → 48.2 32K 165.0 151.3 −8.3% 2.53 → 2.84 65.1 → 53.2 128K 146.0 142.8 −2.2% 2.53 → 2.88 57.6 → 49.6 256K 127.8 124.0 −3.0% 2.35 → 2.81 54.4 → 44.1 兩邊都是 3 runs 取中位數、同一配置(424K + parking 26,624 MiB / 4 slots / 1,024 MiB floor)、同一
--spec-min-p 0.5。
4K 的第一輪是冷 cache(prefill 536 / 544 tok/s),中位數不受它影響。為什麼輸
接受率下降:spec 4 是 65–72%,spec 8 是 46–65%。窗口越深,條件接受率越低——第 4 個 draft 之後的 token 不值得 verify。
spec 8 每 round 多產出 0.4–0.6 個 token,但每秒少做 12–17 個 round。
多出來的 draft 要付 verify 時間,換回的 accepted token 抵不上成本。這個結果跟引擎自己的 cost model 吻合。
controller.hpp的常數(2026-09-23 三場測量)在 0.86 prior 下算出 optimum 是 k=3 drafts(window 4),也就是--spec 4;用draft_policy_test.cpp那條實測 cost 曲線(19.0 + 10.5·(t−1) ms)算,optimum 是 k=2–3。而 log 顯示 spec 4 實際使用的窗口是 2.2 drafts/round——policy 自己選的就是 optimum。spec 8 把 cap 抬到 8,policy 開始 over-draft。--spec的硬上限是 8(kVerifyMaxT)。--spec 4實際 effective cap 是 6(--suffix-draft 3加 2),MTP window 上限 4;--spec 8是 cap 8、MTP window 8。所以:
--spec 4是這台機器的最佳值,--spec 8沒有數據支持。 想再往上只有靠 lookup window,而 policy 已經逐 case 自己選。
10. 沒測和沒做完的
- IQ3(
ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF)的速度 A/B(5090-only 與 5090+5080 K=36 兩個 config)還沒跑。文件已下載完成,四份都跟 HF API 逐 byte 核對:IQ3_S 54,817,524,224 / 28,800,138,432;IQ3_XXS 47,039,860,096 / 28,800,138,432。 - YaRN 延伸的 quality 我沒測。1.5–4.0× factor 完全沒有 needle 或 perplexity 測試。這篇所有長 context 數字是速度與容量,不是 accuracy。
- 沒試的 candidates:
--kv k8v4(816 對 1,056 B/cell,不能與--kv-resident並用)、--kv-resident的 cell 數、--expert-cache-per-layer(參考測量的 2.97% → 21.4% hits at 8K)、--prefill CHUNK(auto = 8192)、--ple-io mmap|ram、--pool-workers/--no-host-worker,以及 MTP knobs(--mtp-max-t、--spec-min-p、--suffix-draft;--spec已測,見 §9)。 --shared-expert-arena(Linux-only)沒試。
11. 複現
Phase 1–5:
benchmark.py --targets 4096,32768,128000,256000 --runs 3,每個 config 一份config-used.json、metrics.json、summary.json、results.json、raw per-request JSON 與startup.txt。Phase 6:改
--max-context與--rope-scaling yarn --rope-scale <factor>,boot 後發送 3–4 條接近上限的獨立對話,看引擎 log 的conversation cache:記錄(parked=N bytes=B evictions=E、skip parking (physical RAM admission; need X MiB plus Y MiB floor))與/metrics的conversation_cache_mib / slots / min_free_mib。准入檢查用的「free」跟FreePhysicalMemory是同一口徑,差額可直接核對。Phase 8(§9):同一 config 跑兩次,只改
--spec,artifacts 在2026-10-02-spec8/與2026-10-02-spec4/。Artifacts:
2026-10-01-5090-only/、-5090-only-4targets/、-5090plus5080/、-5090plus5080-remotecache/、-layersplit-K36/、-layersplit-K36-256k/、-layersplit-K36-256k-r3/、-3gpu-K28-42/、-memctl-B3/、-kvq4-B3-256k/、-mmapexperts-B3-256k/、-residentexperts-A-256k/。Phase 6 沒有 artifact 目錄(即時執行,僅有引擎 log)。
12. 參考
- 前三篇(同一台機器,NInfer):1228、1462、1967
- Strata:https://github.com/Niko1221/Strata
-
,
 T terry 固定了此主题
-
-
-
,系统 取消固定了此主题
-
-
@stxpnet 我在dsh上跑了上跑了一周(1/10 -6/10)高強度的用也沒發生也沒發生循環問題
現在用IQ3_S也沒問題
IQ3_S 在 DSH 上的實際平均速度
資料來源:strata-iq3_s-5090.log,涵蓋 2026-10-06 16:09 → 2026-10-09 12:52(2.85 天),11,241 個 request、12,502,938 個 generated tokens、26.56 小時的 decode 時間。
指標 值 decode(加權平均,總 token ÷ 總時間) 130.8 tok/s decode 中位數 129.4 tok/s decode 算術平均(每 request) 128.4 tok/s p10 / p90 109.7 / 146.2 tok/s min / max 7.8 / 237.2 tok/s prefill(加權平均) 2,832 tok/s 含 prefill 的端到端 113.6 tok/s 平均每 request 1,112 generated tokens,prompt 129,900 tokens prefix reuse 97.2% 的 prompt tokens 按 context 大小(加權 decode):
prompt tokens n decode 60K–100K 2,383 131.4 100K–140K 3,298 130.6 140K–170K 2,568 131.9 170K–300K 2,439 127.1 幾乎平的 —— 到 170K 以上才掉 3.3%。
跟 IQ2_XS 同一張卡、同樣真實流量的對比
strata-iq2_xs-5090-maxslot.log(10-04 → 10-07,10,153 requests、8,780,547 tokens):
IQ2_XS IQ3_S 差 decode 加權 167.8 130.8 −22.0% decode 中位 168.4 129.4 −23.2% p10 / p90 143.4 / 193.8 109.7 / 146.2 含 prefill 136.4 113.6 −16.7% prefill 2,407 2,832 +17.7%(IQ3_S 較快) prefix reuse 97.9% 97.2% 一個跟我之前 benchmark 不一致的地方(要講清楚)
我之前那輪受控測試(4,096 token 隨機 prompt、greedy、128 tokens)量到 IQ3_S 比 IQ2_XS 慢 34.4%。真實使用只有 22.0%。原因是 benchmark 用隨機 token 檔 + greedy,draft acceptance 很低(50 of 92);真實文字好預測得多,加上 97% 的 prefix reuse 讓 expert hit rate 不同。所以真實懲罰比 benchmark 小,兩個數字我都留著。
這組數字的限制
- log 是 engine 的 serve log,18081 就是 DSH 的 backend,所以這些是 DSH 打的 request;但我無法把 DSH 跟其他打同一個 port 的 client(例如 chat 網頁)分開。
- DSH 自己的 dsh-token-usage\index.json 是舊的(
writtenAt2026-08-20,而且完全沒有 strata 那列),所以無法交叉驗證。 - serve log 的行沒有時間戳,所以做不出每日分解。
- 這個窗口包含 10-06 16:09 那個 18085 實驗(短暫共存)和 10-07 16:18 用 bat 啟動的那次 —— 都算在 11,241 個 request 裡。
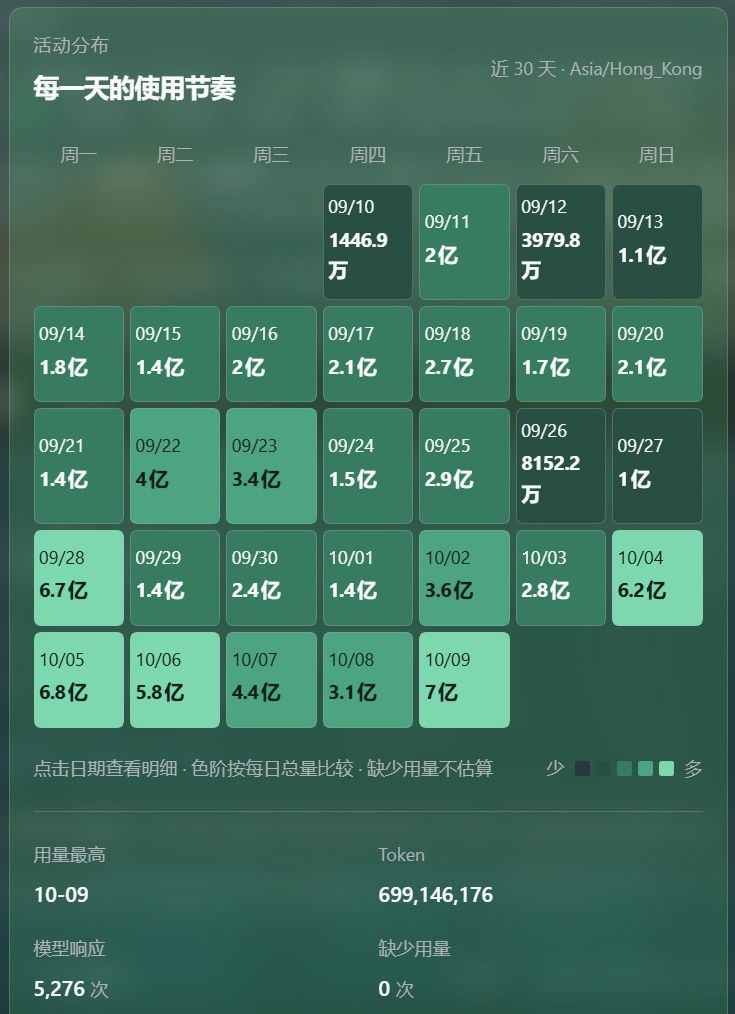
4/10 加ram了(64GB -> 192GB) 中間速度(3600-4800 MT/s)有浮動不太準 現在穩定在4800 MT/s
-