【极速版】Qwen-Image-2.1 Viggle Turbo v0.3:6步出图速度提升5倍!
-
 Qwen-Image-2.1 Viggle Turbo 6步生成、速度提升5倍!
这是一款把 40步扩散→6步 的模型,会带来什么体验?更快?更稳?更强?本帖带你一次看懂 Viggle Turbo 的核心亮点、安装要点、ComfyUI使用、已知限制与版本差异。 一、模型定位:Qwen-Image-2.1 的极速精炼版
Viggle Turbo 是对 Qwen-Image-2.1 的极速精炼版本,将原本 40 步的生成流程压缩到 6 步,并保持高质量输出。
速度提升约 5×
支持 文本转图像、指令编辑、1–3 张参考图像编辑
无需分类器指导(No CFG) ️ 二、版本升级:v0.3 vs v0.2.1
v0.3(当前主推)
颗粒更少、表面更干净、纹理更柔和
仍保持与基础模型接近的多样性
小字表现与 v0.2.1 接近
不是严格升级:如果你喜欢更锐利的风格,v0.2.1 仍可选新增 9 步模式
前 7 步使用 Turbo,后 2 步切回基础模型补细节
小字更容易正确
速度仍比基础模型快约 3.5× 三、核心参数(Turbo 的灵魂)
6步 SIGMAS(必须保持)[1.0, 0.9375, 0.875, 0.75, 0.5, 0.25]关键规则
true_cfg_scale = 1.0(无 CFG)步数变化:只在高噪声端增减步数(5步、7步)
移动低噪声节点会让图像更柔和
🧩 四、文件结构与使用方式
LoRA 文件(推荐)
r256(1.3GB) 主力版本
r128(0.7GB)适合 ComfyUI 工作流单文件 Transformer(合并版)
提供 int8、fp8、GGUF 多种量化格式合并后会损失部分 LoRA 更新效果(约 30%)
 ️ 五、ComfyUI 使用要点
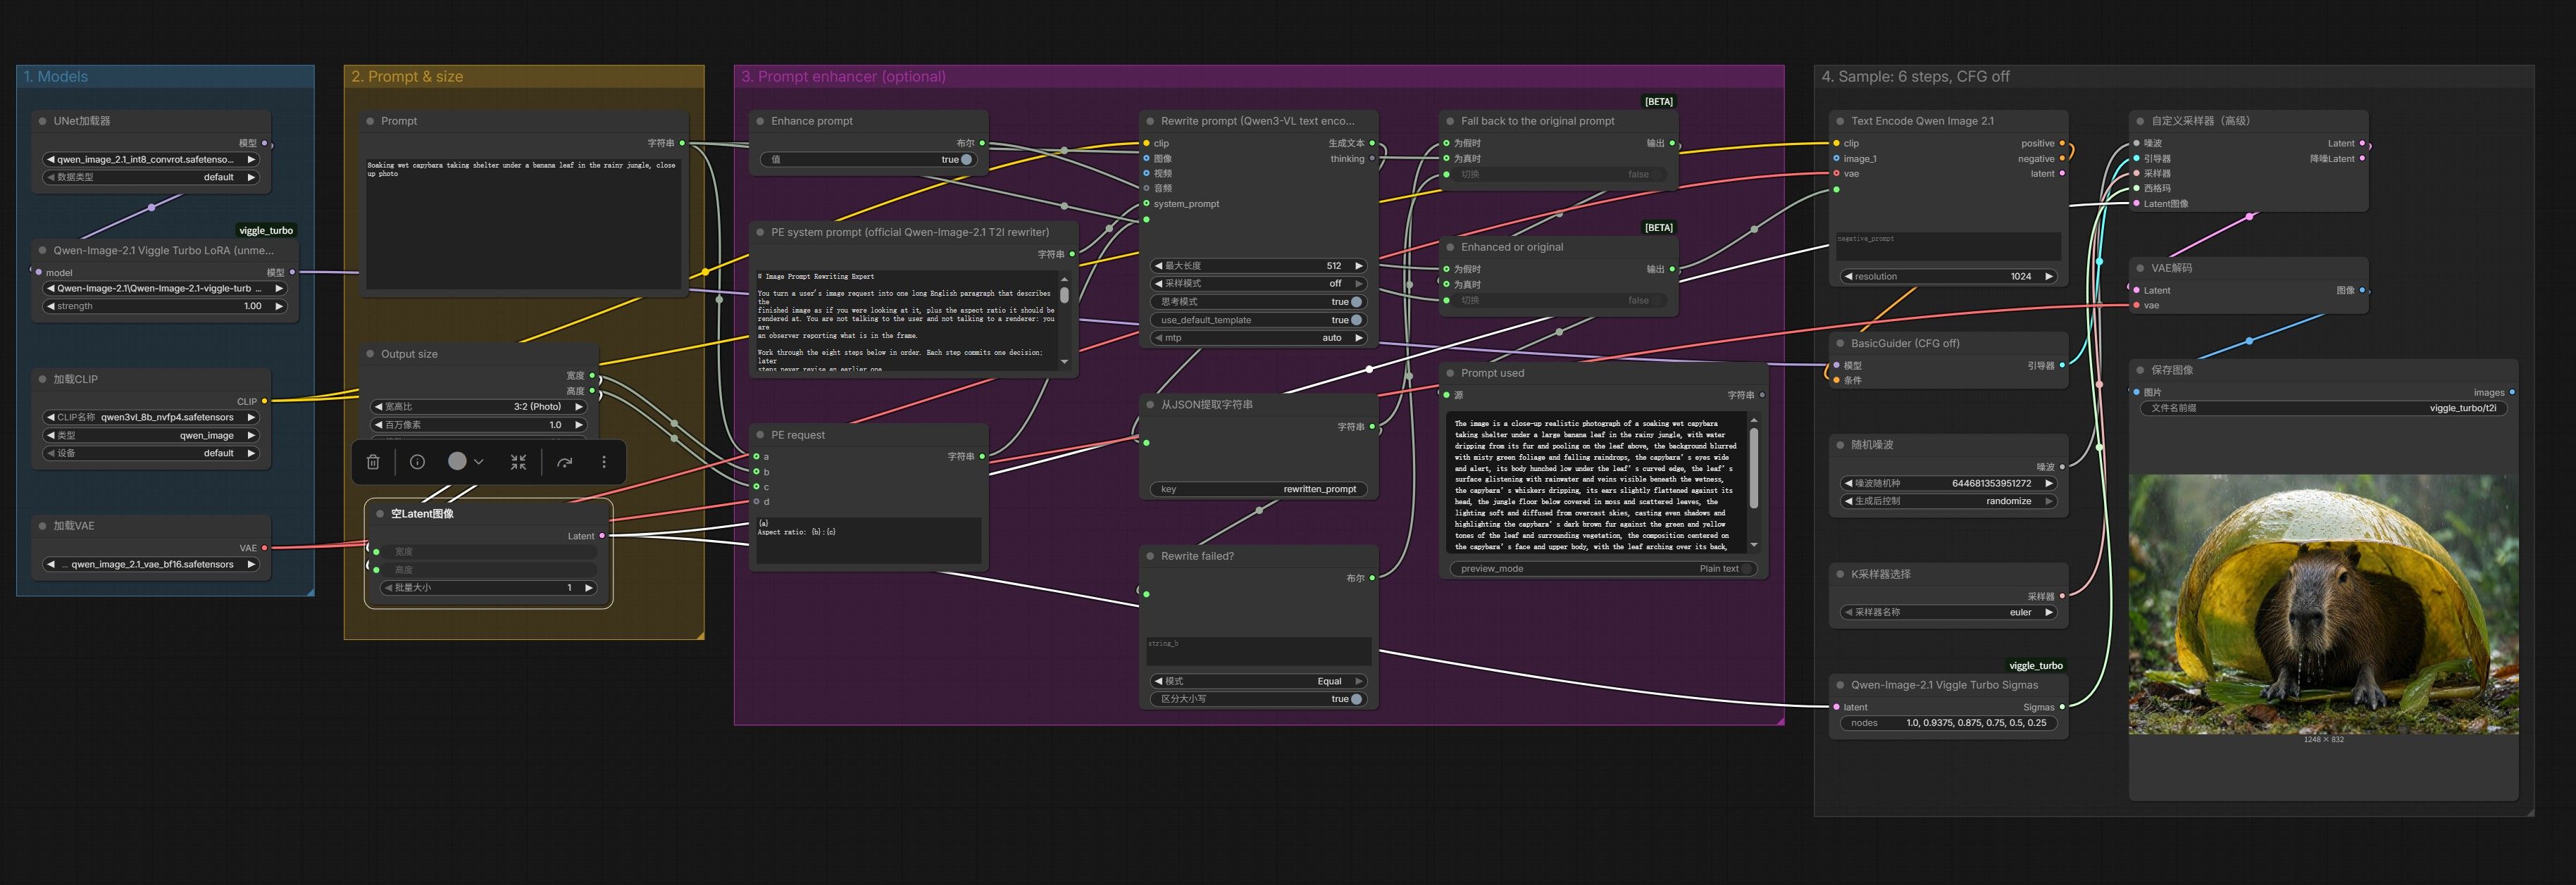
官方提供 自定义节点 + 工作流 JSON
下载地址:https://huggingface.co/Viggle/Qwen-Image-2.1-viggle-turbo/tree/main/comfyui默认使用 int8 模型 + r128 LoRA,显存约 8GB 可跑到 1248×832 分辨率
Turbo Sigmas 替代 KSampler 调度器(无 CFG、无负提示)
编辑模式输出大小跟随参考图像 1
🧪 六、已知限制(务必了解)
复杂编辑:多引用、面部交换、身份保持仍可能弱于基础模型小文字:比基础模型更容易混乱
颜色饱和度:略低于基础模型
v0.3 在细纹理上比 v0.2.1 更柔
-
-
,
 T terry 固定了此主题
-
-
-
谢谢你,很不错。。。
-
,系统 取消固定了此主题