
W7800 48GB 单卡 Strata 0.1.34 实测:100K上下文 no-thinking decode 均值 76.5 tok/s —— 48GB 全驻留是官方表从未测过的区间
-
先交代:本帖所有速度数字均为 no thinking(不思考模式)(请求带
chat_template_kwargs: {"enable_thinking": false})。官方docs/DETAILS.md写明未设定时模型默认 high,所以本帖数字与官方速度表、与论坛里各帖的数字不是同一把尺,对比前请先钉死 thinking 档位。唯一例外:文末 GSM8K 吞吐参考(thinking on),只作工作量对照。一、机器与配置(全部实查)
项 值 GPU AMD Radeon PRO W7800 48GB(gfx1100 / RDNA3 / wave32) CPU Ryzen 5 7500F(6 核,AVX-512 + VNNI) 内存 30GB DDR5-6000 双通道 系统 Linux,ROCm 7.2.4,hipBLASLt 1.2.2(100202),PCIe Gen4 x16 引擎 本地 HIP 编译(gfx1100);生产二进制 sha256 b3bcb0f5…(0.1.34 build);此前 0.1.27/0.1.29 做过完整对照模型 ISTA-DASLab IQ3_XXS(两 shard,HF revision ed59f92…)+ mmproj BF16(vision 走本地 HIP 版)引擎参数(生产现值,09-30 起未变):
--pack packs/iq3_xxs --native …-00001.gguf --ple-gguf …-00002.gguf
--mmap-experts --expert-profile data/expert-profile.bin --expert-cache auto
--prefill auto --spec 3 --spec-min-p 0.7 --mtp mtp/rt
--max-context 262144 --kv k8v4 --pool-workers 5 --pcie-frac 0
--vram-reserve-mib 2048 --adapt-every 0 --vision
环境变量:
STRATA_PREFILL_MMQ=1、STRATA_PREFILL_RING=96、STRATA_IO_THREADS=32、STRATA_HIPBLASLT_TUNING=tools/hip/gfx1100-hipblaslt-100202.txt(自校准 26 行)。二、核心结论:48GB 全驻留改变整个瓶颈结构
官方 IQ3_XXS 参考表(RTX 5070 12GB + 64GB RAM)建立在「专家层要溢出去 RAM/SSD」的前提上。本机 48GB VRAM 下
--expert-cache auto自动吃到 24,576 slots / 39.97 GiB、decode 命中率 100% —— 专家从不离开 VRAM。官方从未测过这个区间。生产实际负载(0.1.34,server log 机械抽取,n=573 臂):
真实交互式对话负载,no thinking,context 累积到 80–120K tokens:
指标 实测 decode @ 80–120K ctx 均值 76.5 tok/s(min 45.3 / max 100.7) expert cache 命中率 93.1–97.0% draft 接受率 0.76–0.94(例 320/336、671/793) 同 log fresh prefill(18–20K prompt,0 reused) 1,196–1,231 tok/s 同 log fresh prefill(160K prompt) 1,043.8 tok/s 100K 上下文的 decode(76.5)比官方 IQ3_XXS 4K 栏参考值(61.6)高约 24%。 注意:本机没跑完
STRATA_HIP_ROUTER_OLD=1开关对照(中途被中止),所以这是观察性证据、不是受控 A/B —— 但它指向 0.1.31–0.1.34 的 AMD 线增益(#262intrinsics、0.1.32hip_router_fast)对 gfx1100 同样有效,不只是 RDNA4。另一个值得注意的现象:本机 4K→100K 没有 decode 断崖(55→76 反而更高,因为长臂 draft 接受率更高:0.85–0.94 vs bench 期间的 0.63–0.76)。论坛 7900 XTX 帖(24GB)在 32K 处断崖,归因于 MTP draft window 默认 32K。本机
--kv k8v4 --spec 3配置下未见断崖 —— 有维护者能确认 0.1.34 的 MTP draft window 默认值、以及 k8v4 会否改变它吗?三、官方 bench_prefill.py 逐笔(0.1.27 + 自校准表,条件与官方完全对齐)
4 fresh prompt(140/280/140/280 rules)+ 4 follow-up、128 max_tokens、temp 0、seed 42、
--prefill auto --kv int8 --mtp mtp/rt --expert-cache auto:kind prompt tokens fresh prefill t/s decode t/s fresh 4,210 4,210 1,085.2 55.2 fresh 8,830 8,830 1,198.0 54.7 fresh 4,210 4,210 1,177.1 56.0 fresh 8,830 8,830 1,176.9 56.4 follow-up 均值 — 248 343.8 51.9 对官方 IQ3_XXS(RTX 5070):prefill 4K 108–117%、decode 4K 90%。
四、256K 上下文(
--kv k8v4)- 160,062-token prompt 端到端:HTTP 200、154.3 s、prefill 1,043.8 tok/s、decode 57.9 tok/s
- 128K(
--kv int8)→ 256K(k8v4):decode 55.0 → 56.6(+2.9%)、prefill 1,151.4 → 1,204.4(+4.6%)、常驻专家仅 −3.1% - 300,059-token prompt 正确回 HTTP 400 ⇒ 262144 真正生效
- 官方说 k8v4「在大卡长上下文才划算」—— 本机证实:48GB 卡上几乎零代价(KV 全在 VRAM,不需要
--kv-resident)
五、四个可写进文档的发现
1. hipBLASLt 表版本闸静默吃掉 75% prefill。 仓库自带表只有 100100/100200;ROCm 7.2.4 的 hipBLASLt 是 1.2.2(100202)。版本不符只印一行 stderr(
version mismatch: file=100200 runtime=100202; using hipBLASEx)就静默退回 plain hipBLAS。修复前后:622 → 1,088 tok/s。论坛 7900 XTX 帖(ROCm 7.2.3)独立撞中同一版本;GitHub PR #170 交过 100202 表,但 0.1.33 的tools/hip/里未见。自校准命令(照贴可用):/opt/rocm-7.2.4/llvm/bin/clang++ -x hip -O2 -std=c++20 --offload-arch=gfx1100 \ --rocm-path=/opt/rocm-7.2.4 -I/opt/rocm-7.2.4/include tools/hip/tune_hipblaslt.cpp \ -L/opt/rocm-7.2.4/lib -lhipblaslt -lhipblas -lamdhip64 \ -Wl,-rpath,/opt/rocm-7.2.4/lib -o /tmp/tune_hipblaslt ARGS=$(awk 'NR>2 {printf "--case %s,%s,%s,%s,%s ", $1,$5,$2,$3,$4}' tools/hip/gfx1100-hipblaslt-100200.txt) /tmp/tune_hipblaslt --workspace-mib 32 $ARGS --tuning-out tools/hip/gfx1100-hipblaslt-100202.txt2. decode 波动的真正变因是 MTP 接受率,官方文档从未说明。 同一 server、同一 session、
decode expert cache hit rate: 100.0%(77,760/83,520 全中)之下:接受率 0.63→49.8 t/s、0.67→51.0、0.72→56.0、0.76→56.4。cache 已满分,唯一变因就是接受率。官方只说「2.4–3.2 tokens per pass」,未给接受率基准;本机 bench 期间实测 1.65–1.73 tokens/pass。建议官方速度表附各模型 draft 接受率,否则用家分不清 cache miss 同 drafting 波动。3. IQ2_XS 在本机比 IQ3_XXS 慢 30% —— 与官方表方向相反。 严格交错 A/B(同机同脚本同参数、每模型 8 次、固定 prompt 措辞):decode IQ3_XXS 54.0 ± 2.5 vs IQ2_XS 41.5 ± 0.6(IQ3 快 27–36%,跨 1K/4K/16K 一致);prefill 只差 +1.7%。我们怀疑官方 IQ2_XS 数字(78.6 @4K)出自 Swift 1.5(思考更短的微调版,输出长度分布不同)——若是,表应标注模型变体,因为用原版 Flash-Next 的人得到的是相反排名。已排除 13 项(config diff、RAM 速度、CPU 指令集、cache 命中率、draft 品质、
STRATA_NO_IQ4NL、STRATA_CPU_YMM、PR #241、PR #242 —— 后者差距反而扩大到 35.1%)。本机专家 100% GPU 驻留,STRATA_IQ_MT_MIN这类 CPU 端开关解释不了。开放问题给维护者:单 token 解码路径里是什么令 IQ2_XS 在 gfx1100 变慢?4. vision 在 gfx1100 只要 llama.cpp
GGML_HIP=ON一个 CMake flag,不是移植工程。 上游 0.1.33 仍写「no HIP encoder build yet」。本机用cmake -DGGML_HIP=ON -DAMDGPU_TARGETS=gfx1100 -DCMAKE_HIP_COMPILER=/opt/rocm/llvm/bin/clang++编tools/vision/strata_vision.cpp(llama.cpp pin3cf03257已在_deps):READY 6.0 s(CPU 版 10–30+ 分钟);每图 4,000 tokens / 5.3 s(CPU 版 480 tokens / 12 s,约 30×);峰值 VRAM +1.61 GiB(在--vram-reserve-mib 2048余裕内);OpenAI 端点图片问答端到端正确。值得上游正式化。六、参数级实证(给 FAQ)
发现 数据 --expert-cache auto不可手写手写 2048:cache 5.08 GiB、prefill 2.8 t/s; auto:42.52 GiB、6.9 t/s(差 8.4 倍)--mtp mtp/rt不可省无 MTP:decode 18.92、接受率 0.005;有:46.43、0.731(2.45 倍) --spec设计上限是 3spec 3:56.2–56.7;spec 4:53.8–54.6(用 4 反而慢) --pool-workers2→5 无改善361.4 vs 323.1 t/s;host 串流时间 ~546 ms 恒定 ⇒ 6 核 CPU 不是 prefill 瓶颈 shard 2 为四个量化共用 IQ2_XS/IQ3_S/IQ3_XXS/Q2_0 的 shard 2 SHA256 完全相同 ⇒ 硬链接每量化省 28.8 GB serve.server启动文案误导固定印「loading the experts into RAM (about 47 GB)」;30GB RAM 实际走的是 --mmap-experts路径七、吞吐参考(thinking ON,GSM8K conc 4、n=200、seed 42、greedy、max_tokens 3072)
Strata Flash-Next IQ3_XXS:190/200 = 95.0%,平均输出 394.9 tokens(含
reasoning_content),聚合 50.68 t/s。只作工作量对照,不与上面 no-thinking 速度数字混比。八、方法备注(判读本帖数字前必读)
- prefill 对比只取 fresh(0 reused) 读数;cached 臂一律作废(官方
bench_prefill.py规则)。 - 模型对模型 A/B 一律固定 prompt 措辞 + 交错量测 —— 我们曾因三种不同 prompt 措辞令同模型 decode 读数 38.0
 50.0(差 24%),此方法论 bug 已修。
- 跨卡对比(W7800/ROCm/Linux vs RTX 5070/Windows)属位置参考,不是受控 A/B。
- 0.1.31–0.1.34 的 AMD 增益本帖不作宣称,§二只是观察性证据。
欢迎维护者或大佬指定跟进项:本机可即刻跑
STRATA_HIP_ROUTER_OLD=1开/关对照(4K/16K),或钉死reasoning_effort档位重跑官方 bench 作完全对齐。 -
-
-
-
-
可以分享一下怎樣做嗎?我周未有空也可以試試


-
@Wing-Wah-Law
有96GB以上内存的可以试一试Unsloth UD-Q4_K_XL
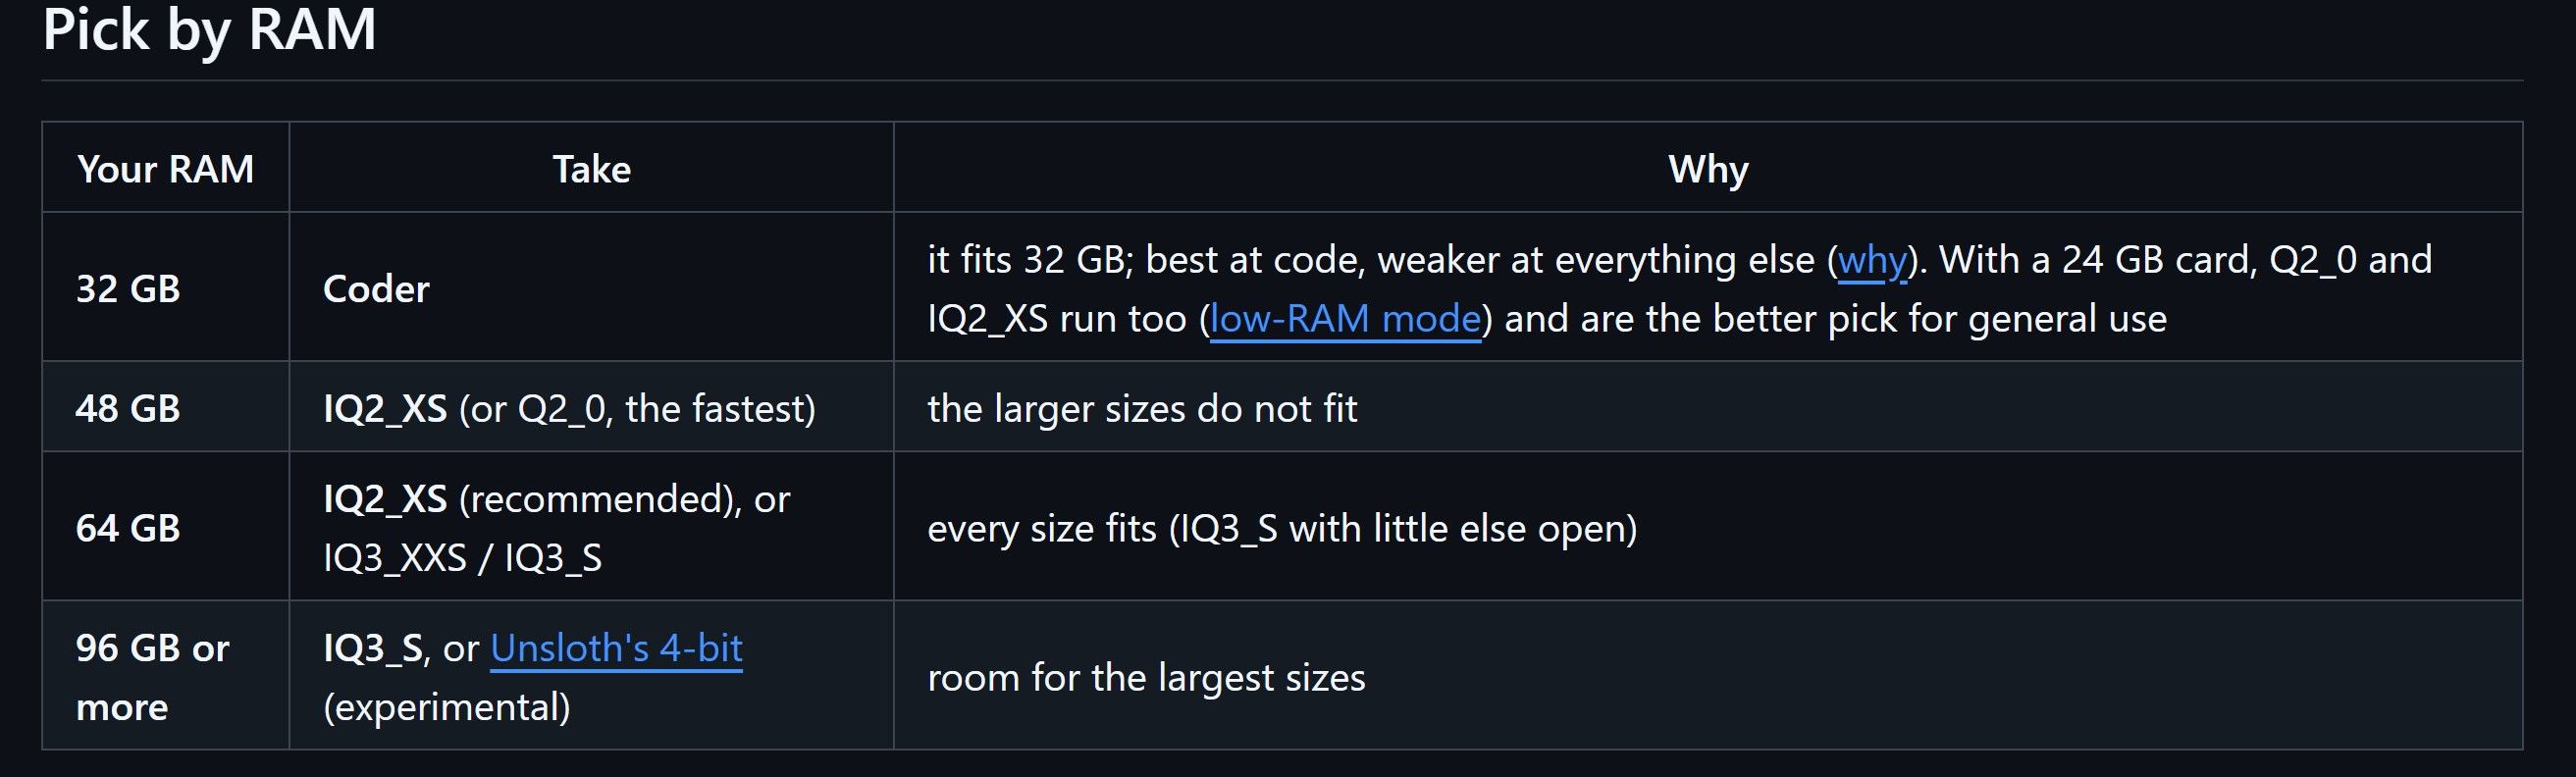
https://github.com/Niko1221/Strata/blob/main/docs/UNSLOTH_Q4.md -
@Wing-Wah-Law
有96GB以上内存的可以试一试Unsloth UD-Q4_K_XL
https://github.com/Niko1221/Strata/blob/main/docs/UNSLOTH_Q4.md



