测试7900XTX上安装strata推理框架和一些感受
-
昨天把手头上工作做个小结后,就想尝试一下qwen flash next,因为网上说的token速度要有60+,现在用qwen3.8Q4UD只有30,所以诱惑力还是很大的,所以这次测试就说说自己的想法。
配置64G内存,4060ti16g+7900xtx
这个是个人使用的win系统电脑,平时是有大量常驻软件的,而且24小时不关机的。
这次这个模型对我来说最大的瓶颈就是需要内存多,我本身软件就占了34G左右的内容存,所以使用之前要把很多浏览器和没用的软件结束掉。背景交代完,开始安装。睡觉的时候让DSH自己安装。
测试一下网页对话:
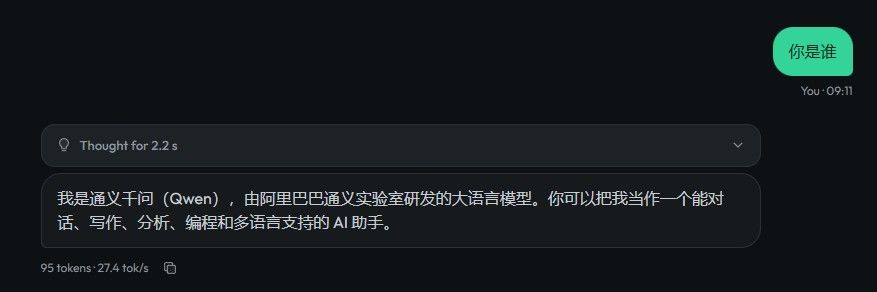
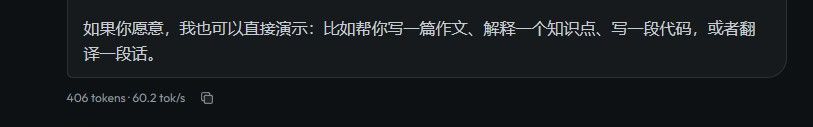
速度是比qwen3.8Q4UD快,内存占用是真的高。
我关闭模型内存占用12%,我打开模型内存占用会到60G左右,而且经常有100%
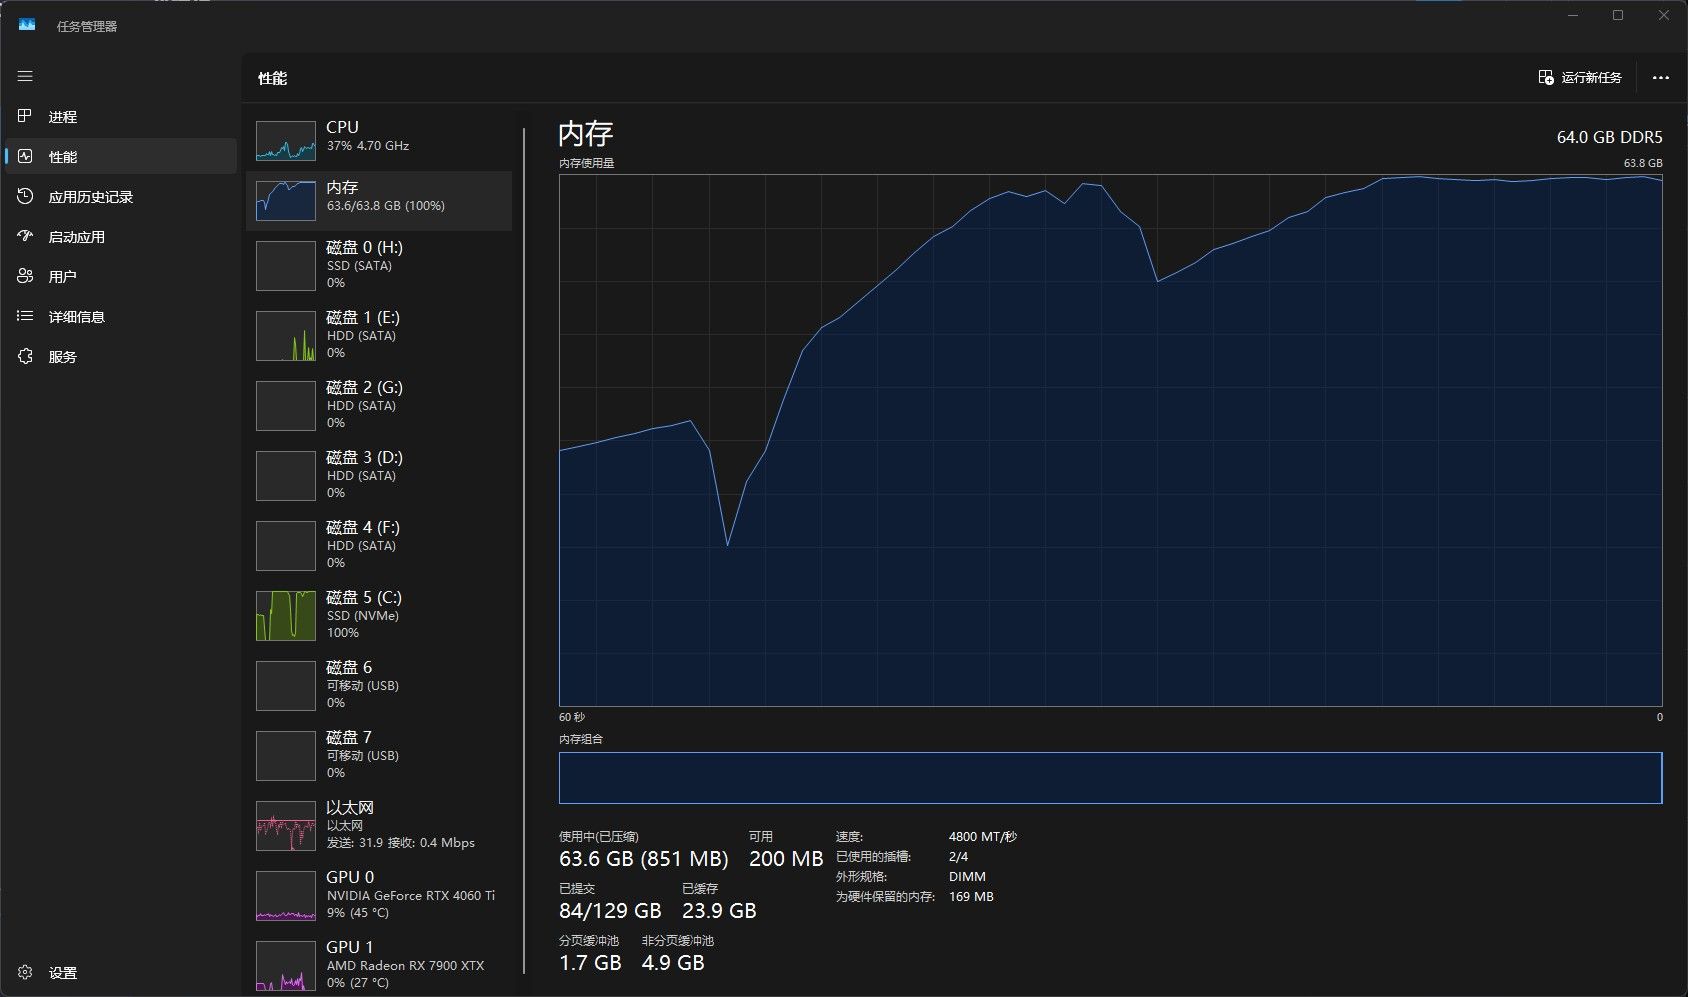
关闭模型就会爽快很多
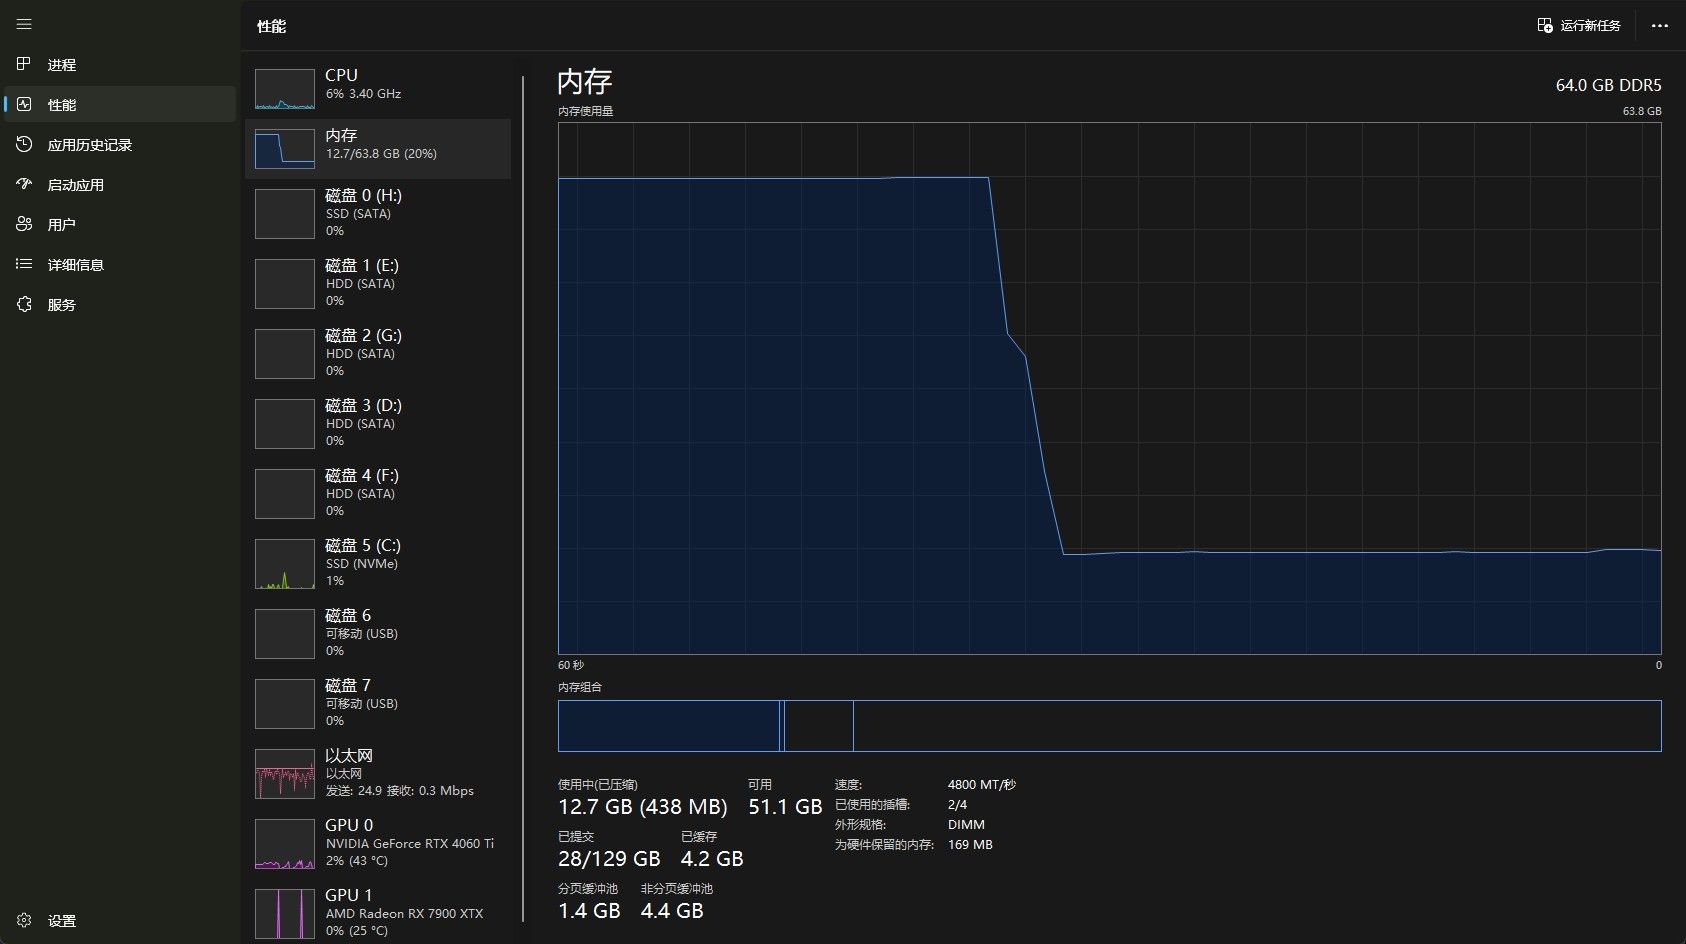
但是用qwen flash next模型会更卡,我这个机器暂时没办法测。
我还没有接到DSH上,等我把手头工作忙完不需要qwen3.8Q4的时候,我再重新测一下。
我的结论是,本身电脑需要很多常驻软件的话,这个模型不适合干活,跑的快的代价就是内存占用大,导致其他软件都不能打开抢内存。但是当服务器的话,应该是没有问题。 -
-