
Strata :Swift 1.5 IQ3_XXS (3×RTX 4090 48G,本来4张坏了一张,京东买才用了2天。。。)
-
部署日期:2026-10-03
状态:已上线运行(systemd 服务
strata.service,active + enabled)
一、需求核对与偏差
项目 原始需求 核实结论 模型名 Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ4 拼凑名,现实中不存在。真实可选的是 4 个互斥家族。已按确认实现为 Swift 1.5 + IQ3_XXS 引擎版本 Strata v0.1.31 v0.1.31 存在但过时; setup.py的MIN_ENGINE=(0,1,38)强制要求 v0.1.38硬件 3×4090 48G 准确。nvidia-smi 实测每张 49140 MiB(48GB 版 4090) KV cache INT8 --kv int8(int8 码 + 每 64 值 fp16 scale,显存减半)上下文 256K --max-context 262144,为模型训练原生长度,无需 rope 扩展命名拆解:“GSQ-RCO” 是 ISTA-DASLab 的量化方法(2 至 3.5 bit);“IQ4” 属于 Unsloth 4-bit 家族(UD-Q4_K_XL)。两者属不同家族,无法组合成单一模型(来源:huggingface.co/ukisai/Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF)。
二、环境实测
项 实测值 GPU 3× NVIDIA GeForce RTX 4090,49140 MiB/张,compute capability 8.9 驱动 580.178.04 CPU Intel Xeon Gold 6148 @ 2.40GHz ×2,80 线程,无 AVX-512(走 AVX-2 专家内核) RAM 252 GB 磁盘 / 938G,用 253G(模型+包+MTP 共约 79G) OS Ubuntu 22.04.5 LTS CUDA 13.0.88(部署时经 cuda-keyring apt 源安装) PCIe 探针 12.3 GB/s host→device,引擎据此设 pcie_frac 0.34 三、多卡模型分片方案
Strata 采用层切分(流水线并行,layer split),非张量并行。一个 token 每个验证窗口跨卡一次(数百 KB 经 pinned RAM),无需 NVLink 或 P2P。
配置采用显式三段切分(比
auto更可预测):layers 0-15 → CUDA0 layers 16-31 → CUDA1 layers 32-47 → CUDA2 (末卡另跑输出头与 MTP 草稿层)引擎启动日志实测确认:
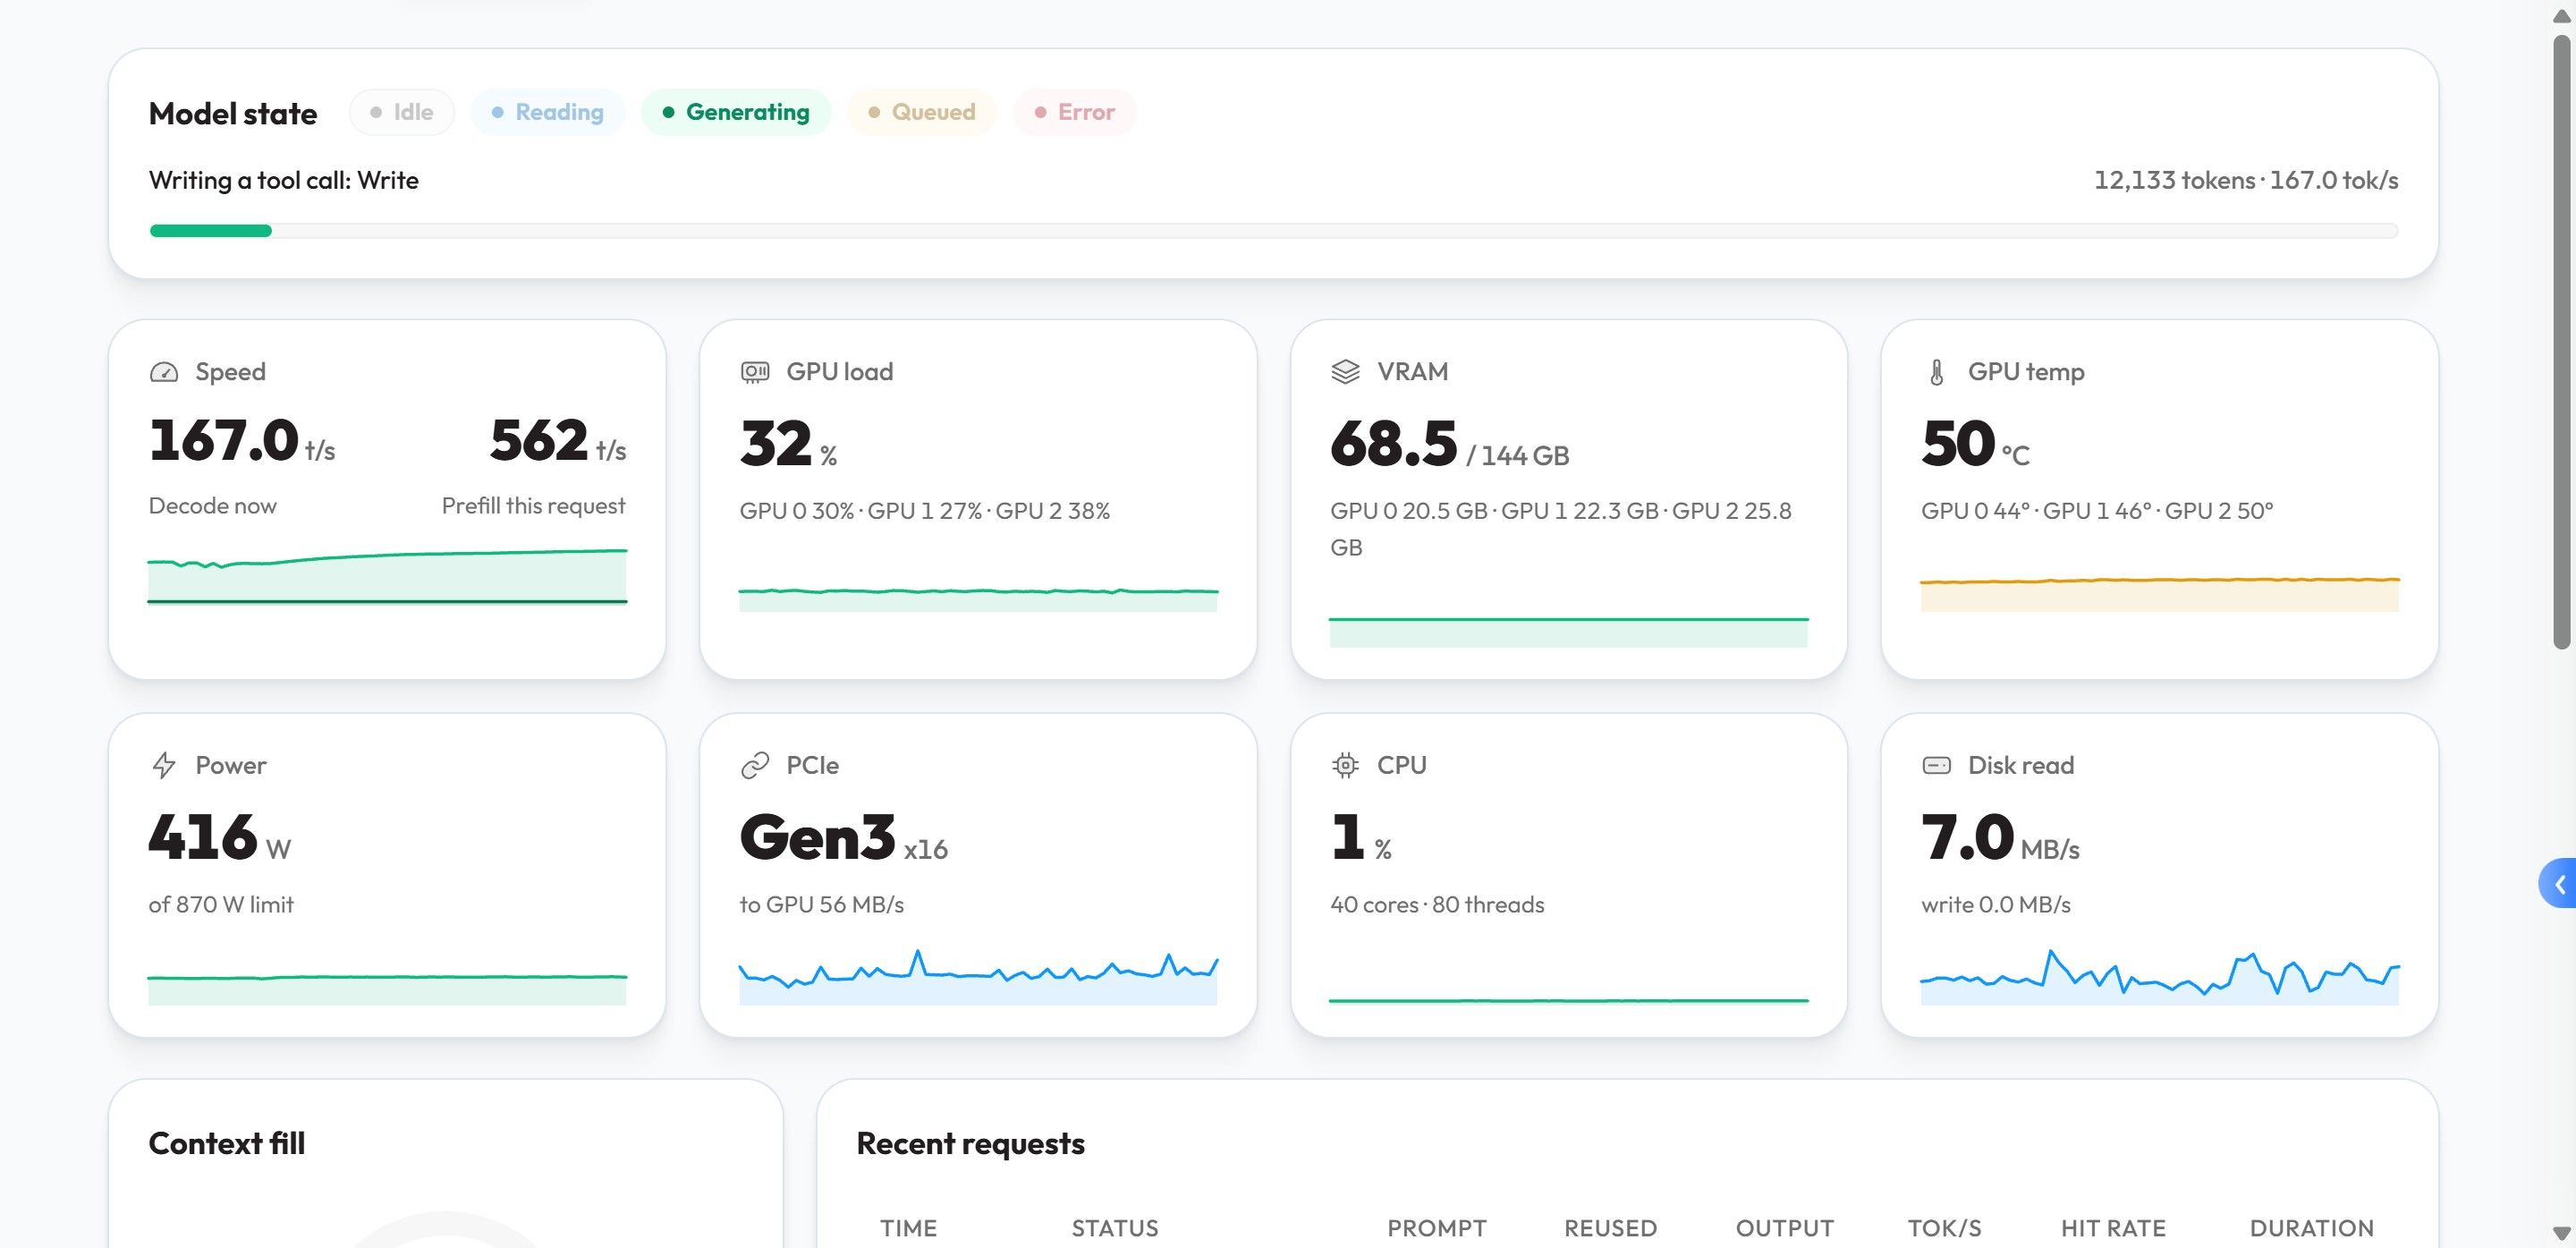
layer split: layers 0-15 (CUDA0), 16-31 (CUDA1), 32-47 (CUDA2), one hand-off per window。各卡持有:dense 权重副本、自身会话的 KV、验证窗口与 prompt 缓冲、以及仅限自身层的专家缓存。主机 RAM 持有共享的专家 arena(39.97 GiB),CPU 池计算任何卡未持有的专家。本次实测 100% experts resident,即全部专家已驻留显存,解码几乎不触 CPU 池。
注意:
--peer-device不可与--layer-split同用(源码generate.cpp:1718直接报错),二者是互斥的两种多卡模式,本方案不使用它。四、引擎核心参数
配置文件:
/root/Strata/strata-swift-iq3_xxs.json参数 值 说明 --pack/root/Strata-data/packs/swift-iq3_xxs 引擎格式包(1.5G,1079 张量,302 原生直供) --native.../Swift-...-IQ3_XXS-00001-of-00002.gguf 原生 GGUF 首分片 --ple-gguf同上 N-gram 查表(PLE) --expert-profile../data/expert-profile.bin 专家热力画像 --expert-cacheauto VRAM 专家槽位(实测 8192 专家 / 11.43 GiB) --prefillauto 预填充分块(实测 8192 tokens) --spec/--spec-min-p4 / 0.5 MTP 推测解码窗口 --mtp/root/Strata-data/mtp/rt MTP 草稿层(106299 tokens,178.4 MiB) --max-context262144 256K 上下文 --kvint8 INT8 KV cache --kv-resident32768 KV 流式:每 QSA 层 32768 cell 留显存,其余走 pinned RAM(KV 共 3.6 GB,腾出显存给专家槽) --vram-reserve-mib8192 每卡预留 8GB 显存(关键修复,见第七节) gpu[0, 1, 2] 参与分片的卡 layer_split16,32 三卡分层起点 host/port0.0.0.0 / 8080 对外监听 五、模型准备(国内网络加速)
Strata 在 Linux 上没有预编译引擎(v0.1.38 release 仅 Windows 资产),必须源码编译;同时 GitHub 大数据传输被限速、HuggingFace 直连不通。实际采用如下加速路径:
环节 常规做法的问题 实际做法 获取源码 git clone仅 ~45KB/sgh-proxy 拉 tarball,7.8 MB/s llama.cpp 源码 setup 从 GitHub 下载,不通 预先用 gh-proxy 下载并解压到 third_party/llama.cpp/CUDA 工具链 需 8-10GB cuda-keyring+ apt 装cuda-toolkit-13-0Python 依赖 慢 系统 pip 已配阿里云源 模型(70.75GiB) setup 单线程 urllib 约 2.6MB/s aria2c -x16 -s16实测 43-66 MiB/s,预下到Strata-data/models/swift-IQ3_XXS/并写.done标记MTP 草稿层(4.97GB) tools/mtp_fetch.py单线程仅 1.6MB/s复用其 mtp-inventory.json,16 线程并行 range 抓取,7.5MB/s关键点:setup 判断分片是否已下载,要求文件存在且有
<name>.done标记(setup.py:3395)。模型目录为Strata-data/models/<family tag><SIZE>,swift 家族 tag 为swift-。产物清单:
71G   /root/Strata-data/models      (2 个 GGUF 分片,70.75 GiB)
6.5G  /root/Strata-data/mtp         (MTP 张量 + 打包后的 gguf/rt)
1.5G  /root/Strata-data/packs       (引擎格式包)
39M   /root/Strata/engine/strata    (编译产物)
六、服务启动命令
systemd(当前生产方式)
单元:
/etc/systemd/system/strata.service[Unit] Description=Strata inference server (Swift 1.5 IQ3_XXS, 3x RTX 4090 layer split) After=network-online.target Wants=network-online.target [Service] Type=simple WorkingDirectory=/root/Strata Environment=HF_ENDPOINT=https://hf-mirror.com ExecStart=/root/Strata/.venv/bin/python /root/Strata/serve/server.py \ --engine strata \ --config /root/Strata/strata-swift-iq3_xxs.json \ --port 8080 Restart=on-failure RestartSec=15 LimitMEMLOCK=infinity TimeoutStartSec=0 [Install] WantedBy=multi-user.target操作:
systemctl start strata # 启动(首次加载约 1 分钟) systemctl status strata # 状态 journalctl -u strata -f # 跟踪日志 systemctl restart strata # 重启 systemctl stop strata # 停止LimitMEMLOCK=infinity必需:引擎要 pin 约 40GB 主机内存作专家 arena。手动启动(等价)
cd /root/Strata && ./run-swift-iq3_xxs.sh重新生成配置(如需改参数)
cd /root/Strata
export HF_ENDPOINT=https://hf-mirror.com
./setup.sh --setup --family swift --model IQ3_XXS \
  --context 262144 --kv int8 --vision no \
  --gpus 0,1,2 --layer-split 16,32 \
  --vram-reserve-mib 8192 \
  --host 0.0.0.0 --api-key <KEY> --port 8080 --yes --no-start
七、部署中遇到的两个关键问题
1. OOM:
native dense upload blk.26.attn_qkv.weight: out of memory现象:GPU0/GPU1 各占 45GB,GPU2 空;dense 权重上传失败。
根因:GPU0/GPU1 被现有 SGLang 服务占用(详见第八节),仅剩约 3GB 空闲。自动分片
auto把层分到了几乎占满的卡上。引擎侧诱因:
--kv-resident把 KV 移出显存后,--expert-cache auto把释放的显存全部填成专家槽,未给 dense 权重留空间。修复:
- 释放 GPU0/1(停 SGLang);
- 显式
layer_split=16,32,避免auto的不可预期放置; - 加
--vram-reserve-mib 8192,为 dense 权重与缓冲留出固定空间。
2. 显式分片优于 auto
auto会尝试所有放置并挑缓存命中最高者,但受 PCIe 探针(12.3GB/s → pcie_frac 0.34)影响会过度倾向把专家塞进显存。三卡等分(16,32)行为确定,便于容量规划。八、与现有 SGLang 服务的资源冲突(重要)
服务器原有
sglang-dflash2.service(systemd),提供Qwen/Qwen3.8-27B+ DFlash2 推测解码,TP=2,端口 30000,占用 GPU0/GPU1 各约 45GB。按确认执行了:停止并禁用该服务,三卡全部让给 Strata。
systemctl stop sglang-dflash2.service
systemctl disable sglang-dflash2.service
影响:Qwen3.8-27B 服务(30000 端口)中断,WorkBuddy 中指向
http://192.168.1.79:30000/v1的自定义模型不可用。需要恢复 SGLang 时
注意:它与 Strata 争抢 GPU0/GPU1,二者不能同时运行(除非改用单卡或重排)。
# 先停 Strata 释放显存
systemctl stop strata
systemctl enable --now sglang-dflash2.service
完整原始启动命令已保存在服务器
/root/sglang_restart_cmd.txt,同时单元文件/etc/systemd/system/sglang-dflash2.service未改动,可直接复用。九、API 使用
项 值 OpenAI 兼容 http://192.168.1.79:8080/v1(/v1/chat/completions、/v1/models)Anthropic 兼容 http://192.168.1.79:8080/v1/messages模型名 swift-1.5-iq3_xxsAPI Key sk-strata-dbd01a2eca2adc9823153870c853973bWeb 聊天 http://192.168.1.79:8080/curl http://192.168.1.79:8080/v1/chat/completions \ -H "Content-Type: application/json" \ -H "Authorization: Bearer sk-strata-dbd01a2eca2adc9823153870c853973b" \ -d '{"model":"swift-1.5-iq3_xxs","messages":[{"role":"user","content":"你好"}]}'reasoning_content返回思考过程,timings返回predicted_per_second等实测指标。十、实测性能
场景 结果 短对话解码 179.8 tokens/s( 1+1用例,draft 25/30)一般对话解码 130.2 tokens/s(draft 54/41) 27,108 tokens 预填充 4,657 tokens/s,耗时 5.82s 27K 深度解码 152.6 tokens/s 长上下文检索 从 27K tokens 中部准确取出埋入密文,通过 显存占用 GPU0 20.3G / GPU1 22.1G / GPU2 25.7G,加载完毕仍余 28.3G 空闲 鉴权 无密钥 HTTP 401 接口 OpenAI 200 / Anthropic 200 十一、运维速查
systemctl status strata                     # 服务状态
journalctl -u strata -n 50                  # 最近日志
tail -f /root/Strata/strata-swift-iq3_xxs.log   # 引擎日志(含分片与缓存命中)
nvidia-smi                                  # 显存占用
nvidia-smi --query-compute-apps=pid,process_name,used_memory --format=csv
调优候选(当前未启用):
- 显存充裕时可下调
--vram-reserve-mib(8192 → 4096 或 2048),给专家缓存更多空间; - 若显存吃紧,可把
--kv降为k8v4(INT8 K + 4bit V,816 B/cell,比 int8 的 1056 更省); - 短上下文场景可将
--kv-resident 0,令全部 KV 驻显存。
十二、来源
- 引擎仓库与发布:https://github.com/Niko1221/Strata(v0.1.38,MIT,基于 llama.cpp/ggml)
- 引擎文档:仓库内
docs/INSTALL.md、docs/MODELS.md、docs/MULTI_GPU.md - 模型:https://huggingface.co/ukisai/Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF
- 量化基础模型:https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF