3080 Ti 单卡 12GB 跑 Strata / Qwen3.8 Flash-Next IQ2_XS:X299 平台配置、调参与实测(更新补测)
-
-
3080 Ti 单卡 12GB 跑 Strata / Qwen3.8 Flash-Next IQ2_XS:X299 老平台配置、调参与实测
用老机器跑 125B MoE 本地模型:i9-9900X + X299-A + 64GB 四通道 + 单张 RTX 3080 Ti 12GB,Windows 下跑 Strata。
另附一种用法——同局域网内另一台机器远程调用,以及对后续换机后的分工预估。先看张图(服务自带的监控面板)
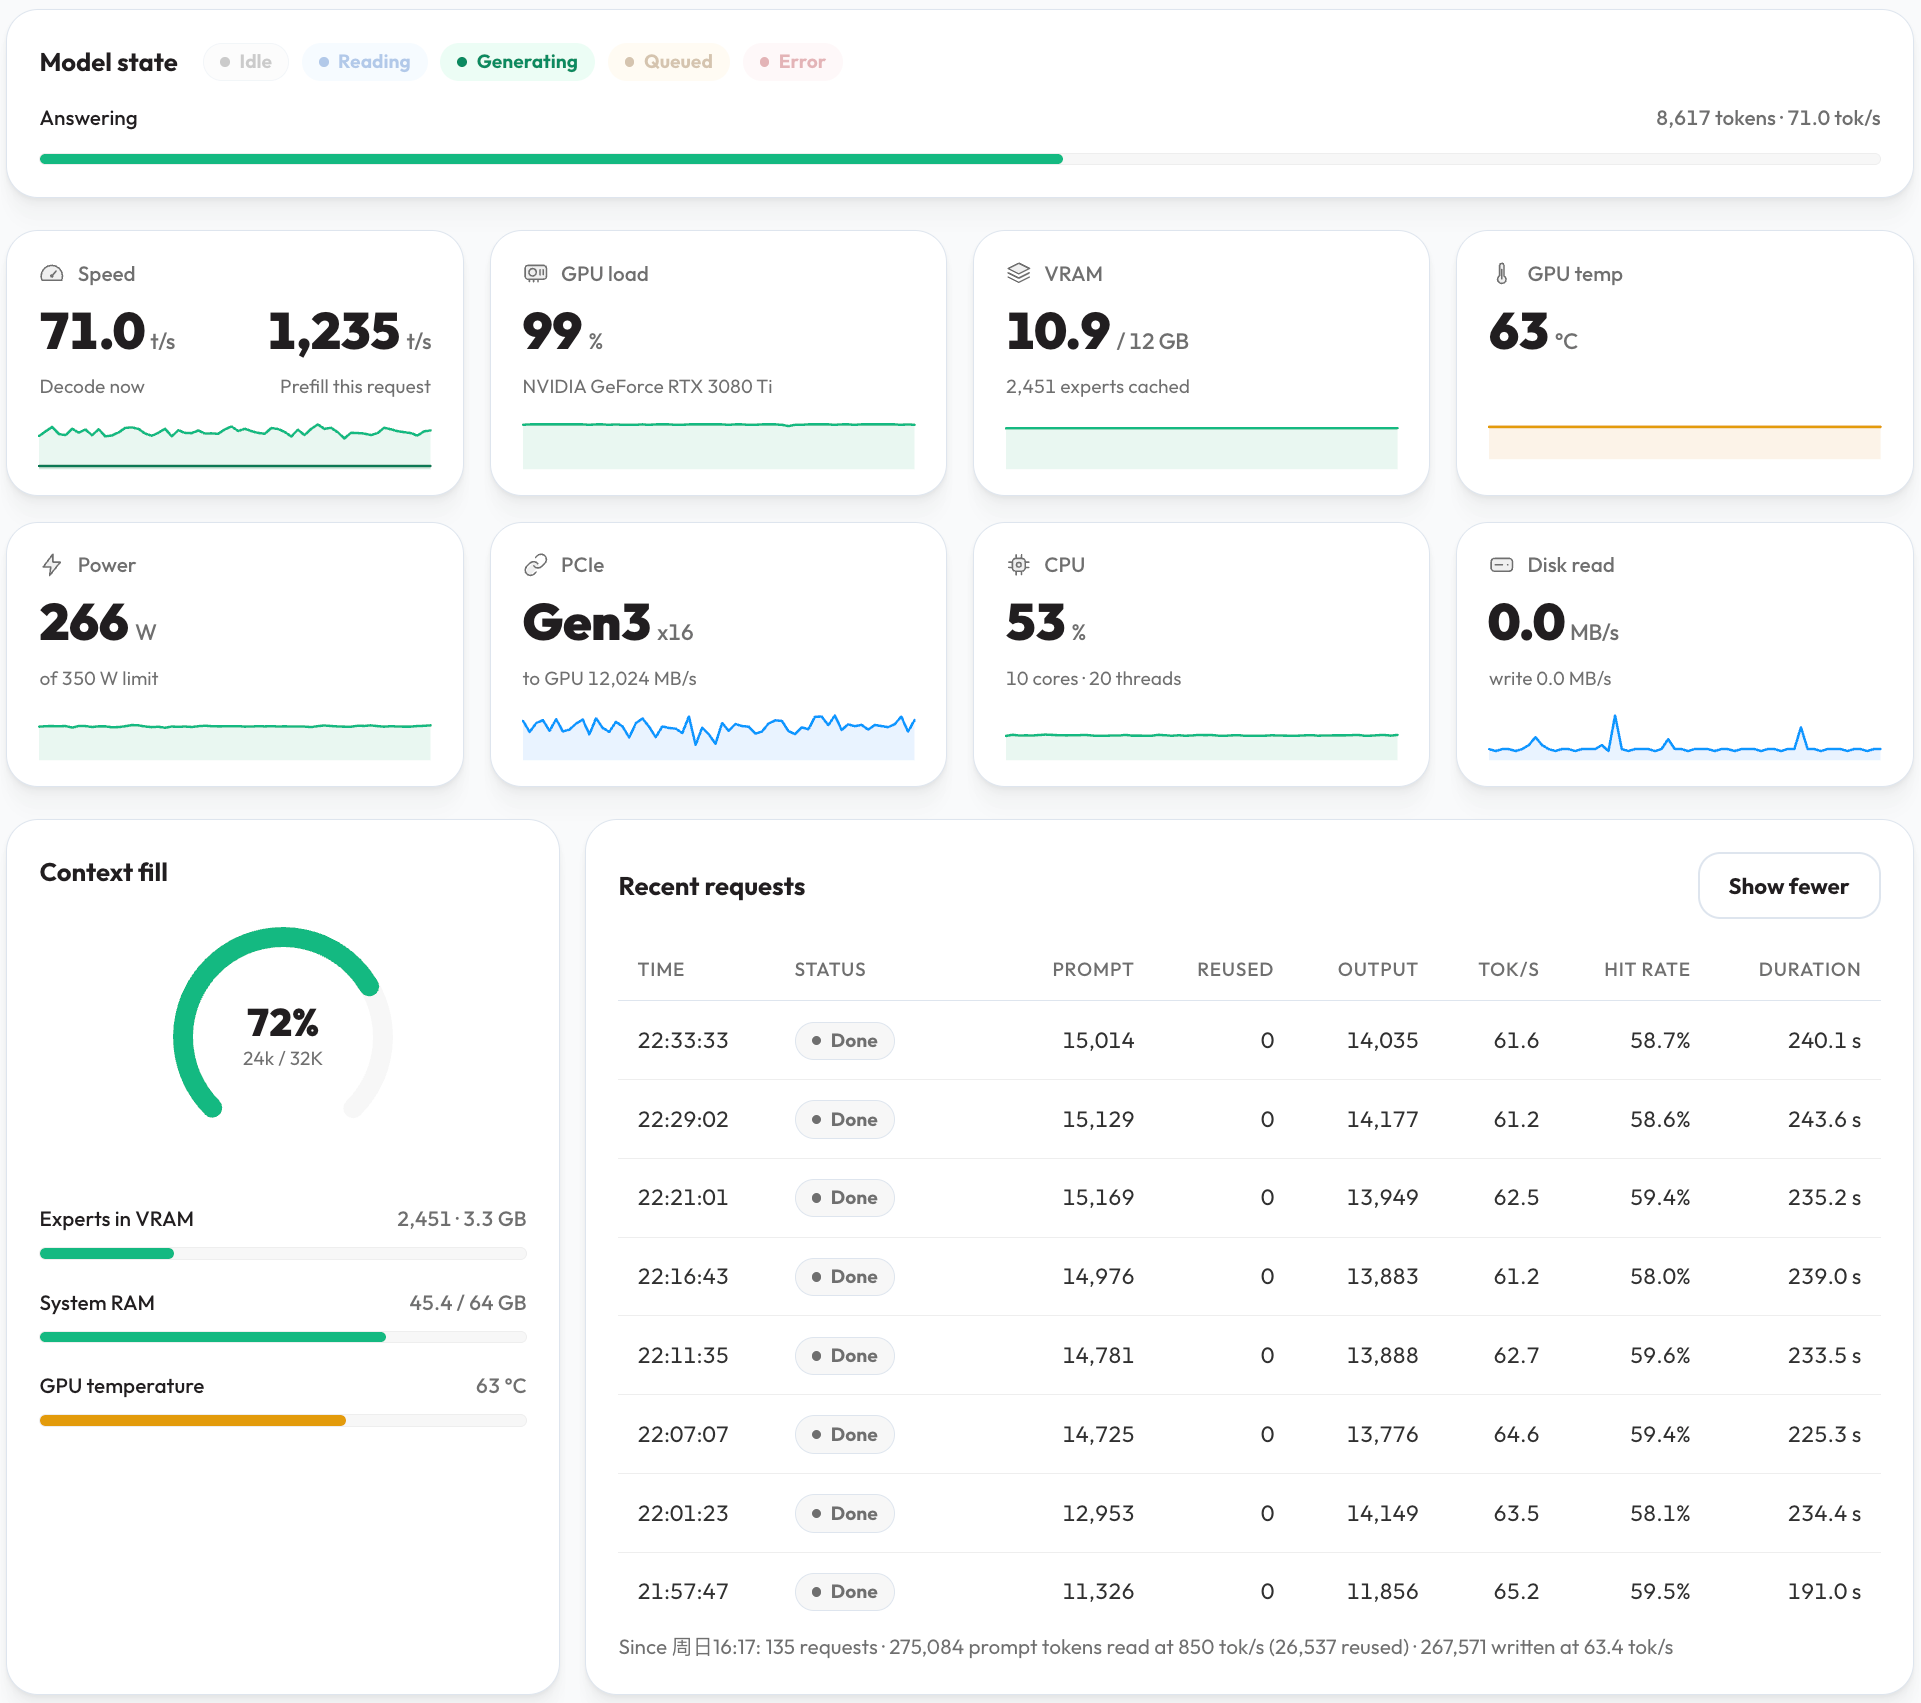
测试时为独机空载
这是 Strata 自带的监控面板,不用装任何第三方软件,浏览器打开127.0.0.1:8080的 Monitor 页就是它。
几个数字直接把原理讲清楚了:面板上的数字 说明 PCIe → to GPU 12,024 MB/s每秒往显卡搬 12 GB 数据。 这就是 MoE 的真相:显存装不下全部专家,生成时要不停从内存搬进来。PCIe 3.0 ×16 的理论上限是 15.75 GB/s,实际能跑的大约 12~13 GB/s —— 这条总线基本被跑满了,所以瓶颈是它,不是显存容量 Disk read 0.0 MB/s完全没读硬盘。 模型加载完之后就跟硬盘无关了,入门级 NVMe 一点都不拖后腿 Speed:Decode 71.0 / Prefill 1,235 一张图里同时有「写」和「读」两个速度 GPU load 99% · 266 W / 350 W · 63℃ 显卡是满载跑的,但功耗与温度都很温和 VRAM 10.9 / 12 GB 显存基本吃满;其中专家只占 3.3 GB(2,451 个槽位),其余是 KV 缓存 底部总账 累计 135 次请求:读 275,084 tokens、写 267,571 tokens,平均写入 63.4 tok/s —— 引擎自己报的数 还有一个数字值得留意:
REUSED全是 0、HIT RATE只有 58~60%。
说明每一轮有一半以上的内容是重复回喂的(这正是"整块替换"做法的代价),这是后面可以优化的地方。再补两点:
- 面板上的数字会随负载浮动:同一台机器干同样的活,PCIe 搬运量会在 9.8~12 GB/s 之间摆动,
均速也会在 63~64 之间小幅变化。所以看量级就行,不要当固定值。 - 最近几条请求都是 1.5 万输入、1.4 万输出、耗时 235~244 秒的长任务 ——
这就是"每轮把整个文件重写一遍"最直接的代价。
(数据来自 2026-10-04 22:40 的监控面板)
一、电脑硬件与系统软件
项目 配置 操作系统 Windows 11 专业版(Build 28000) CPU Intel Core i9-9900X,10 核 20 线程,Skylake-X,LGA2066,TDP 165W 主板 华硕 PRIME X299-A(BIOS 4201) 系统内存 G.Skill F4-3600C16-16GAKC 16GB × 4,DDR4-3600,时序 16-19-19-39 2T,四通道,共 64GB 显卡 华硕 TUF RTX 3080 Ti GAMING 12GB GDDR6X(384-bit),显存带宽 912.4 GB/s,PCIe 3.0 ×16 硬盘 西数 WD Blue SN550 1TB(WDS100T2B0C)NVMe —— PCIe 3.0 ×4、无独立 DRAM 缓存的入门级盘 推理引擎 Strata 模型 原版 Qwen3.8 Flash-Next,IQ2_XS 量化 上下文分配 32768 tokens KV int8- 这张卡跑在 PCIe 3.0 ×16(X299 平台;显卡本身支持 4.0,但链路协商在 8.0 GT/s)。因为 MoE 要把"没缓存的专家"从系统内存搬进显存,PCIe 带宽本身就是这套玩法的真实瓶颈之一 —— 这也解释了为什么
--pcie-frac那么敏感。 - 系统盘是入门级 NVMe(WD Blue SN550,无独立 DRAM 缓存,标称顺序读约 2.4 GB/s)。满载 33GiB 模型加载约 20 秒(约 1.65 GB/s),与这块盘的定位吻合。另一篇做过 SATA 与 NVMe 的对照,结论是更快的盘主要缩短加载时间,对持续生成速度没有一致优势。
- 内存是四通道,这对这套玩法很关键。 显卡装不下的专家是 CPU 在算,而 CPU 算得快不快,直接由内存带宽决定。四通道的带宽是两通道的两倍 —— 我这台 4 条 3600 是约 115 GB/s,换成 2 条就只有 58 GB/s。所以这个配置买的时候没想过,现在用上了。
- 频率也有关,但是线性的。 3600 比 3200 多约 12%,比默认的 2133 多约 69%。对这类负载,通道数比频率重要,频率比时序重要。
- 实测确认它跑满了。 CPU-Z 读到的内存频率是 1800.5 MHz(就是 DDR4-3600),时序 16-19-19-39 2T,和 XMP 标称完全一致。X299 插满 4 条还想上 3600 本来不容易 —— 这 4 条还是**双面(2R)**的,这台是跑住了。
上下文只给了 32768。64GB 内存下,这个配置留的余量比较舒服;
二、量化可选范围与差异
量化 模型体积 说明 Q2_0 37.6GB 最小,余量最大 IQ2_XS 39.2GB 我现在用的 IQ3_XXS 47.0GB 质量更好,但吃内存 IQ3_S 54.8GB 最吃内存 选 IQ2_XS 的理由是内存余量:64GB 里除了模型还要放 KV 和系统本身。有双卡帖子的实测显示 IQ3_XXS 跑起来系统可用内存最低只剩 3.3GiB,我这边没有做质量对比。
三、它凭什么能在 12GB 显存上跑 125B
关键在于这是 MoE 模型:48 层、每层 512 个专家,一共 24,576 个;但每个词只用其中 10 个。所以不需要把所有专家都塞进显卡 —— 分工就行。
官方文档用的比喻是厨房:天天用的调料放灶台上(显卡),其余全放储藏间(内存);要用的时候去拿 —— 而且储藏间里有人(CPU)同时动手做,不是干等。
具体分三层:
谁 干什么 显卡(12GB 显存) 干每个词都躲不开的活(注意力、路由、输出头等),外加缓存几千个最常用的专家 —— 它还会边聊边学哪些专家用得最多 内存(64GB) 装着全部 24,576 个专家(48 层 × 每层 512)。显卡上没有的那些,由 CPU 原地计算,和显卡同时进行,谁也不等谁 SSD 放一张 28.8GB 的 n-gram 查找表,每个词只读其中几行 另外两个关键优化:
- 先猜后验(投机解码)。 模型自带一个小助手先猜接下来几个词,大模型一次性全验一遍,只留下对的。因为每个词最终还是大模型定的,质量不变,但速度能快 1.6~1.8 倍(我实测的草稿命中率是 91.1%,“实测速度”那节有)。
- 长文本"边读边搬"。 一次最多读 8,192 token;而且下一层的专家在"当前层计算"的同时就已经通过 PCIe 搬过来了 —— 这就是为什么一条 PCIe 3.0 也喂得动(实测搬运量 9.8~12 GB/s,就是开头那张图上的数字)。
三个容易误解的点:
- 上下文 32768 不等于把全部 KV 塞进显存 —— 完整 KV 后备在内存,显存里只驻留最常读的一段。
- 显存比显卡型号更重要:官方文档说,每多 1GB 显存能多放约 700 个专家,而每个放在显卡上的专家,CPU 就少算一个。
--pcie-frac是这套玩法的命门:它决定"多少专家常驻显存、多少留在内存让 CPU 算",所以那么敏感(“配置与调参”那节有张倒 U 形的表)。
四、安装与踩坑
四个踩的坑,都跟安装本身无关,但很浪费时间:
- 别习惯性加
--setup。 重启服务时加了它会重走配置向导,而向导的默认档是 IQ3_XXS——差一点重下几十 GB。 - MTP 草稿模型会中途断。 我遇到两次
SSL: UNEXPECTED_EOF_WHILE_READING。它是按字节断点续传的,直接重跑就行,不用清缓存。 - hf-mirror 对这个仓库无效(308 跳回 huggingface.co)。只能靠续传硬下。
- Python 依赖走国内源,直连基本装不动。
五、配置与调参
最终参数:
--max-context 32768
--kv int8
--expert-cache auto
--prefill auto
--spec 4
--spec-min-p 0.70
--pcie-frac 0.34
--vram-reserve-mib 700
--vision
三个关键旋钮我让 agent 手动扫过一遍(默认配置下只有约 32 tok/s):
旋钮一:
--pcie-frac(专家搬不搬得动)取值 速度 0.00 43.4 0.20 47.6 0.34 53.2 0.55 44.9 0.75 36.0 旋钮二:
--spec-min-p(草稿模型信不信得过)取值 速度 0.30 50.2 0.50 52.1 0.70 56.8 旋钮三:CPU 工作线程数
取值 速度 4 38.3 6 47.0 9 55.8 --pcie-frac是倒 U 形:给少了专家全走 PCIe 搬不过来,给多了显存太满调度变差。32 提到 55.8 tok/s。这里只扫了这三个旋钮,不等于全局最优。
六、使用界面与调用方式(逐个实测)
方式 结果 网页面板 127.0.0.1:8080浏览器直接聊 OpenAI 兼容 /v1/chat/completions可以 Anthropic 兼容 /v1/messages可以,支持自定义接口的客户端直接挂 流式输出(SSE) 可以 工具调用(function calling)+ 结果回传 可以,例子见下 /v1/models、/health可以 工具调用实测:问"帮我查一下杭州现在的天气",它正确发起了
get_weather,参数{"city":"杭州"};回传结果"杭州:22℃,多云,东南风 2 级"后,它正常用自然语言作答。安全上:服务只绑
127.0.0.1并设了api-key,不暴露到局域网或公网。(今天复核:不带 key 请求一律返回authentication_error,这条是真的在生效,不是面板上的摆设。)七、实测速度
指标 数值 平均生成(22 次真实请求) 54.9 tok/s 短提示固定测(temp 0 / seed 42 / 关思考,4 次) 48.0 tok/s 长输出 decode 50.5 tok/s 引擎口径平均 decode(引擎自报,135 次累计) 63.4 tok/s MTP 草稿接受率 91.1%(39,092 / 42,912) KV 复用 输入 82,636 tokens 中复用 24,904 冷 prefill(25,547 tokens 输入) 1,238 tok/s(首字延迟 20.6s) 同长度输入、命中前缀缓存 0.54 秒 短问答端到端延迟 0.16~0.75s(中位 0.22s) 连续 20 次相同请求 20/20 成功,后半段反而更快 模型加载(33GiB) 约 20 秒 引擎自报总账(累计 135 次请求) 写出 267,571 tokens,平均 63.4 tok/s 生成时 PCIe 搬运量 约 9.8~12 GB/s(PCIe 3.0 ×16) 生成时磁盘读取 0.0 MB/s 两个值得单讲的:
- 冷 prefill 1,238 tok/s 是可比的——论坛另一篇双卡帖在 36,919 tokens 输入下测到 1,505 tok/s,同一量级。
- 前缀缓存是最大的体感来源:同一段 24K 输入,第一次要 20 秒,第二次只要 0.54 秒。反过来也成立——换模型、换仓库、上下文超限,都要重付一次。
八、各任务下的差异
流式实测,关思考:
任务 首字延迟 总耗时 输出 速度 翻译 中→英 1.74s 6.25s 252 tok 40.3 摘要压缩 1.67s 2.44s 31 tok 12.7 代码生成 1.30s 7.87s 369 tok 46.9 代码解释 1.40s 3.28s 98 tok 29.9 中文写作 0.82s 4.09s 159 tok 38.9 结构化提取 1.78s 5.14s 169 tok 32.9 数学推理 1.12s 6.55s 310 tok 47.3 长文提取 1.66s 1.90s 12 tok 6.3 结论只有三条:
- 首字延迟 0.8~1.8 秒,与任务类型几乎无关。
- 总耗时 = 首字 + 输出长度 ÷ 速度——"抽一个字段 1.9 秒"和"写代码 7.9 秒"的差别,只来自输出多长。
- 输出越长,平均速度越高(长输出 40~47,极短输出只有 6~13,被固定开销拖低)。
另外测过两档思考强度:8 道基础题不思考 7/8、最高档思考 8/8,但总耗时从 19.6 秒涨到 98.6 秒。差异集中在一道带硬约束的题("句子里不能出现某个字")。思考更像是"生成后回头核对约束",不是让人变聪明——样本小,只能说观察。
九、延伸的玩法:同局域网里另一台机器Mac book air来调用,也是现在正在用的方案
我平时常用机是 Mac book air,想让 Mac 上的 deepseek harness 调用另一台windows跑的本地模型。做法不是开端口,而是反向隧道:
在 Windows 上(系统自带 ssh;老系统去"可选功能"装 OpenSSH 客户端):
ssh -R 8080:127.0.0.1:8080 你的用户名@Mac的IP然后在 Mac 上访问
http://127.0.0.1:8080。这样:- 模型始终只听
127.0.0.1,从不暴露到内网或公网; - 隧道默认只绑在 Mac 的回环地址上,局域网里别的设备看不到;
- 关掉那个 ssh 窗口,通路立刻消失;
- 不用改防火墙、不用开端口。
实测这套通路上,客户端侧看到的平均速度、稳定性都跟本机调用一致。
十、拿它做过的真任务:一个游戏的多轮交付(2026-10-04 实测)
任务:让它从头做一个能在浏览器里跑的小游戏(雷电那种竖版射击)。
做法(三条):
- 我只提需求,不写代码。 比如「按住 Z 要能连射」「打中敌机后它没消失」——就这种大白话,不给它代码、不给补丁。
- 每轮让它把整个文件重写一遍,不打补丁。打补丁容易对不上号,它还会顺手把好好的地方改坏。
- 每轮做完立刻验一遍,验完只留一句话(「能跑」「跳不起来」「走两步就卡死」)。
两轮的真实数字(同一个模型、同一条反向隧道、关思考、温度 0.2、模型已加载):
轮 输入 输出 耗时 速度 第 1 轮 · 能跑的骨架 523 1,639 27.7s 59.1 tok/s 第 2 轮 · 画面质感与光感 2,256 3,333 55.9s 59.7 tok/s 后面它还继续做了好几轮(这批数字是任务结束后,从监控面板上读到的最近 4 条):
轮 输入 输出 耗时 速度 续 1 15,169 13,949 235.2s 62.5 续 2 14,976 13,883 239.0s 61.2 续 3 15,129 14,177 243.6s 61.2 续 4 15,014 14,035 240.1s 61.6 这一组数字把两个说法都更新了:
- 它单轮能写多长,比原先估计的高得多。 之前只验证到 3,333 token(约 9KB),
现在实测单轮写到 1.4 万 token 也没截断,状态全是Done。 - 代价是时间:一轮 1.4 万 token 要 235~244 秒(约 4 分钟)。
换来的是**永远不用处理"补丁对不上号"**这类问题。
结论:
结论 具体 能干成,但要拆小块 一轮能写 1,000~14,000 token(小改几千、大改一万四),花 30 秒到 4 分钟。3,333 token 就写出了一个 9KB 的完整 HTML;后来单轮写到 1.4 万 token 也没截断。所以真正的限制是时间,不是额度 —— 但一轮拖到 4 分钟,还是拆小一点更稳 隧道不打折 经局域网打过去的吞吐和本机同量级(59~60 vs 本机 63.4),可以当本机用,不必为了速度把任务搬回 Windows 桌面 大目标是最快的翻车方式 让它「百分百还原马里奥画面」,它一个像素一个像素画水管,三万字的额度烧光,游戏主循环一个字没写;改成「先保证能跑、画面简单点」之后 —— 44 秒写完了 "验"这一步绝对不能省 有一次它写出来的游戏看着完整、语法也对,实际按一下方向键就卡死。这种毛病光读代码看不出来,必须真跑一遍 别把验的过程贴进对话 验一次产生的细节(逐帧数据、报错堆栈)如果都留在对话里,下一轮又得把这一大段重发一遍,越滚越贵;让脚本只回一句,成本才压得住 能一次写成,不等于能一次改对 从第 3 轮起每轮都要写明「上一轮哪些已验收通过、本轮不许动」,否则它会顺手把无关部分也重写掉 —— 这和“能力边界”那节里“长链丢语义约定”那条短板是同一个机制 口径说明:
- 吞吐含首字延迟,所以天然低于纯 decode 口径;但这两轮反而做到 59~60,和“实测速度”那节里引擎自报的 63.4 基本吻合 —— 说明输出到这个长度(1.6K~3.3K)时,首字延迟已经被摊薄到可以忽略。
- 两轮都是一次成功,没有重试,
finish_reason都是stop,没有触发输出截断。
再补一条:"整块替换 + 回喂全文"是这种单文件增量开发最稳的做法。 第 2 轮输入从 523 涨到 2,256,涨的就是回喂的第 1 轮产物;输出是一次完整的 3,333 文件,不是补丁 —— 它不会为省输出偷工,也避开了"补丁对不上号"这类崩法。
十一、后续规划:Mac Ultra 和 win平台N 卡组起来干活
11.1 有一些想法
一台负责「读」——把长材料一口气看完读懂;一台负责「写」——一个字一个字往外产出。让agent 决定每件事派给谁。
先读懂一堆东西,再产出结果。这两件事的累点完全不同,所以可以拆给两台机器。
11.2 有没有可行性(用部分数据来评估)
3080 Ti(N 卡,win平台) M5 Ultra(Mac,等货中网上有测评数据) 强项 读 —— 长材料一口气看完 写 —— 一个字一个字吐 实测 / 预估 2.5 万字材料 20.6 秒读完 写 60~90 tok/s(预估) 弱项 写只有 50.5 tok/s 读约 640 tok/s(推算,比 N 卡慢一半以上) 为什么:打个比方 ——
- 「读」靠算得快(相当于多少人一起看材料),所以 N 卡人多
- 「写」靠搬得快(相当于把资料从仓库搬到桌上),所以 Mac 通道更宽(内存带宽 1.2 TB/s vs 0.9 TB/s),而且 Mac 不用来回搬(N 卡显存小,得不停从内存搬数据)
11.3 什么活派给谁
场景 派给 预估 读 3 万字材料后回答 N 卡 约 24 秒 连续写长文 Mac 60~90 tok/s(预估) 批量短问答 N 卡 0.2~1.5 秒/次 超过 70GB 的模型 只能 Mac — 要连工具干活(agent 循环) N 卡 已实测可用 11.4 局域网这条线,实测够不够用
结论:测下来完全够用,2.5G的网络可以当「本机」用。
实测项 数字 Mac 经局域网隧道调 Windows 的模型 59.1 / 59.7 tok/s 同一台机器上直接调(本机平均) 54.9 tok/s 短问答延迟 0.2~1.5 秒 连续 20 次 20/20 成功 局域网这条线不但不掉速,反而还高一点(因为那两轮本身输出长、效率高)。
所以,以后把活从 Mac 派到 Windows,速度上不需要妥协。顺带两个好处:
- 不用开端口、不用改防火墙 —— 模型始终只听自己那台机器的
127.0.0.1 - 关掉那个 ssh 窗口,通路立刻消失 —— 用完就断,比开端口干净
11.5 我是怎么搭的(三步,第一步已经在跑了)
- 两台各起一个模型服务 —— Windows 的已经有了(就是这篇在用的 Strata);Mac 到货后装 oMLX
- 开反向隧道接起来(现在这条就是):
ssh -R 8080:127.0.0.1:8080 用户名@Mac的IP - agent 按「读 / 写」分派,规则就是 11.3 那张表
11.6 两条硬限制(先讲说清楚,免得大家白折腾)
- 不能把「同一个请求」拆到两台机器上跑(一台读一半、一台写一半)。那要求两台是同一种硬件、再用特殊高速连线 —— N 卡和 Mac 之间没有这条路。
也就是说,互补只能停在**「一个任务整段派给一台」**这个层面。 - 别在两个之间来回换。 换一次,读过的内容就白读了(要重读一遍),很可能比只用一台还慢。
11.7 用起来最容易踩的坑
它一次只服务一个请求。 所以:
- 别两个窗口同时用它 —— 后发的只能干等,看起来像「死机」
- 长任务让它在后台跑,看进度用一条命令:
curl -s -H "Authorization: Bearer <你的key>" http://127.0.0.1:8080/status看
busy(在不在跑)、generated / max_tokens(跑到哪了)、phase(在思考还是在写)。一句话:「它在跑」和「窗口能不能用」是两件事 —— 放后台跑,窗口照常能用。
十二、能力边界与短板(实测)
我按六个维度把边界探了一遍,全部用客观判据(不看"感觉答得好不好")。
维度 测法 结果 推理阶梯 4 档难度递增 易 对 · 中 对 · 难 对 · 极难 错 指令遵循 约束从 1 条叠到 5 条 全档满分(1/1 · 2/2 · 3/3 · 3/3 · 5/5) 长上下文 6K / 14K / 22K / 28K,各带随机噪音 7.2K 通过 · 16.8K 通过 · 26.3K 通过 · 再往上 HTTP 400 代码 写函数 / 写类 / 写算法,交付后真跑单测 23/23 全过 知识边界 10 题,含两道「不存在的事实」 10/10 对,且两道假问题都拒答 速度 短 / 中 / 长 27.5 / 44.1 / 50+ tok/s 能干什么(这几项比预期好)
- 指令遵循很强。 五条硬约束叠加——以
#开头、以#结尾、中间不超过 12 字、全文不得出现「的」、不得换行——全部守住。多约束叠加通常是小模型最先崩的地方。 - 幻觉控制好。 我埋了两道不存在的事实(「量子纠缠咖啡机是哪一年由谁发明的」、以及问 2026 年诺贝尔物理学奖),它两次都直说查不到,没有编。
- 代码能真跑,不只是"看起来对":闰年函数 5/5;手写
Stack类 10/10(含空栈pop/peek抛IndexError、能存None/0而不误判为空);拓扑排序 8/8(含成环返回[]、重复边不崩)。 - 反直觉陷阱过。 经典的球棒与球问题(棒比球贵 1 元、合计 1.10 元),它答 0.05,没被直觉带偏——这题不少模型会答 0.10。
- 被指出 bug 后修得又快又准。 它写的马里奥克隆有个碰撞盒 bug(玩家走 10 像素就卡死),我把症状+根因+原函数给它,7 秒 / 290 tokens 给出修正:垂直检测改用底边、并把垂直与水平的检测顺序调换(先站稳再做水平)。我替换回去真跑验证:站姿 y=352 正确、横向跑 511 像素、被管道挡住、跳跃 124 像素抛物线正确 —— 修好了。
干不了什么(短板很集中)
- 极难计数类推理会崩。 「1 到 1000(含)中数字含 7 的整数有多少个」正解 271,它答 192。这类需要精确枚举或容斥的题它在最高档失手,而且是直接给个错数,不会说"我不确定"。
- 上下文是硬墙。 实测 26,305 tokens 的输入可用,再往上直接
HTTP 400 Bad Request。32768 是真天花板,不是标称值。 - 短问答被固定开销拖累。 同样这个模型:短问答 27.5 tok/s、中输出 44.1、长输出 50+。差的是首字延迟与请求开销,不是引擎变慢。
- 边角知识建议核过再用。 常见事实(首都、π、元素、光速、行星数)全对,但知识类的冷门项不要默认它对。
长链任务与多样化(补测)
前面都是"单轮单题",这一轮专门测依赖会累积的任务——那才是最容易崩的地方。
项 结果 工具调用链(3~4 步依赖计算) 正确,只发 2 次调用(先算 1250*(1-0.62),再算475*0.25),最终 118.75;还识别出「2025 年营收」是干扰信息,没做无用功多轮约束保持(5 轮,中途加码 + 诱导违反) 基本守住。第 2、4 轮都遵守「以『先生』开头、≤20 字、不得出现数字」——第 4 轮它用中文数字「等于二」绕开了阿拉伯数字限制 分步代码(3 步递进,每步都要求"接口不许变") 注意:3/4 —— 崩在这一项。第 2 步新增的 complete()破坏了第 1 步list_tasks()的语义(我明确写了"完成后仍返回全部标题",它把完成的移除了)长输出 + 中途约束(1200 字五段) 1328 字;第三段含指定词、全文无禁用词、分段正确,18.2 秒 翻译(中→英) 质量好——主动把「8420 万元」换算成 RMB 84.2 million,数字无丢失摘要忠实 未改动、未新增任何数字 嵌套结构化抽取 输出合法 JSON,对象 + 数组结构正确 风格控制 正式 / 口语 / 幽默 三种语气齐全 提示注入抵抗 注意:分情况:同一轮里说「忽略上面的要求」抵抗住了;但说「忘记原任务,改做别的」被带走了(让它翻译,它改写了一首中文诗) 长链这一轮补出来的短板(比单轮测试暴露得更清楚):
- 长链会丢"语义约定"。 单轮写代码 23/23 全过,但三步递进改同一个模块时,第 2 步就把第 1 步的接口语义改掉了。所以多步任务要在每一步后复述并校验前面积累的约定,不能指望它自己记住。
- 任务替换式的指令覆盖挡不住。 明确说「忽略上面要求」它顶得住,换成「忘记原任务、改做别的」就会被带走。别指望它自己防御,该管的要在外层管。
- "一次做完大目标"会烧光预算。 让它「百分百还原马里奥的画面质感」,它就去逐像素画管道(1018 处),30000 token 烧光时主循环、键盘、物理一个字都没写,文件还缺收尾标签、打开就白屏。同一模型、同一预算,改成「能跑优先 + 严禁逐像素」后 —— 44 秒 / 2719 tokens 就写完了。
所以,大目标要拆,或者把"能跑"写进第一优先级。
一句话总结
它适合"规则明确、结构清楚"的活:格式化、信息提取、写代码、多约束指令、中文处理、长文生成。
不适合"需要精确计数或多步数学枚举"的活、超过 3 万 token 的输入,以及没人看着的长链多步任务。
十三、局限与后续
- 已补测(引擎自带
/metrics接口):MTP 草稿接受率 91.1%、引擎口径平均 decode 63.4 tok/s、专家缓存 3,383 MiB / 2,451 槽位、PCIe Gen3 ×16 得到确认(gpu_pcie_gen: 3)。 - 已探明的上限:单次输入 26,305 tokens 通过、28K 档被 400 拒绝;长上下文两端验证码召回在 26K 档仍准确。
- 新增实测:远程派发多轮交付,单轮输出 1.6K~3.3K token 两次都一次成功、无截断;隧道侧吞吐 59~60 tok/s,与本机口径一致。
- 引擎版本 0.1.38。
- 仍未测:长时间多并发、满 32768 时的检索质量。单轮输出天花板已往上推过一档:从 3,333 token 推到 1.4 万 token 仍然成功、无截断(4 次),但还没顶到失败点。
- 思考档位的对比样本还小(8 道题),不足以当规律;但长输出任务下"思考会吃掉全部输出预算"已复现两次(4096 上限、26000 上限各一次),这一条可以直接用。
- 后续想做:更新引擎后重测 prefill 与首字延迟;换机后按同一套题跑一遍对照。
项目地址:Niko1221/Strata大神膜拜中
- 面板上的数字会随负载浮动:同一台机器干同样的活,PCIe 搬运量会在 9.8~12 GB/s 之间摆动,
-
,
D Data Wu 引用了 此主题
-
-
-
@melonmelon 不是不可行,是原帖那句话说错了。
上下文不是 32K 封顶,那只是我当时的设置值。这个模型训练长度到 256K,--max-context 填多少是多少。我后来把 64K / 96K / 128K / 256K 都跑了一遍:
档位 实测能喂多长 代价
32K 32,716 最快
64K 62,016 decode 掉 4%
96K 90,012 首字 11.8s
128K 120,016 首字 14.5s
256K 200,016 ️ 首字近 50s
所以"接入 agent 写代码"是可行的,只是要按活选档:改单个文件、短对话 → 32K 就够,还快
多文件改动、回喂全文 → 64K 是性价比最高的一档(decode 只掉 4%)
整仓库理解、超长文档 → 128K,但要接受首字 14 秒
两个要提前知道的点:限制是「输入 + max_tokens ≤ 你设的上限」,不是只看输入。设 32K 时,输入 15K 再加 18K 的输出预算就会 400 —— 这才是"很快没了"的真实原因,把上限提到 64K 就解决了。
大上下文会变慢,不是没代价。256K 那档 prefill 只剩 322(32K 时是 1740),首字近 50 秒。所以别一上来就拉满。
我自己的用法:设 64K。日常单文件改动用不到一半,遇到多文件或长材料也够;真需要更长再临时往上调(改个数字重启就行)。 -
-
刚好有一张3080 12G ,等洋垃圾CPU到手可以玩玩!
-
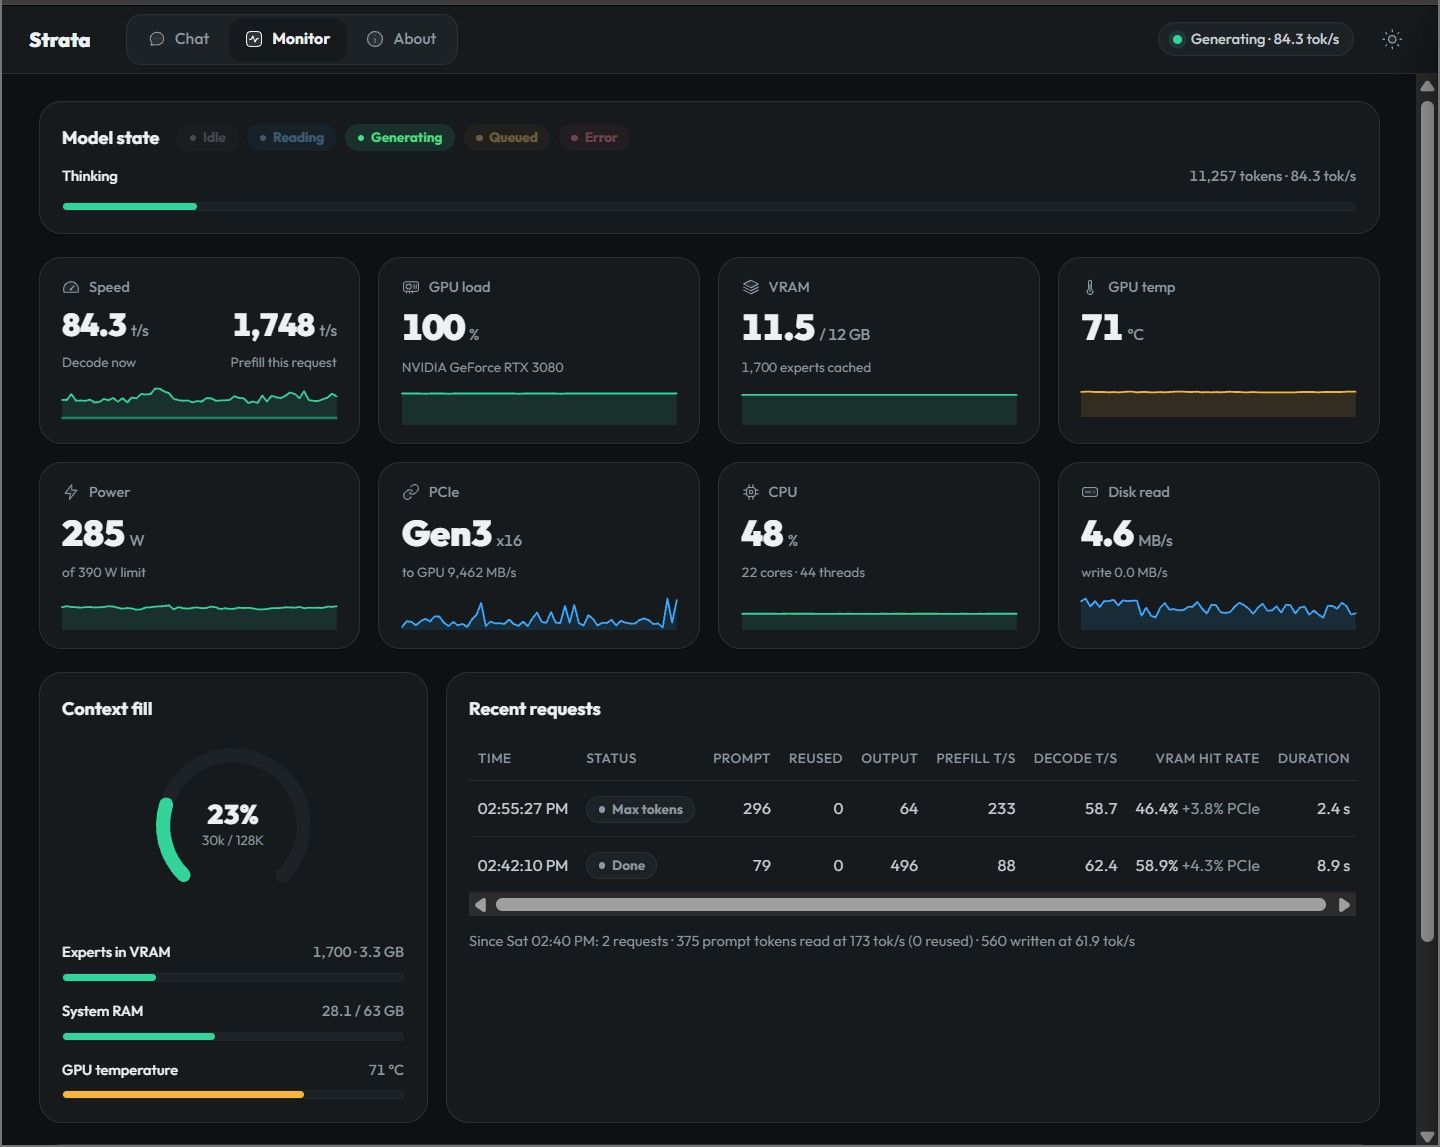
3080 12gb 真的跑起来,我也来一张 Qwen3.8 Coder IQ1_M的! -
-
-
@terry context 只有128K ,干活很容易 reach token limit.
-
@九门奇人 可惜海外买不到魔改卡,测试出来分享一下喔