3080 Ti 单卡 12GB 跑 Strata / Qwen3.8 Flash-Next IQ2_XS:X299 平台配置、调参与实测(更新补测)
-
-
-
@melonmelon 不是不可行,是原帖那句话说错了。
上下文不是 32K 封顶,那只是我当时的设置值。这个模型训练长度到 256K,--max-context 填多少是多少。我后来把 64K / 96K / 128K / 256K 都跑了一遍:
档位 实测能喂多长 代价
32K 32,716 最快
64K 62,016 decode 掉 4%
96K 90,012 首字 11.8s
128K 120,016 首字 14.5s
256K 200,016 ️ 首字近 50s
所以"接入 agent 写代码"是可行的,只是要按活选档:改单个文件、短对话 → 32K 就够,还快
多文件改动、回喂全文 → 64K 是性价比最高的一档(decode 只掉 4%)
整仓库理解、超长文档 → 128K,但要接受首字 14 秒
两个要提前知道的点:限制是「输入 + max_tokens ≤ 你设的上限」,不是只看输入。设 32K 时,输入 15K 再加 18K 的输出预算就会 400 —— 这才是"很快没了"的真实原因,把上限提到 64K 就解决了。
大上下文会变慢,不是没代价。256K 那档 prefill 只剩 322(32K 时是 1740),首字近 50 秒。所以别一上来就拉满。
我自己的用法:设 64K。日常单文件改动用不到一半,遇到多文件或长材料也够;真需要更长再临时往上调(改个数字重启就行)。 -
-
刚好有一张3080 12G ,等洋垃圾CPU到手可以玩玩!
-
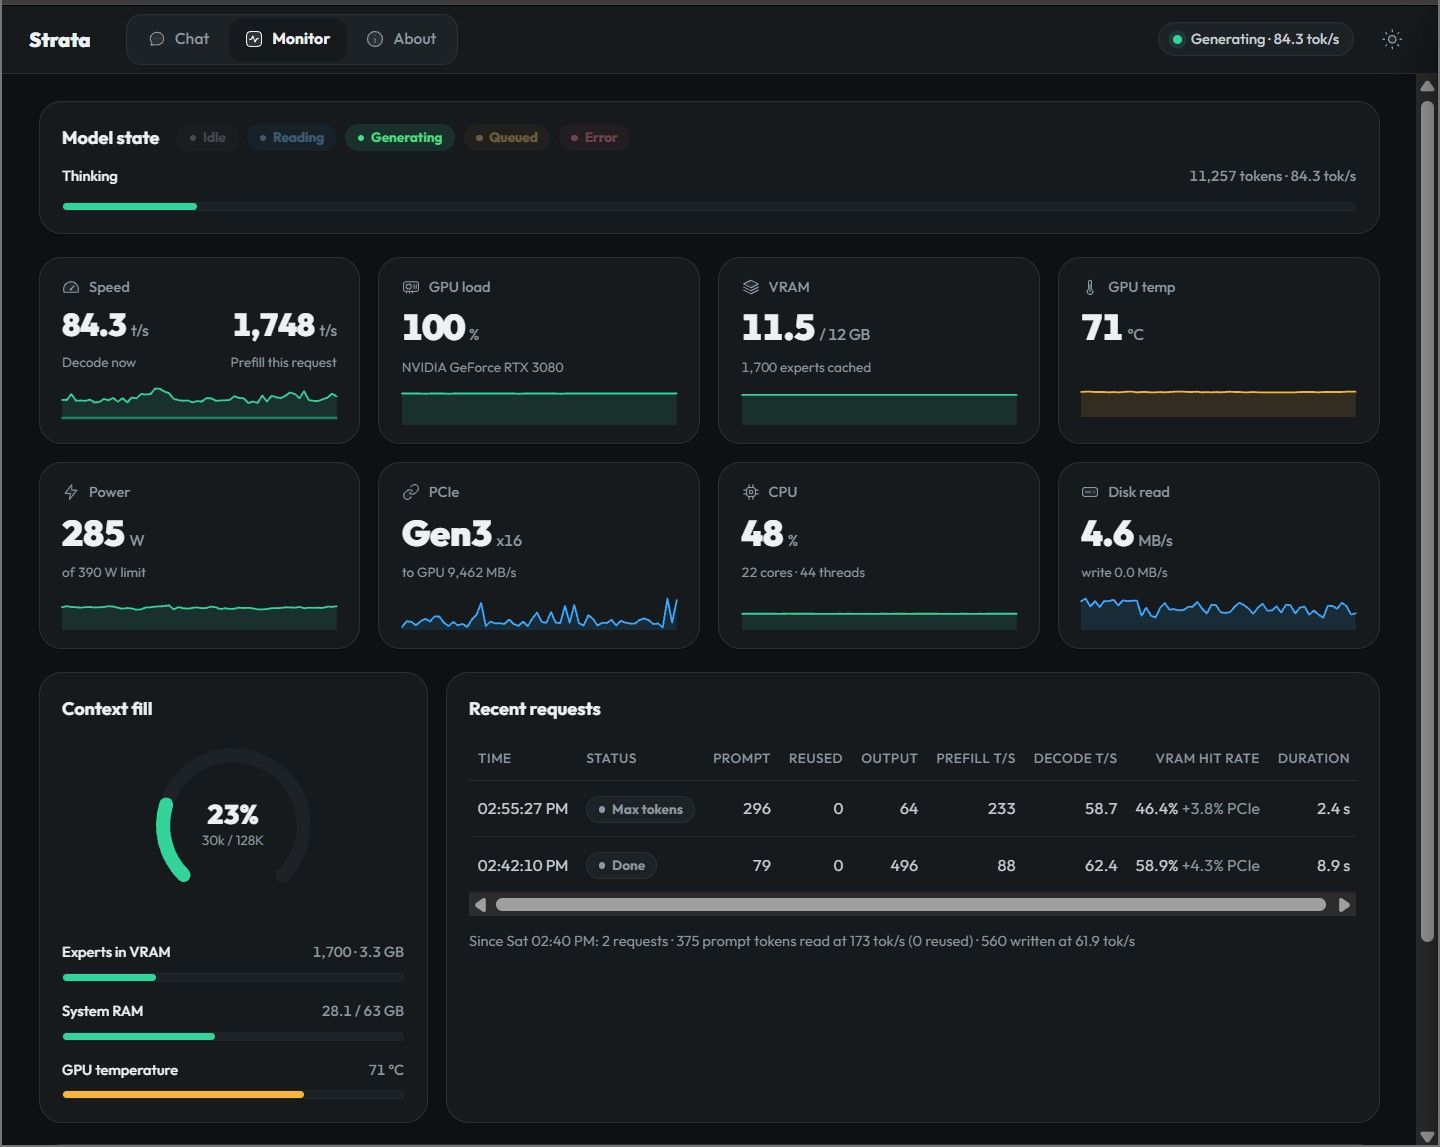
3080 12gb 真的跑起来,我也来一张 Qwen3.8 Coder IQ1_M的! -
-
-
@terry context 只有128K ,干活很容易 reach token limit.
-
@九门奇人 可惜海外买不到魔改卡,测试出来分享一下喔