
六爺再次披甲上陣 # 用雙 RTX 3060/12GB 跑 Strata Qwen3.8 Flash Next IQ3_S:硬體清單、256K上下文,實測速度約50上下tok/s
-
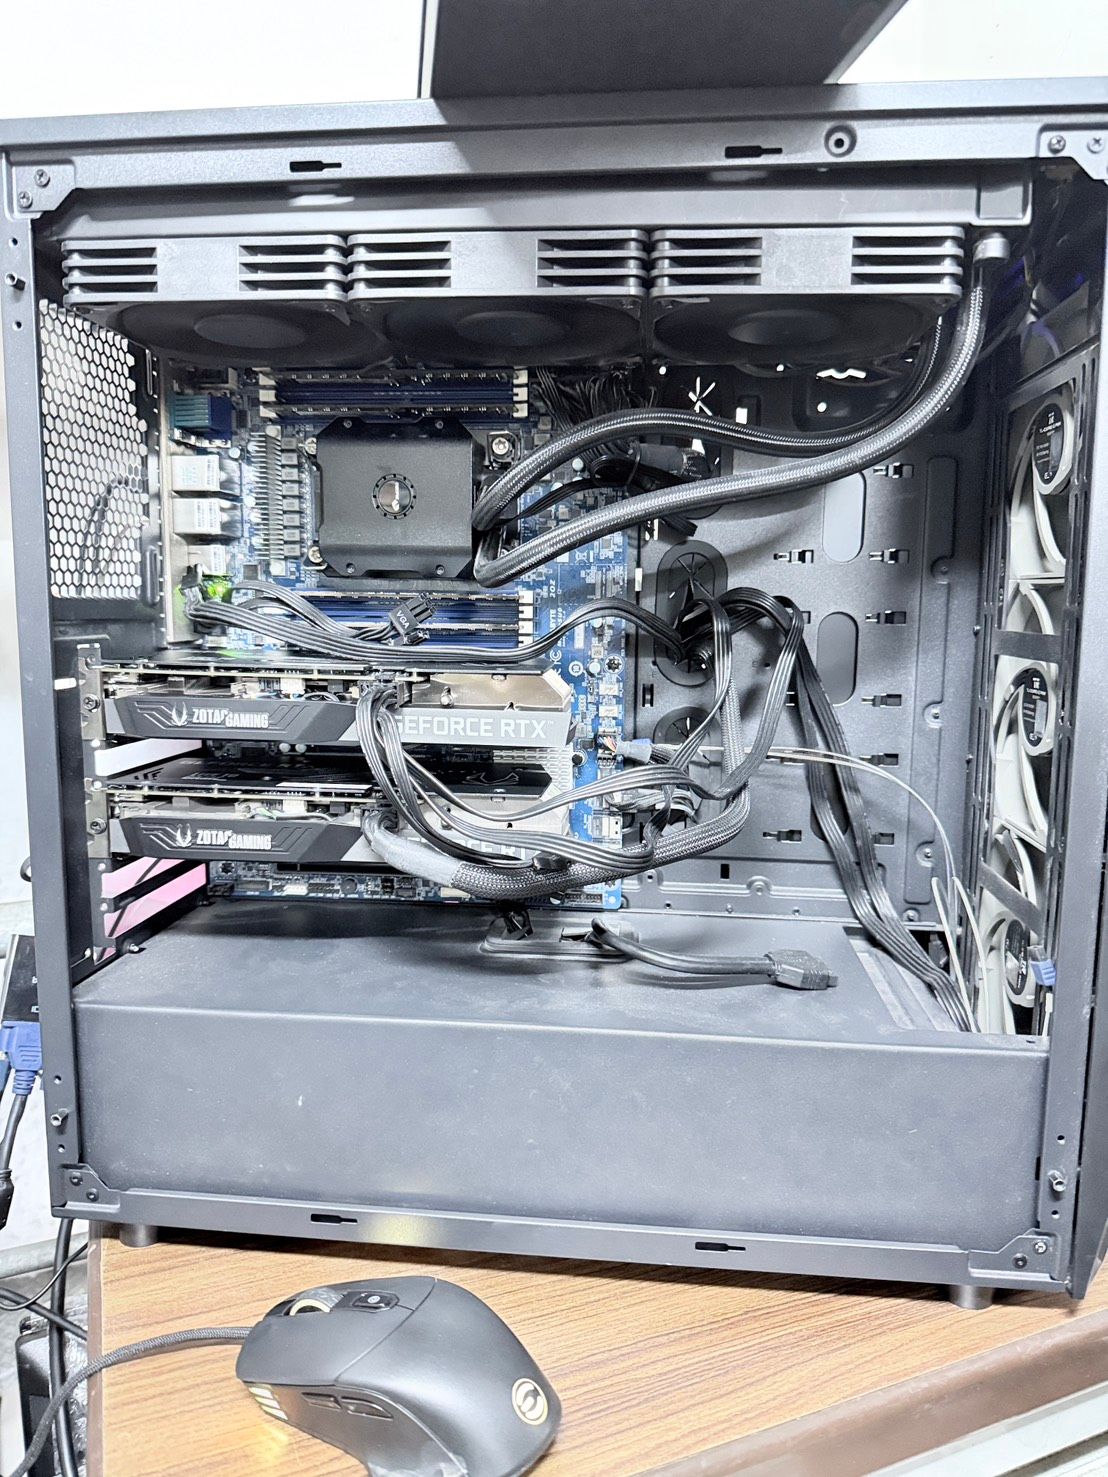
潛水太久了,看大家都再玩strata,這次請出六爺再次披甲上陣用雙 RTX 3060/12GB 跑 Strata Qwen3.8 Flash Next IQ3_S:硬體清單、實測速度約50上下tok/s
**測試日期:**2026-10-07
**文章目的:**分享一套本機可重現的 Strata 設定,並用實測說清楚推理速度受到哪些硬體影響。
**測試範圍:**Qwen3.8-Flash-Next IQ3_S,沒有測 Q2_0。本文數字只代表這台主機和這些 prompt,不是所有 RTX 3060 或所有模型都能得到的保證值。先看答案
- 這台機器最快的已測設定,是兩張 RTX 3060 一起跑,context 256K、KV int8,並把
--pcie-frac設成0.20、--spec-min-p設成0.70。 - 短 prompt 的 decode 校準中位數從 43.3 升到 54.3 tok/s(約快 25%)。同一份 235K prompt 的長上下文對照,decode 從 38.2 升到 41.8 tok/s(約快 9.4%);prefill 幾乎沒有變化。
- 同一份 120K prompt 改成單卡 128K,反而比雙卡 128K 慢:單卡總耗時 124.1 秒,雙卡 70.6 秒。
- 目前最明確的限制是顯存容量與 expert-cache(專家快取)/PCIe/CPU 的分流。這次沒有測到 GDDR6 的實際 GB/s,不能說顯存頻寬已經跑滿。
1. 測試主機:完整硬體清單
以下列出這台推理主機中,已實際核對的硬體和版本;沒核對到的欄位明確標示,不用猜測補上。
部件 本次核對結果 主機板 GIGABYTE MU72-SU0-00,Intel C621A,單路 LGA4189;主機板有 8 個 DDR4 DIMM 插槽,支援 8 通道 ECC Registered RAM(具錯誤更正的暫存式記憶體)。GIGABYTE 主機板規格 CPU Intel Xeon Ice Lake-SP 世代,38 核心 / 76 執行緒,單一 NUMA node(記憶體區域節點),有 AVX-512。 lscpu的商品名稱只回報Genuine Intel(R) CPU 0000%@,因此確切 CPU 型號未能確認RAM Linux lsmem顯示 128 GiB online。實際 DIMM 數量、廠牌、速度及目前啟用幾個記憶體通道未重新核對;「主機板支援 8 通道」不等於目前已啟用 8 通道GPU 2 張 NVIDIA GeForce RTX 3060 12GB,CUDA index 0、1;GPU 0 的 PCI bus 是 0000:51:00.0,GPU 1 是0000:c3:00.0。兩張卡的 power limit(功耗上限)各 170W;桌面主顯示卡在 GPU 1GPU 連線 推論負載期間 nvidia-smi取樣顯示兩卡各為 PCIe Gen4 x16;兩卡間nvidia-smi topo -m顯示NODE(經同一 NUMA node 的 PCIe / host bridge 路徑),沒有 NVLink 標記。閒置時 PCIe 連線世代可能省電降速顯存規格 一款 GIGABYTE RTX 3060 12GB 板卡列出 GDDR6、360 GB/s 名目頻寬;這是該型號規格,不是本次實測的顯存 GB/s。GIGABYTE RTX 3060 規格 其他顯示裝置 主機板上的 ASPEED AST2600 BMC 顯示裝置,PCI 0000:06:00.0;Strata 推理使用兩張 NVIDIA GPU有線網路 主機板規格有 2 × Intel I210-AT 1GbE 網路埠和獨立 BMC 管理埠;Strata 僅綁 localhost 127.0.0.1,網路介面不在本次 GPU 推理計算路徑上。GIGABYTE MU72-SU0 規格SSD MSI M450 1TB NVMe SSD;Strata/Qwen 資料位於本機 NVMe。測量當時根分割區約 916GiB,剩餘約 31GiB 作業系統 Ubuntu 24.04.4 LTS,Linux kernel 7.0.0-34-generic,x86-64 NVIDIA 軟體 Driver 595.84; nvidia-smi顯示 CUDA Version 13.2,這是驅動相容版本,不代表引擎用 13.2 編譯。Strata 本機建置紀錄使用 CUDA Toolkit 12.0Strata v0.1.40.1,commit 82f46a8,引擎 v0.1.40,Python 3.12.3。Strata v0.1.40.1 release電源 / 散熱 電源供應器型號、CPU/GPU 散熱器與機殼風道未量測;本文不推論是否有供電或散熱限制 整機功耗 使用者補充:待機約 200W,雙卡全速推理約 500W。此為整機觀測值,量測位置/工具未註明;不是 nvidia-smi的單卡功耗讀值**RAM 與安裝空間注意:**本機辨識到 128 GiB RAM,但 DIMM 插法和實際記憶體頻寬未知。Strata 官方將 96GB 以上列為 IQ3_S 建議區間;本次安裝的 IQ3_S 兩個模型 shard 約 83.6GB,還有 pack、MTP 草稿資料與其他檔案。新安裝建議預留約 90–100GB SSD 空間。當時這台 SSD 剩 31GB,所以是沿用已安裝的模型做測試,不是重新下載。 Strata 安裝指南
2. 新手名詞小抄
- MoE(Mixture of Experts,混合專家模型):模型中有許多「專家子網路」,每個 token 只啟用其中一部分。Qwen 官方模型卡列出這個模型總參數約 125B、啟用參數約 6B;每個 MoE 層有 512 個 experts,每個 token 使用 10 個 routed experts 和 1 個 shared expert。Qwen 官方模型卡
- Expert(專家):MoE 裡負責計算的一組權重。
- Expert cache(專家快取):顯卡記憶體先存常用 experts;沒存到的叫 cache miss(快取未命中)。Strata 說多 1GB VRAM 約能多留 700 個 experts,但實際收益依模型和 GPU 而異。Strata 架構說明
- VRAM / 顯存容量:GPU 上能放多少模型資料、expert cache 和 KV cache。
- GDDR 顯存頻寬:GPU 核心從顯存讀寫資料的傳輸規格;和「顯存容量」不同。
- PCIe:CPU/主機 RAM 和 GPU 之間的連線。未命中 expert cache 的權重可以留給 CPU 算,也可以用
--pcie-frac把一部分送到 GPU 算。 - KV cache(Key/Value 注意力快取):模型保留已讀 token 的注意力狀態,不是模型權重。
- Prefill(提示詞讀入):讀取 prompt、系統提示與對話歷史;主要影響第一個 token 要等多久。
- Decode(逐 token 生成):模型一個 token 接一個 token 寫答案;常用 tok/s 表示每秒 token 數。
- MTP(Multi-Token Prediction,多 token 預測):草稿層先猜後續 token,再由主模型驗證。
- Layer split(模型層切分):一張卡跑模型前段層,另一張卡跑後段層;兩張卡不是合成一塊可互換資料的 24GB VRAM。Strata 多 GPU 文件
3. Strata 怎麼使用這台電腦
Qwen3.8-Flash-Next 有很多 experts,全部放不進一張 12GB 顯卡。Strata 把完整 experts 放在主機 RAM,顯存保存常用 experts;遇到沒駐留在 GPU 的 expert 時,CPU 可直接由 RAM 計算,也可依
--pcie-frac把一部分 misses 透過 PCIe 交給 GPU。GPU 顯存還要放共同模型層、KV cache、MTP 和 prompt 暫存區。Strata How it works雙卡 layer split 時,每張卡各有自己 layer 的 expert cache。Strata 文件說 token 在兩卡間是每個 verify window(草稿驗證批次)交接一次小量資料,不是每一層都來回搬。因此兩卡的主要價值是分攤模型層、增加總 expert cache;不需要假設有 NVLink 才能工作。Strata Multi-GPU 文件
4. 新手安裝與設定:一步一步照做
以下是 Linux 新安裝範例,固定使用本次測試的 Strata 版本和 IQ3_S。模型下載前先確認 SSD 有約 90–100GB 可用空間:
git clone --depth 1 --branch v0.1.40.1 https://github.com/Niko1221/Strata.git cd Strata ./setup.sh --family qwen --model IQ3_S --context 262144 --gpus 0,1 --vision no --no-start --yesnvidia-smi會列出你的 GPU index(編號);若不是 0、1,請把--gpus換成自己的編號。Windows 用官方START-HERE.bat回答同樣選項即可。setup 顯示的 RAM 警告要照做:官方資料指出 64GB 上的 IQ3_S 256K context 可能接近記憶體限制,建議依 RAM 選較小 context。Qwen 模型原生 context 是 262,144 tokens。Strata setup flags Qwen 官方 context 規格修改設定前先備份
在 Strata 目錄先備份 setup 產生的 JSON:
cp -a strata-iq3_s.json "strata-iq3_s.json.bak_$(date +%Y%m%d_%H%M%S)"
nano strata-iq3_s.json
在 JSON 的
args陣列中保留 setup 產生的--pack、--native、--ple-gguf、--mtp等路徑,只檢查下面參數;不要把這個表當成整份 JSON 覆蓋貼上,也不要在args中重複放同一個 flag。flag 本機勝出值 說明 --expert-cacheauto依剩餘顯存自動配置 expert cache --prefillauto本機雙卡實際挑到 8,192-token prompt chunk --spec4MTP 草稿驗證深度 --spec-min-p0.70草稿層再多猜一個 token 前的門檻;本機校準值 --max-context262144最大總 context,輸入與輸出都要算進去 --kvint8KV cache 使用 int8 --kv-resident32768每層 32,768 cells 留在顯存,其餘用 pinned RAM 支援 --pcie-frac0.20未命中顯存的 experts 中,送 PCIe 給 GPU 計算的比例;本機校準勝出 JSON gpu[0,1]同時使用兩張卡,編號依 nvidia-smiJSON layer_split"auto"Strata 自動切分兩卡模型層 本機沒有加
--pool-workers,引擎自動用 37 個 CPU workers(工作執行緒);校準顯示這比 25、18、9 workers 快。別的 CPU 不一定應設 37,先跑校準。啟動並驗證
./run-iq3_s.sh首次啟動會將約 47 GiB experts 載入 RAM,通常要等一到兩分鐘。看到
ready後,開另一個終端機:curl -fsS http://127.0.0.1:8080/health | python3 -m json.tool curl -fsS http://127.0.0.1:8080/slots | python3 -m json.tool nvidia-smi/health應顯示loaded: true、max_context: 262144;/slots應顯示n_ctx: 262144。瀏覽器可開http://127.0.0.1:8080/。下面的 curl 只檢查 API 有回應,短 prompt 不代表長 context 速度:curl -fsS http://127.0.0.1:8080/v1/chat/completions \ -H 'Content-Type: application/json' \ -d '{"model":"qwen3.8-flash-next-iq3_s","messages":[{"role":"user","content":"只回覆 READY"}],"max_tokens":128,"temperature":0}' \ | python3 -m json.tool自己測速:不要把 prefill 和 decode 混在一起
- 確認沒有其他模型或使用者同時佔用 GPU。
- 固定模型量化、prompt token 數、
max_tokens(最大輸出 token)、溫度和思考模式;每個設定至少測 3 次取中位數。 - 同一 prompt 重跑時,確認 Strata 的
cache_n/ reused tokens 是 0,或重新啟動引擎,避免把 prompt cache(提示詞快取)命中誤認成硬體加速。 - 記錄 API response 的
timings.prompt_per_second(prefill)和timings.predicted_per_second(decode)、usage.prompt_tokens和completion_tokens。也另記 wall time(實際總等待時間);它還可能包含 queue / tokenize 等非 GPU 推論時間。 - 256K 是總 context,不是可放 262,144 個輸入再加輸出。本文用約 235K prompt + 128 output,保留模板和輸出空間。
看硬體時可用:
nvidia-smi --query-gpu=index,name,memory.used,memory.total,utilization.gpu,utilization.memory,power.draw,power.limit,pcie.link.gen.current,pcie.link.width.current --format=csvNVIDIA 的
utilization.gpu是取樣期間有 kernel 執行的時間比例;utilization.memory是顯存正在讀寫的時間比例,不是「顯存頻寬已用掉幾成」。NVIDIA 指標定義第一次安裝後可用
./setup.sh --calibrate自動測本機 PCIe expert 分流、草稿門檻和 CPU workers,需約 5–10 分鐘並會更新 model JSON;先備份、等服務閒置再跑。Strata 校準說明5. 本機實測:把數字拆開看
Decode 校準
設定 短 prompt decode 中位數 預設 pcie-frac 0.55 / spec-min-p 0.5043.3 tok/s 校準 pcie-frac 0.20 / spec-min-p 0.7054.3 tok/s 本機校準提升約 25.3%,但這是校準短 prompt 的結果,長 context 不會保證同幅度。
同一份 235K prompt:原設定 vs 校準設定
兩輪使用同一份 235,016-token prompt、同一個 128-token 輸出上限:
設定 Prefill Decode HTTP wall time 原設定 1,744.6 tok/s 38.2 tok/s 139.1 秒 校準後 1,747.3 tok/s 41.8 tok/s 138.6 秒 prefill 幾乎相同;總 wall time 只少約半秒,因 235K prompt 讀入約佔 134.5 秒。兩次都達到 128-token 上限,這是吞吐量測,不是回答品質比較。
128K context:雙卡 vs 單卡
使用同一份 119,992-token prompt、相同 128-token 輸出上限;單卡也先獨立校準:
配置 Prefill Decode HTTP wall time 雙 RTX 3060 1,786 tok/s 44.8 tok/s 70.6 秒 單 RTX 3060 997 tok/s 40.4 tok/s 124.1 秒 單卡 prefill 約慢 44%、decode 約慢 10%、總耗時多約 76%。單卡啟動日誌配置 2,377 個 expert-cache slots(4.57 GiB);雙卡則各自保存所屬 layer 的 cache。slots 會隨 context 和顯存狀況改變,因此表格用同 prompt 的速度做直接比較,不把不同 context 下的 cache slots 當成完全同條件數字。
加大 prefill chunk 上限沒有讓引擎實際用更大 chunk
--prefill65K prompt 235K prompt 引擎實際 chunk auto1,712.8 tok/s 1,742.9 tok/s 8,192 auto:163841,710.7 tok/s 1,743.9 tok/s 8,192 auto:327681,710.6 tok/s 1,744.3 tok/s 8,192 雙卡中 CUDA1 的 cache slots 不足以借出更大 prompt buffer,所以三種設定實際都用 8,192-token chunk;32K 設定還出現 slots 不足警告。正式設定保留
--prefill auto。另測 K8V4(INT8 K + 旋轉 4-bit V 的 KV 格式):235K prompt prefill 1,613 tok/s,int8 為 1,747 tok/s。K8V4 雖把 pinned KV RAM 約從 1.55 GiB 降至 1.20 GiB,但沒有加快這台機器的 prompt 讀入。兩者生成 token 數不同,因此不把 decode 數字當成嚴格 A/B。
6. 瓶頸分析:顯存容量、顯存頻寬還是主機 RAM?
顯存容量:這台最明確的硬體限制
推論時以 1 秒間隔取樣 39 次,每張卡用了約 11.7–11.9 GiB / 12 GiB;Strata expert cache 合計約 11.5 GiB。GPU 還要放共同層、KV cache、MTP 草稿層和 prompt buffer。對這種 MoE 模型,顯存裝得下更多常用 experts,就能少走 CPU miss 路徑;Strata 文件估計每多 1GB VRAM 約能多留 700 個 experts。Strata 架構說明
GDDR 頻寬:沒有證據顯示已跑滿
推論取樣期間,兩卡 GPU kernel 活躍時間平均約 84–86%,但 memory-active 平均約 55–58%、取樣最高約 80%。這表示 GPU 很忙,但不能直接推成 GDDR6 頻寬已到 360 GB/s;本次沒有讀取 DRAM bytes/s。應說「目前未測得飽和」,不能說「頻寬絕不會是瓶頸」。
主機 RAM:容量夠,頻寬仍未知
系統有 128 GiB online,推論時約 56–57 GiB available,Swap 幾乎為零;Strata 能把 experts 和 streamed KV 放進 RAM,所以本機 RAM 容量不是瓶頸。CPU 全機平均利用率約 6.9%,但 76 個邏輯執行緒的整體平均不能排除少數 worker 或 RAM 通道很忙。實體 DIMM/通道及 RAM bandwidth 未測。
PCIe / CPU expert-miss 分流:已證明影響 decode
235K prompt 的原設定約 11.9% routed experts 走 PCIe 給 GPU;校準後約 2.2%,decode 從 38.2 升到 41.8 tok/s。這支持「本機讓較多 misses 留給 CPU 計算,比搬更多 experts 過 PCIe 更有效」;不代表 PCIe Gen4 x16 的實體頻寬已經滿載。Strata 的 expert-cache hit-rate 會排除一部分 PCIe offload,因此數字可能隨
--pcie-frac改變,不可單獨用它判斷速度。Strata issue #5887. 給朋友的抄作業結論
對本文這套雙 12GB RTX 3060 + 128 GiB RAM + IQ3_S:
- 保留雙卡 layer split;同 prompt 測試顯示單卡 128K 更慢。
- 正式設定用
--pcie-frac 0.20、--spec-min-p 0.70;這是本機校準值,不保證其他 CPU/GPU 組合一樣。 - 保留
--prefill auto、KV int8、--kv-resident 32768;加大 prefill chunk 上限沒有增加實際 chunk。 - 若有資源升級需求,更多可用 VRAM 有比只追求更高 GDDR 頻寬更直接的依據;但本文沒有做不同顯卡的實體升級 A/B。
- 128K 只適合輸入加輸出總長在 128K 內的工作;235K 對話不能用 128K context。
參考資料
- Qwen3.8-Flash-Next 官方模型卡 — 125B 總參數、啟用參數、experts 與原生 262,144 context。
- Strata v0.1.40.1 release — 本次軟體版本。
- Strata AI Setup — IQ3_S RAM 建議、安裝與 GPU/context 選項。
- Strata How it works — expert cache、VRAM/RAM/CPU 分工。
- Strata Multi-GPU — layer split、卡間交接與限制。
- Strata issue #588 — PCIe expert offload 與 cache hit-rate 的意義。
- NVIDIA
nvidia-smi文件 — GPU/memory utilization 和 PCIe link 指標定義。 - GIGABYTE RTX 3060 12GB 規格 — 一款 RTX 3060 12GB 板卡的 GDDR6 規格。
**已知缺口:**CPU 精確 SKU、實際 DIMM 數量/通道、RAM 頻寬、DRAM 實際 GB/s、電源供應器與散熱器未核實或未量測。本文所有速度只代表上述本機 IQ3_S 測試;Q2_0 未測。
- 這台機器最快的已測設定,是兩張 RTX 3060 一起跑,context 256K、KV int8,並把
-
,
 T terry 固定了此主题
-
-
-
潛水太久了,看大家都再玩strata,這次請出六爺再次披甲上陣用雙 RTX 3060/12GB 跑 Strata Qwen3.8 Flash Next IQ3_S:硬體清單、實測速度約50上下tok/s
**測試日期:**2026-10-07
**文章目的:**分享一套本機可重現的 Strata 設定,並用實測說清楚推理速度受到哪些硬體影響。
**測試範圍:**Qwen3.8-Flash-Next IQ3_S,沒有測 Q2_0。本文數字只代表這台主機和這些 prompt,不是所有 RTX 3060 或所有模型都能得到的保證值。先看答案
- 這台機器最快的已測設定,是兩張 RTX 3060 一起跑,context 256K、KV int8,並把
--pcie-frac設成0.20、--spec-min-p設成0.70。 - 短 prompt 的 decode 校準中位數從 43.3 升到 54.3 tok/s(約快 25%)。同一份 235K prompt 的長上下文對照,decode 從 38.2 升到 41.8 tok/s(約快 9.4%);prefill 幾乎沒有變化。
- 同一份 120K prompt 改成單卡 128K,反而比雙卡 128K 慢:單卡總耗時 124.1 秒,雙卡 70.6 秒。
- 目前最明確的限制是顯存容量與 expert-cache(專家快取)/PCIe/CPU 的分流。這次沒有測到 GDDR6 的實際 GB/s,不能說顯存頻寬已經跑滿。
1. 測試主機:完整硬體清單
以下列出這台推理主機中,已實際核對的硬體和版本;沒核對到的欄位明確標示,不用猜測補上。
部件 本次核對結果 主機板 GIGABYTE MU72-SU0-00,Intel C621A,單路 LGA4189;主機板有 8 個 DDR4 DIMM 插槽,支援 8 通道 ECC Registered RAM(具錯誤更正的暫存式記憶體)。GIGABYTE 主機板規格 CPU Intel Xeon Ice Lake-SP 世代,38 核心 / 76 執行緒,單一 NUMA node(記憶體區域節點),有 AVX-512。 lscpu的商品名稱只回報Genuine Intel(R) CPU 0000%@,因此確切 CPU 型號未能確認RAM Linux lsmem顯示 128 GiB online。實際 DIMM 數量、廠牌、速度及目前啟用幾個記憶體通道未重新核對;「主機板支援 8 通道」不等於目前已啟用 8 通道GPU 2 張 NVIDIA GeForce RTX 3060 12GB,CUDA index 0、1;GPU 0 的 PCI bus 是 0000:51:00.0,GPU 1 是0000:c3:00.0。兩張卡的 power limit(功耗上限)各 170W;桌面主顯示卡在 GPU 1GPU 連線 推論負載期間 nvidia-smi取樣顯示兩卡各為 PCIe Gen4 x16;兩卡間nvidia-smi topo -m顯示NODE(經同一 NUMA node 的 PCIe / host bridge 路徑),沒有 NVLink 標記。閒置時 PCIe 連線世代可能省電降速顯存規格 一款 GIGABYTE RTX 3060 12GB 板卡列出 GDDR6、360 GB/s 名目頻寬;這是該型號規格,不是本次實測的顯存 GB/s。GIGABYTE RTX 3060 規格 其他顯示裝置 主機板上的 ASPEED AST2600 BMC 顯示裝置,PCI 0000:06:00.0;Strata 推理使用兩張 NVIDIA GPU有線網路 主機板規格有 2 × Intel I210-AT 1GbE 網路埠和獨立 BMC 管理埠;Strata 僅綁 localhost 127.0.0.1,網路介面不在本次 GPU 推理計算路徑上。GIGABYTE MU72-SU0 規格SSD MSI M450 1TB NVMe SSD;Strata/Qwen 資料位於本機 NVMe。測量當時根分割區約 916GiB,剩餘約 31GiB 作業系統 Ubuntu 24.04.4 LTS,Linux kernel 7.0.0-34-generic,x86-64 NVIDIA 軟體 Driver 595.84; nvidia-smi顯示 CUDA Version 13.2,這是驅動相容版本,不代表引擎用 13.2 編譯。Strata 本機建置紀錄使用 CUDA Toolkit 12.0Strata v0.1.40.1,commit 82f46a8,引擎 v0.1.40,Python 3.12.3。Strata v0.1.40.1 release電源 / 散熱 電源供應器型號、CPU/GPU 散熱器與機殼風道未量測;本文不推論是否有供電或散熱限制 整機功耗 使用者補充:待機約 200W,雙卡全速推理約 500W。此為整機觀測值,量測位置/工具未註明;不是 nvidia-smi的單卡功耗讀值**RAM 與安裝空間注意:**本機辨識到 128 GiB RAM,但 DIMM 插法和實際記憶體頻寬未知。Strata 官方將 96GB 以上列為 IQ3_S 建議區間;本次安裝的 IQ3_S 兩個模型 shard 約 83.6GB,還有 pack、MTP 草稿資料與其他檔案。新安裝建議預留約 90–100GB SSD 空間。當時這台 SSD 剩 31GB,所以是沿用已安裝的模型做測試,不是重新下載。 Strata 安裝指南
2. 新手名詞小抄
- MoE(Mixture of Experts,混合專家模型):模型中有許多「專家子網路」,每個 token 只啟用其中一部分。Qwen 官方模型卡列出這個模型總參數約 125B、啟用參數約 6B;每個 MoE 層有 512 個 experts,每個 token 使用 10 個 routed experts 和 1 個 shared expert。Qwen 官方模型卡
- Expert(專家):MoE 裡負責計算的一組權重。
- Expert cache(專家快取):顯卡記憶體先存常用 experts;沒存到的叫 cache miss(快取未命中)。Strata 說多 1GB VRAM 約能多留 700 個 experts,但實際收益依模型和 GPU 而異。Strata 架構說明
- VRAM / 顯存容量:GPU 上能放多少模型資料、expert cache 和 KV cache。
- GDDR 顯存頻寬:GPU 核心從顯存讀寫資料的傳輸規格;和「顯存容量」不同。
- PCIe:CPU/主機 RAM 和 GPU 之間的連線。未命中 expert cache 的權重可以留給 CPU 算,也可以用
--pcie-frac把一部分送到 GPU 算。 - KV cache(Key/Value 注意力快取):模型保留已讀 token 的注意力狀態,不是模型權重。
- Prefill(提示詞讀入):讀取 prompt、系統提示與對話歷史;主要影響第一個 token 要等多久。
- Decode(逐 token 生成):模型一個 token 接一個 token 寫答案;常用 tok/s 表示每秒 token 數。
- MTP(Multi-Token Prediction,多 token 預測):草稿層先猜後續 token,再由主模型驗證。
- Layer split(模型層切分):一張卡跑模型前段層,另一張卡跑後段層;兩張卡不是合成一塊可互換資料的 24GB VRAM。Strata 多 GPU 文件
3. Strata 怎麼使用這台電腦
Qwen3.8-Flash-Next 有很多 experts,全部放不進一張 12GB 顯卡。Strata 把完整 experts 放在主機 RAM,顯存保存常用 experts;遇到沒駐留在 GPU 的 expert 時,CPU 可直接由 RAM 計算,也可依
--pcie-frac把一部分 misses 透過 PCIe 交給 GPU。GPU 顯存還要放共同模型層、KV cache、MTP 和 prompt 暫存區。Strata How it works雙卡 layer split 時,每張卡各有自己 layer 的 expert cache。Strata 文件說 token 在兩卡間是每個 verify window(草稿驗證批次)交接一次小量資料,不是每一層都來回搬。因此兩卡的主要價值是分攤模型層、增加總 expert cache;不需要假設有 NVLink 才能工作。Strata Multi-GPU 文件
4. 新手安裝與設定:一步一步照做
以下是 Linux 新安裝範例,固定使用本次測試的 Strata 版本和 IQ3_S。模型下載前先確認 SSD 有約 90–100GB 可用空間:
git clone --depth 1 --branch v0.1.40.1 https://github.com/Niko1221/Strata.git cd Strata ./setup.sh --family qwen --model IQ3_S --context 262144 --gpus 0,1 --vision no --no-start --yesnvidia-smi會列出你的 GPU index(編號);若不是 0、1,請把--gpus換成自己的編號。Windows 用官方START-HERE.bat回答同樣選項即可。setup 顯示的 RAM 警告要照做:官方資料指出 64GB 上的 IQ3_S 256K context 可能接近記憶體限制,建議依 RAM 選較小 context。Qwen 模型原生 context 是 262,144 tokens。Strata setup flags Qwen 官方 context 規格修改設定前先備份
在 Strata 目錄先備份 setup 產生的 JSON:
cp -a strata-iq3_s.json "strata-iq3_s.json.bak_$(date +%Y%m%d_%H%M%S)"
nano strata-iq3_s.json
在 JSON 的
args陣列中保留 setup 產生的--pack、--native、--ple-gguf、--mtp等路徑,只檢查下面參數;不要把這個表當成整份 JSON 覆蓋貼上,也不要在args中重複放同一個 flag。flag 本機勝出值 說明 --expert-cacheauto依剩餘顯存自動配置 expert cache --prefillauto本機雙卡實際挑到 8,192-token prompt chunk --spec4MTP 草稿驗證深度 --spec-min-p0.70草稿層再多猜一個 token 前的門檻;本機校準值 --max-context262144最大總 context,輸入與輸出都要算進去 --kvint8KV cache 使用 int8 --kv-resident32768每層 32,768 cells 留在顯存,其餘用 pinned RAM 支援 --pcie-frac0.20未命中顯存的 experts 中,送 PCIe 給 GPU 計算的比例;本機校準勝出 JSON gpu[0,1]同時使用兩張卡,編號依 nvidia-smiJSON layer_split"auto"Strata 自動切分兩卡模型層 本機沒有加
--pool-workers,引擎自動用 37 個 CPU workers(工作執行緒);校準顯示這比 25、18、9 workers 快。別的 CPU 不一定應設 37,先跑校準。啟動並驗證
./run-iq3_s.sh首次啟動會將約 47 GiB experts 載入 RAM,通常要等一到兩分鐘。看到
ready後,開另一個終端機:curl -fsS http://127.0.0.1:8080/health | python3 -m json.tool curl -fsS http://127.0.0.1:8080/slots | python3 -m json.tool nvidia-smi/health應顯示loaded: true、max_context: 262144;/slots應顯示n_ctx: 262144。瀏覽器可開http://127.0.0.1:8080/。下面的 curl 只檢查 API 有回應,短 prompt 不代表長 context 速度:curl -fsS http://127.0.0.1:8080/v1/chat/completions \ -H 'Content-Type: application/json' \ -d '{"model":"qwen3.8-flash-next-iq3_s","messages":[{"role":"user","content":"只回覆 READY"}],"max_tokens":128,"temperature":0}' \ | python3 -m json.tool自己測速:不要把 prefill 和 decode 混在一起
- 確認沒有其他模型或使用者同時佔用 GPU。
- 固定模型量化、prompt token 數、
max_tokens(最大輸出 token)、溫度和思考模式;每個設定至少測 3 次取中位數。 - 同一 prompt 重跑時,確認 Strata 的
cache_n/ reused tokens 是 0,或重新啟動引擎,避免把 prompt cache(提示詞快取)命中誤認成硬體加速。 - 記錄 API response 的
timings.prompt_per_second(prefill)和timings.predicted_per_second(decode)、usage.prompt_tokens和completion_tokens。也另記 wall time(實際總等待時間);它還可能包含 queue / tokenize 等非 GPU 推論時間。 - 256K 是總 context,不是可放 262,144 個輸入再加輸出。本文用約 235K prompt + 128 output,保留模板和輸出空間。
看硬體時可用:
nvidia-smi --query-gpu=index,name,memory.used,memory.total,utilization.gpu,utilization.memory,power.draw,power.limit,pcie.link.gen.current,pcie.link.width.current --format=csvNVIDIA 的
utilization.gpu是取樣期間有 kernel 執行的時間比例;utilization.memory是顯存正在讀寫的時間比例,不是「顯存頻寬已用掉幾成」。NVIDIA 指標定義第一次安裝後可用
./setup.sh --calibrate自動測本機 PCIe expert 分流、草稿門檻和 CPU workers,需約 5–10 分鐘並會更新 model JSON;先備份、等服務閒置再跑。Strata 校準說明5. 本機實測:把數字拆開看
Decode 校準
設定 短 prompt decode 中位數 預設 pcie-frac 0.55 / spec-min-p 0.5043.3 tok/s 校準 pcie-frac 0.20 / spec-min-p 0.7054.3 tok/s 本機校準提升約 25.3%,但這是校準短 prompt 的結果,長 context 不會保證同幅度。
同一份 235K prompt:原設定 vs 校準設定
兩輪使用同一份 235,016-token prompt、同一個 128-token 輸出上限:
設定 Prefill Decode HTTP wall time 原設定 1,744.6 tok/s 38.2 tok/s 139.1 秒 校準後 1,747.3 tok/s 41.8 tok/s 138.6 秒 prefill 幾乎相同;總 wall time 只少約半秒,因 235K prompt 讀入約佔 134.5 秒。兩次都達到 128-token 上限,這是吞吐量測,不是回答品質比較。
128K context:雙卡 vs 單卡
使用同一份 119,992-token prompt、相同 128-token 輸出上限;單卡也先獨立校準:
配置 Prefill Decode HTTP wall time 雙 RTX 3060 1,786 tok/s 44.8 tok/s 70.6 秒 單 RTX 3060 997 tok/s 40.4 tok/s 124.1 秒 單卡 prefill 約慢 44%、decode 約慢 10%、總耗時多約 76%。單卡啟動日誌配置 2,377 個 expert-cache slots(4.57 GiB);雙卡則各自保存所屬 layer 的 cache。slots 會隨 context 和顯存狀況改變,因此表格用同 prompt 的速度做直接比較,不把不同 context 下的 cache slots 當成完全同條件數字。
加大 prefill chunk 上限沒有讓引擎實際用更大 chunk
--prefill65K prompt 235K prompt 引擎實際 chunk auto1,712.8 tok/s 1,742.9 tok/s 8,192 auto:163841,710.7 tok/s 1,743.9 tok/s 8,192 auto:327681,710.6 tok/s 1,744.3 tok/s 8,192 雙卡中 CUDA1 的 cache slots 不足以借出更大 prompt buffer,所以三種設定實際都用 8,192-token chunk;32K 設定還出現 slots 不足警告。正式設定保留
--prefill auto。另測 K8V4(INT8 K + 旋轉 4-bit V 的 KV 格式):235K prompt prefill 1,613 tok/s,int8 為 1,747 tok/s。K8V4 雖把 pinned KV RAM 約從 1.55 GiB 降至 1.20 GiB,但沒有加快這台機器的 prompt 讀入。兩者生成 token 數不同,因此不把 decode 數字當成嚴格 A/B。
6. 瓶頸分析:顯存容量、顯存頻寬還是主機 RAM?
顯存容量:這台最明確的硬體限制
推論時以 1 秒間隔取樣 39 次,每張卡用了約 11.7–11.9 GiB / 12 GiB;Strata expert cache 合計約 11.5 GiB。GPU 還要放共同層、KV cache、MTP 草稿層和 prompt buffer。對這種 MoE 模型,顯存裝得下更多常用 experts,就能少走 CPU miss 路徑;Strata 文件估計每多 1GB VRAM 約能多留 700 個 experts。Strata 架構說明
GDDR 頻寬:沒有證據顯示已跑滿
推論取樣期間,兩卡 GPU kernel 活躍時間平均約 84–86%,但 memory-active 平均約 55–58%、取樣最高約 80%。這表示 GPU 很忙,但不能直接推成 GDDR6 頻寬已到 360 GB/s;本次沒有讀取 DRAM bytes/s。應說「目前未測得飽和」,不能說「頻寬絕不會是瓶頸」。
主機 RAM:容量夠,頻寬仍未知
系統有 128 GiB online,推論時約 56–57 GiB available,Swap 幾乎為零;Strata 能把 experts 和 streamed KV 放進 RAM,所以本機 RAM 容量不是瓶頸。CPU 全機平均利用率約 6.9%,但 76 個邏輯執行緒的整體平均不能排除少數 worker 或 RAM 通道很忙。實體 DIMM/通道及 RAM bandwidth 未測。
PCIe / CPU expert-miss 分流:已證明影響 decode
235K prompt 的原設定約 11.9% routed experts 走 PCIe 給 GPU;校準後約 2.2%,decode 從 38.2 升到 41.8 tok/s。這支持「本機讓較多 misses 留給 CPU 計算,比搬更多 experts 過 PCIe 更有效」;不代表 PCIe Gen4 x16 的實體頻寬已經滿載。Strata 的 expert-cache hit-rate 會排除一部分 PCIe offload,因此數字可能隨
--pcie-frac改變,不可單獨用它判斷速度。Strata issue #5887. 給朋友的抄作業結論
對本文這套雙 12GB RTX 3060 + 128 GiB RAM + IQ3_S:
- 保留雙卡 layer split;同 prompt 測試顯示單卡 128K 更慢。
- 正式設定用
--pcie-frac 0.20、--spec-min-p 0.70;這是本機校準值,不保證其他 CPU/GPU 組合一樣。 - 保留
--prefill auto、KV int8、--kv-resident 32768;加大 prefill chunk 上限沒有增加實際 chunk。 - 若有資源升級需求,更多可用 VRAM 有比只追求更高 GDDR 頻寬更直接的依據;但本文沒有做不同顯卡的實體升級 A/B。
- 128K 只適合輸入加輸出總長在 128K 內的工作;235K 對話不能用 128K context。
參考資料
- Qwen3.8-Flash-Next 官方模型卡 — 125B 總參數、啟用參數、experts 與原生 262,144 context。
- Strata v0.1.40.1 release — 本次軟體版本。
- Strata AI Setup — IQ3_S RAM 建議、安裝與 GPU/context 選項。
- Strata How it works — expert cache、VRAM/RAM/CPU 分工。
- Strata Multi-GPU — layer split、卡間交接與限制。
- Strata issue #588 — PCIe expert offload 與 cache hit-rate 的意義。
- NVIDIA
nvidia-smi文件 — GPU/memory utilization 和 PCIe link 指標定義。 - GIGABYTE RTX 3060 12GB 規格 — 一款 RTX 3060 12GB 板卡的 GDDR6 規格。
**已知缺口:**CPU 精確 SKU、實際 DIMM 數量/通道、RAM 頻寬、DRAM 實際 GB/s、電源供應器與散熱器未核實或未量測。本文所有速度只代表上述本機 IQ3_S 測試;Q2_0 未測。
双六爷就好像秦琼秦叔宝用的双锏啊, 挥起来虎虎生风!
战鼓如雷,杀声震天。只见秦琼深吸一口气,双臂一振,锵然声中,那一对祖传的四棱金装锏已然破空出鞘!那双锏重达一百三十斤,在烈日下鎏金溢彩,寒芒吞吐,隐隐带着破风的龙吟之声。
两军阵前,数名敌将不知深浅,纵马挺枪齐齐围攻上来。秦琼面不改色,跨下黄骠马长嘶一声,人马合一暴冲而出。他右臂一抡,一记“力劈华山”,金锏携万钧之势呼啸而下,只听“当”的一声暴烈巨响,迎面敌将的厚重长枪竟被震得脱手飞出,虎口崩裂!未等敌兵惊骇,秦琼左手金锏顺势一个横扫千军,沉重的钝击掠过,厚重的护身铁甲如纸糊般内凹碎裂,敌将惨叫一声,直接被扫落马下。
眨眼间,秦琼已陷万军重围,但他毫无惧色。两柄金锏在他手中被舞得风雨不透,只见金光万道,层层叠叠,化作一团不透风的金色暴风。枪刺不进,箭射不穿!凡是金锏所到之处,骨碎甲崩,人马辟易。就在此时,敌方主帅企图拨马逃走,秦琼目若朗星,陡然大喝一声,使出了威震天下的压箱底绝技——“撒手锏”!只见他右手一扬,一柄金锏化作一道凌厉无比的金色流星,裹挟着撕裂空气的锐啸直奔敌首。“砰”地一声,金锏精准无比地砸中敌将后心,直接将其击落马下,一招定乾坤! - 這台機器最快的已測設定,是兩張 RTX 3060 一起跑,context 256K、KV int8,並把
-
双六爷就好像秦琼秦叔宝用的双锏啊, 挥起来虎虎生风!
战鼓如雷,杀声震天。只见秦琼深吸一口气,双臂一振,锵然声中,那一对祖传的四棱金装锏已然破空出鞘!那双锏重达一百三十斤,在烈日下鎏金溢彩,寒芒吞吐,隐隐带着破风的龙吟之声。
两军阵前,数名敌将不知深浅,纵马挺枪齐齐围攻上来。秦琼面不改色,跨下黄骠马长嘶一声,人马合一暴冲而出。他右臂一抡,一记“力劈华山”,金锏携万钧之势呼啸而下,只听“当”的一声暴烈巨响,迎面敌将的厚重长枪竟被震得脱手飞出,虎口崩裂!未等敌兵惊骇,秦琼左手金锏顺势一个横扫千军,沉重的钝击掠过,厚重的护身铁甲如纸糊般内凹碎裂,敌将惨叫一声,直接被扫落马下。
眨眼间,秦琼已陷万军重围,但他毫无惧色。两柄金锏在他手中被舞得风雨不透,只见金光万道,层层叠叠,化作一团不透风的金色暴风。枪刺不进,箭射不穿!凡是金锏所到之处,骨碎甲崩,人马辟易。就在此时,敌方主帅企图拨马逃走,秦琼目若朗星,陡然大喝一声,使出了威震天下的压箱底绝技——“撒手锏”!只见他右手一扬,一柄金锏化作一道凌厉无比的金色流星,裹挟着撕裂空气的锐啸直奔敌首。“砰”地一声,金锏精准无比地砸中敌将后心,直接将其击落马下,一招定乾坤!@johnnybegood 真的,哈哈,六爺是老特版主在視頻裡面提到的,我順勢拿來用,哈,滿舒服的,但就是有點耗電了
-
,系统 取消固定了此主题


 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!