
本地 Coding Agent 实测:NInfer 96K 已经很好用,KVMem 150K 我暂时先放弃了 5060ti 16g +32g内存 实测
-
本地 Coding Agent 实测:96K 已经能干活,150K 还需要观察
我现在的选择:继续用 NInfer 96K,暂时停掉 KVMem 150K。
对 Coding Agent 来说,真正重要的是连续开发几个小时以后,还能不能把项目正确做完。01 · NInfer 96K:已经是我愿意长期用的方案
我之前用 96K 跑过一次比较完整的长程项目。不是简单写几个函数,而是接手一个现有项目,完成真实的 Brownfield 全栈任务。
从 Domain、API、SQLite、前端,一路做到测试、浏览器 E2E、Vision 检查和最终报告。
一次 4 小时的完整开发
项目 实测记录 任务类型 Brownfield:接手现有项目,完成全栈业务闭环 运行时长 4 小时 02 分 Agent steps 约 293 个 Cumulative tokens 约 16.5M Context compaction 8 次 Domain / API 测试 通过 Build PASS 完整 E2E 40/40,连续两轮 PASS 中间当然也踩过坑:Google Fonts、Playwright、React UI race、Vision timeout、端口残留……
但重要的是:Agent 没有因为跑得久、压缩了 8 次上下文,就把整个项目做崩。
到最后,它仍然能分清:
- 当前业务链推进到哪里,哪些文件已经修改;
- 哪些测试已经通过,哪些问题还需要处理;
- 哪些是业务 bug,哪些只是测试 race condition。
最终,它把整个项目做完了。
我对 compaction 的看法变了
以前我把 compaction 当缺点。现在反而觉得,它可能是 Coding Agent 的一种 “工作记忆整理机制”。
旧代码、旧错误、旧 tool output,以及已经失效的中间状态,会被定期压缩掉。留下来的信息,反而更接近当前真正需要的内容。
适度整理上下文,可能比一直保留所有历史更有用。
02 · 再跑一次 Greenfield:从空目录开始验证
为了排除“之前那个项目本身已经有基础”的影响,我又建了一个完全空白的目录,只给 Agent 一份需求文件。
这次是真正的 Greenfield 从零开发。
维度 任务要求 起点 空白目录 + 一份需求文件 前端 React 19 + Vite + Ant Design + ECharts 后端 Node API + SQLite 业务闭环 岗位 → 任务 → 能力 → 课程 → 学习证据 → Rubric → 评价 → 修订 → 学生画像 目前这轮 96K 的表现让我更满意。大约 50 分钟左右,已经推进到:
检查项 当时的进度 / 结果 SQLite 完成 Domain 完成 API 完成 前端 基本完成 Build PASS 完整 E2E 32/32 checks × 2,连续两轮 PASS 生成速度 约 70 tok/s Cache hit 约 97% 即使已经发生 context compaction,项目推进仍然比较稳定。到目前为止,没有明显出现这种严重的状态漂移:
“我记得文件应该是这样,但磁盘里怎么不是这样?”
03 · 为什么又去测试 KVMem 150K?
原因很简单:既然 96K 已经能跑几个小时,那自然会想——把上下文扩大到 150K,是不是就能减少 compaction?
理论上很漂亮,于是我测试了:
NInfer + KVMem + Qwen3.8-27B,150K context。
项目 实测表现 上下文配置 150K 生成速度 60~70 tok/s 显存情况 没有直接 OOM 能否运行 能跑 这也是 KVMem 最吸引人的地方:把更大的历史 KV 放到系统内存,再按需调度,让 16GB 显存的机器也有机会把上下文推到 150K,甚至更高。
但我真正关心的问题是:
150K 里面,到底有多少是真正稳定、有效、可用的上下文?
一个多小时后,开始出现状态混淆
我用 150K KVMem 跑的任务,和现在这轮 96K Greenfield 非常接近,同样从空目录开始。
跑到大约一个多小时以后,出现了一些让我不太放心的现象:
环节 发生了什么 修改 domain.js按记忆中的代码做 exact edit,返回 old_string was not found重新读取文件 判断“磁盘上的 domain.js 和我记忆中的不一样” 排查原因 一度怀疑文件被其他东西改过 再次 Read 才意识到自己对当前文件版本的记忆已经不准确 修改 index.js又出现过类似情况 让我介意的不是一次普通 typo,而是:Agent 开始把历史版本代码和当前磁盘状态混淆。
现象看到了,但原因不能直接归给 KVMem
我不能证明这一定是 KVMem 导致的。可能的原因包括:
- 超长上下文本身的 retrieval interference;
- Harness 对 tool result 的压缩;
- 旧版本代码在上下文里长期残留;
- KV 分页、检索或 checkpoint 机制;
- 模型在超长上下文里的 attention dilution。
这些都只是可能的解释,没有完成归因验证。
但对我来说,没有必要一定找到最终责任人:我是拿它干活,不是做论文。
04 · 96K 和 150K,实际用起来差在哪里?
下面是我目前的使用体验,不是严格控制变量的性能结论。
对比维度 NInfer 96K KVMem 150K 上下文容量 小一些 更大 Compaction 更多 理论上更少 当前工作状态 比较干净,推进稳定 出现过历史版本与当前状态混淆 历史信息 定期压缩整理 旧代码、旧 tool output、旧状态可能长期残留 错误表现 大部分是正常 coding bug 出现 stale-state / memory drift 风险 修复体验 测试后可以快速自修复 出现过需要重新读取文件、纠正自身记忆的情况 我的当前定位 主力方案 实验方案 所以我现在越来越怀疑:Coding Agent 的最优上下文,并不是越大越好。
它可能存在一个甜点区。对我这台机器来说,目前这个甜点区很可能就在:
Qwen3.8-27B + NInfer 96K
05 · 为什么暂时停掉 KVMem 150K?
我觉得 KVMem 很有技术价值。它解决的是一个非常现实的问题:本地显存有限,但大家又想跑更长的 context。
这个方向值得继续关注。不过,现阶段我不会把它当作自己的 Coding Agent 主力方案。
验证目标 它回答的问题 150K 成功加载 上下文能不能装下、能不能运行? 连续开发 3~4 小时 Agent 还能不能稳定知道自己在干什么,并把项目做完? 这是两个完全不同的问题。
Coding Agent 要反复经历:
代码修改 → 测试 → 再修改 → 浏览器 → API → E2E → 回归 → 报告
任何一次状态混乱,都可能让它把前面已经正确的东西改坏。
因此,在我的使用场景下:
稳定性 > 上下文数字
会正确地忘掉一部分旧东西,可能比什么都不忘更重要。06 · 我现在的配置和建议
方案 当前选择 Qwen3.8-27B GSQ-RCO IQ3_S-MTP + NInfer 96K 继续作为主力配置 KVMem 150K 暂时停用,等待后续版本再测 后续我会关注这些方面的打磨:
- Long-context correctness
- Page boundary
- KV retrieval
- Checkpoint / replay
- 超长 Agent session 稳定性
如果你现在也准备部署本地 Coding Agent,我个人的建议是:不要为了 150K、200K 这个数字急着上 KVMem。
如果已经有一套稳定的 64K、96K 或类似方案,先把它跑稳。
真正衡量一个 Coding Agent 的,是跑几个小时以后,它还能不能把项目正确做完。
至少目前我的实测结论是:96K 已经能干活。150K KVMem 更像值得研究的实验方案,还不是我愿意长期依赖的生产方案。
-
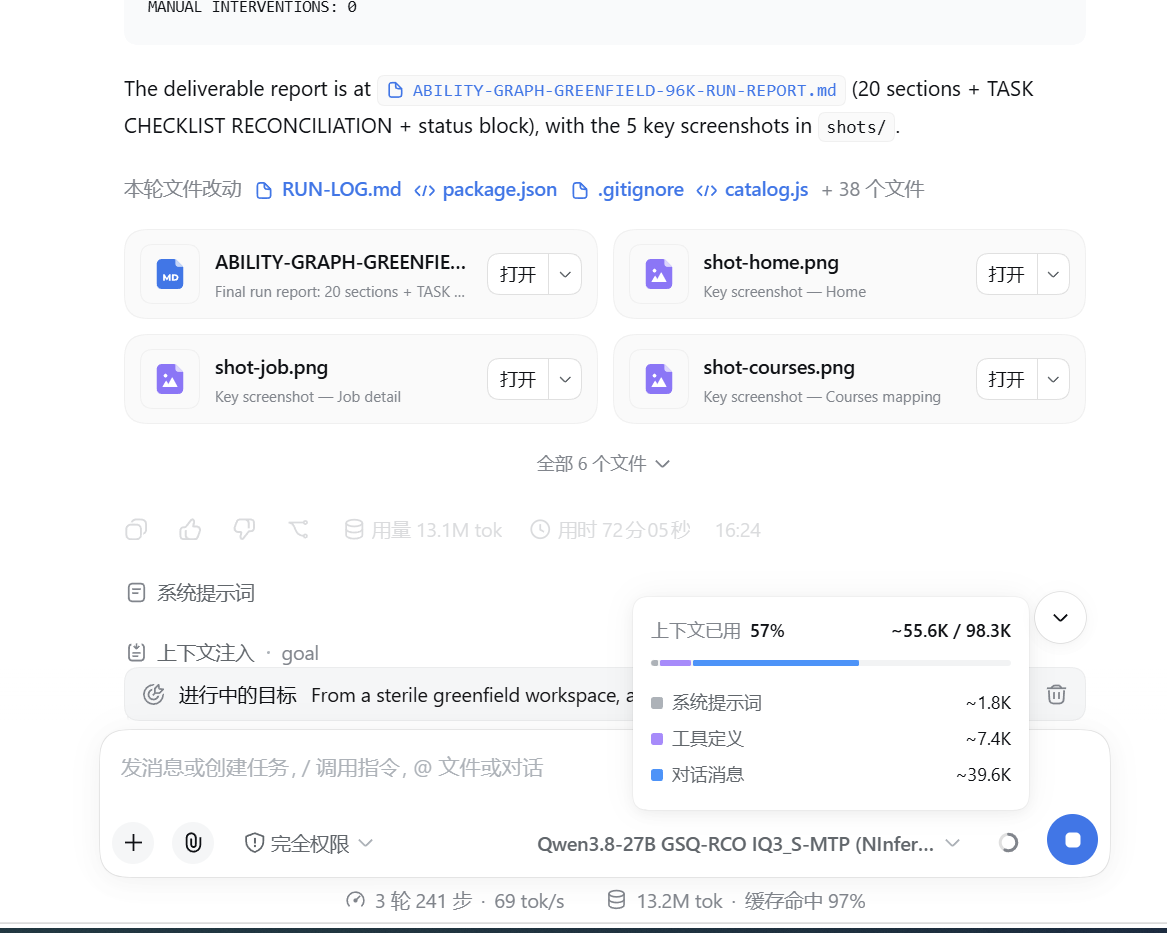
补一个任务完成的截图
-
-
一直没搞懂NInfer,运行下载模型的bat,只有
NInfer - model artifact downloader  (Hugging Face)
====================================================

 [1]  Qwen3.6-27B        groupwise-int   qwen3_6_27b.ninfer         ~16.3 GiB
 [2]  Qwen3.6-27B NVFP4  nvfp4           qwen3_6_27b_nvfp4.ninfer   ~17.1 GiB
 [3]  Qwen3.8-27B        groupwise-int   qwen3_8_27b.ninfer          ~19.0 GiB
 [4]  Qwen3.8-27B NVFP4  nvfp4           qwen3_8_27b_nvfp4.ninfer   ~22.1 GiB
 [5]  Qwen3.6-35B-A3B    groupwise-int   qwen3_6_35b_a3b.ninfer     ~21.2 GiB
 [6]  Qwen3.8-27B NVFP4F  nvfp4full       qwen3_8_27b_nvfp4full.ninfer  ~17.1 GiB

 [0]  cancel
楼主的那个不知道哪下载
是魔搭这个吗
https://www.modelscope.cn/models/fyb423/Swift-1.5-Qwen3.8-27B-GSQ-RCO-NInfer/files -

