跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. strata极致优化指南(参数篇)64GB RAM + RTX pro 5000 48GB, IQ3_XXS量化,prefill 4500t/s,decode 180t/s 同时缓存5个262k会话不重新prefill

strata极致优化指南(参数篇)64GB RAM + RTX pro 5000 48GB, IQ3_XXS量化,prefill 4500t/s,decode 180t/s 同时缓存5个262k会话不重新prefill

已定时 已固定 已锁定 已移动 精华 LLM讨论区
stratartxpro5000量化
21 帖子 9 发布者 3.7k 浏览 4 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Marck WongM Marck Wong

    我是5080+64g ram 也是跑 IQ3_XXS 体感比之前的IQ3_S好了不少 我设置了128k context 现在大概80tok/s

    fcmeF
    fcmeF
    fcme
    王侯将相
    发表于 最后由 编辑
    #5

    @Marck-Wong
    128的话对于实际你日常应用有影响吗?你是办公场景多还是代码开发多?上下文短的话,是不是也会速度比较快?

    个人的repo,欢迎指教
    https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

    Marck WongM 1 条回复 最后回复
    0
    • Z zeroxin

      @Marck-Wong 说:

      我是5080+64g ram 也是跑 IQ3_XXS 体感比之前的IQ3_S好了不少 我设置了128k context 现在大概80tok/s

      我的5070TI+96GDDR3 rem 其他设置跟你一样,有60tok/S

      terryT
      terryT
      terry
      易有太极
      发表于 最后由 编辑
      #6

      @zeroxin 发个详细测试呢,给大家参考下。上次我说大概50多tokens,但是评论区有哥们说能跑到100t/s,是不是量化版本不一样。

      油管:https://www.youtube.com/@抡锤者

      1 条回复 最后回复
      0
      • fcmeF fcme

        @Marck-Wong
        128的话对于实际你日常应用有影响吗?你是办公场景多还是代码开发多?上下文短的话,是不是也会速度比较快?

        Marck WongM
        Marck WongM
        Marck Wong
        发表于 最后由 编辑
        #7

        fcme 是的 64k更快 不过我是放进用opencodex 放进codex和GPT-6一起配合用的 所以我觉得128k也不太够用 刚刚改成了256k 还行

        fcmeF 1 条回复 最后回复
        0
        • Marck WongM Marck Wong

          fcme 是的 64k更快 不过我是放进用opencodex 放进codex和GPT-6一起配合用的 所以我觉得128k也不太够用 刚刚改成了256k 还行

          fcmeF
          fcmeF
          fcme
          王侯将相
          发表于 最后由 编辑
          #8

          @Marck-Wong
          哦,是这样,agent时代上下文累积太快了,100多确实小了点。 我也是最后稳定在了245k。

          个人的repo,欢迎指教
          https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
          https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

          Marck WongM 1 条回复 最后回复
          0
          • fcmeF fcme

            @Marck-Wong
            哦,是这样,agent时代上下文累积太快了,100多确实小了点。 我也是最后稳定在了245k。

            Marck WongM
            Marck WongM
            Marck Wong
            发表于 最后由 编辑
            #9

            @fcme 我不太懂 我就是设置了 autocompact 80% 所以不会用满256k

            fcmeF 1 条回复 最后回复
            0
            • Marck WongM Marck Wong

              @fcme 我不太懂 我就是设置了 autocompact 80% 所以不会用满256k

              fcmeF
              fcmeF
              fcme
              王侯将相
              发表于 最后由 编辑
              #10

              @Marck-Wong
              80%就对了,你要再高了的话,那个模型就崩了。80%就是说在256k的8%大概也就是两百k左右压缩就启动了,因为再往上涨的话,你上下文太长了,塞给显卡,显卡就卡死了。

              个人的repo,欢迎指教
              https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
              https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

              1 条回复 最后回复
              0
              • kop wangK
                kop wangK
                kop wang
                易有太极
                发表于 最后由 编辑
                #11

                不同的LLM执行框架对于上下文压缩有不同的要求。比如sglang就要求你最后一次会话的所剩上下文空间要大于单次最长输出token数量。否则就报429

                虚心交流,一起进步

                1 条回复 最后回复
                1
                • E
                  E
                  Enigma
                  体面乡绅 硕果累累
                  发表于 最后由 编辑
                  #12

                  谢谢分享,回头去做

                  1 条回复 最后回复
                  0
                  • 系统 于 取消固定此主题
                  • ,kop wangK kop wang 引用了 此主题
                  • W
                    W
                    wml-ai
                    体面乡绅 硕果累累
                    编写于 最后由 编辑
                    #13

                    @kop-wang
                    大神有没有升级Strata到0.2以上的版本?我也是RTX PRO 5000,一直跑着0.1.43版本,很稳,看到Strata更新很积极,但是似乎没有针对RTX PRO 5000的优化。不知道大神有没有升级测试?

                    Windows-Mac-Linux-AI

                    kop wangK 懒人烘培懒 2 条回复 最后回复
                    0
                    • W wml-ai

                      @kop-wang
                      大神有没有升级Strata到0.2以上的版本?我也是RTX PRO 5000,一直跑着0.1.43版本,很稳,看到Strata更新很积极,但是似乎没有针对RTX PRO 5000的优化。不知道大神有没有升级测试?

                      kop wangK
                      kop wangK
                      kop wang
                      易有太极
                      编写于 最后由 编辑
                      #14

                      @wml-ai 0.2.x版本本质上就是0.1.45以及以上内核,提升了一点效率。

                      一个是默认状态不是贪心算法了,也就是温度是1,而不是0。但是速度基本没降。
                      一个是对于nvfp4而言,优化了一些吞吐效率,目前我的普遍经验是nvfp4能跑到大概3500t/s的prefill,130t/s的decode。

                      我目前基本已经不用IQ3_XXS了。

                      虚心交流,一起进步

                      W 1 条回复 最后回复
                      0
                      • kop wangK kop wang

                        @wml-ai 0.2.x版本本质上就是0.1.45以及以上内核,提升了一点效率。

                        一个是默认状态不是贪心算法了,也就是温度是1,而不是0。但是速度基本没降。
                        一个是对于nvfp4而言,优化了一些吞吐效率,目前我的普遍经验是nvfp4能跑到大概3500t/s的prefill,130t/s的decode。

                        我目前基本已经不用IQ3_XXS了。

                        W
                        W
                        wml-ai
                        体面乡绅 硕果累累
                        编写于 最后由 编辑
                        #15

                        @kop-wang 说:

                        @wml-ai 0.2.x版本本质上就是0.1.45以及以上内核,提升了一点效率。

                        一个是默认状态不是贪心算法了,也就是温度是1,而不是0。但是速度基本没降。
                        一个是对于nvfp4而言,优化了一些吞吐效率,目前我的普遍经验是nvfp4能跑到大概3500t/s的prefill,130t/s的decode。

                        我目前基本已经不用IQ3_XXS了。

                        我跑的是Q4_K_XL,和nvfp4速度差不多,decode略慢,看起来暂时没有升级的动力了。

                        Windows-Mac-Linux-AI

                        kop wangK 1 条回复 最后回复
                        0
                        • W wml-ai

                          @kop-wang 说:

                          @wml-ai 0.2.x版本本质上就是0.1.45以及以上内核,提升了一点效率。

                          一个是默认状态不是贪心算法了,也就是温度是1,而不是0。但是速度基本没降。
                          一个是对于nvfp4而言,优化了一些吞吐效率,目前我的普遍经验是nvfp4能跑到大概3500t/s的prefill,130t/s的decode。

                          我目前基本已经不用IQ3_XXS了。

                          我跑的是Q4_K_XL,和nvfp4速度差不多,decode略慢,看起来暂时没有升级的动力了。

                          kop wangK
                          kop wangK
                          kop wang
                          易有太极
                          编写于 最后由 编辑
                          #16

                          @wml-ai 从理论上讲,50系的4bit量化,nvfp4相对而言收益更多一些,但差异不大。

                          虚心交流,一起进步

                          1 条回复 最后回复
                          0
                          • W wml-ai

                            @kop-wang
                            大神有没有升级Strata到0.2以上的版本?我也是RTX PRO 5000,一直跑着0.1.43版本,很稳,看到Strata更新很积极,但是似乎没有针对RTX PRO 5000的优化。不知道大神有没有升级测试?

                            懒人烘培懒
                            懒人烘培懒
                            懒人烘培
                            王侯将相
                            编写于 最后由 编辑
                            #17

                            @wml-ai 我和你一样,没有升级。没有对显卡的优化可以不升级

                            双 7900 XTX:模型本地跑,Token 随便烧!

                            1 条回复 最后回复
                            0
                            • M
                              M
                              mudfox
                              编写于 最后由 编辑
                              #18

                              学习了,同PRO5000 48G 显卡

                              1 条回复 最后回复
                              0
                              • kop wangK kop wang

                                前言:strata最近已经火出圈了,火到RAM又翻了个倍。目前京东自营,海力士颗粒的64GB的DDR5 6000内存已经几近破万。

                                十一长假回来,笔者也是暂时小试牛刀了一把,发现有一些关键参数,会直接影响整个LLM引擎的本质体验,但是默认值并不是特别合理。所以发个tips小文供大家交流。欢迎批评指正。

                                本文全程手打,无任何AI含量,请放心阅读。
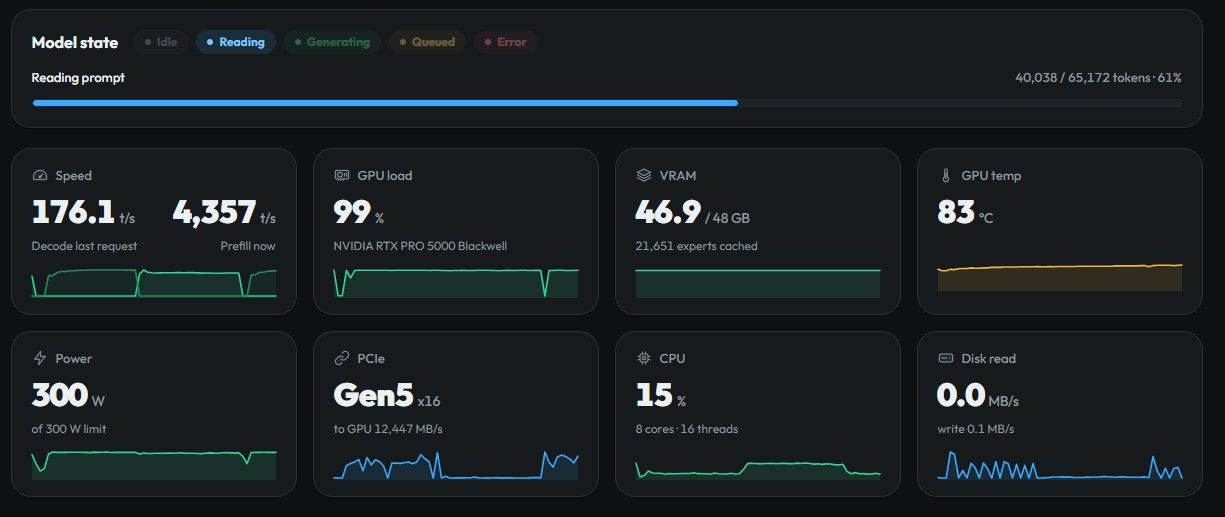
                                image.jpeg


                                1、Harness会频繁唤起子代理(sub agent),导致切换会话prefill浪费太多时间,怎么办?

                                答:开启--conversation-cache-mib

                                这个参数会让strata使用RAM来缓存历史对话,从而不让LLM反复重新prefill老的session。增加会话切换时的速度,对于agent、harness场景有奇效。

                                开启conversation-cache-mib后,monitor面板会有如下展示:
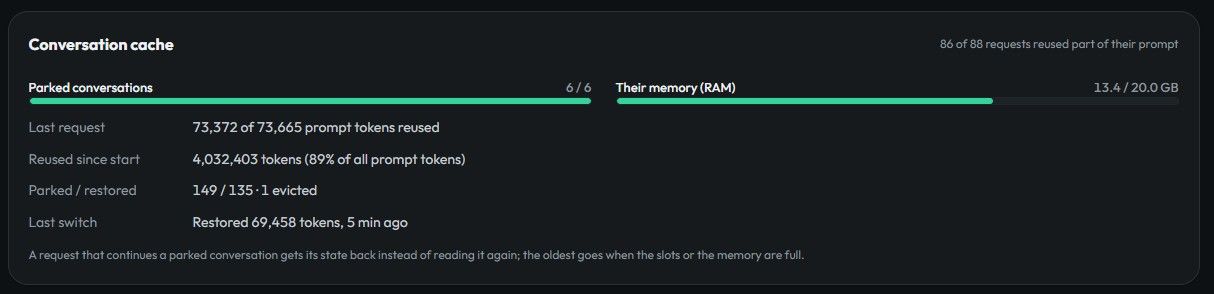
                                image.jpeg

                                分别表述当期缓存了多少个会话,以及目前占用了多少RAM。

                                这个机制有两个痛点:1、不支持多显卡。2、最大只支持20GB的对话缓存(如果是8bitkvcache,大概就是4各半的262k context)。


                                2、我的显卡显存总是占不满,浪费一些,怎么破?

                                答:配置--expert-cache,不要用auto档位。手动指定

                                让更多的专家进驻显存。注意,手动指定的是下限,所以要反复测试量力而行。


                                3、我想使用上文的conversation-cache,但是我RAM都快满了,怎么办?

                                答:启用低内存模式:--resident-experts

                                小科普,正常默认情况下,strata加载的专家是内存+SSD加载全量,vRAM加载高命中概率专家。相当于RAM和vRAM之间,是有一定的重复加载的。

                                官方这样指定默认值是有道理的,一旦VRAM的专家没能命中,直接可以读取RAM的进入vRAM。
                                代价就是这会导致RAM的极大浪费。

                                通过配置低内存模式,能够让vRAM+RAM分别加载不同专家,分工合作。这样能节省巨量RAM。代价是一旦VRAM中的专家没能命中,除了从RAM读取以外,还要从vRAM剔除一个回写到RAM。但相较于直接节省40GB的RAM空间而言,这点回写简直可以忽略不计。而且你显卡的显存越大,遇到回写的概率越低。
                                笔者的是48GB的 rtx pro 5000,专家命中率一直保持在99%。


                                4、我想多个聊天会话一起聊(并发),怎么办?
                                答,配置parallel: X(X是并发会话数,最大8)

                                会占用显存,我个人实测,IQ3_XXS量化下,会话长度262k,每个并发占用5.2GB显存。

                                以上,欢迎列为交流,指正。最后列出我个人的全套参数,供各位参考。

                                "args": [
                                  "--pack", "C:\\work\\Strata-data\\packs\\iq3_xxs",
                                  "--native", "C:\\work\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00001-of-00002.gguf",
                                  "--ple-gguf", "C:\\work\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00002-of-00002.gguf",
                                  "--expert-profile", "C:\\work\\Strata\\data\\expert-profile.bin",
                                  "--resident-experts",
                                  "--expert-cache", "19000",
                                  "--prefill", "auto",
                                  "--spec", "4",
                                  "--mtp", "C:\\work\\Strata-data\\mtp\\rt",
                                  "--max-context", "262144",
                                  "--kv", "k8v4",
                                  "--vision", 
                                  "--vram-reserve-mib", "3400", 
                                  "--pcie-frac", "0.00", 
                                  "--spec-min-p", "0.70",
                                  "--conversation-cache-mib", "20480",
                                  "--conversation-cache-slots", "6",
                                  "--conversation-cache-min-free-mib", "13824",
                                  "--prompt-cache-every", "8192"
                                 ],
                                
                                fcmeF
                                fcmeF
                                fcme
                                王侯将相
                                编写于 最后由 fcme 编辑
                                #19

                                @kop-wang
                                Strata的并发是假并发,实际上是排队的。不过你卡牛逼,速度快体验会好很多吧

                                个人的repo,欢迎指教
                                https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                                https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                kop wangK 1 条回复 最后回复
                                0
                                • fcmeF fcme

                                  @kop-wang
                                  Strata的并发是假并发,实际上是排队的。不过你卡牛逼,速度快体验会好很多吧

                                  kop wangK
                                  kop wangK
                                  kop wang
                                  易有太极
                                  编写于 最后由 编辑
                                  #20

                                  @fcme 如果配置parallel: X,从技术上讲是假并发,从效果上讲是真并发(热缓存,可以实现并排decode)。但是总token输出速度甚至会因为batch不支持mtp反降。

                                  和vllm以及sglang的并发有很大不同。这个取决于他是借鉴的llama.cpp的一部分引擎逻辑。

                                  这个并发,其实主要是和conversation-cache相对而言的。
                                  不配置并发,就是纯排队,会有队列queue列出。但是就可以通过conversation-cache机制在RAM实现温缓存。

                                  对应的,sglang的hicache和conversation-cache也有一定渊源,具体的我没深究。

                                  虚心交流,一起进步

                                  fcmeF 1 条回复 最后回复
                                  0
                                  • kop wangK kop wang

                                    @fcme 如果配置parallel: X,从技术上讲是假并发,从效果上讲是真并发(热缓存,可以实现并排decode)。但是总token输出速度甚至会因为batch不支持mtp反降。

                                    和vllm以及sglang的并发有很大不同。这个取决于他是借鉴的llama.cpp的一部分引擎逻辑。

                                    这个并发,其实主要是和conversation-cache相对而言的。
                                    不配置并发,就是纯排队,会有队列queue列出。但是就可以通过conversation-cache机制在RAM实现温缓存。

                                    对应的,sglang的hicache和conversation-cache也有一定渊源,具体的我没深究。
                                    fcmeF
                                    fcmeF
                                    fcme
                                    王侯将相
                                    编写于 最后由 编辑
                                    #21

                                    @kop-wang
                                    对,那是这样,和我的体感和测试结果是一致的。你的卡太快了,所以即使排队的话,某种程度上也可以等效的认为是并发,卡弱一点体验下来就差很多😂😂

                                    个人的repo,欢迎指教
                                    https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                                    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                    1 条回复 最后回复
                                    0

                                    你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                    厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                    有了你的建议,这篇帖子会更精彩哦 💗

                                    注册 登录
                                    回复
                                    • 在新帖中回复
                                    登录后回复
                                    • 从旧到新
                                    • 从新到旧
                                    • 最多赞同


                                    • 登录

                                    • 登录或注册以进行搜索。
                                    • 第一个帖子
                                      最后一个帖子
                                    0
                                    • 版块
                                    • 最新
                                    • 标签
                                    • 热门
                                    • 用户
                                    • 群组