
RTX 5080 跑 Qwen 约 70–100 tok/s(request 样本):我把 Codex 的部分 ticket 交给本地模型
-
这几天我把本地 Qwen 接进了 Codex 的日常 workflow。现在的分工是:主 agent 明确 scope,Qwen 做部分 reader/coder ticket,主 agent 再做 validation。
目前看,scope 明确、结果容易检查的 ticket,值得交给它。我有一个 coding 样本,cloud uncached input 从 42,612 降到 16,228;代价也很直接:完成时间从约 71 秒变成 154 秒。我愿意多等一会儿,但还不能说整个 workflow 已经省了六成 tokens。
前一帖讲的是 44 分钟做出 3D 鹈鹕骑行 demo。这一帖单独放到 AI Agent 板块,讲后续的分工和 token 记录。
本地速度够用,完整 ticket 仍然要等
机器是 RTX 5080 16GB + Ryzen 7 9700X + 64GB DDR5-6000,Windows 上跑官方 Strata;model 是 SC117 的 Qwen3.8 Flash-Next Uncensored,IQ3_XXS。Codex 通过 OpenCodex 接入。
原帖的 Strata 0.1.41 截图里,单次 request 的 Decode 有 69.4、72.6 tok/s,另一个执行中瞬时读数是 101.9 tok/s。标题的“约 70–100 tok/s”取自这些 request 样本,不是整场均速,也不是所有 prompt 都有这个速度。256K 是当时配置的 context 容量,没有做满 256K 的 speed benchmark。
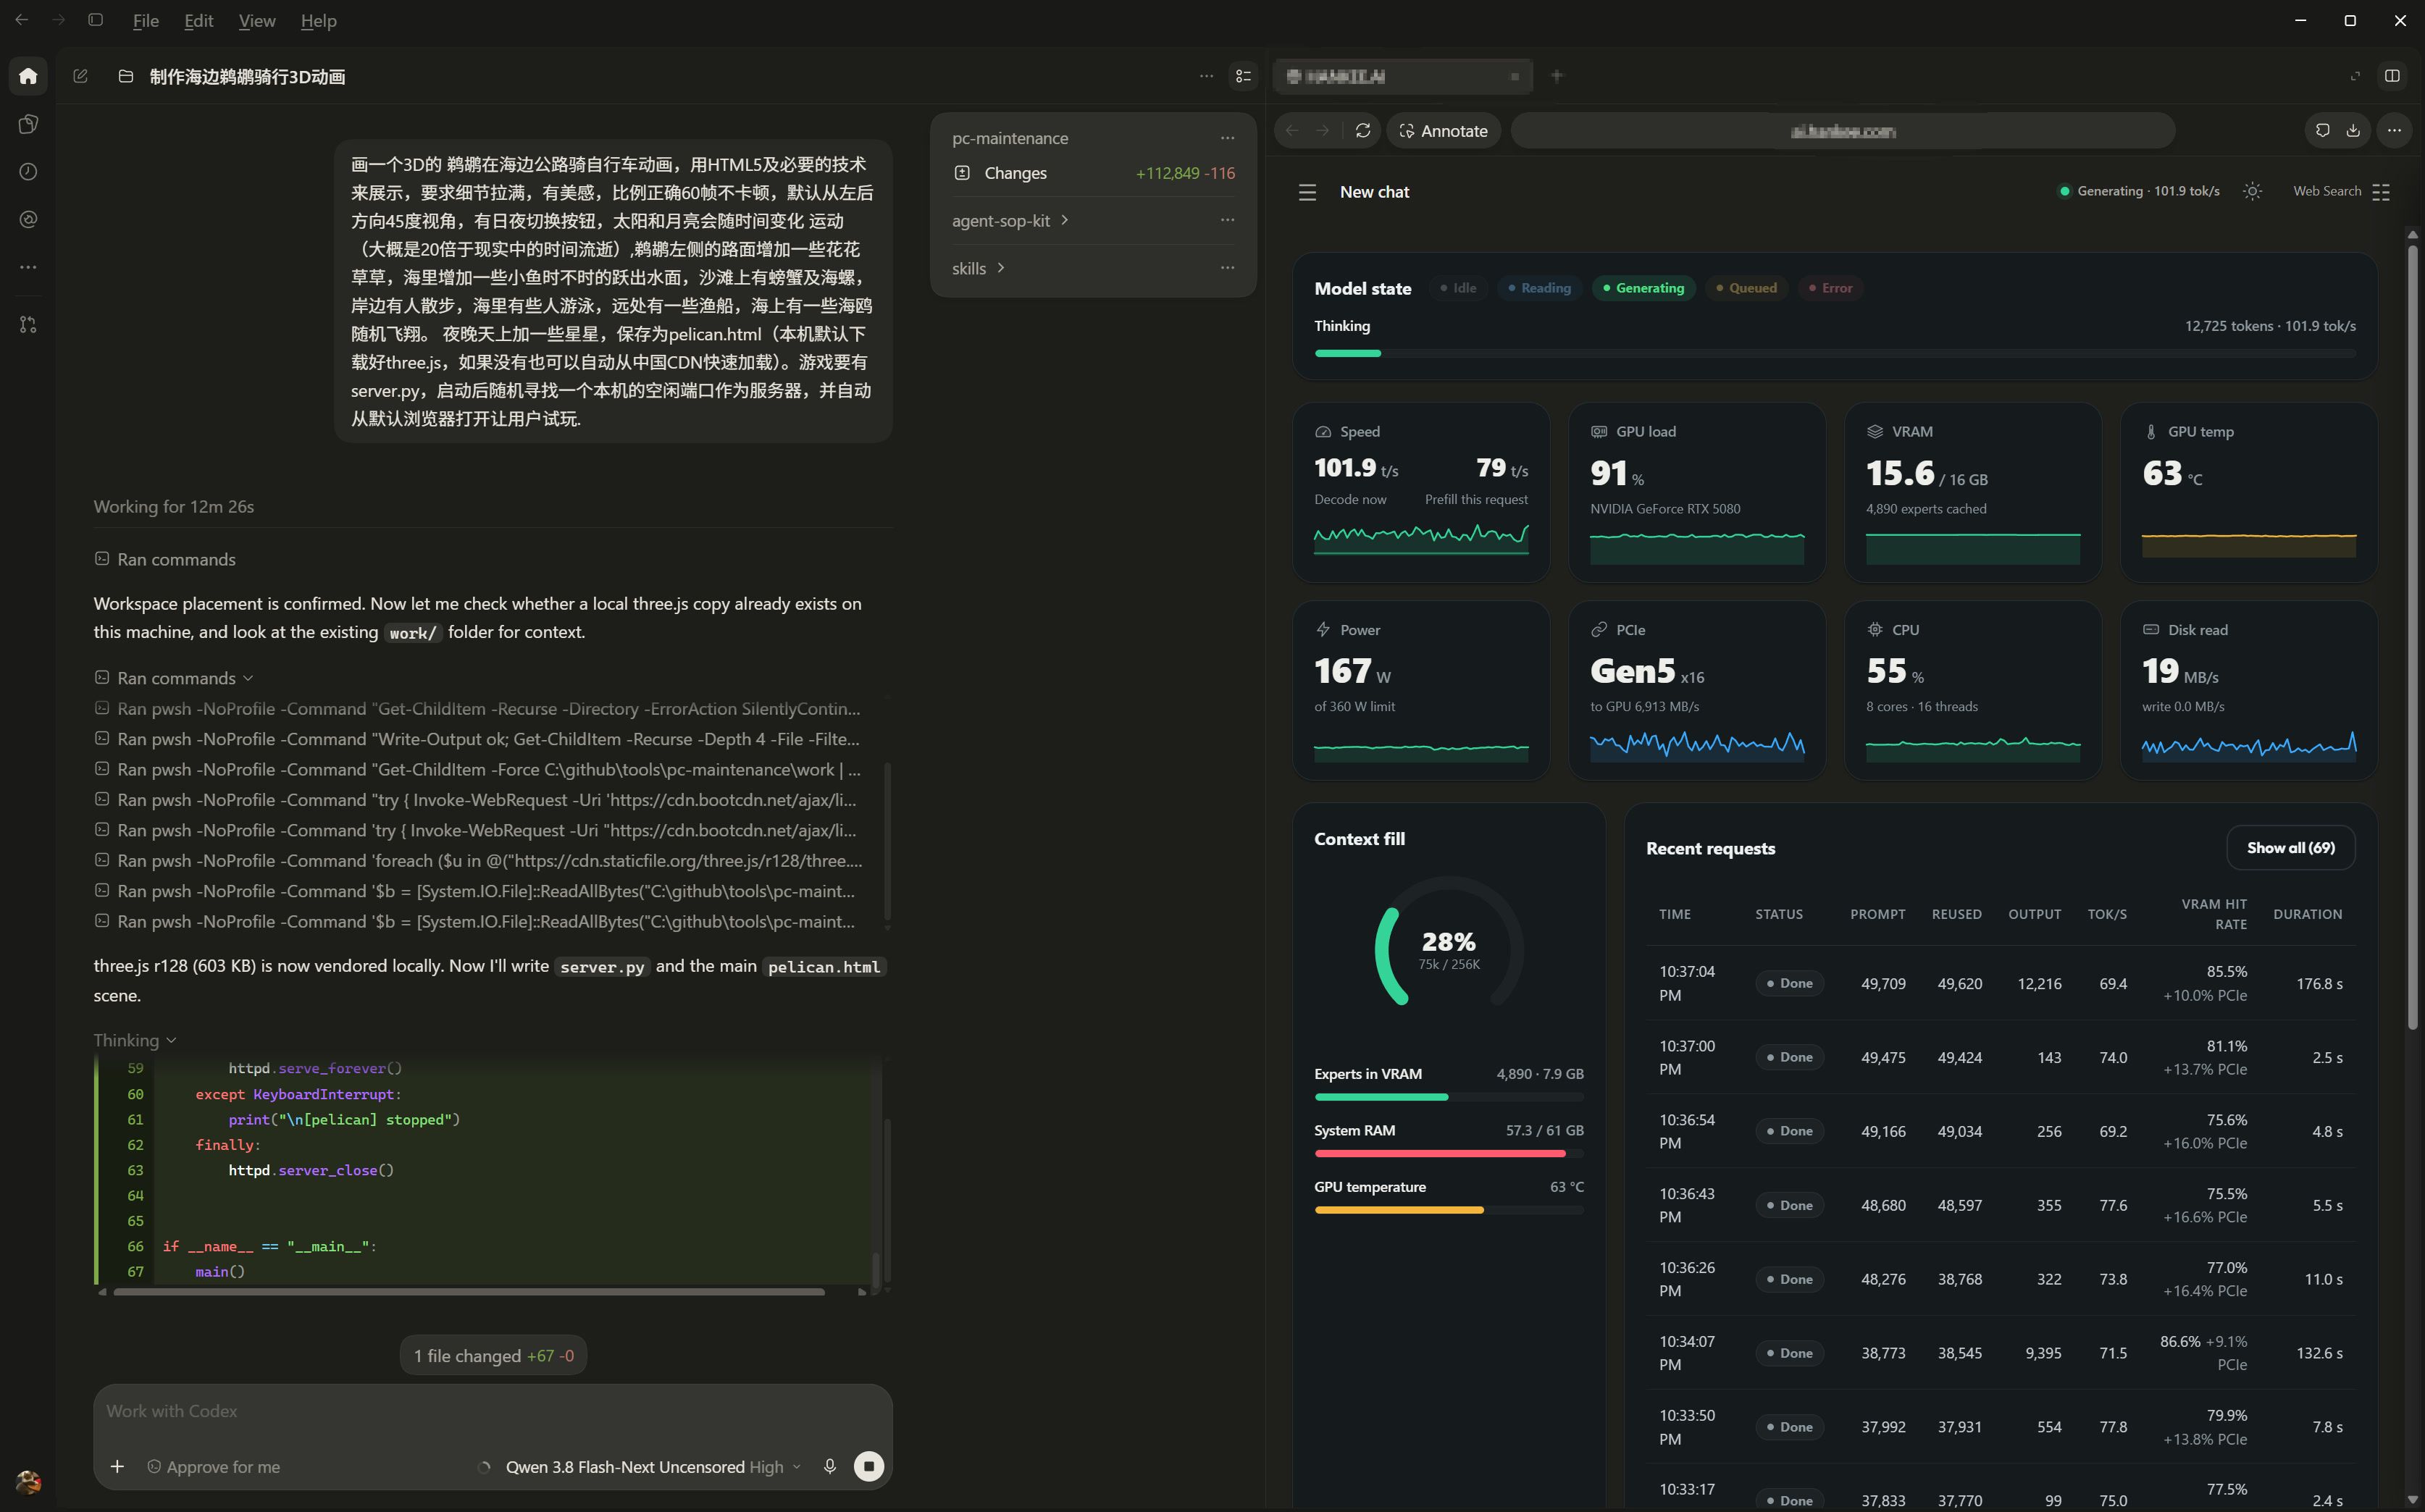
这是前一帖的真实执行截图。Decode 是 model 吐 tokens 的速度;读取 files、调用 tools、跑 checks 和 repair 都要另外花时间。
我具体交给 Qwen 什么?
目前 Codex 里主要是两类:
- Reader ticket:指定 code/docs 范围,提取 facts、分类和引用。能提供完整 source packet 时,就不让 worker 再到处找 files。
- Coder ticket:实现 scope 已明确、可以独立验证的行为。完整的 text sources 可以走 patch coder,由主 agent 执行 checks。
比如已有的实际 ticket 是给 comparison report 增加 metadata fields。Qwen 的 candidate 经主 agent 独立 checks 后被采用。现有记录主要还是 Strata integration 内的 ticket 和 regression pilot,我还没有把所有业务 project 都迁过去。
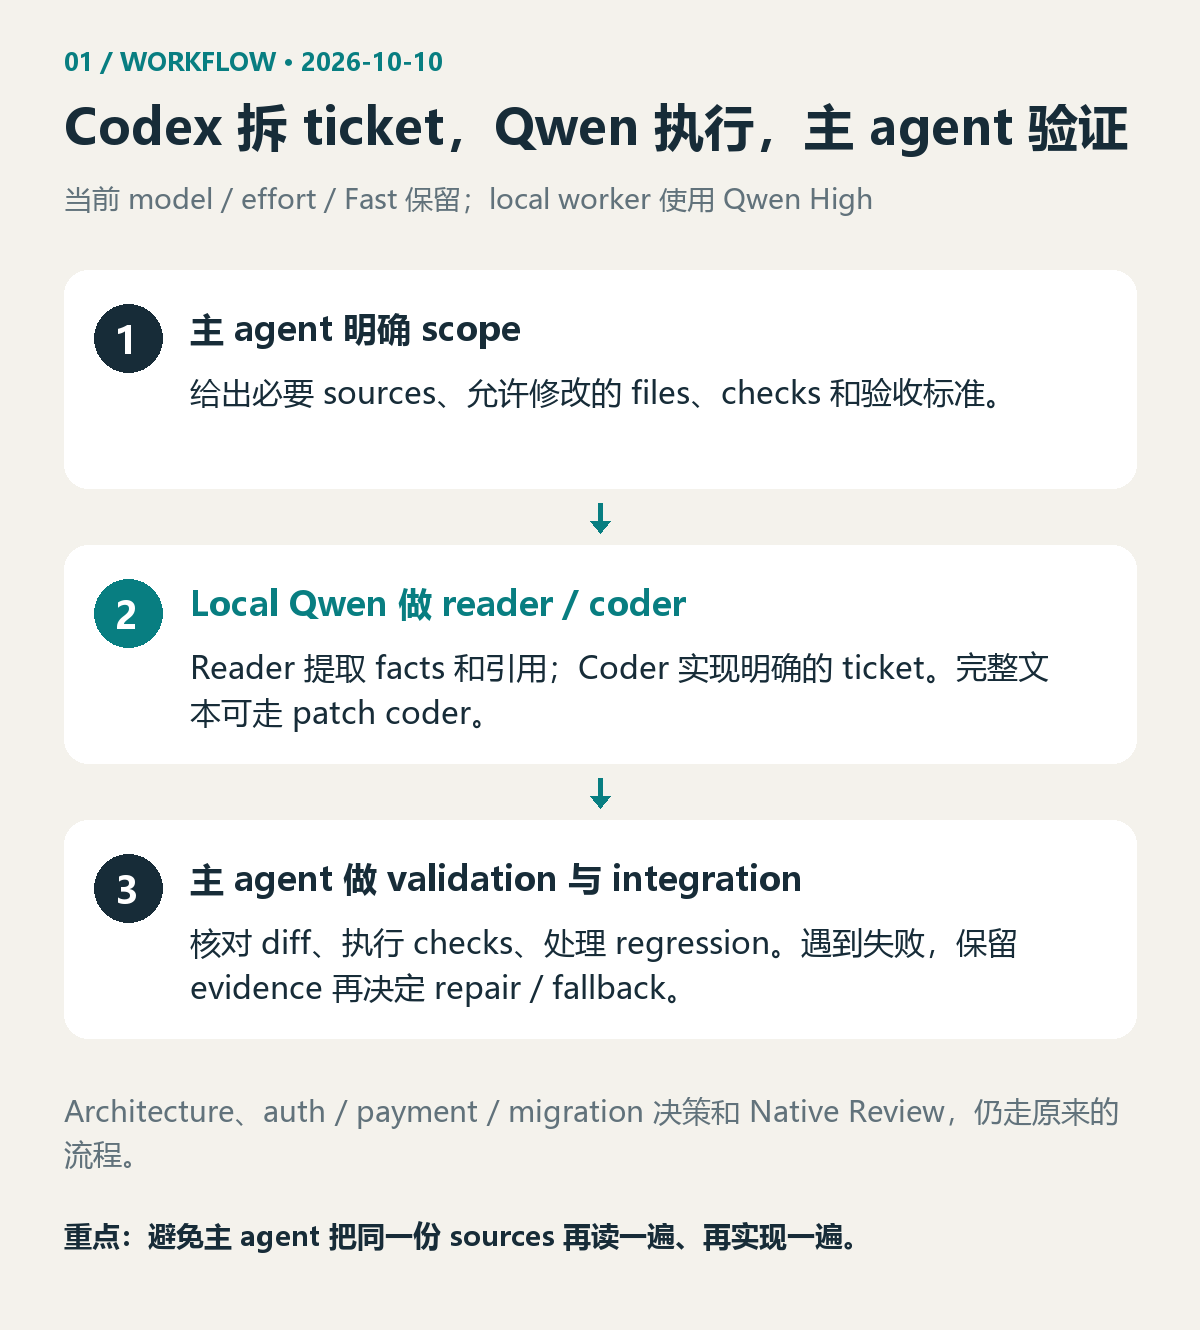
我仍然打开原来的 Codex chat,正常描述需求。主 agent 的 model、effort、Fast 保留;适合的 ticket 才启动一个新的 Qwen High worker。
最需要避免的是重复劳动:主 agent 先读完 sources、想好实现,再让 Qwen 从头做一次。 Ticket 的 scope、允许改的 files、checks 和验收标准要提前明确。主 agent 保留独立 validation、integration 和 fallback;architecture、auth/payment/migration 决策,以及 high-risk Native Review 继续走原流程。Tiny changes 直接做,mechanical work 用 scripts。
一个 ticket 到底少用了多少 cloud tokens?
这组记录来自 2026-10-09,同一干净 starting state、同一 scope 和 source packet,也用了同一组独立 checks。Cloud 直接做与 Qwen + 主 agent validation 的数据如下:
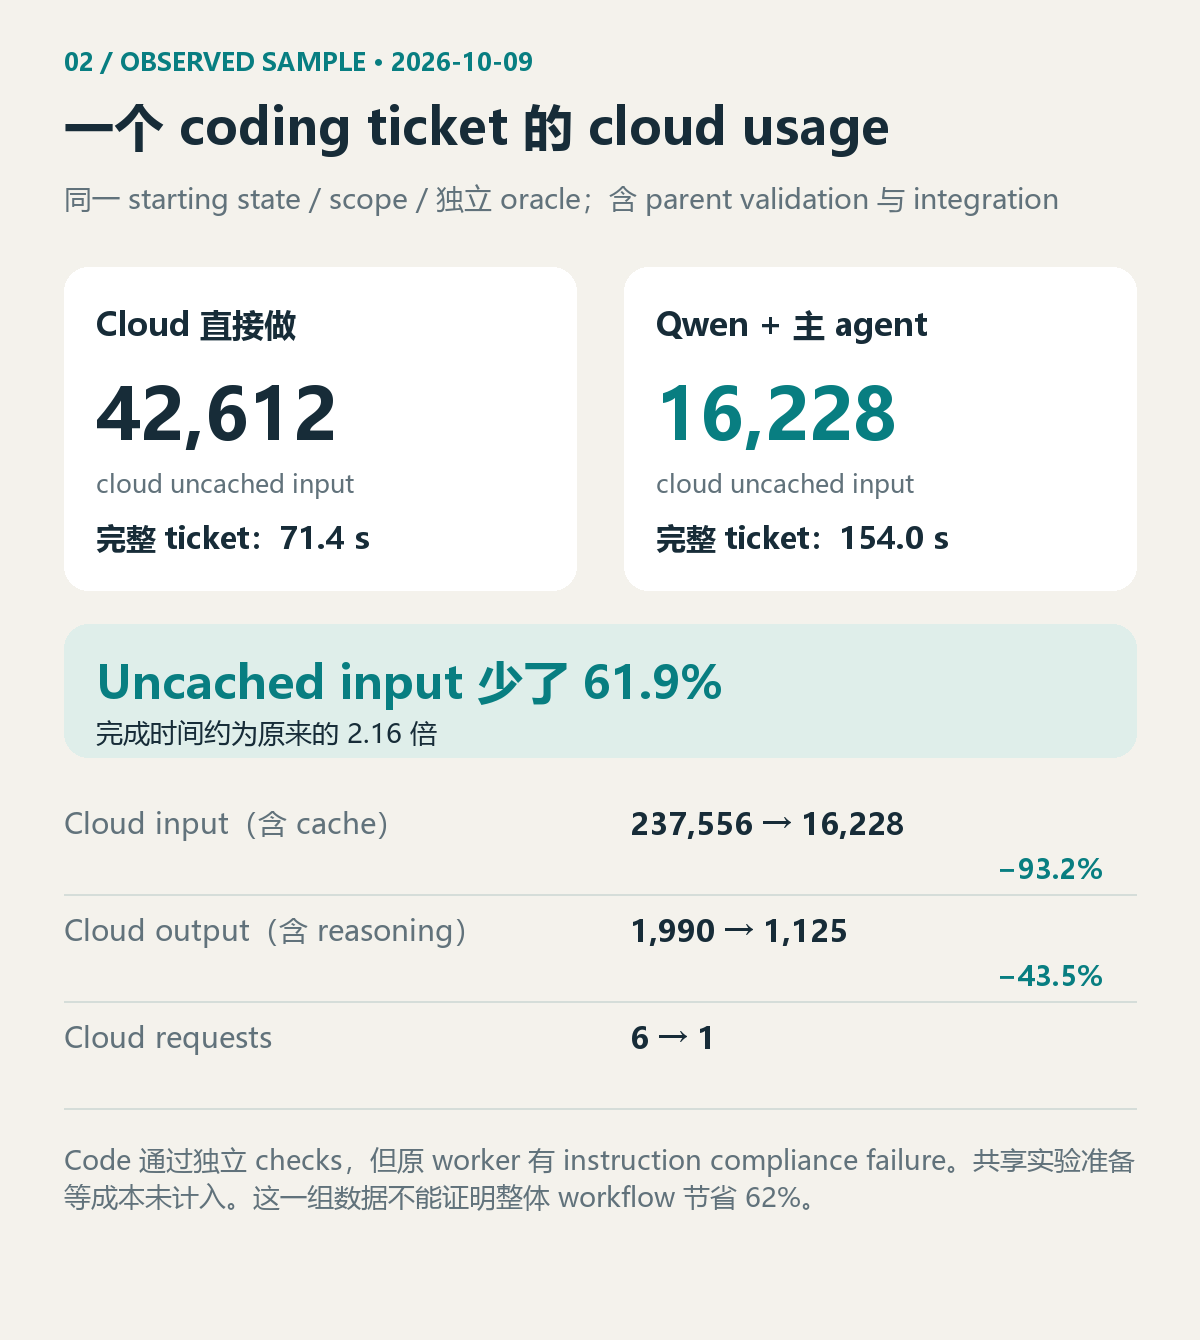
这个 ticket 的记录 Cloud 直接做 Qwen + 主 agent Cloud requests 6 1 Cloud input,含 cache 237,556 16,228 Cloud uncached input 42,612 16,228 Cloud output,含 reasoning 1,990 1,125 完成时间 71.4 秒 154.0 秒 对应减少 93.2% / 61.9% / 43.5%。我更关注 uncached input 的 61.9%;含 cache 的 93.2% 看起来很大,但不能拿它直接说订阅 quota 或费用少了这么多。
这次 code 通过了独立 checks,主 agent 没有重新实现 code。但 worker 曾在 command 失败后继续执行,违反 stop-at-failure 规则;这项 instruction compliance failure 保留在原记录里,后来 helper 增加了 stop gate。
统计包含这个 ticket 的 preparation、执行和主 agent validation/integration,未计入共享实验准备等成本。这只是一个 ticket 的实测,整体收益还需要继续记录。
刚才我也追问了:整个 workflow 能省多少?
我问了两个问题:“现在有哪些流程是放在 Qwen 跑的?”以及“预计这样可以减少多少 token 消耗?”下面是本次对话的重新排版摘录,方便在手机上看;不是原 chat 界面截图。
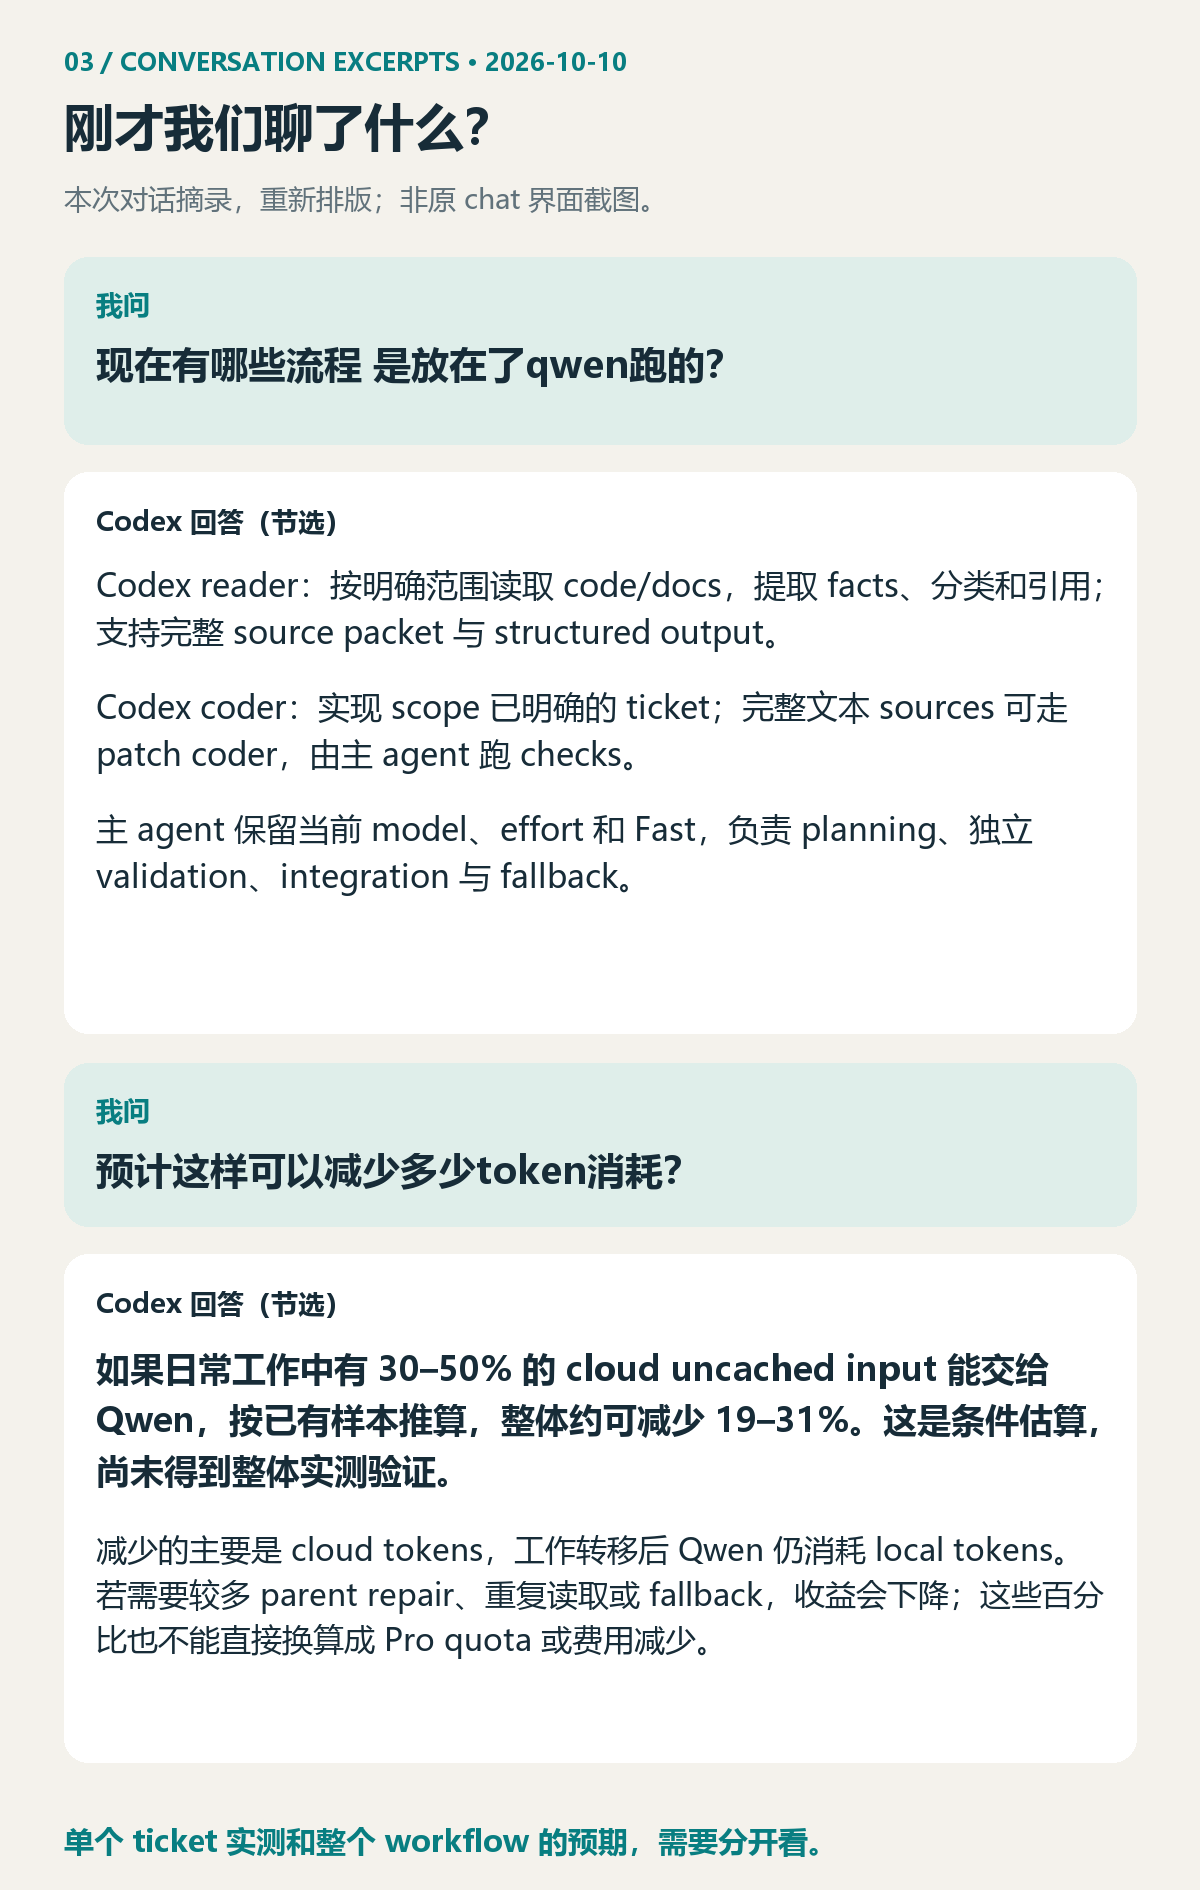
回答里的 19–31% 是条件估算:假设原有 cloud uncached input 有 30–50% 对应的工作适合转给 Qwen,而且单 ticket 减少比例接近这次的 61.9%,算出来约是 19–31%。目前没有整个日常 workflow 的实测结果,repair、重复读取和 fallback 还会影响它。
Qwen 自己仍然消耗 local tokens;转移的是 cloud 请求及其 context。这些数字不能直接换算成 Pro quota 或费用。
我现在会继续怎么用
有明确 scope、能用 checks 判定结果的 reader/coder ticket,我会继续交给 local Qwen;需要判断方向和承担风险的部分,继续由主 agent 负责。 我接受这类 ticket 更慢,前提是 code 通过独立 validation,而且能看到实际减少了哪些 cloud 请求。
对我而言,这次最有用的进展是把本地 model 接成了一个可检查的 worker。后面会继续记完整 ticket 的时间、cloud usage 和 parent repair,而不是只看 tok/s。
本文根据我的实测记录和刚才的对话整理,文字与配图有 AI 协助。大家如果也在用 cloud 主 agent + local worker,欢迎交流实际的分工、repair 成本和完整 ticket 耗时。
-
,
 T terry 固定了此主题
-
-

