
[記錄] Google縮減線上免費版能力 , 新手自建本地Qwen 3.8 27b
-
感謝此處的各位大師的精華貼, 讓新手的我可以少走歪路.
剛10月9日, Google縮減線上免費版能力, 只提供flash-lite版AI, 更不再支持讀取文件. 個人本地自建LLM貌似更有必要了.....雖然現在人人都在玩strata, 但我決定不急慢慢學習. 先從llama+Qwen開始. 想在此貼記錄一下自己的步伐. 純新手貼. 多多包涵.1)無頭電腦llama.cpp(headless):
i5 13400
DDR4 3200 16GBx2
內顯 UHD730
7900xtx 24GB所用模型, 文件和驅動:
win11 26H2
AMD驅動 26.10.41.05 (電源消耗減10%)
llama-b11540-bin-win-vulkan-x64 (vulkan版)
Qwen3.8-27B-UD-Q4_K_XL
mtp-Qwen3.8-27B-Q4_0AI啟動指令:
代码文本
.\llama-server.exe ^
  -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf ^
  --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf ^
  -dev Vulkan1 ^
  -ngl 999 ^
  --fit off ^
  -c 262144^
  -b 4096 ^
  -ub 512 ^
  --cache-type-k q4_0 ^
  --cache-type-v q4_0 ^
  -np 1 ^
  --spec-type draft-mtp ^
  --spec-draft-n-max 2 ^
  --flash-attn on ^
  --host 0.0.0.0 ^
  --port 8080 ^
  --jinja ^
  -lv 4
結果:
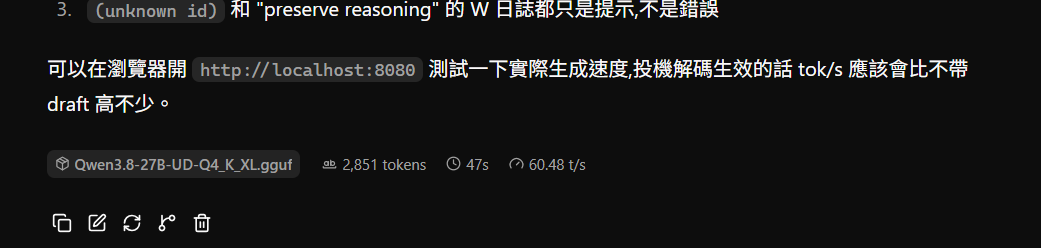
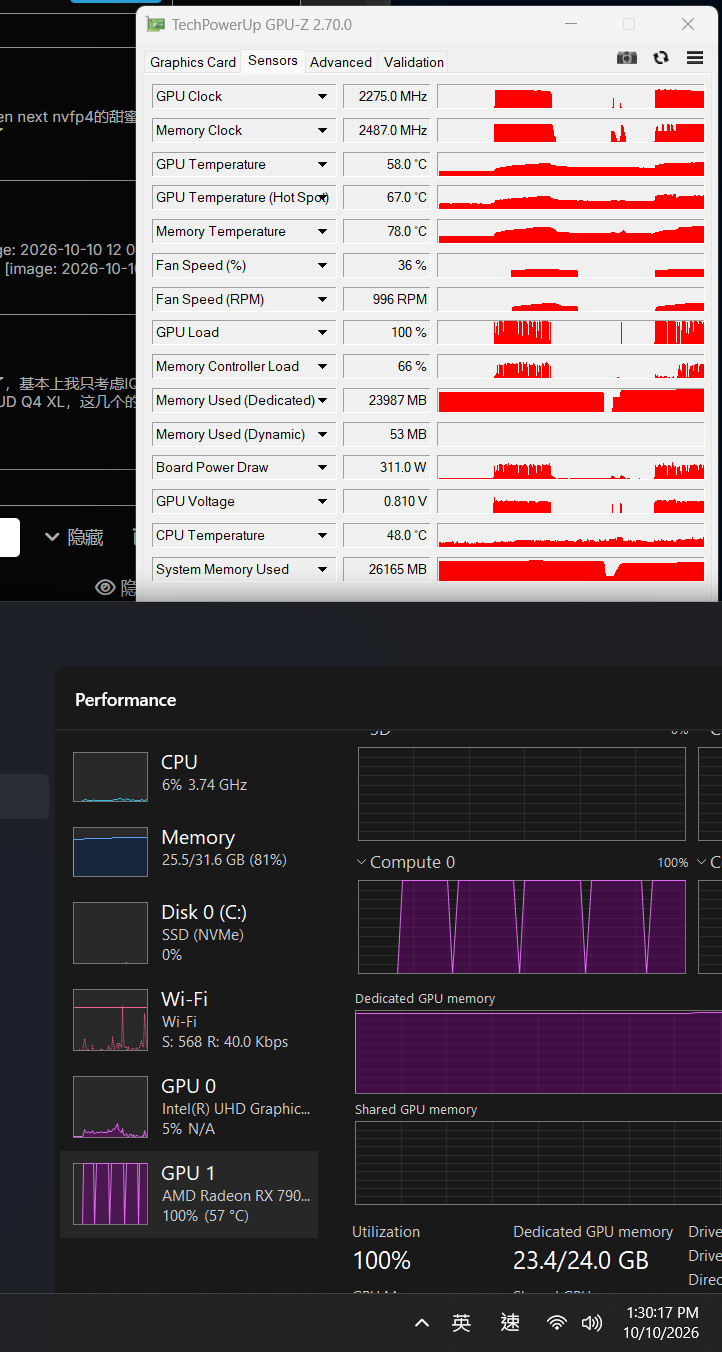
配置256k上下文的能力, VRAM使用剛好23.4GB, 7900xtx剛好可以處理沒有OOM. 我也很好奇, 為什麼人人都只配64k? 不配置128k呢? 另外, token每秒生成的速度大約60. 不知是不是達標了, 但感覺很可以.
這裡必須說一下, 有些llama的版本會出現獨顯閒置時, llama強制清空VRAM, 把模型塞回RAM內. 當你發問時, 才把模型由RAM塞回VRAM中. 這個是一個bug, 原因是因為win/AMD十分進取的省電策略, 再加上無頭電腦, 當獨顯閒置時, window強制把VRAM清掉省電. 我看老外都有回報, 解決方法就是確保AMD驅動使用最新, llama的版本就用最新的幾個輪流替換試試. 問題就可以解決.
下一步必須跑通comfyui+Minimax H3. 謝謝大家
-
