
如何實現雙顯卡用Ninfer跑DF2 的Qwen 3.8 27B NVFP4(Prefill > 10K , C8 > 1K)
-
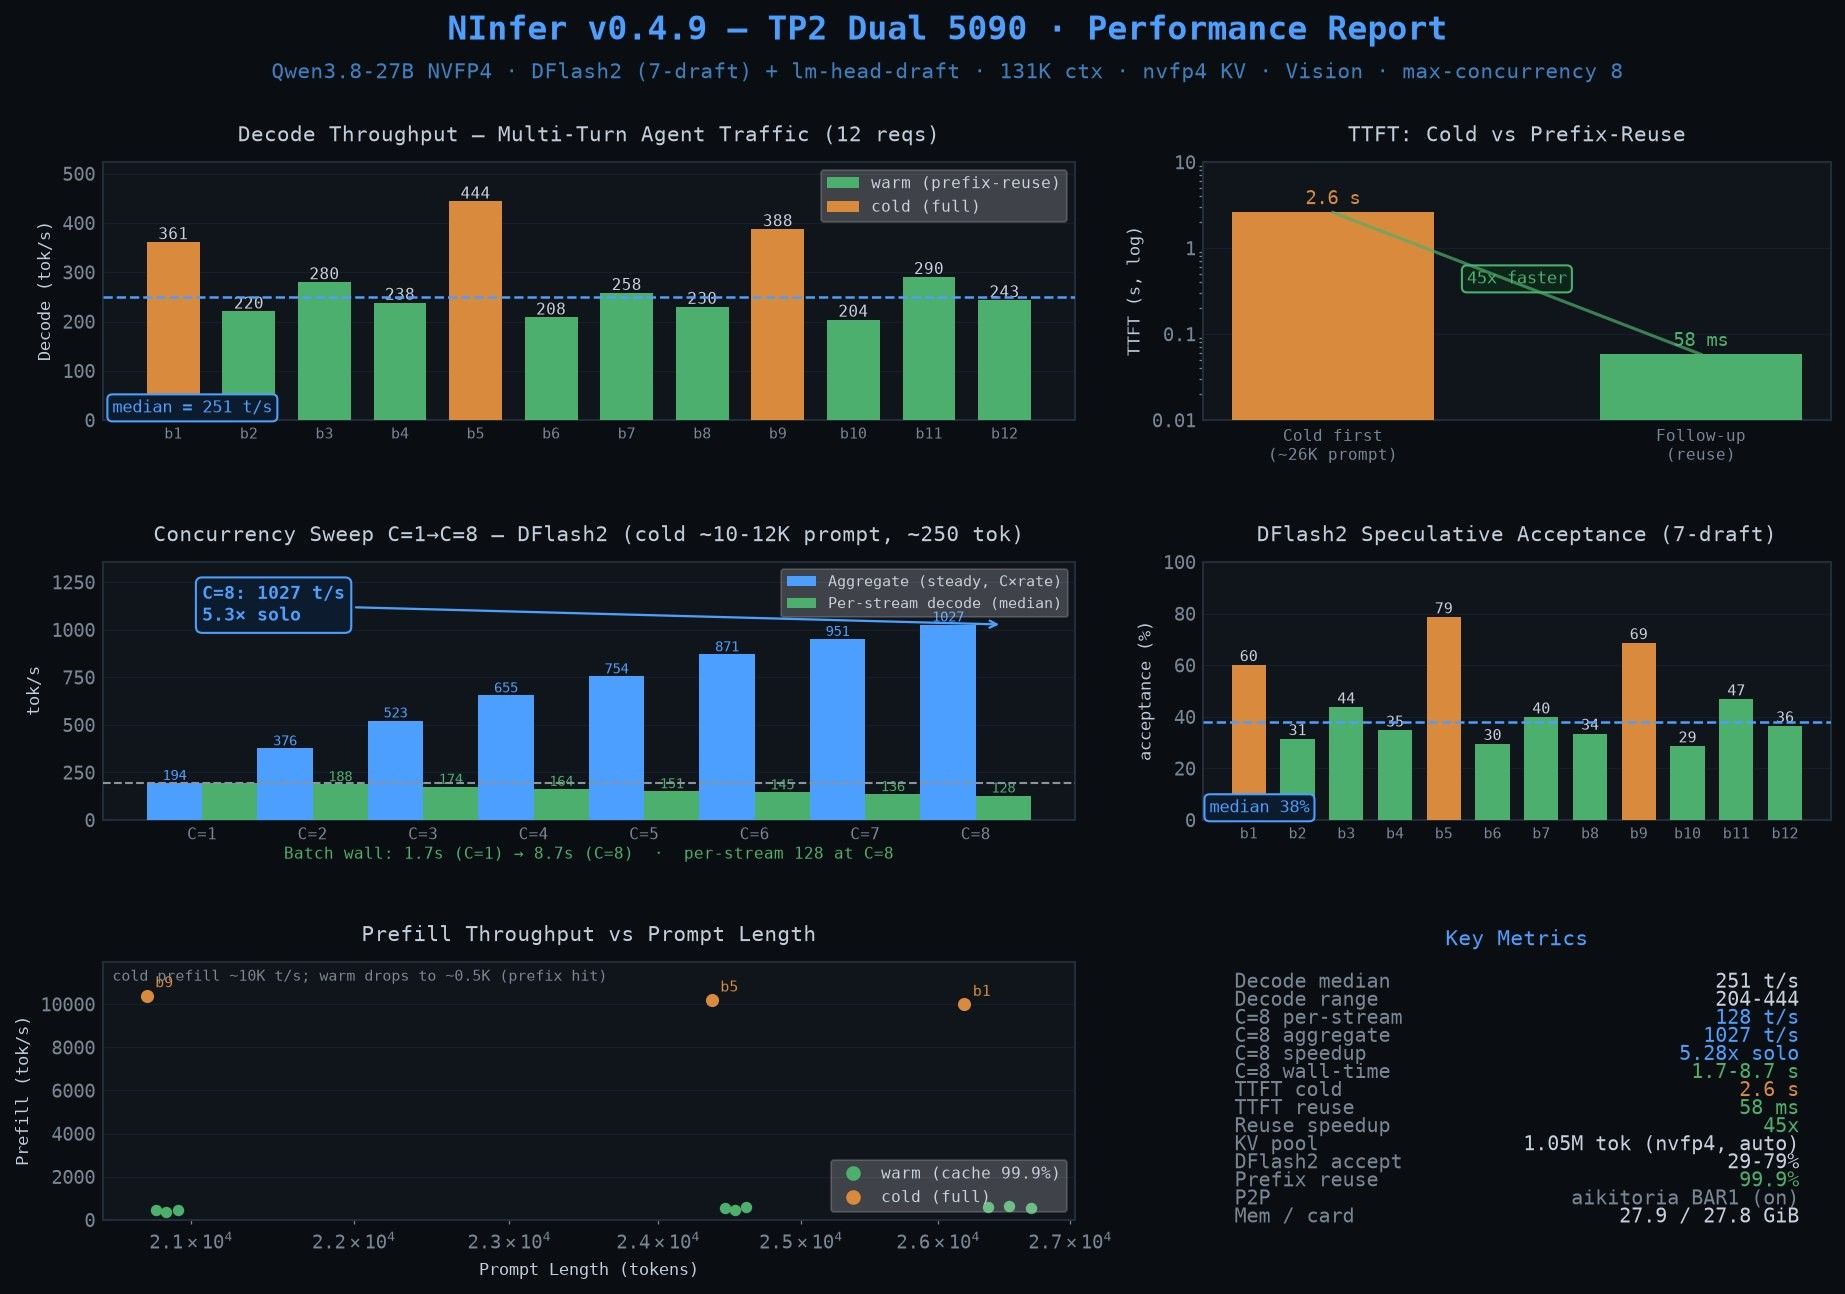
這應該是我最後一篇Qwen 3.8 27B
下一次就等Qwen4出來了1. 引用技術(哪些開源元件)組合方式因人而異,我是偏好拿自己的積木來組合,你也可以全抄開源的方法
整套腦拆成五塊,底料三塊是第三方,整合是我們的:
環節 來源 模型權重 Qwen3.8-27B(阿里)+ 官方 nvfp4 量化工具 推論引擎 NInfer(ValerioDolci 開源,C++ spin-wait + CUDA graphs,不用 NCCL) P2P 直連 aikitoria fork(fork 自 tinygrad)+ NVIDIA 615.71.09 開源驅動 整合 / 調校 雙卡分片、vision tower、KV pool、並發口徑——實戰調出來的 幾個關鍵定位:
- P2P 直連是 PCIe BAR1 GPU
 GPU 直傳,不是 NVLink、也不是裸 PCIe 經 host bounce。走 aikitoria patch 開的 BAR1 視窗,實測 28.5 GB/s(~90% Gen5 x8 天花板)。
- 雙卡各直掛 CPU die 的 Gen5 x8 root port(無 switch),ReBAR 把 BAR1 開到各 32G。
2. 裝配步驟(從無到有)
4步,順序依賴 1→2→3→4(前一步的產物是後一步的前置)。
2.1 裸機驅動 + P2P patch(從無到有)
目標:
nvidia-smi topo -p2p r雙向 OK、實測 28.5 GB/s。2.2 Build 推論引擎 binary
由 source 產
ninfer-serve。關鍵是 CUDA arch 要傳120a(5090/Blackwell):成功判據:
Found CUDAToolkit 13.1+Found libavformat+ 無CMake Error,末尾Linking CXX executable apps/ninfer-serve。2.3 模型 artifact(nvfp4 + DF2 drafter)
用 NInfer 官方 convert 工具,Qwen3.8-27B → nvfp4、融合 DF2 81 個 drafter tensor:
2.4 起 TP2 + DF2 + vision production
核心啟動命令
setsid nohup "$BIN" "$MODEL" \
  --host 0.0.0.0 --port 12435 \
  --tp 2 --devices 0,1 \
  --max-context 131072 \
  --kv-dtype nvfp4 --kv-capacity auto \
  --max-concurrency 8 --prefill-chunk 32768 \
  --spec dflash2 --draft-tokens 7 --lm-head-draft \
  --default-max-tokens 16384 \
  --vision --vision-device 0 --media-cache-mib 256 --media-live-mib 512 \
  --model-id qwen38-nvfp4-mtp >>LOG 2>&1 </dev/null 200>&- &
4. 避坑(這部份請你家AI幫忙念!!!!!!!!!!!!!!)
驅動 / P2P
- 595 GSP firmware 建不出 BAR1 P2P mailbox → 固定 615.71.09;Ubuntu 更新蓋掉用 restore 腳本還原。
- 閒置 PCIe 掉 Gen1 是正常 ASPM 省電,有負載立刻爬回 Gen5 x8。測 link 爬升用真實 compute 負載(torch matmul),別用
nvidia-smi -lgc(只鎖時鐘、不打滿 link、且拖垮後續 bench;用過務必-rgc/-rac復位)。
Build
CMAKE_CUDA_ARCHITECTURES不傳120a→NInfer supports only CMAKE_CUDA_ARCHITECTURES=120a。必傳 + 用對 CUDA 版本。- ffmpeg
libavformat not found→PKG_CONFIG_PATH沒指向 deps。
Artifact / spec
- convert 必用
python3 -m模組模式,直接跑腳本會ImportError。 - 含 dflash2 權重的 artifact 在舊 fork 的
--tp 2下必炸(shard_mapping無 dflash2 branch)。正牌解 = 用 rebase 到 upstream 的 binary(有 dflash2 機制 + 補 TP2 split wiring)。 --spec dflash2缺--lm-head-draft→ DF2@TP2 硬性要(源碼 guard,缺則 throw)。
KV / memory
- KV dtype 決定 pool 尺寸:nvfp4 ≈ int8 的 1/2 bytes/token,混配 = 啟動即 OOM FATAL。用
--kv-capacity auto讓引擎依 dtype 自動 fit 卡片。 - 從 hermes
terminal(background=true)拉 server 會 OOM(worker scope 有 memcg cap)→ 用setsid nohup脫離 gateway cgroup。
Benchmark 口徑
- 比併發一定鎖 prompt 長度 + 輸出長度口徑:純 decode workload(短 prompt、長輸出)會把重 draft head 的跨卡 allreduce payload 吃滿 → per-stream -41%;生產形(長 prompt、短輸出)只 -18%。口徑不同會完全誤導結論。
- 跨 spec 比接受率沒意義:MTP 4-draft vs DF2 7-draft 分母不同。wall 吞吐才是唯一公平口徑(同 prompts、同 max_tokens、T=0)。
- tok/s 以 server 端 per-request log 為準,client SSE 會低估 ~4.5×。
雙 5090 無 NVLink 的 TP2 雙卡推論,靠 aikitoria P2P patch + NInfer 純 CUDA allreduce + DF2 重 draft 拼到 production。底料開源、整合實戰。有踩到一樣坑的歡迎對照。
- P2P 直連是 PCIe BAR1 GPU
-

