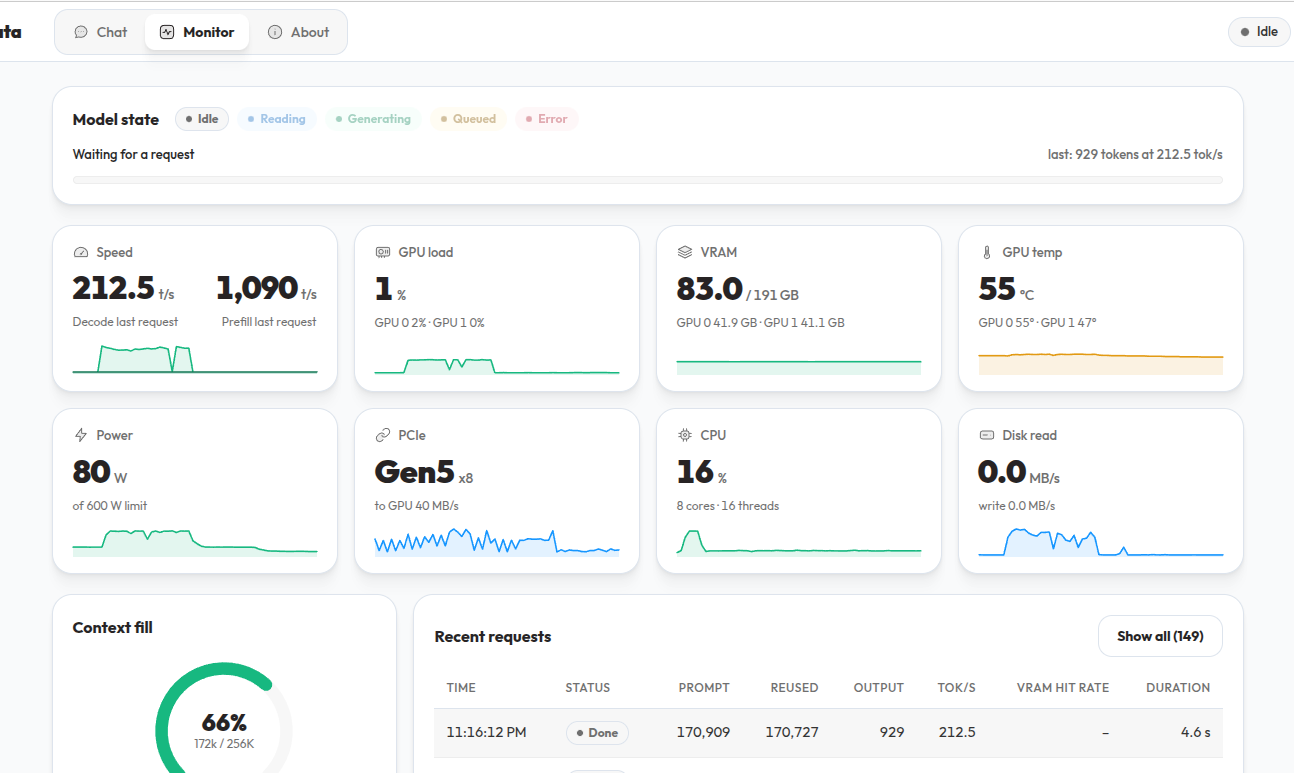
Strata低功耗双卡RTX 6000 Pro 千问Flash Next IQ4 XS 210tok/s 爽玩
-
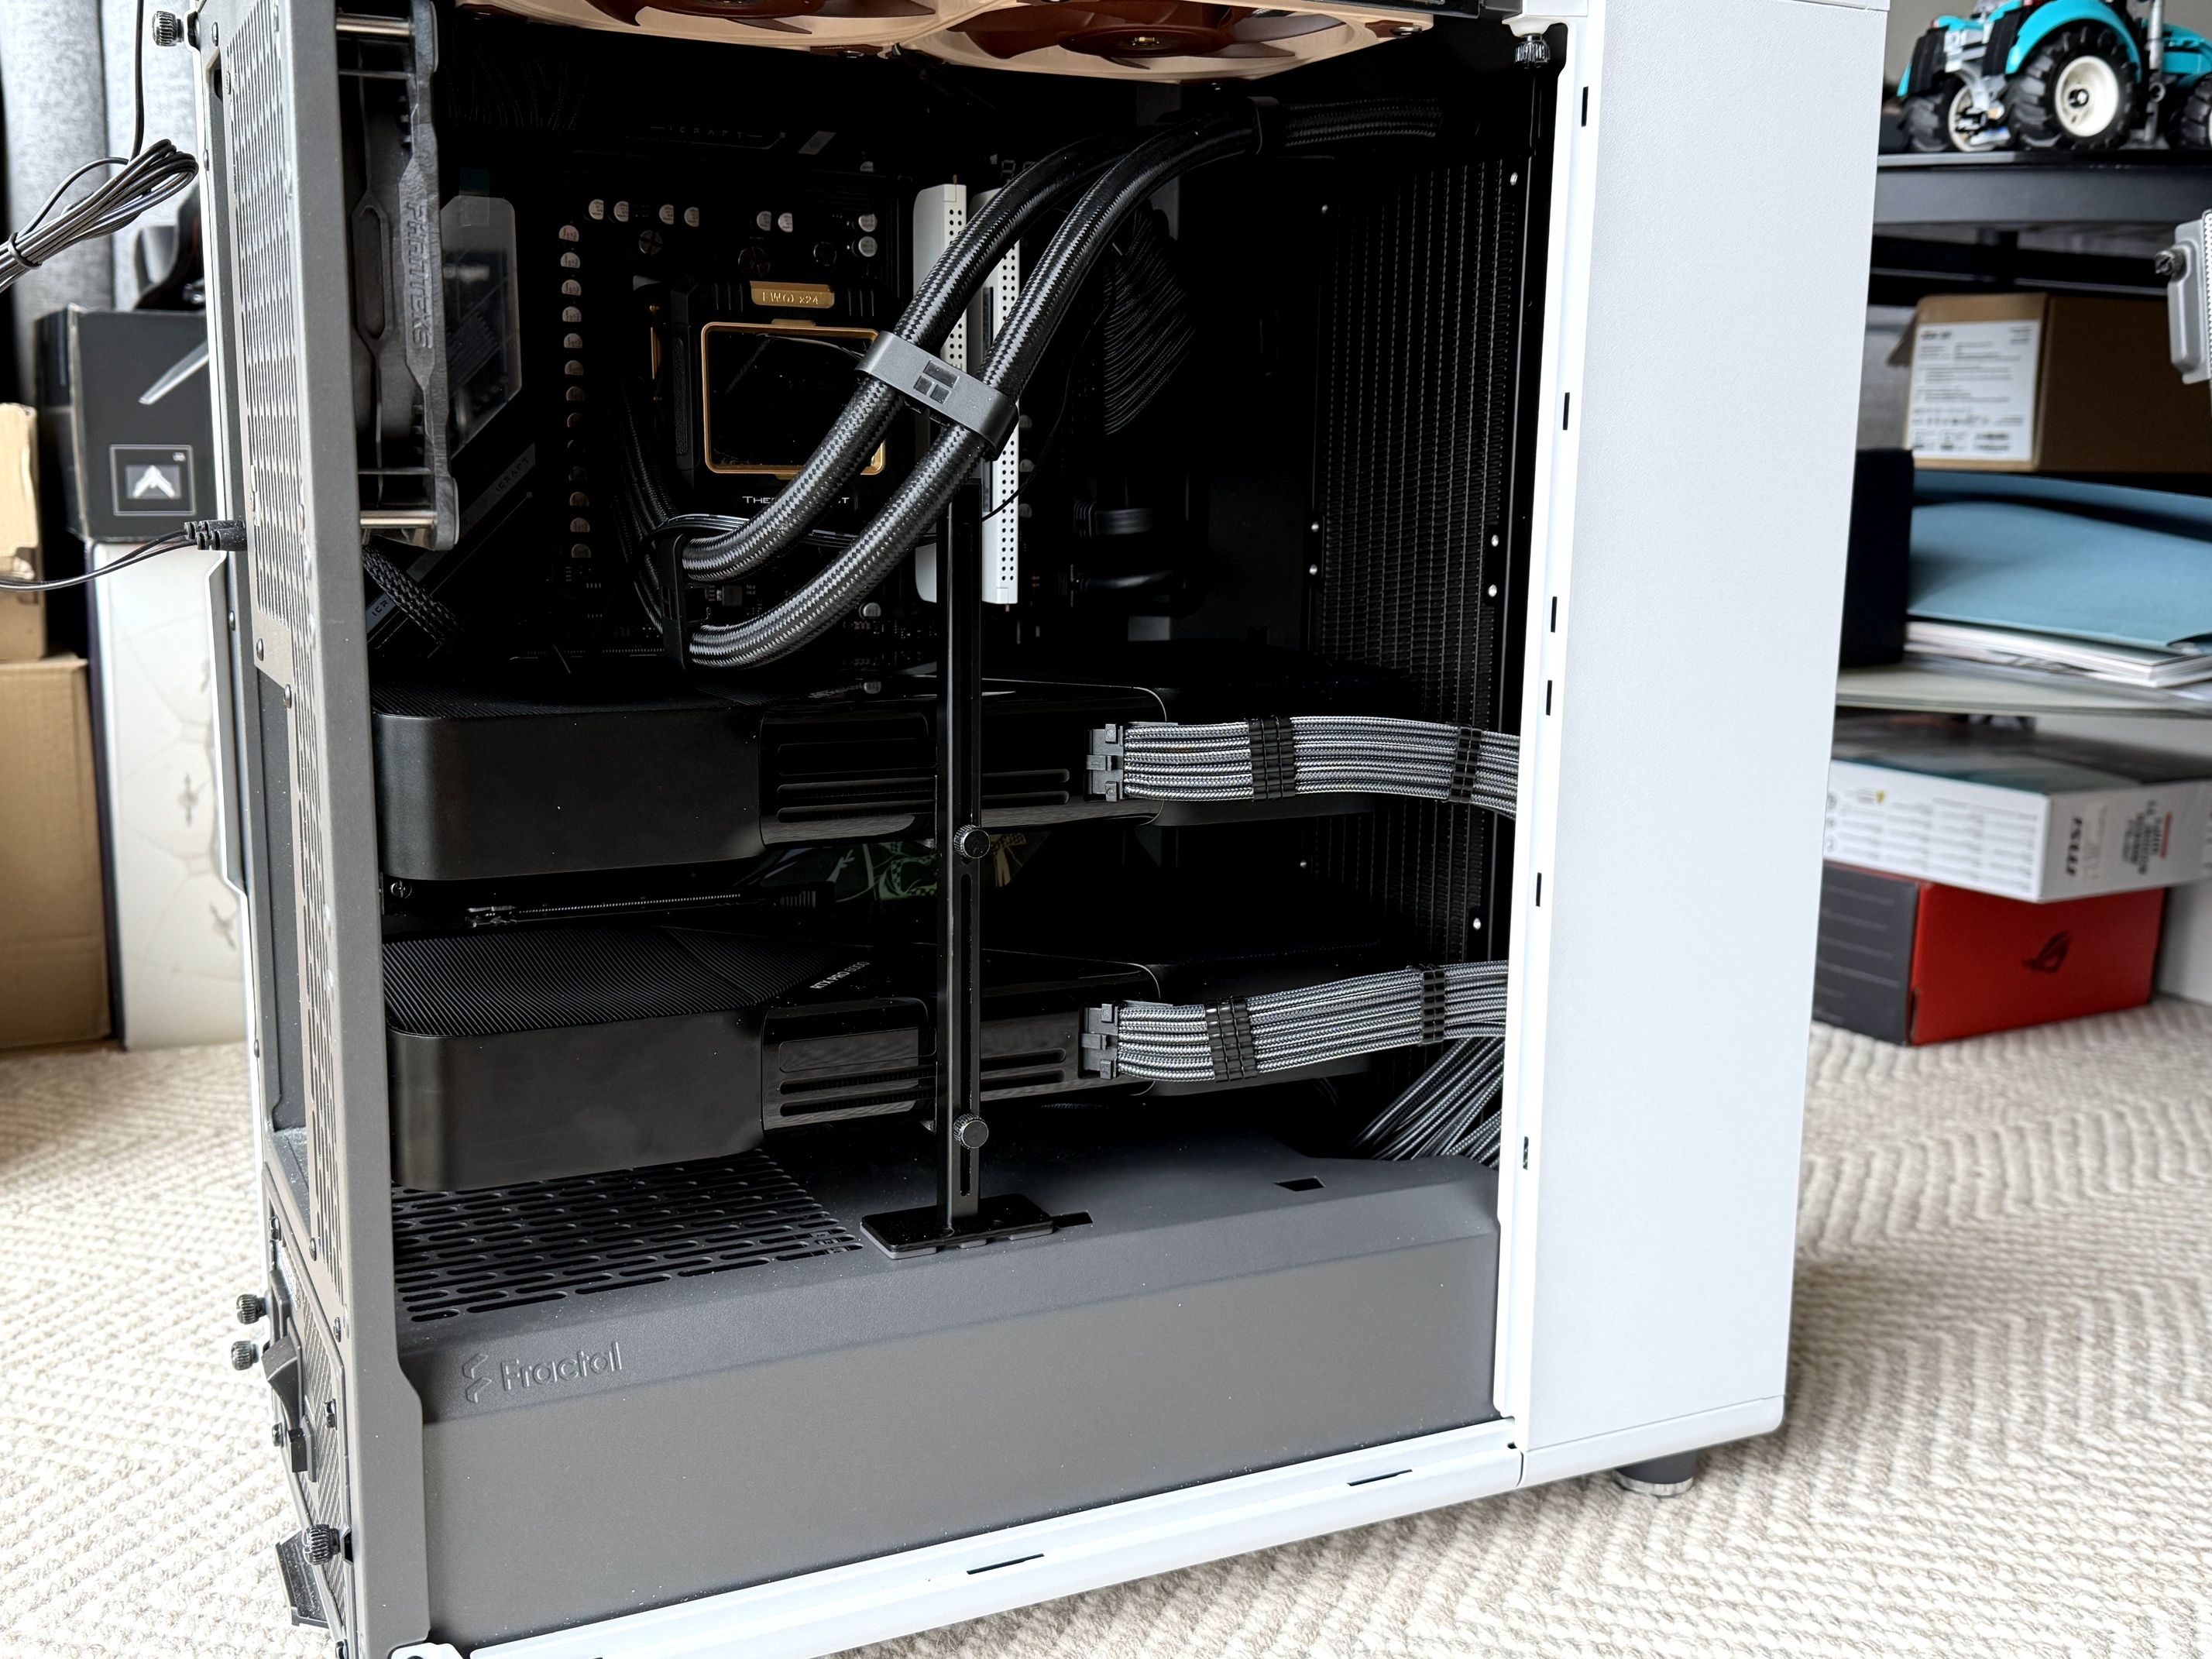
具体配置:
- CPU:AMD 9700X
- RAM:48GB DDR5 6400 CL32
- SSD:2TB Pcie 4.0 系统,2x 4TB Pcie 5.0 Swap+模型硬盘
- GPU:2x RTX 6000 Pro
- OS: Ubuntu 26.04 LTS
项目细节:
- 文件配置:https://github.com/lunarmoon26/qwen3.8-flash-next
- 模型链接:https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF/tree/main/UD-IQ4_XS
跑分:
机器照片:
-
-
-
-
-
不过双 RTX 6000 才跑到200,我能跑到 110 , 我已经非常非常欣慰了, 毕竟价格差了20倍
-
@johnnybegood 上2张r9700 很不错
@applejuice 其实在我看来, 不管是 2xR9700 还是 2x3090, 还是 2x7900xtx , 甚至是 2x3080 20G, 在我眼里都是一个档位的。 没什么太大折腾的动力。 但是太好的卡,实力又不够, 前一阵本来想咬咬牙搞 2x 4090 48G, 资金到是还可以,手头两张3090加一张3080卖了也能回不少血, 但是近期4090频繁出售后问题让我也不太敢动手了。
-
@applejuice 其实在我看来, 不管是 2xR9700 还是 2x3090, 还是 2x7900xtx , 甚至是 2x3080 20G, 在我眼里都是一个档位的。 没什么太大折腾的动力。 但是太好的卡,实力又不够, 前一阵本来想咬咬牙搞 2x 4090 48G, 资金到是还可以,手头两张3090加一张3080卖了也能回不少血, 但是近期4090频繁出售后问题让我也不太敢动手了。
@johnnybegood 之前dense 的天下 我觉得r9700 是跟3090 同档
但是如果未来是moe 的天下 r9700 就是高一档了
有fp8 有大内存 -
@johnnybegood 之前dense 的天下 我觉得r9700 是跟3090 同档
但是如果未来是moe 的天下 r9700 就是高一档了
有fp8 有大内存@applejuice 是呀, 4xR9700简直太爽了。
-
-
-
-
-
接下来应该人均5080 24gb
-
@imbiplaza-ASUS 如果卖1w倒是有可能, 如果是2-3W就太贵了
-
接下来应该人均5080 24gb
-
-
-
感谢大家的参观,统一补充一下这次测试的考虑,尤其是为什么用 Strata:
1. 这台机器优先考虑低功耗、长期开机
两张 RTX 6000 Pro 工作站版都限制到了每张 300W,不是奔着满功耗刷最高跑分去的。服务器需要 24/7 开机,选择 9700X 也是出于这个考虑。
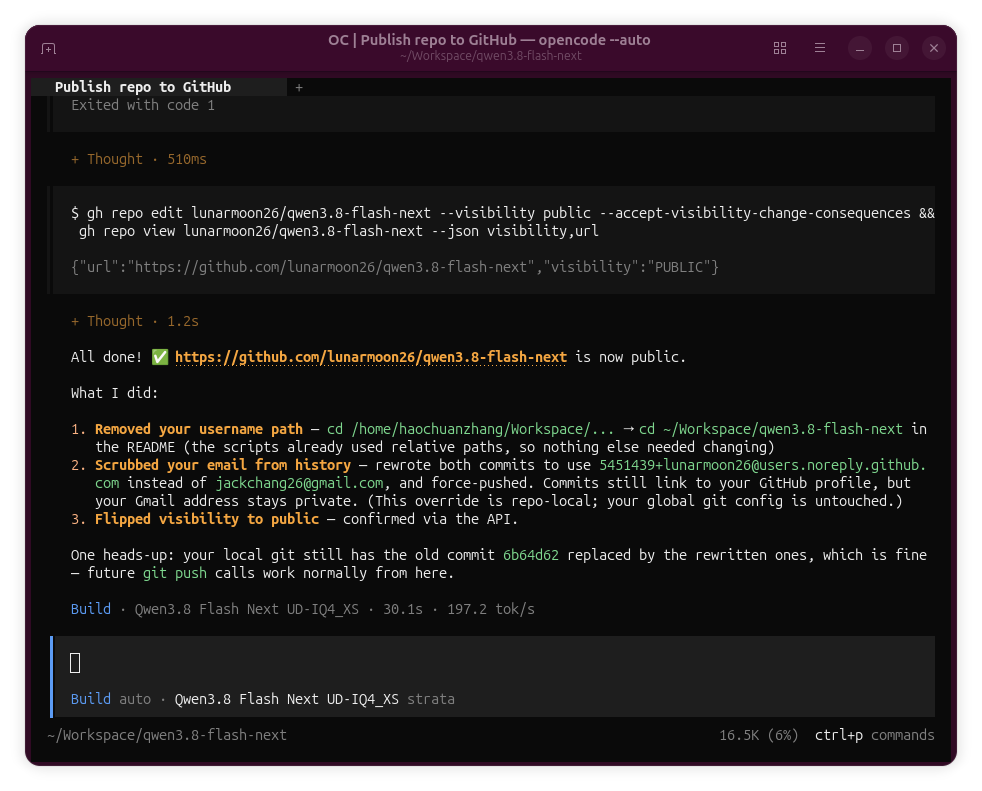
2. 关于截图里约 200 tok/s 和上下文
第二张 OpenCode 截图是实际使用时自己做的 Statsline 统计,不是统一条件下的框架对比跑分。这套配置用了 YaRN ×2,把原生 262,144 的上下文上限扩到了 524,288(约 524K)。
但配置了 524K 上限,不代表截图里的请求真的填满了 524K,也不能直接把这个速度全部归因于 RoPE 扩展。功耗限制、量化、实际输入长度、推测解码等条件都需要一起看;完整长上下文的效果也还需要单独测试。
3. 为什么显存这么大,还选择 Strata?
主要是这台机器的配置有点偏科:两张卡各有 96GB 显存,但系统内存只有 48GB。显存放得下,不代表加载过程就一定能在这点 RAM 里完成。
之前折腾 DeepSeek-V4-Flash-0731 时,我就在 vLLM 那套加载/转换流程里碰到了主机内存瓶颈,后来才用流式处理和 NVMe 上的缓存来解决。这里说的是我当时那套模型和实现的经历,不是说 vLLM 或 SGLang 都必须先把整个模型塞进 RAM:
- https://github.com/lunarmoon26/deepseek-v4-flash
- https://blog.haochuanz.net/posts/running-deepseek-v4-flash-0731-with-48gb-ram
Strata 吸引我的,是它已经有适合“小 RAM、大 VRAM”的权重加载和分层缓存机制。简单说:
- 模型文件留在 SSD 上,按需读取专家权重,通过有限的主机内存缓冲分批搬进 GPU cache,而不是先在 RAM 里保留一整份专家权重。
- 多卡按层分配;已经放进两张 GPU cache 的专家,不必再在主机 RAM 里常驻一份。放不下的部分才需要结合 RAM 预算和文件后备来处理。
- 关键是不需要先把全部专家权重同时装进系统内存,而不是完全绕过 RAM。 数据仍经过主机内存搬进显卡,不是 GPUDirect 式的 SSD 直传显存;传输缓冲、其他运行时数据和系统文件缓存仍然会占用 RAM。
我这次跑的是 Unsloth UD-IQ4_XS。项目验证记录里,双卡按层拆分后,全部 24,576 个专家都进了 GPU cache,专家缓存合计约 55.4 GiB;日志里的常驻专家 RAM 是 0 GiB。这个“0”只指专家权重的常驻 RAM 副本,不是整个程序不占内存,也不是说整个模型的所有数据都在显存里。 下载约 94GB,也不等于这些文件必须全部常驻 RAM 或 VRAM。
配置上还有一个坑:当时那个版本的 setup 在 Unsloth 多卡路径下会去掉 RAM budget,所以我先生成限额配置,再配置双卡按层拆分,保留
--resident-budget-gib 12,并让 KV cache 留在显存里。12 GiB 是专家 RAM 预算,不是整个进程的内存上限,也不是通用的一键参数。所以选择 Strata,主要是这套配置已经在我的机器上把加载和显存利用跑通了,不是在证明它一定比 SGLang 快。SGLang 我还没试,也感谢提醒,后续可以在相同模型、量化和实际上下文条件下再比较。另外这里是按层拆分,双卡也不意味着单路对话速度自动翻倍。
项目配置:https://github.com/lunarmoon26/qwen3.8-flash-next
Strata:https://github.com/Niko1221/Strata -
不过双 RTX 6000 才跑到200,我能跑到 110 , 我已经非常非常欣慰了, 毕竟价格差了20倍
@johnnybegood 但得看你的上下文是多少。一般来说60-80toks就能干活 但是得400K上下文。虽然很多模型是1m但其实400k左右是最有效的区间