跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI硬件
  4. Strata低功耗双卡RTX 6000 Pro 千问Flash Next IQ4 XS 210tok/s 爽玩

Strata低功耗双卡RTX 6000 Pro 千问Flash Next IQ4 XS 210tok/s 爽玩

已定时 已固定 已锁定 已移动 热议 AI硬件
stratartxpro6000qwen-flash
33 帖子 11 发布者 874 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • kop wangK kop wang

    楼主帖子刚发完,官方setup就支持nvfp4了……
    应该速度还能再快50~100t/s

    btw:191GB的显存,其实是可以直接sglang来运行的,为何要用strata……

    A
    A
    applejuice
    王侯将相
    编写于 最后由 编辑
    #11

    @kop-wang 其实我也想问 但是我想都用6000 pro 应该有他的道理

    1 条回复 最后回复
    0
    • terryT terry

      这么丧心病狂吗?真的是人均RTX Pro6000?

      kos orK
      kos orK
      kos or
      至尊皇帝
      编写于 最后由 编辑
      #12

      @terry said:

      真的是人均RTX Pro6000?

      LCZ論壇本來是 人均RX7900 XTX, 快變成人均 RTX Pro 6000了

      imbiplaza ASUSI 1 条回复 最后回复
      0
      • kos orK kos or

        @terry said:

        真的是人均RTX Pro6000?

        LCZ論壇本來是 人均RX7900 XTX, 快變成人均 RTX Pro 6000了

        imbiplaza ASUSI
        imbiplaza ASUSI
        imbiplaza ASUS
        谪仙人
        编写于 最后由 编辑
        #13

        @kos-or

        接下来应该人均5080 24gb

        johnnybegoodJ kos orK 2 条回复 最后回复
        1
        • imbiplaza ASUSI imbiplaza ASUS

          @kos-or

          接下来应该人均5080 24gb

          johnnybegoodJ
          johnnybegoodJ
          johnnybegood
          王侯将相
          编写于 最后由 编辑
          #14

          @imbiplaza-ASUS 如果卖1w倒是有可能, 如果是2-3W就太贵了

          imbiplaza ASUSI 1 条回复 最后回复
          0
          • johnnybegoodJ johnnybegood

            @imbiplaza-ASUS 如果卖1w倒是有可能, 如果是2-3W就太贵了

            imbiplaza ASUSI
            imbiplaza ASUSI
            imbiplaza ASUS
            谪仙人
            编写于 最后由 编辑
            #15

            @johnnybegood

            按照现在5080的市价,应该要万8

            我还记得当初5080丐版好像只要8000

            1 条回复 最后回复
            0
            • imbiplaza ASUSI imbiplaza ASUS

              @kos-or

              接下来应该人均5080 24gb

              kos orK
              kos orK
              kos or
              至尊皇帝
              编写于 最后由 kos or 编辑
              #16

              @imbiplaza-ASUS said:

              接下来应该人均5080 24gb

              大概 US$2500~3000吧
              都是用GB203晶片 不買了 😁

              除非 記憶體頻寬上 1.3T/s 才會考慮

              imbiplaza ASUSI 1 条回复 最后回复
              0
              • kos orK kos or

                @imbiplaza-ASUS said:

                接下来应该人均5080 24gb

                大概 US$2500~3000吧
                都是用GB203晶片 不買了 😁

                除非 記憶體頻寬上 1.3T/s 才會考慮

                imbiplaza ASUSI
                imbiplaza ASUSI
                imbiplaza ASUS
                谪仙人
                编写于 最后由 编辑
                #17

                @kos-or

                估计3500

                1 条回复 最后回复
                0
                • A
                  A
                  applejuice
                  王侯将相
                  编写于 最后由 编辑
                  #18

                  大佬 你应该去玩玩project maya glm5.3 flash 应该会更爽

                  johnnybegoodJ 1 条回复 最后回复
                  1
                  • lunarmoon26L
                    lunarmoon26L
                    lunarmoon26
                    体面乡绅
                    编写于 最后由 lunarmoon26 编辑
                    #19

                    感谢大家的参观,统一补充一下这次测试的考虑,尤其是为什么用 Strata:

                    1. 这台机器优先考虑低功耗、长期开机

                    两张 RTX 6000 Pro 工作站版都限制到了每张 300W,不是奔着满功耗刷最高跑分去的。服务器需要 24/7 开机,选择 9700X 也是出于这个考虑。

                    2. 关于截图里约 200 tok/s 和上下文

                    第二张 OpenCode 截图是实际使用时自己做的 Statsline 统计,不是统一条件下的框架对比跑分。这套配置用了 YaRN ×2,把原生 262,144 的上下文上限扩到了 524,288(约 524K)。

                    但配置了 524K 上限,不代表截图里的请求真的填满了 524K,也不能直接把这个速度全部归因于 RoPE 扩展。功耗限制、量化、实际输入长度、推测解码等条件都需要一起看;完整长上下文的效果也还需要单独测试。

                    3. 为什么显存这么大,还选择 Strata?

                    主要是这台机器的配置有点偏科:两张卡各有 96GB 显存,但系统内存只有 48GB。显存放得下,不代表加载过程就一定能在这点 RAM 里完成。

                    之前折腾 DeepSeek-V4-Flash-0731 时,我就在 vLLM 那套加载/转换流程里碰到了主机内存瓶颈,后来才用流式处理和 NVMe 上的缓存来解决。这里说的是我当时那套模型和实现的经历,不是说 vLLM 或 SGLang 都必须先把整个模型塞进 RAM:

                    • https://github.com/lunarmoon26/deepseek-v4-flash
                    • https://blog.haochuanz.net/posts/running-deepseek-v4-flash-0731-with-48gb-ram

                    Strata 吸引我的,是它已经有适合“小 RAM、大 VRAM”的权重加载和分层缓存机制。简单说:

                    • 模型文件留在 SSD 上,按需读取专家权重,通过有限的主机内存缓冲分批搬进 GPU cache,而不是先在 RAM 里保留一整份专家权重。
                    • 多卡按层分配;已经放进两张 GPU cache 的专家,不必再在主机 RAM 里常驻一份。放不下的部分才需要结合 RAM 预算和文件后备来处理。
                    • 关键是不需要先把全部专家权重同时装进系统内存,而不是完全绕过 RAM。 数据仍经过主机内存搬进显卡,不是 GPUDirect 式的 SSD 直传显存;传输缓冲、其他运行时数据和系统文件缓存仍然会占用 RAM。

                    我这次跑的是 Unsloth UD-IQ4_XS。项目验证记录里,双卡按层拆分后,全部 24,576 个专家都进了 GPU cache,专家缓存合计约 55.4 GiB;日志里的常驻专家 RAM 是 0 GiB。这个“0”只指专家权重的常驻 RAM 副本,不是整个程序不占内存,也不是说整个模型的所有数据都在显存里。 下载约 94GB,也不等于这些文件必须全部常驻 RAM 或 VRAM。

                    配置上还有一个坑:当时那个版本的 setup 在 Unsloth 多卡路径下会去掉 RAM budget,所以我先生成限额配置,再配置双卡按层拆分,保留 --resident-budget-gib 12,并让 KV cache 留在显存里。12 GiB 是专家 RAM 预算,不是整个进程的内存上限,也不是通用的一键参数。

                    所以选择 Strata,主要是这套配置已经在我的机器上把加载和显存利用跑通了,不是在证明它一定比 SGLang 快。SGLang 我还没试,也感谢提醒,后续可以在相同模型、量化和实际上下文条件下再比较。另外这里是按层拆分,双卡也不意味着单路对话速度自动翻倍。

                    项目配置:https://github.com/lunarmoon26/qwen3.8-flash-next
                    Strata:https://github.com/Niko1221/Strata

                    johnnybegoodJ 1 条回复 最后回复
                    0
                    • johnnybegoodJ johnnybegood

                      不过双 RTX 6000 才跑到200,我能跑到 110 , 我已经非常非常欣慰了, 毕竟价格差了20倍

                      lunarmoon26L
                      lunarmoon26L
                      lunarmoon26
                      体面乡绅
                      编写于 最后由 编辑
                      #20

                      @johnnybegood 但得看你的上下文是多少。一般来说60-80toks就能干活 但是得400K上下文。虽然很多模型是1m但其实400k左右是最有效的区间

                      1 条回复 最后回复
                      0
                      • terryT terry

                        这么丧心病狂吗?真的是人均RTX Pro6000?

                        lunarmoon26L
                        lunarmoon26L
                        lunarmoon26
                        体面乡绅
                        编写于 最后由 lunarmoon26 编辑
                        #21

                        @terry 关注老哥您的频道很久了 您讲话实在 而且直觉狠准。
                        之前一直潜水 没怎么发帖。这个论坛终于找到组织了。
                        现在我有2x DGX Spark,2x R9700,2x Pro6000有什么想法我可以跑跑评测
                        我的本职工作是在对冲基金写递归自我改进型AI系统 不过刚开始起步 还有很多需要学习
                        博客地址:https://blog.haochuanz.net/ 时不时发一些AI时代的想法和研究 完全免费 欢迎参观

                        johnnybegoodJ 1 条回复 最后回复
                        0
                        • kop wangK kop wang

                          楼主帖子刚发完,官方setup就支持nvfp4了……
                          应该速度还能再快50~100t/s

                          btw:191GB的显存,其实是可以直接sglang来运行的,为何要用strata……

                          lunarmoon26L
                          lunarmoon26L
                          lunarmoon26
                          体面乡绅
                          编写于 最后由 lunarmoon26 编辑
                          #22

                          @kop-wang 多谢提醒,我下面统一补充了 Strata 的配置,也去查了 SGLang 的源码和官方部署说明。我的机器是两张 96GB 显卡,但系统 RAM 只有 48GB,所以我主要担心的是主机内存,不只是显存够不够。

                          SGLang 并不是必须先把整个模型塞进 RAM 才能加载。 默认的 safetensors 路径使用 mmap,再把权重加载到 GPU;因此 checkpoint 大于 48GB,并不等于这台机器一定跑不了。实际还要看具体模型、量化、加载时的临时分配,以及有没有把大张量常驻到 CPU。

                          Qwen3.8-Flash-Next 这里有一个具体的坑:官方单张 RTX PRO 6000 的 NVFP4 配方,把约 47.7 GiB 的 PLE / N-gram 查表权重放进 pinned host RAM,并要求至少 64GB 空闲主机内存。这套配方原样照搬到我的 48GB 机器上就不合适。源码里 BF16 dtype 的 CUDA 路径也会默认启用 PLE offload。

                          不过我有两张卡,可以考虑用受支持的 RadixArk NVFP4 checkpoint,TP=2,并显式加 --no-ple-offload-embedding,让这张表也分片留在显存里。按部署说明里约 126 GiB 的权重规模看,这是有希望不改源码就跑通的方向;先不开 MTP、用短上下文验证,再检查加载峰值和可用上下文更稳妥。毕竟还要给 KV、Mamba 状态和临时空间留余量,不能直接保证 524K 实际输入也能用。NVFP4 checkpoint 和我现在 Strata 用的 UD-IQ4_XS GGUF 也不是同一套量化文件。

                          所以我的判断是:48GB RAM 不是 SGLang 的硬性门槛,但默认参数或照抄单卡配方不一定适合这台机器;双卡全显存方案值得试。 我还没有在本机实测 SGLang,之前 DeepSeek 那套 vLLM 加载/转换遇到的内存问题,也不能直接当作 SGLang 跑 Qwen 不行的证据。现在继续用 Strata,主要是现有配置已经验证跑通了。

                          参考:

                          • SGLang 官方 Qwen3.8-Flash-Next 部署说明
                          • 双 RTX PRO 6000 的社区实测:证明这套 GPU 能跑,但其配方仍使用 pinned PLE,启动脚本要求 70GB 空闲 RAM,不能直接套用到我的机器。
                          1 条回复 最后回复
                          0
                          • A applejuice

                            大佬 你应该去玩玩project maya glm5.3 flash 应该会更爽

                            johnnybegoodJ
                            johnnybegoodJ
                            johnnybegood
                            王侯将相
                            编写于 最后由 编辑
                            #23

                            @applejuice 我测了一些场景, maya 因为是 2比特量化, 感觉不尽人意, 不如 strata iq4 更不如 UD-iq4

                            1 条回复 最后回复
                            0
                            • lunarmoon26L lunarmoon26

                              @terry 关注老哥您的频道很久了 您讲话实在 而且直觉狠准。
                              之前一直潜水 没怎么发帖。这个论坛终于找到组织了。
                              现在我有2x DGX Spark,2x R9700,2x Pro6000有什么想法我可以跑跑评测
                              我的本职工作是在对冲基金写递归自我改进型AI系统 不过刚开始起步 还有很多需要学习
                              博客地址:https://blog.haochuanz.net/ 时不时发一些AI时代的想法和研究 完全免费 欢迎参观

                              johnnybegoodJ
                              johnnybegoodJ
                              johnnybegood
                              王侯将相
                              编写于 最后由 johnnybegood 编辑
                              #24

                              @lunarmoon26 说:

                              https://blog.haochuanz.net/

                              其实对大模型跑分不太关注,因为网上也很多类似视频,但我就是特别想知道一些细节,比如 2x Pro6000 跑在什么样的主板cpu,机箱型号是什么,散热如何处理, 噪音大不大,如果24小时工作,是不是需要放在单独的一个房间,电源是多少瓦,可能只有真正想搭建一套的人才有这么多疑问吧, 请不吝赐教。

                              1 条回复 最后回复
                              0
                              • lunarmoon26L lunarmoon26

                                感谢大家的参观,统一补充一下这次测试的考虑,尤其是为什么用 Strata:

                                1. 这台机器优先考虑低功耗、长期开机

                                两张 RTX 6000 Pro 工作站版都限制到了每张 300W,不是奔着满功耗刷最高跑分去的。服务器需要 24/7 开机,选择 9700X 也是出于这个考虑。

                                2. 关于截图里约 200 tok/s 和上下文

                                第二张 OpenCode 截图是实际使用时自己做的 Statsline 统计,不是统一条件下的框架对比跑分。这套配置用了 YaRN ×2,把原生 262,144 的上下文上限扩到了 524,288(约 524K)。

                                但配置了 524K 上限,不代表截图里的请求真的填满了 524K,也不能直接把这个速度全部归因于 RoPE 扩展。功耗限制、量化、实际输入长度、推测解码等条件都需要一起看;完整长上下文的效果也还需要单独测试。

                                3. 为什么显存这么大,还选择 Strata?

                                主要是这台机器的配置有点偏科:两张卡各有 96GB 显存,但系统内存只有 48GB。显存放得下,不代表加载过程就一定能在这点 RAM 里完成。

                                之前折腾 DeepSeek-V4-Flash-0731 时,我就在 vLLM 那套加载/转换流程里碰到了主机内存瓶颈,后来才用流式处理和 NVMe 上的缓存来解决。这里说的是我当时那套模型和实现的经历,不是说 vLLM 或 SGLang 都必须先把整个模型塞进 RAM:

                                • https://github.com/lunarmoon26/deepseek-v4-flash
                                • https://blog.haochuanz.net/posts/running-deepseek-v4-flash-0731-with-48gb-ram

                                Strata 吸引我的,是它已经有适合“小 RAM、大 VRAM”的权重加载和分层缓存机制。简单说:

                                • 模型文件留在 SSD 上,按需读取专家权重,通过有限的主机内存缓冲分批搬进 GPU cache,而不是先在 RAM 里保留一整份专家权重。
                                • 多卡按层分配;已经放进两张 GPU cache 的专家,不必再在主机 RAM 里常驻一份。放不下的部分才需要结合 RAM 预算和文件后备来处理。
                                • 关键是不需要先把全部专家权重同时装进系统内存,而不是完全绕过 RAM。 数据仍经过主机内存搬进显卡,不是 GPUDirect 式的 SSD 直传显存;传输缓冲、其他运行时数据和系统文件缓存仍然会占用 RAM。

                                我这次跑的是 Unsloth UD-IQ4_XS。项目验证记录里,双卡按层拆分后,全部 24,576 个专家都进了 GPU cache,专家缓存合计约 55.4 GiB;日志里的常驻专家 RAM 是 0 GiB。这个“0”只指专家权重的常驻 RAM 副本,不是整个程序不占内存,也不是说整个模型的所有数据都在显存里。 下载约 94GB,也不等于这些文件必须全部常驻 RAM 或 VRAM。

                                配置上还有一个坑:当时那个版本的 setup 在 Unsloth 多卡路径下会去掉 RAM budget,所以我先生成限额配置,再配置双卡按层拆分,保留 --resident-budget-gib 12,并让 KV cache 留在显存里。12 GiB 是专家 RAM 预算,不是整个进程的内存上限,也不是通用的一键参数。

                                所以选择 Strata,主要是这套配置已经在我的机器上把加载和显存利用跑通了,不是在证明它一定比 SGLang 快。SGLang 我还没试,也感谢提醒,后续可以在相同模型、量化和实际上下文条件下再比较。另外这里是按层拆分,双卡也不意味着单路对话速度自动翻倍。

                                项目配置:https://github.com/lunarmoon26/qwen3.8-flash-next
                                Strata:https://github.com/Niko1221/Strata

                                johnnybegoodJ
                                johnnybegoodJ
                                johnnybegood
                                王侯将相
                                编写于 最后由 编辑
                                #25

                                @lunarmoon26

                                正问着呢, 去 blog看了一眼, 看到配置了。 那现在只剩下关于噪音和存储方式的疑问了。

                                另外发现楼主的主板好像不支持 2x PCIE 16x 也不支持 4通道内存? 这个对这两张卡来说, 真的有点束手束脚了。

                                lunarmoon26L 1 条回复 最后回复
                                0
                                • johnnybegoodJ johnnybegood

                                  @lunarmoon26

                                  正问着呢, 去 blog看了一眼, 看到配置了。 那现在只剩下关于噪音和存储方式的疑问了。

                                  另外发现楼主的主板好像不支持 2x PCIE 16x 也不支持 4通道内存? 这个对这两张卡来说, 真的有点束手束脚了。

                                  lunarmoon26L
                                  lunarmoon26L
                                  lunarmoon26
                                  体面乡绅
                                  编写于 最后由 lunarmoon26 编辑
                                  #26

                                  @johnnybegood 😆 感谢参观博客 对的主要是我用的360水冷 本来想用AMD TRX50但要买新散热不方便就直接买了这块b850 价格也不夸张。
                                  x8/x8确实也限制了两张pro6000性能释放。

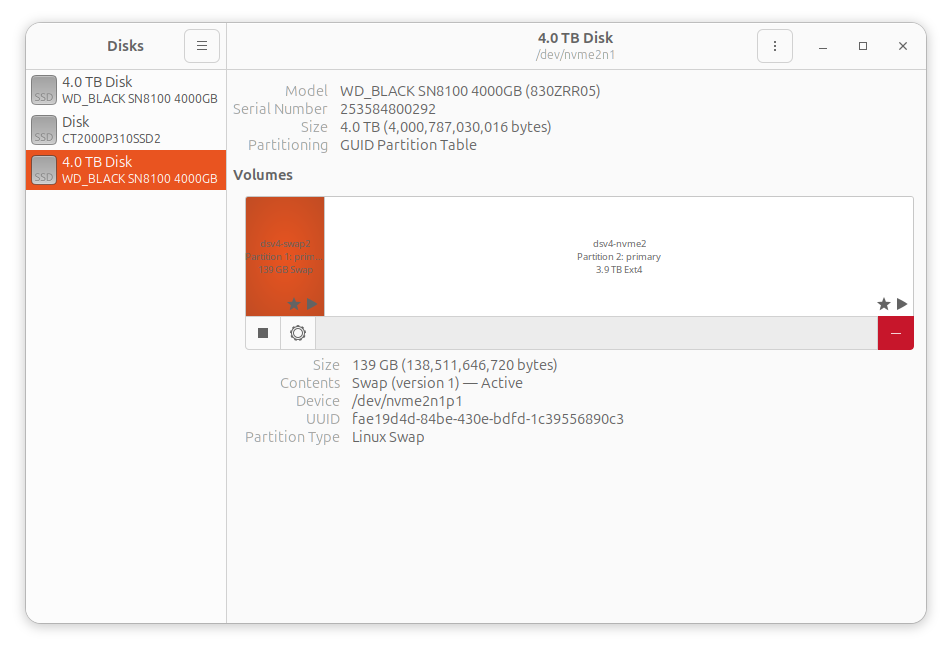
                                  硬盘就是pcie5x4两个+pcie4x4一个作为系统盘:
                                  Screenshot From 2026-10-15 01-45-20.png

                                  模型放pcie5盘上加载速度快

                                  总之这个配置就是图一乐但也能干活。
                                  噪音真没啥,限制了300w功耗外加调了CoolerControl曲线 非常安静 满载也就400w+

                                  johnnybegoodJ 2 条回复 最后回复
                                  0
                                  • lunarmoon26L lunarmoon26

                                    @johnnybegood 😆 感谢参观博客 对的主要是我用的360水冷 本来想用AMD TRX50但要买新散热不方便就直接买了这块b850 价格也不夸张。
                                    x8/x8确实也限制了两张pro6000性能释放。

                                    硬盘就是pcie5x4两个+pcie4x4一个作为系统盘:
                                    Screenshot From 2026-10-15 01-45-20.png

                                    模型放pcie5盘上加载速度快

                                    总之这个配置就是图一乐但也能干活。
                                    噪音真没啥,限制了300w功耗外加调了CoolerControl曲线 非常安静 满载也就400w+

                                    johnnybegoodJ
                                    johnnybegoodJ
                                    johnnybegood
                                    王侯将相
                                    编写于 最后由 johnnybegood 编辑
                                    #27

                                    @lunarmoon26

                                    x8 + x8 够用了, 但如果后续需要跑更大的模型, 卸载到内存的话, 内存带宽的问题会很明显地显现, 我现在就很受其困扰, 一直在搜索合适的配件,我的目标是八通道 DDR4 3600 就可以, 这样的话内存带宽会达到 230.4 GB/s , 比 DGXSpark还高, 在很多场景就很好用了,这个时候 x8 的 pcie 反而成了最瓶颈的那个。

                                    1 条回复 最后回复
                                    0
                                    • lunarmoon26L lunarmoon26

                                      @johnnybegood 😆 感谢参观博客 对的主要是我用的360水冷 本来想用AMD TRX50但要买新散热不方便就直接买了这块b850 价格也不夸张。
                                      x8/x8确实也限制了两张pro6000性能释放。

                                      硬盘就是pcie5x4两个+pcie4x4一个作为系统盘:
                                      Screenshot From 2026-10-15 01-45-20.png

                                      模型放pcie5盘上加载速度快

                                      总之这个配置就是图一乐但也能干活。
                                      噪音真没啥,限制了300w功耗外加调了CoolerControl曲线 非常安静 满载也就400w+

                                      johnnybegoodJ
                                      johnnybegoodJ
                                      johnnybegood
                                      王侯将相
                                      编写于 最后由 编辑
                                      #28

                                      @lunarmoon26 哈哈, 想当年 4T 的 PCIe4.0 的大船SSD 才 900多块钱, 我屯了8个, 2个给电脑用, 6个组SSD NAS, 现在天天都觉得赚了。

                                      lunarmoon26L 1 条回复 最后回复
                                      1
                                      • johnnybegoodJ johnnybegood

                                        @lunarmoon26 哈哈, 想当年 4T 的 PCIe4.0 的大船SSD 才 900多块钱, 我屯了8个, 2个给电脑用, 6个组SSD NAS, 现在天天都觉得赚了。

                                        lunarmoon26L
                                        lunarmoon26L
                                        lunarmoon26
                                        体面乡绅
                                        编写于 最后由 编辑
                                        #29

                                        @johnnybegood 太机智了

                                        johnnybegoodJ 1 条回复 最后回复
                                        0
                                        • lunarmoon26L lunarmoon26

                                          @johnnybegood 太机智了

                                          johnnybegoodJ
                                          johnnybegoodJ
                                          johnnybegood
                                          王侯将相
                                          编写于 最后由 编辑
                                          #30

                                          @lunarmoon26 不如你机智, rtx pro 6000 在 5w 出头的时候我买了一个, 但当时因为一点点小原因, 就给退了, 现在每次想起来还后悔。
                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组