
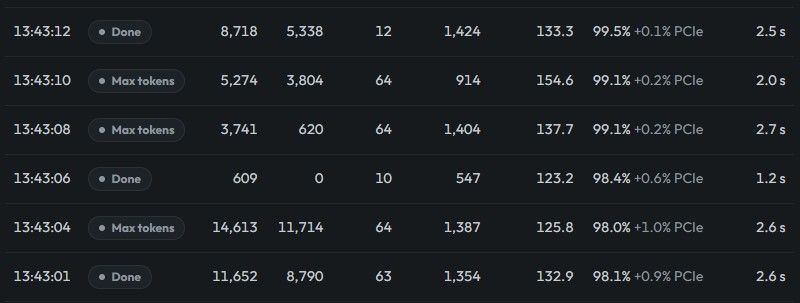
你好NVFP4:strata-0.1.44.1,qwen3.8-flash-next,rtx pro 5000 48GB + 64GB RAM,decode 130t/s,prefill2600 t/s
-
如题。
相较于只有ISTA-DASLab孤立跑分的IQ3系列,nvfp4有英伟达官方站台,所以其能力会更有说服力。
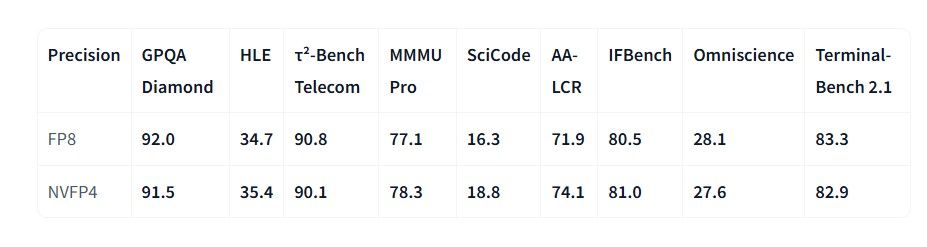
更何况nvfp4并不是全4bit,很多参数都保持了全量bf16。
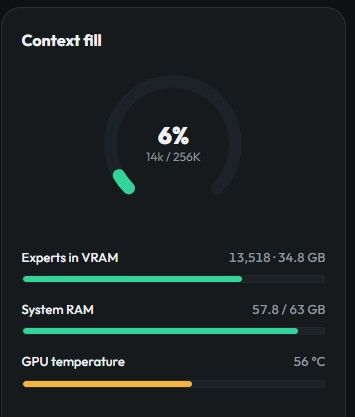
对于64GB ram + rtx pro 5000 48GB而言。瓶颈主要是因为专家变大了,导致显存只能放进13500个专家,从而专家命中率从99.7%降低至大概97.x~99%。
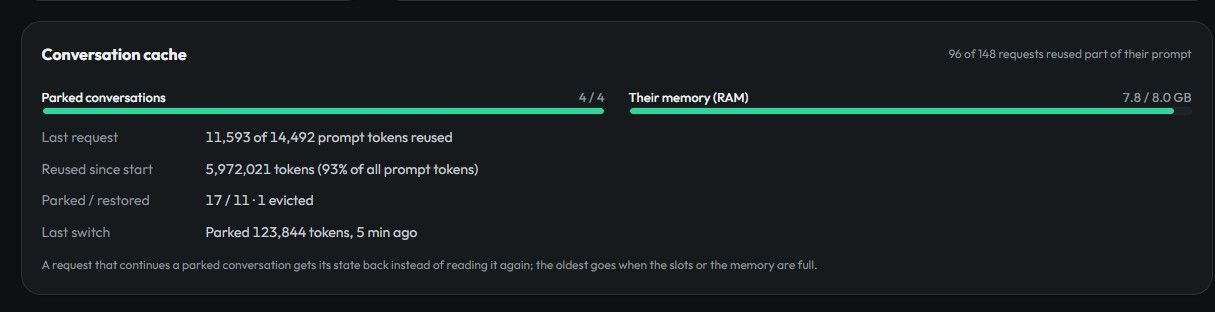
然后就是因为内存的紧张,所以Conversation cache只能维系在8GB,4slot。
其他的配置保持不变。
如惯例,贴出我的配置表:args": [ "--pack", "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\pack", "--native", "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\qwen-nvfp4-gptq-dense.gguf", "--native-dense-gguf", "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\qwen-nvfp4-gptq-dense.gguf", "--ple-gguf", "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\ple-fp8.gguf", "--embd-gguf", "C:\\work\\Strata-data\\models\\Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata\\token-embd-bf16.gguf", "--expert-profile", "C:\\work\\Strata\\data\\expert-profile.bin", "--expert-cache", "auto", "--prefill", "auto", "--spec", "4", "--mtp", "C:\\work\\Strata-data\\mtp\\rt", "--max-context", "262144", "--kv", "k8v4", "--resident-budget-gib", "39", "--vision", "--vram-reserve-mib", "700", "--spec-min-p", "0.5", "--pool-workers", "2", "--conversation-cache-mib", "8192", "--conversation-cache-min-tokens", "20000" ], -
-
-
-
-
-
-
-
-
-
@张光璞 其实也不一定不好
2x9700 跟 2x 7900 能做的应该比单张5000 pro 多只是功耗 维护是个问题
-
-
资讯跑得很快。。。。。。。。。我还是需要一点呼吸空间
-


 , 不过看prefill 2000多好像不太高.




