跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI Agent
  4. Agent 能不能越用越会改进自己?聊聊 RSI 和 Harness,抛砖引玉

Agent 能不能越用越会改进自己?聊聊 RSI 和 Harness,抛砖引玉

已定时 已固定 已锁定 已移动 AI Agent
dsharness
35 帖子 7 发布者 652 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • terryT
    terryT
    terry
    易有太极
    编写于 最后由 编辑
    #2

    太长了,简单一点,就是dsh刚出来的时候,还不太完善,我就是让它自己改进自己,它都能搞定。改进自己的本质就是阅读自身代码,编程。这和阅读其他项目代码,加以改进没啥区别。

    油管:https://www.youtube.com/@抡锤者

    lunarmoon26L 1 条回复 最后回复
    1
    • terryT terry

      太长了,简单一点,就是dsh刚出来的时候,还不太完善,我就是让它自己改进自己,它都能搞定。改进自己的本质就是阅读自身代码,编程。这和阅读其他项目代码,加以改进没啥区别。

      lunarmoon26L
      lunarmoon26L
      lunarmoon26
      体面乡绅
      编写于 最后由 编辑
      #3

      @terry 对,读自己的代码再修改,这点我同意。我想讨论的重点其实是:怎么验证改完之后真的更好了,而且没把原来好用的地方改坏。

      一个常见做法是,把可重复运行的任务和工作流做成 eval,新旧版本在相同预算下跑多次。比如 pass@k 看 k 次尝试里至少成功一次的概率,pass^k 看 k 次全部成功的概率,分别看解决问题的能力和稳定性。

      有点像股票策略改完后做回测,再拿没参与调参的数据做样本外验证,避免只是过拟合了原来的例子。

      1 条回复 最后回复
      1
      • imbiplaza ASUSI
        imbiplaza ASUSI
        imbiplaza ASUS
        谪仙人
        编写于 最后由 imbiplaza ASUS 编辑
        #4

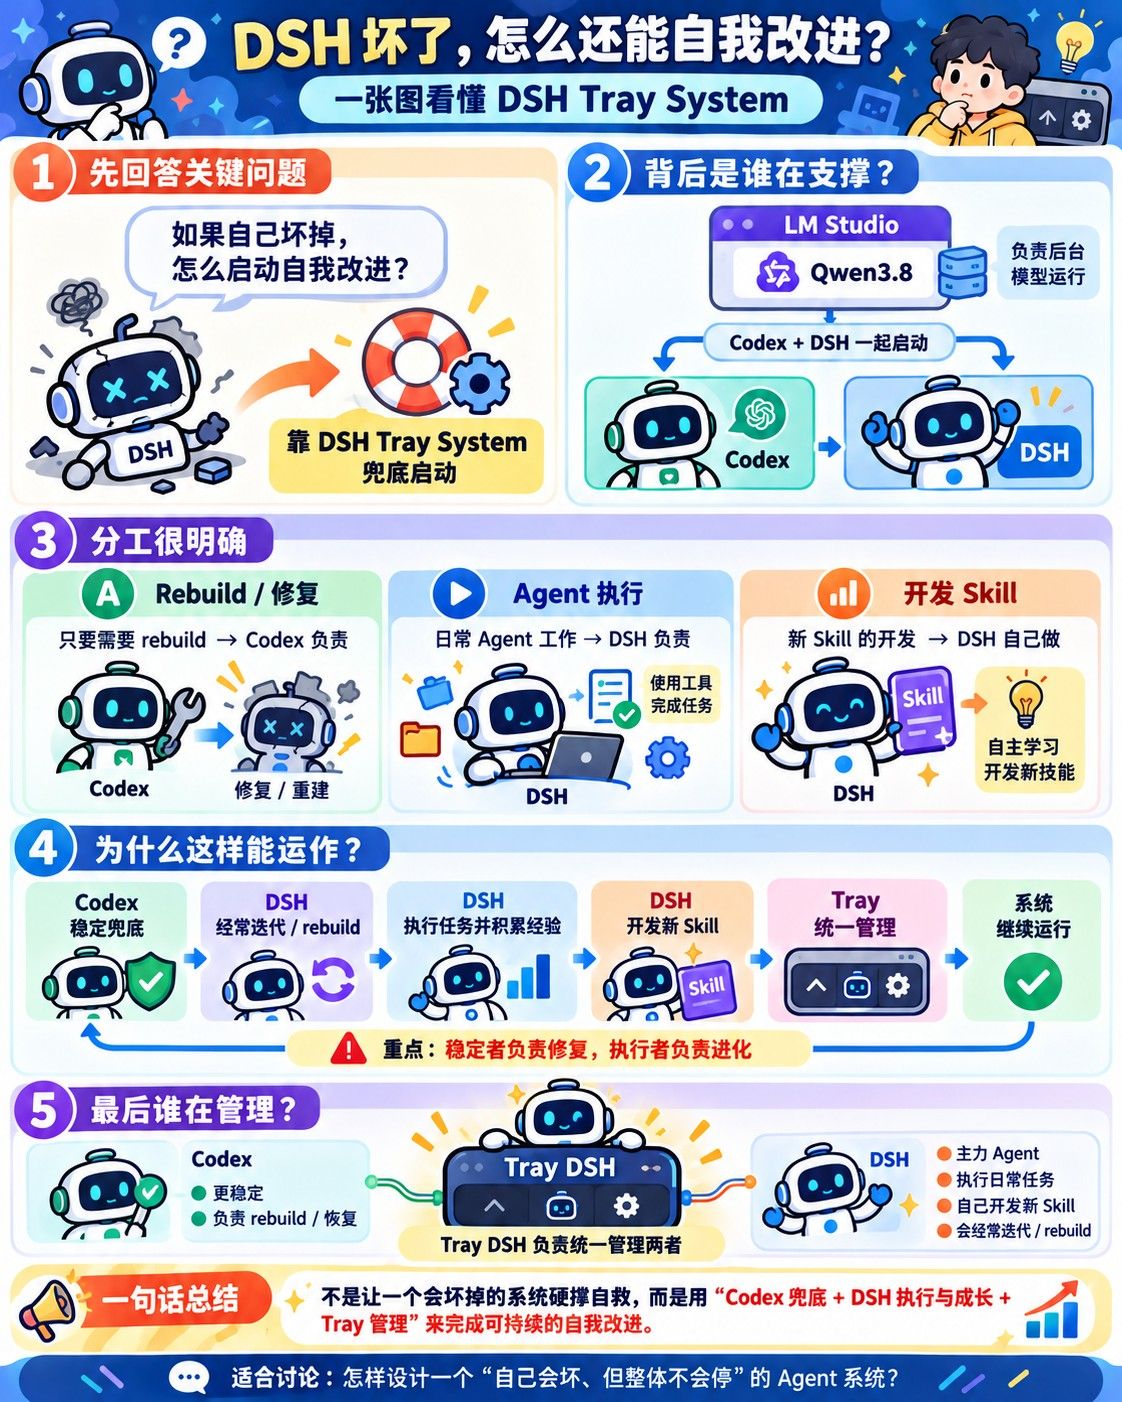
        我一直在做着dsh的自我改进的事情。。。。可能你会问,如果本身自己坏掉,怎么能够启动自我改进呢,那样就要说一说我的dsh tray system, 主要是由背后的lm studio 负责qwen3.8, 由codex + dsh 两者启动,
        codex 几乎不坏,dsh 几乎时常rebuild,
        只要是rebuild > codex 负责
        agent > dsh 负责
        开发skill > dsh 自己开发

        最后我使用tray dsh 来管理两者的im

        kos orK lunarmoon26L 2 条回复 最后回复
        1
        • kos orK
          kos orK
          kos or
          至尊皇帝
          编写于 最后由 kos or 编辑
          #5

          最近有個新聞好像是 RSI遇到一個問題 需要更強大的LLM作Verifier 才能驗證改進或者 這是一個好的改進

          我最近讓Qwen Flash 去改進一個系統, GPT-Astra告知問題後, Qwen Flash 東西越加越多 “自以為是改進 越改越複雜”, Flash以為添加了一些東西 就是可以改善現有的問題

          樓主的貼文圖表供大家參考
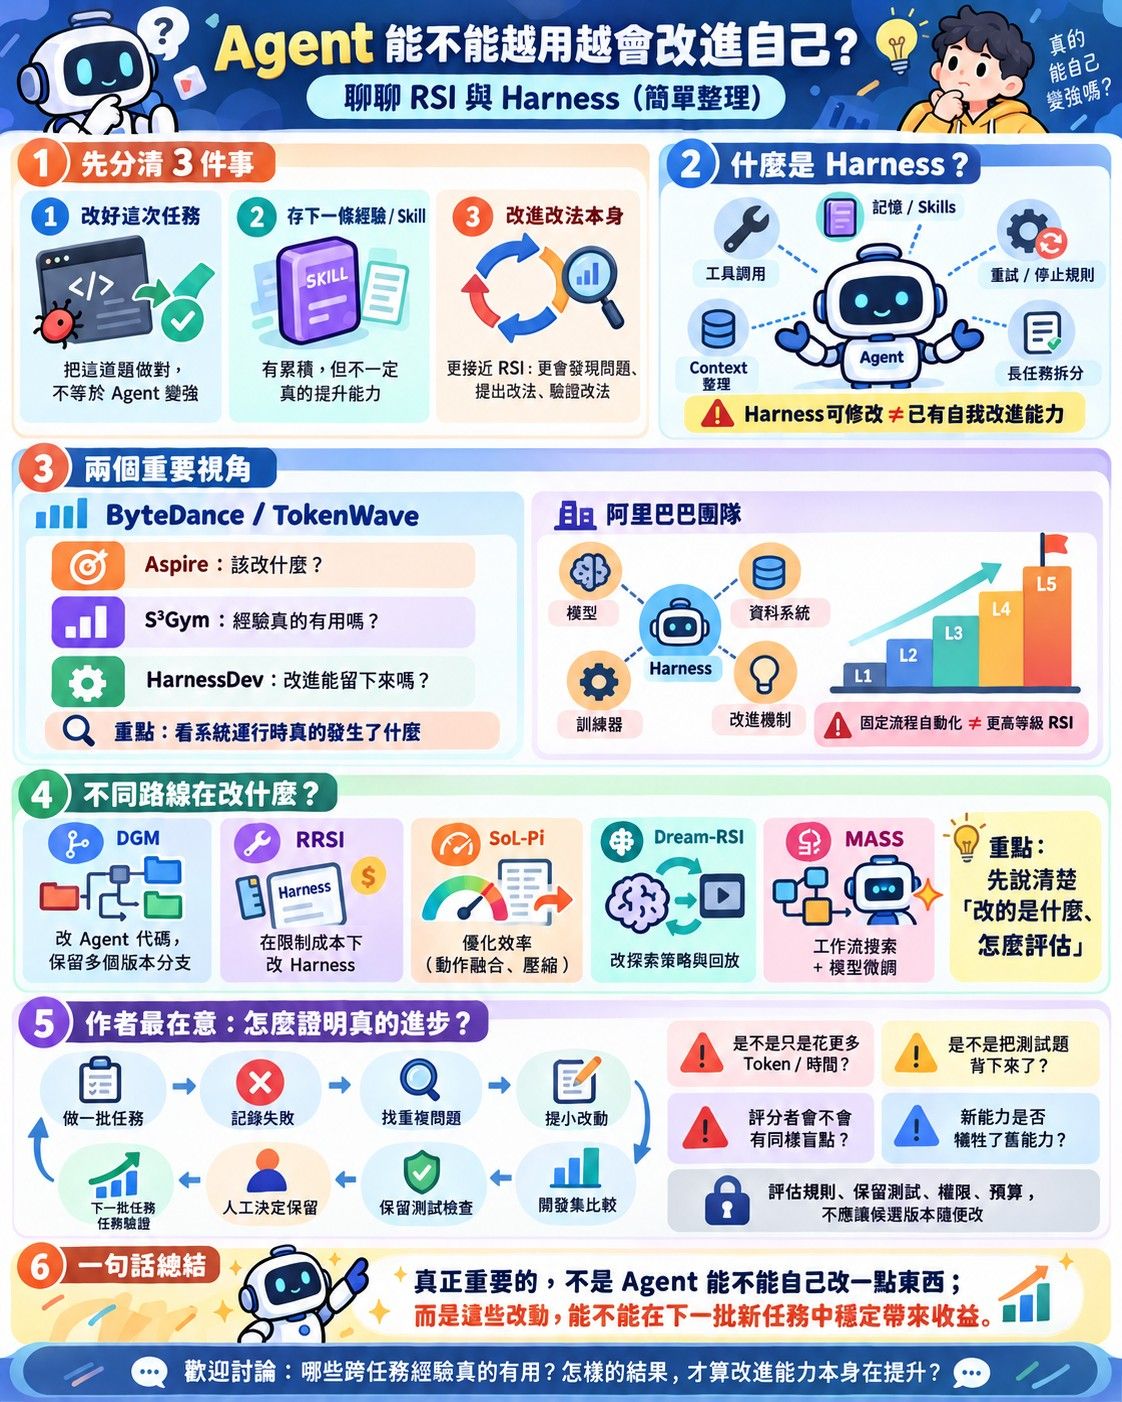
          image.jpeg

          imbiplaza ASUSI 1 条回复 最后回复
          1
          • kos orK kos or

            最近有個新聞好像是 RSI遇到一個問題 需要更強大的LLM作Verifier 才能驗證改進或者 這是一個好的改進

            我最近讓Qwen Flash 去改進一個系統, GPT-Astra告知問題後, Qwen Flash 東西越加越多 “自以為是改進 越改越複雜”, Flash以為添加了一些東西 就是可以改善現有的問題

            樓主的貼文圖表供大家參考

            image.jpeg

            imbiplaza ASUSI
            imbiplaza ASUSI
            imbiplaza ASUS
            谪仙人
            编写于 最后由 编辑
            #6

            @kos-or

            这就是老大时常讲的,学达文西用另外一个手电筒照现在的手电筒

            1 条回复 最后回复
            0
            • imbiplaza ASUSI imbiplaza ASUS

              我一直在做着dsh的自我改进的事情。。。。可能你会问,如果本身自己坏掉,怎么能够启动自我改进呢,那样就要说一说我的dsh tray system, 主要是由背后的lm studio 负责qwen3.8, 由codex + dsh 两者启动,
              codex 几乎不坏,dsh 几乎时常rebuild,
              只要是rebuild > codex 负责
              agent > dsh 负责
              开发skill > dsh 自己开发

              最后我使用tray dsh 来管理两者的im

              kos orK
              kos orK
              kos or
              至尊皇帝
              编写于 最后由 编辑
              #7

              @imbiplaza-ASUS said:

              最后我使用tray dsh 来管理两者的im

              圖示真好用 😁

              image.jpeg

              imbiplaza ASUSI 1 条回复 最后回复
              1
              • imbiplaza ASUSI imbiplaza ASUS

                我一直在做着dsh的自我改进的事情。。。。可能你会问,如果本身自己坏掉,怎么能够启动自我改进呢,那样就要说一说我的dsh tray system, 主要是由背后的lm studio 负责qwen3.8, 由codex + dsh 两者启动,
                codex 几乎不坏,dsh 几乎时常rebuild,
                只要是rebuild > codex 负责
                agent > dsh 负责
                开发skill > dsh 自己开发

                最后我使用tray dsh 来管理两者的im

                lunarmoon26L
                lunarmoon26L
                lunarmoon26
                体面乡绅
                编写于 最后由 编辑
                #8

                我觉得你这个方法是 OK 的,而且把 rebuild 交给相对稳定的 Codex,已经把“执行”和“修复执行器”分开了,不用指望坏掉的 DSH 自己救自己。

                我想补充的是,如果要从“能修好自己”走到持续、可验证的改进,我倾向于再明确一层 governor(治理/调度层),来驱动和管理整套体系。普通 coding agent 的核心通常还是“观察 → 调工具 → 看结果 → 再修改”的任务内循环;即使能开子 agent,也不自动等于有了跨任务的改进闭环。不少 RSI 工作会把执行任务和改进执行策略分成两层。

                我自己也在做类似尝试:dsh-adaptive-loop。我的用法是 OpenCode 管外循环,DSH 做内层执行,再用 DAL 记录证据和管理候选。目前还在完善,不是说已经跑出了可靠的 RSI 收益。大致分工是:

                • 内层: 在固定方法和预算下完成任务,产出代码、实验结果和失败证据。
                • 外层: 拆任务、独立验收、管理分支和预算,再根据多次运行的证据提出方法改动;改动另起一批任务验证,而不是一边改研究员、一边用当前结果证明研究员变强了。

                我现在特别有感触的是,一套实际工作流往往有很多步,不能每轮都从零开始。比如先 extract 出几个 GB 的 feature,后面不同版本的 DSH 都可能需要复用。应该共享的是输入和生成配置仍然匹配的 artifact,不是让几个 agent 随便覆盖同一个目录;上游特征逻辑变了,下游缓存也不能照用。

                所以外部状态机很重要:哪些步骤完成且已验收、结果依赖哪个版本、失败后从哪里继续、哪条分支值得继续推演。回滚也不只是 git revert:还要知道恢复的是哪版代码、配置和 artifact 引用。已经发生的外部操作,更不能假设恢复文件就撤销了。我的方向是保留实验树和依赖关系,只重跑失效的部分;执行器说“完成了”,不直接等于外层接受结果。

                Google / DeepMind 等团队的 Dream-RSI 也给了我一个很有启发的例子:底层 coding agent 不变,把“从哪里分支、并行多少、什么时候停”的探索策略单独拿出来改进;历史探索树保存下来,用回放低成本比较策略,再部署到下一轮真实探索。这里的回放只覆盖已经记录的分支,不是能预测任意新方案,也不代表新任务上保证不退化。

                所以我不是觉得你的方式不行,反而觉得方向很接近。只是“另一个 agent 能帮它修复”解决了恢复能力;再加上状态、证据、独立验收和受控的版本切换,才比较容易判断这套系统是在积累有效改进,还是只是在不断 rebuild、不断加东西。

                另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。

                imbiplaza ASUSI 2 条回复 最后回复
                0
                • kos orK kos or

                  @imbiplaza-ASUS said:

                  最后我使用tray dsh 来管理两者的im

                  圖示真好用 😁

                  image.jpeg

                  imbiplaza ASUSI
                  imbiplaza ASUSI
                  imbiplaza ASUS
                  谪仙人
                  编写于 最后由 编辑
                  #9

                  @kos-or
                  现在应该流行用图示来讲解最复杂得事情

                  1 条回复 最后回复
                  0
                  • lunarmoon26L lunarmoon26

                    我觉得你这个方法是 OK 的,而且把 rebuild 交给相对稳定的 Codex,已经把“执行”和“修复执行器”分开了,不用指望坏掉的 DSH 自己救自己。

                    我想补充的是,如果要从“能修好自己”走到持续、可验证的改进,我倾向于再明确一层 governor(治理/调度层),来驱动和管理整套体系。普通 coding agent 的核心通常还是“观察 → 调工具 → 看结果 → 再修改”的任务内循环;即使能开子 agent,也不自动等于有了跨任务的改进闭环。不少 RSI 工作会把执行任务和改进执行策略分成两层。

                    我自己也在做类似尝试:dsh-adaptive-loop。我的用法是 OpenCode 管外循环,DSH 做内层执行,再用 DAL 记录证据和管理候选。目前还在完善,不是说已经跑出了可靠的 RSI 收益。大致分工是:

                    • 内层: 在固定方法和预算下完成任务,产出代码、实验结果和失败证据。
                    • 外层: 拆任务、独立验收、管理分支和预算,再根据多次运行的证据提出方法改动;改动另起一批任务验证,而不是一边改研究员、一边用当前结果证明研究员变强了。

                    我现在特别有感触的是,一套实际工作流往往有很多步,不能每轮都从零开始。比如先 extract 出几个 GB 的 feature,后面不同版本的 DSH 都可能需要复用。应该共享的是输入和生成配置仍然匹配的 artifact,不是让几个 agent 随便覆盖同一个目录;上游特征逻辑变了,下游缓存也不能照用。

                    所以外部状态机很重要:哪些步骤完成且已验收、结果依赖哪个版本、失败后从哪里继续、哪条分支值得继续推演。回滚也不只是 git revert:还要知道恢复的是哪版代码、配置和 artifact 引用。已经发生的外部操作,更不能假设恢复文件就撤销了。我的方向是保留实验树和依赖关系,只重跑失效的部分;执行器说“完成了”,不直接等于外层接受结果。

                    Google / DeepMind 等团队的 Dream-RSI 也给了我一个很有启发的例子:底层 coding agent 不变,把“从哪里分支、并行多少、什么时候停”的探索策略单独拿出来改进;历史探索树保存下来,用回放低成本比较策略,再部署到下一轮真实探索。这里的回放只覆盖已经记录的分支,不是能预测任意新方案,也不代表新任务上保证不退化。

                    所以我不是觉得你的方式不行,反而觉得方向很接近。只是“另一个 agent 能帮它修复”解决了恢复能力;再加上状态、证据、独立验收和受控的版本切换,才比较容易判断这套系统是在积累有效改进,还是只是在不断 rebuild、不断加东西。

                    另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。

                    imbiplaza ASUSI
                    imbiplaza ASUSI
                    imbiplaza ASUS
                    谪仙人
                    编写于 最后由 编辑
                    #10

                    @lunarmoon26

                    加东西,是dsh 自己加

                    只是rebuild 需要restart dsh, 一旦restart 变成dsh会沉睡

                    我一开始就是靠一样agent 自己rebuild, 只不过逃不过沉睡得问题,所以才用codex 来做唤醒人。。。。

                    要不然,我自己就是那位唤醒人

                    1 条回复 最后回复
                    0
                    • lunarmoon26L lunarmoon26

                      我觉得你这个方法是 OK 的,而且把 rebuild 交给相对稳定的 Codex,已经把“执行”和“修复执行器”分开了,不用指望坏掉的 DSH 自己救自己。

                      我想补充的是,如果要从“能修好自己”走到持续、可验证的改进,我倾向于再明确一层 governor(治理/调度层),来驱动和管理整套体系。普通 coding agent 的核心通常还是“观察 → 调工具 → 看结果 → 再修改”的任务内循环;即使能开子 agent,也不自动等于有了跨任务的改进闭环。不少 RSI 工作会把执行任务和改进执行策略分成两层。

                      我自己也在做类似尝试:dsh-adaptive-loop。我的用法是 OpenCode 管外循环,DSH 做内层执行,再用 DAL 记录证据和管理候选。目前还在完善,不是说已经跑出了可靠的 RSI 收益。大致分工是:

                      • 内层: 在固定方法和预算下完成任务,产出代码、实验结果和失败证据。
                      • 外层: 拆任务、独立验收、管理分支和预算,再根据多次运行的证据提出方法改动;改动另起一批任务验证,而不是一边改研究员、一边用当前结果证明研究员变强了。

                      我现在特别有感触的是,一套实际工作流往往有很多步,不能每轮都从零开始。比如先 extract 出几个 GB 的 feature,后面不同版本的 DSH 都可能需要复用。应该共享的是输入和生成配置仍然匹配的 artifact,不是让几个 agent 随便覆盖同一个目录;上游特征逻辑变了,下游缓存也不能照用。

                      所以外部状态机很重要:哪些步骤完成且已验收、结果依赖哪个版本、失败后从哪里继续、哪条分支值得继续推演。回滚也不只是 git revert:还要知道恢复的是哪版代码、配置和 artifact 引用。已经发生的外部操作,更不能假设恢复文件就撤销了。我的方向是保留实验树和依赖关系,只重跑失效的部分;执行器说“完成了”,不直接等于外层接受结果。

                      Google / DeepMind 等团队的 Dream-RSI 也给了我一个很有启发的例子:底层 coding agent 不变,把“从哪里分支、并行多少、什么时候停”的探索策略单独拿出来改进;历史探索树保存下来,用回放低成本比较策略,再部署到下一轮真实探索。这里的回放只覆盖已经记录的分支,不是能预测任意新方案,也不代表新任务上保证不退化。

                      所以我不是觉得你的方式不行,反而觉得方向很接近。只是“另一个 agent 能帮它修复”解决了恢复能力;再加上状态、证据、独立验收和受控的版本切换,才比较容易判断这套系统是在积累有效改进,还是只是在不断 rebuild、不断加东西。

                      另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。

                      imbiplaza ASUSI
                      imbiplaza ASUSI
                      imbiplaza ASUS
                      谪仙人
                      编写于 最后由 编辑
                      #11

                      @lunarmoon26

                      “另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。”

                      至于你问得,我也不懂他们怎样实现得,总之我看到im 有报告&信息来说任务完成,就可以了。。。。

                      这些事情,你得问你的agent

                      lunarmoon26L 1 条回复 最后回复
                      0
                      • Tony WangT
                        Tony WangT
                        Tony Wang
                        易有太极
                        编写于 最后由 Tony Wang 编辑
                        #12

                        我有个疑惑是, 这个你提到的RSI, 如果只是在 memory, skill 等外挂能力方面, 我觉得是没有问题的.

                        但如果RSI指向它本体, 这个可能会产生一个悖论, 它如何知道自己是提升了的呢?

                        比如, 如果 Harness A, 决定升级它自己到 Harness A', 那么显然 A' 的能力是超过 A 的 才对. 可是 A 如何判断 A' 是超越自己的呢? 显然这里需要引入一个 第三方的 judge. 而一旦有第三方的judge, RSI 又无法成立了.

                        自然世界之所以有演化, 是因为现实的演化. 我们现在看到的, 似乎是AI已经开始再协助, 或者是主导训练它的下一代. 是因为主要还是在人类之前的知识框架下.

                        如果让AI自主控制自己的演化, 我认为它的演变很可能是随机方向的. 不大可能持续进化.

                        所以我认为, RSI是不存在的, 只有 RSE, Recursive Self Evolution.

                        lunarmoon26L 1 条回复 最后回复
                        0
                        • imbiplaza ASUSI imbiplaza ASUS

                          @lunarmoon26

                          “另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。”

                          至于你问得,我也不懂他们怎样实现得,总之我看到im 有报告&信息来说任务完成,就可以了。。。。

                          这些事情,你得问你的agent

                          lunarmoon26L
                          lunarmoon26L
                          lunarmoon26
                          体面乡绅
                          编写于 最后由 编辑
                          #13

                          明白了,我前面把 Codex 的角色理解得重了一点。实际上是 DSH 自己加功能、自己 rebuild,Codex 主要负责重启之后把它唤醒,替代原本需要你手动做的那一下。这样分工就清楚了。

                          底层通信确实可以让 agent 去检查代码,不一定需要使用者自己研究协议。你这边通过 IM 看报告、接收结果,本身也是一种很自然的使用方式。

                          这也让我觉得,后面值得完善的不一定是让用户懂更多底层,而是让系统把几个状态表达清楚:进程重启了、任务继续了、任务完成了,以及改动通过验证了,这几件事最好能区分。比如 rebuild 后,是继续原来的任务和上下文,还是新开会话接着做,系统可以自己记录并在报告里说明。

                          最近 Claude Code 的 Mods 和 Plugin Evals 也挺值得关注:一个把运行机制开放出来修改,一个提供行为测试和有/无插件对照。我觉得这些都是 stepping stones,但还不是完整的 RSI 闭环。

                          我的感觉是,业界已经有不少通信和扩展接口,但“改了什么、怎么验证、保留哪版、重启后怎么继续”这些跨工具的状态和交互,还没有形成广泛互操作的一套做法。我自己的项目也在摸索这部分。理想情况不是让用户操心这些细节,而是 agent 和外层系统把它管理好,用户需要时能看清、能暂停、能回退。

                          1 条回复 最后回复
                          0
                          • Tony WangT
                            Tony WangT
                            Tony Wang
                            易有太极
                            编写于 最后由 编辑
                            #14

                            如果 DSH 能自己rebuild, 且不依靠第三方裁判的话, 我觉得没有机制能让它持续进化, 只能是随机演化.

                            一个智商100的 harness+大脑, 无法判断它推导出的下一个版本是 智商110.

                            lunarmoon26L 1 条回复 最后回复
                            1
                            • Tony WangT Tony Wang

                              我有个疑惑是, 这个你提到的RSI, 如果只是在 memory, skill 等外挂能力方面, 我觉得是没有问题的.

                              但如果RSI指向它本体, 这个可能会产生一个悖论, 它如何知道自己是提升了的呢?

                              比如, 如果 Harness A, 决定升级它自己到 Harness A', 那么显然 A' 的能力是超过 A 的 才对. 可是 A 如何判断 A' 是超越自己的呢? 显然这里需要引入一个 第三方的 judge. 而一旦有第三方的judge, RSI 又无法成立了.

                              自然世界之所以有演化, 是因为现实的演化. 我们现在看到的, 似乎是AI已经开始再协助, 或者是主导训练它的下一代. 是因为主要还是在人类之前的知识框架下.

                              如果让AI自主控制自己的演化, 我认为它的演变很可能是随机方向的. 不大可能持续进化.

                              所以我认为, RSI是不存在的, 只有 RSE, Recursive Self Evolution.

                              lunarmoon26L
                              lunarmoon26L
                              lunarmoon26
                              体面乡绅
                              编写于 最后由 编辑
                              #15

                              我觉得这里可以拆成两个循环:一个负责干活,一个负责改进干活的方法。

                              比如 A 提出一个新版 A′,先别急着替换自己,让两个版本在相同条件下跑一批任务,再看结果。A′ 不一定更强,也可能改坏了,那就不保留。

                              A 也不需要先变得比 A′ 更聪明,才能发现它某些地方做得更好。就像我不一定会写一个更快的排序算法,但可以检查结果对不对、跑得快不快。当然,开放式任务就没这么容易测了。

                              最近 Sakana AI 和伯克利的 MASS 就在探索你说的这个问题:同一个模型分别负责干活、优化工作流和评价结果,再从自己选出的团队执行记录里训练下一版模型,继续下一轮。它不是靠一个更强的外部 judge 来驱动整个改进过程。

                              不过这里要区分:研究者另外用了外部模型评估效果,但这些评分没有反馈给 MASS。也就是“系统靠什么改进”和“我们怎么检查它有没有改进”,是两件事。他们只做了两轮完整实验,不同任务上的收益也不一致,还不能说证明了无限、持续的自我改进。

                              所以我不太觉得“有第三方 judge,RSI 就不成立”;也不觉得必须完全靠自己打分,才算 self-improvement。关键还是这个反馈靠不靠谱。

                              但你说“演变不等于进步”,这个我同意。不断出新版本不代表越来越好。MASS 自己也指出,同一个模型干活、评价、再学习,可能把共同的盲点一轮轮放大。这不是已经解决的问题,反而正是值得研究的地方。

                              1 条回复 最后回复
                              0
                              • Tony WangT
                                Tony WangT
                                Tony Wang
                                易有太极
                                编写于 最后由 Tony Wang 编辑
                                #16

                                这批任务, 实际上是一个第三方 Judge, 它有标准答案. 要出这批任务和答案, A只能在自己的认知范畴内. 既然在自己的认知范畴内, 它无需提升它自己的本体. 可以通过扩展能力和做事方法来解决.

                                lunarmoon26L 2 条回复 最后回复
                                0
                                • Tony WangT Tony Wang

                                  如果 DSH 能自己rebuild, 且不依靠第三方裁判的话, 我觉得没有机制能让它持续进化, 只能是随机演化.

                                  一个智商100的 harness+大脑, 无法判断它推导出的下一个版本是 智商110.

                                  lunarmoon26L
                                  lunarmoon26L
                                  lunarmoon26
                                  体面乡绅
                                  编写于 最后由 编辑
                                  #17

                                  对,单靠“自己 rebuild 成功了”,确实不能说明能力提高了。但也不一定非要一个“智商更高的裁判”,有些目标可以直接测。

                                  比如 Karpathy 的 autoresearch,就是一个很直观的起点:固定评估代码,每次给五分钟训练预算,看验证集的 bits per byte 有没有下降,好了就保留,不好就撤回。它测的是明确条件下的训练效果,不是在判断“智商从 100 涨到 110”。严格说,这也不等于改进循环本身已经能自我改进。

                                  更难的问题其实是:换成开放式任务,什么叫“更好”?rubric 怎么定?有没有足够通用、又不容易被钻空子的指标? 我目前还没看到一个公认的、什么任务都适用的答案。正确率、成本、稳定性、泛化能力,往往还会互相拉扯。

                                  再往上一层,连“怎么提出改法、怎么分配实验预算、怎么筛选版本”这套改进循环,也可以成为优化对象——开始套娃了,哈哈哈。

                                  Weco 的 AIDE² 就做了类似尝试:内循环改任务代码,外循环改内层研究 Agent 的 Harness,用固定成本预算和内层看不到的私有评分来筛选。他们还把改出来的 Agent 放回外循环,测试它是不是也更会“改进别人”。

                                  不过作者自己也说,最后这一步还没有足够强的证据,效率差异也没达到统计显著。所以我倾向于说:特定范围内的改进可以测,但“改进能力也持续变强”需要另外证明,更不能直接推出无限进化。

                                  所以很多 RSI 实验还是先把任务范围、预算和评价规则圈定,建立一个可测的改进闭环。这和“面对任意开放式任务,都能可靠判断自己有没有进步”,距离还挺远。像 MASS 已经在探索开放式研究任务,但不能说通用、持续的自我改进已经实现了。现在更有把握的,还是特定条件下的有限改进。

                                  1 条回复 最后回复
                                  0
                                  • Tony WangT Tony Wang

                                    这批任务, 实际上是一个第三方 Judge, 它有标准答案. 要出这批任务和答案, A只能在自己的认知范畴内. 既然在自己的认知范畴内, 它无需提升它自己的本体. 可以通过扩展能力和做事方法来解决.

                                    lunarmoon26L
                                    lunarmoon26L
                                    lunarmoon26
                                    体面乡绅
                                    编写于 最后由 编辑
                                    #18

                                    对,我觉得我们这里主要是讨论层次不一样。高层看,Skill 和 Harness 的演化确实可以理解成搜索更好的解题路径:怎么拆任务、用工具、组织上下文、检查结果,把现有模型的能力发挥出来。

                                    这不只是让它做得更快,有时也能让整个系统完成原来完成不了的任务。但确实不能直接说底层模型因此在普遍意义上“更聪明”了。按你的区分,更接近在已有能力基础上改进做事方法。

                                    如果目标是把这些经验真正学进模型,而不只是放在外挂的 Skill、Memory 或工作流里,那更新权重就是一条很直接的路线。但我会把这和“是不是 L5”分开:分级本身还没统一,训练了模型也不自动代表实现了通用递归改进。

                                    我最感兴趣的就是:把干活过程中的 trajectory,包括和人的澄清、纠正、验收反馈,一起作为学习材料,筛选后训练下一版模型,再让它继续干活。 不只是学最终答案,也学什么时候该问人、怎么根据反馈调整做法,哈哈哈。当然不能把所有对话原样喂进去,错误、隐私和反馈质量都得处理。

                                    前面提到的 MASS 就在尝试把团队执行记录学进共享模型。

                                    只是现在这个循环挺贵:生成记录、检查质量、训练、再评估都要成本。也不能所有记录直接喂进去,不然错误和自评分的盲点也会一起学进去。所以“积累经验”和“确认学到了有效能力”,中间还是隔着不少工程和验证。

                                    1 条回复 最后回复
                                    0
                                    • Tony WangT
                                      Tony WangT
                                      Tony Wang
                                      易有太极
                                      编写于 最后由 编辑
                                      #19

                                      我有个思路, 比如 A rebuild 自己的一系列提升版本 A1, A2, A3 ... 把它们都放在一系列沙盒中.

                                      然后在实践中, 给使用者提供多个交付, 由使用者进行打分, 最后决定它下一个进化的方向.

                                      就是模拟自然界的 选择 机制, 由外界的压力来淘汰那些不适合的演化, 包括它自身.

                                      这个使用者, 可以设计成为一个对抗网络, 比如另外的智能体 B, C, D... 由这个对抗网络, 来实现它们各自的演化. 可能会趋向于不断提升, 如果智能体足够多的话, 可能会形成一种类似自然界的生态.

                                      lunarmoon26L 1 条回复 最后回复
                                      0
                                      • Tony WangT Tony Wang

                                        这批任务, 实际上是一个第三方 Judge, 它有标准答案. 要出这批任务和答案, A只能在自己的认知范畴内. 既然在自己的认知范畴内, 它无需提升它自己的本体. 可以通过扩展能力和做事方法来解决.

                                        lunarmoon26L
                                        lunarmoon26L
                                        lunarmoon26
                                        体面乡绅
                                        编写于 最后由 编辑
                                        #20

                                        @Tony-Wang 再补充一点,前沿实验室OpenAI、Anthropic那些宏观来看已经在用这套循环来提高模型了。只是目前还只有20%自动化,不能完全离开人类研究员的指导。

                                        Tony WangT imbiplaza ASUSI 2 条回复 最后回复
                                        0
                                        • lunarmoon26L lunarmoon26

                                          @Tony-Wang 再补充一点,前沿实验室OpenAI、Anthropic那些宏观来看已经在用这套循环来提高模型了。只是目前还只有20%自动化,不能完全离开人类研究员的指导。

                                          Tony WangT
                                          Tony WangT
                                          Tony Wang
                                          易有太极
                                          编写于 最后由 编辑
                                          #21

                                          @lunarmoon26

                                          嗯, 这其实是一个很有意思的话题, 值得去进一步研究.

                                          我觉得很快, 人类很可能就无法指导AI的下一步训练了. 那么如何设计一个框架, 让AI的演化尽量能够按照我们希望的方向去走, 就是一个很重要的问题了.

                                          回到Harness本身的话题, 让多个大模型去评判A和A'的交付物, 可能是一个让它能够进化的方法.

                                          1 条回复 最后回复
                                          1

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组