Agent 能不能越用越会改进自己?聊聊 RSI 和 Harness,抛砖引玉
-
最近看论坛里不少人在折腾 Agent、记忆和 Skills,但围绕递归自我改进(Recursive Self-Improvement,RSI)的讨论,我暂时看到得不多。想开个帖子抛砖引玉。
先交代一下背景:我自己是在对冲基金做 applied AI,最近也刚开始做递归自我改进系统这方面的工作。不是学术研究出身,更关心这些想法怎么变成能实际运行、能评估、出了问题能回退的系统。
这段时间整理了一些论文和 Harness 的实现,越看越觉得,“让 Agent 改进自己”这句话里其实装了好几个不同的问题。下面是我目前的理解,不是成熟结论。如果有做这方面研究的 PhD、研究员,或者已经在实际项目里尝试的朋友,很欢迎纠正和讨论。
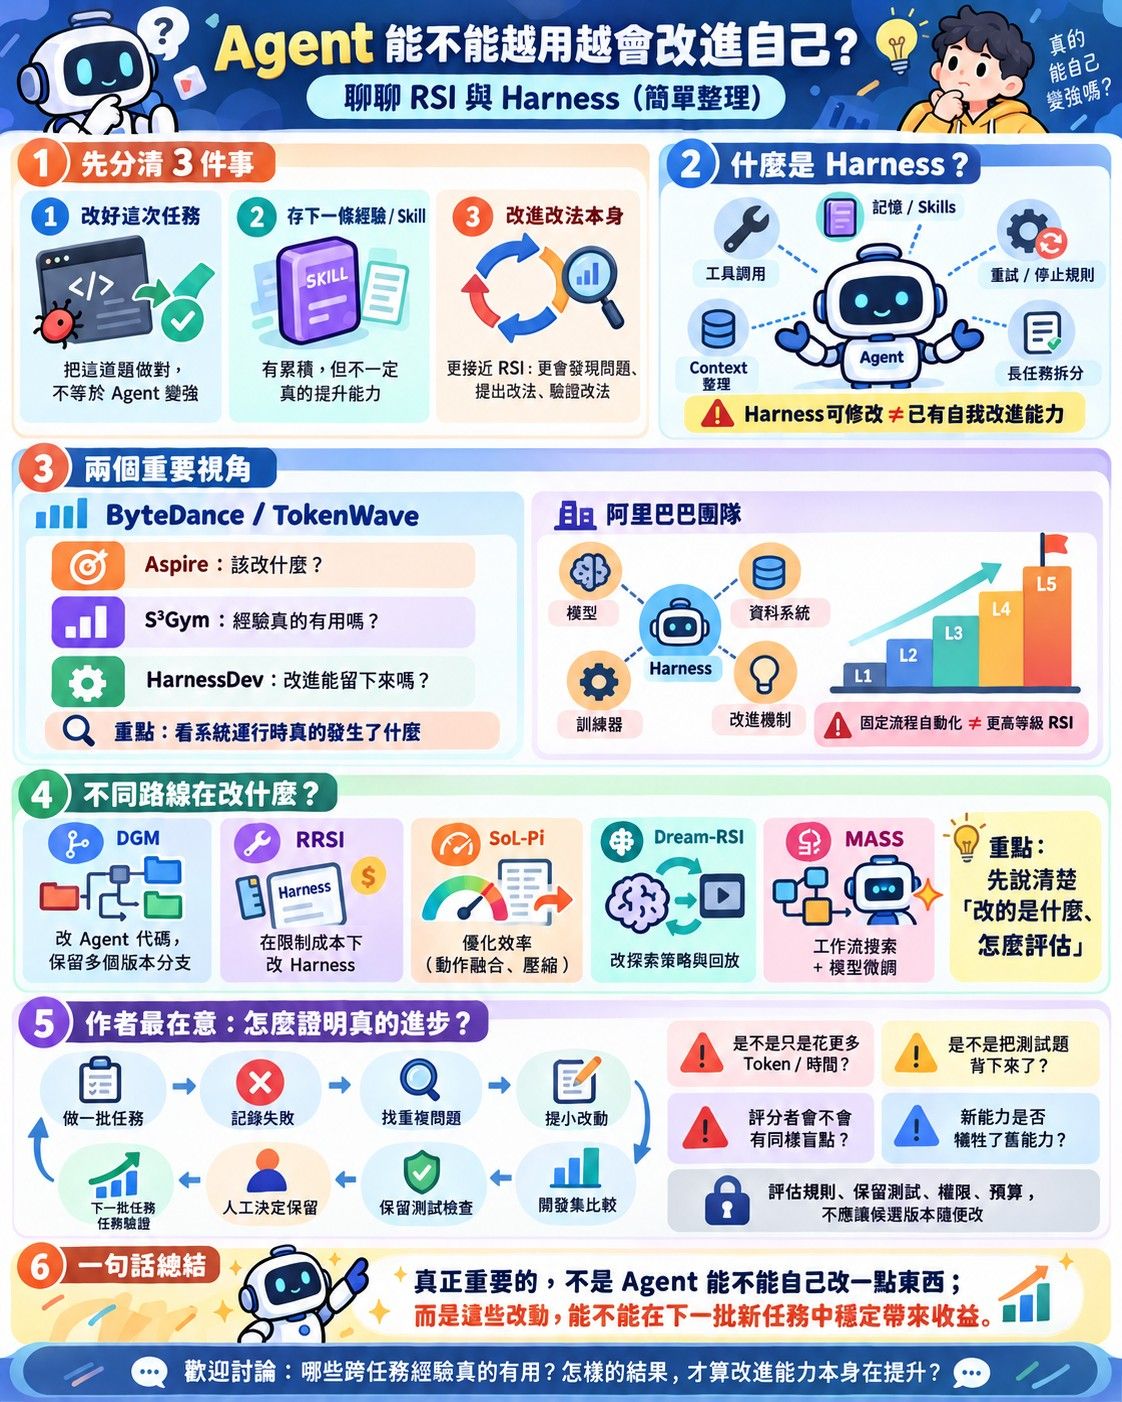
1. Agent 改好了这道题,和 Agent 自己变好了,是一回事吗?
举个很普通的例子:让一个 Agent 写分析脚本,运行,发现报错,再修改,最后通过测试。
这当然有用,但下次换一个任务,它可能还是会犯同样的错误。被改好的是这份脚本,不一定是写脚本的 Agent。
再往前一步:它把失败原因整理成一个 Skill,下一次遇到类似任务时拿出来用。这个变化保留到了任务之外,开始有了积累的可能。但“多存了一条经验”也不等于“能力真的提高了”:可能根本检索不到,也可能把某个任务的偶然经验当成通用规则。
我更感兴趣的是再往前一步:系统能不能改进自己发现问题、提出改法、验证改法的能力?
比如,原本只会随机试 Prompt,后来能从失败记录里找出反复出现的工具使用问题,提出一个小改动,并用新的任务验证。这和在一道题上多反思几轮,就不是同一件事了。
不过 RSI 目前也没有一个大家都同意的门槛。我倾向于先问清楚:改了什么,保留到什么时候,凭什么说更好了?而不是先争论哪个项目配不配叫 RSI。
2. 为什么我会把注意力放在 Harness 上?
光有一个模型,还不够让 Agent 持续做事。谁负责调用工具、保存结果、整理 Context、恢复中断、决定什么时候停、什么时候必须问人?这些围绕模型运行的机制,我这里统称为 Harness。
所以即使模型权重不变,Agent 系统仍然有不少可以改进的地方:
- 工具描述是否让模型容易选对工具;
- 一类重复任务能不能提炼成可复用的 Skill;
- Context 压缩后,有没有丢掉关键约束和失败证据;
- 什么情况应该重试,什么情况应该停下来;
- 长任务如何拆分,子任务之间怎么交接。
这也是我觉得这个方向适合从工程侧切入的原因。不一定一开始就训练模型,也不一定要让 Agent 随意改自己的全部代码。可以先选一个很小的可修改范围,看看反馈能不能稳定地变成下一次的收益。
但反过来说,Harness 可修改,不代表它已经具备自我改进能力。 有 Plugin 接口、有 Memory、有循环,都只是条件;还需要知道什么时候改、怎么选、怎么证明没有改坏。
3. 字节和阿里的两份整合,帮我把问题拆得更清楚了
除了单篇论文,最近还有两份值得一起看的整合。它们的侧重点不一样,我觉得放在一起比较有帮助。
ByteDance Seed 和 TokenWave 的 Self-Developing Agents,把问题拆成了三件事:
- Aspire:该改进什么? 给一个宽泛目标,比如“提高数学推理能力”,Agent 能不能自己把目标变成可执行的学习计划,并在看不到的最终评估上获得收益?
- S³Gym:经验真的有用吗? 把探索、判断结果和改进分开,考察历史记录、总结记忆和参数更新等路径,观察经验能否帮助后续决策,而不是只看它能不能写一篇漂亮的反思。这里参数训练与 Context 方法不是一套完全匹配的对照实验,不能直接混成一个排名。
- HarnessDev:改进能留下来吗? 让模型构建、再演化一个能运行的 Harness,检查新任务上的表现,以及固定执行模型之后,改 Harness 这件事是否仍然有效。
这个项目页里很值得注意的一点,是它不只展示成功:完成了一次更新,不代表超过原始基线;代码里写了 Memory 或状态保存,也不代表实际执行时触发了。对我这种工程侧的人来说,这个提醒很直接:我们究竟是在评估系统的设计,还是它运行时真正发生的事?
阿里巴巴团队的 The Path to Recursive Self-Improving Agents,则更像一张全景地图。它把系统放在五个相互影响的部分里看:模型、Harness、数据系统、训练器,以及负责“诊断 → 提案 → 评估 → 整合”的改进机制。
它还提出了 L1–L5 的分级:从人工修改,到 Agent 提建议、人来验证和应用;再到固定机制下自动提出、应用和验证改动;更往上才是修改改进机制本身,以及跨领域的递归改进。
我觉得这个区分很有用:自动化执行一个固定的优化流程,和让优化流程本身也变得更好,是两件事。 按这份综述的划分,保留人工审核和应用环节的辅助改进,也不应该直接包装成已经实现了更高等级的 RSI。
不过这里的分级是作者提出的框架,不是全行业公认的标准。字节这边的三组 Benchmark,也不能概括成“递归自我改进已经被解决了”。我这里主要引用项目页的组织方式和观察,还没有独立复现底层论文的实验。
对我而言,一份整合更像是在问“闭环会在哪里断”,另一份更像是在问“系统究竟允许哪些东西发生变化”。后面看具体方法时,我会带着这两组问题去读。
4. 具体到不同路线,究竟在改什么?
下面只是帮我理清问题的几个例子,不是排行榜。我也没有在统一条件下复现这些工作的跑分。
- Darwin Gödel Machine(DGM):修改 coding agent 自身的代码,评估后保留多个版本,再从这些版本继续探索。吸引我的不只是“自己改代码”,还有保留不同分支,而不是每次都拿最新版本覆盖旧版本。
- RRSI:在冻结模型权重的前提下,对 Harness 做受编辑预算、历史反馈和成本等约束的修改。对实际工程来说,“允许改多少、花多少成本”本身就很重要,但约束存在也不保证每次都进步。
- SoL-Pi:关注 Harness 的效率机制,比如动作融合、上下文压缩、观测打包。它提醒我,收益不只是一道题做没做对,也可能是相近能力下少花一些 Token 和时间;但发布出来的扩展,不等于整个自动发现过程已经被我们复现。
- Dream-RSI:把改进目标放在探索策略上,用历史探索树的回放来筛选怎么分支、怎么分配并行、什么时候停止,而不是只改最终生成的代码。这里回放能告诉我们的,也受已有探索历史限制;我整理笔记时,仓库仍在准备完整代码和复现脚本,不能把方法介绍当成完整实现已经可复现。
- MASS:把工作流搜索和共享模型的微调交替进行,让更新后的模型继续承担执行、优化和评估角色。这比只改 Harness 又多了一层,但论文里的有限轮实验,仍不能直接推成无限递归加速。
所以我暂时不太愿意把它们都塞进一个“通用 RSI 范式”里。有的改代码,有的改经验,有的改搜索策略,有的连模型权重也一起变。把修改对象和评估方式说清楚,比统一叫“自我进化”更有帮助。
5. 我目前最拿不准的,其实是怎么证明它在进步
如果只想让 Agent 不断提出新版本,现在已经不难了。难的是新版本究竟有没有更好。
我目前比较想从这样一个小闭环开始:
完成一批有明确边界的任务
    → 记录结果和失败类型
    → 找出重复问题
    → 提出一个范围很小的改动
    → 在开发评估任务上比较新旧版本
    → 用不参与改法和选版本的保留测试做最终检查
    → 人工决定是否保留
    → 下一批任务再验证
这里有几个坑,我觉得比“怎么让它反思”更值得讨论:
是不是只是多花了钱? 新版本多试十次、多开几个 Agent,成功率涨了,不一定说明改进机制更强了。至少要把预算、Token、时间和成功率一起看。
是不是把测试题背下来了? 同一批任务反复用来提修改、选版本,最后分数变好很正常。即使换了一批任务,只要反复拿来选版本,也会逐渐变成开发集。最终保留测试需要隔离,不能把它的反馈再喂回去继续调。新的任务还有效吗?甚至只是换一种错误表现,还能识别吗?
谁来判断好坏? 同一个模型提改法、执行、打分,可能共享同一种盲点。我觉得要区分单元测试、外部结果和模型评价,不能全揉成一个“自评分”。测试通过也只说明通过了这些测试。
有没有牺牲旧能力? 某一类任务更快了,另一类任务却开始漏步骤,怎么算?只保留总分可能会把这种退化藏起来。
哪些东西不能由它自己改? 我的倾向是,实验范围里的 Skill、工具说明或小块 Harness 代码可以提出候选;评估规则、保留测试集、权限、预算和上线审批不能让候选随便改。否则很容易变成修改评分规则之后宣布自己进步了。
这不是说一定要人永远手工批准所有东西,而是至少在刚开始时,我宁愿先把证据、版本和回退路径做好,再逐步增加自动化。我自己也还在探索,不想把这种早期尝试说成已经实现了强意义上的 RSI。
想听听大家怎么做
- 大家有没有做过跨任务保留经验、自动改 Skill 或 Harness 的实验?什么改动是真的有用,什么最后只是增加了复杂度?
- 如果模型权重不变,怎样的结果会让你相信“改进能力本身”在提高,而不只是积累了更多模板?
- 评估怎么设计,才能避免越迭代越过拟合?业务结果反馈很慢、很吵的时候,怎么选可靠的中间信号?
- 有没有特别值得读的论文、开源实现,或者反例?尤其欢迎那种“试过,最后没用”的经验。
对我来说,现在最想弄明白的不是 Agent 能不能自己写一段修改,而是这些修改能不能经得起下一批任务。欢迎拍砖,也欢迎做相关研究的朋友帮忙指出我理解里的漏洞。
文中提到的资料:
- Self-Developing Agents — ByteDance Seed / TokenWave
- The Path to Recursive Self-Improving Agents — Alibaba Group
- Darwin Gödel Machine 论文
- RRSI 论文
- SoL-Pi
- Dream-RSI
- MASS 论文
我之前也写过一篇自己的小规模实验记录,里面是更具体的两层循环和评估边界。还在摸索中,放在这里供有兴趣的朋友参考。
-
-
-
-
-
最近有個新聞好像是 RSI遇到一個問題 需要更強大的LLM作Verifier 才能驗證改進或者 這是一個好的改進
我最近讓Qwen Flash 去改進一個系統, GPT-Astra告知問題後, Qwen Flash 東西越加越多 “自以為是改進 越改越複雜”, Flash以為添加了一些東西 就是可以改善現有的問題
樓主的貼文圖表供大家參考
-
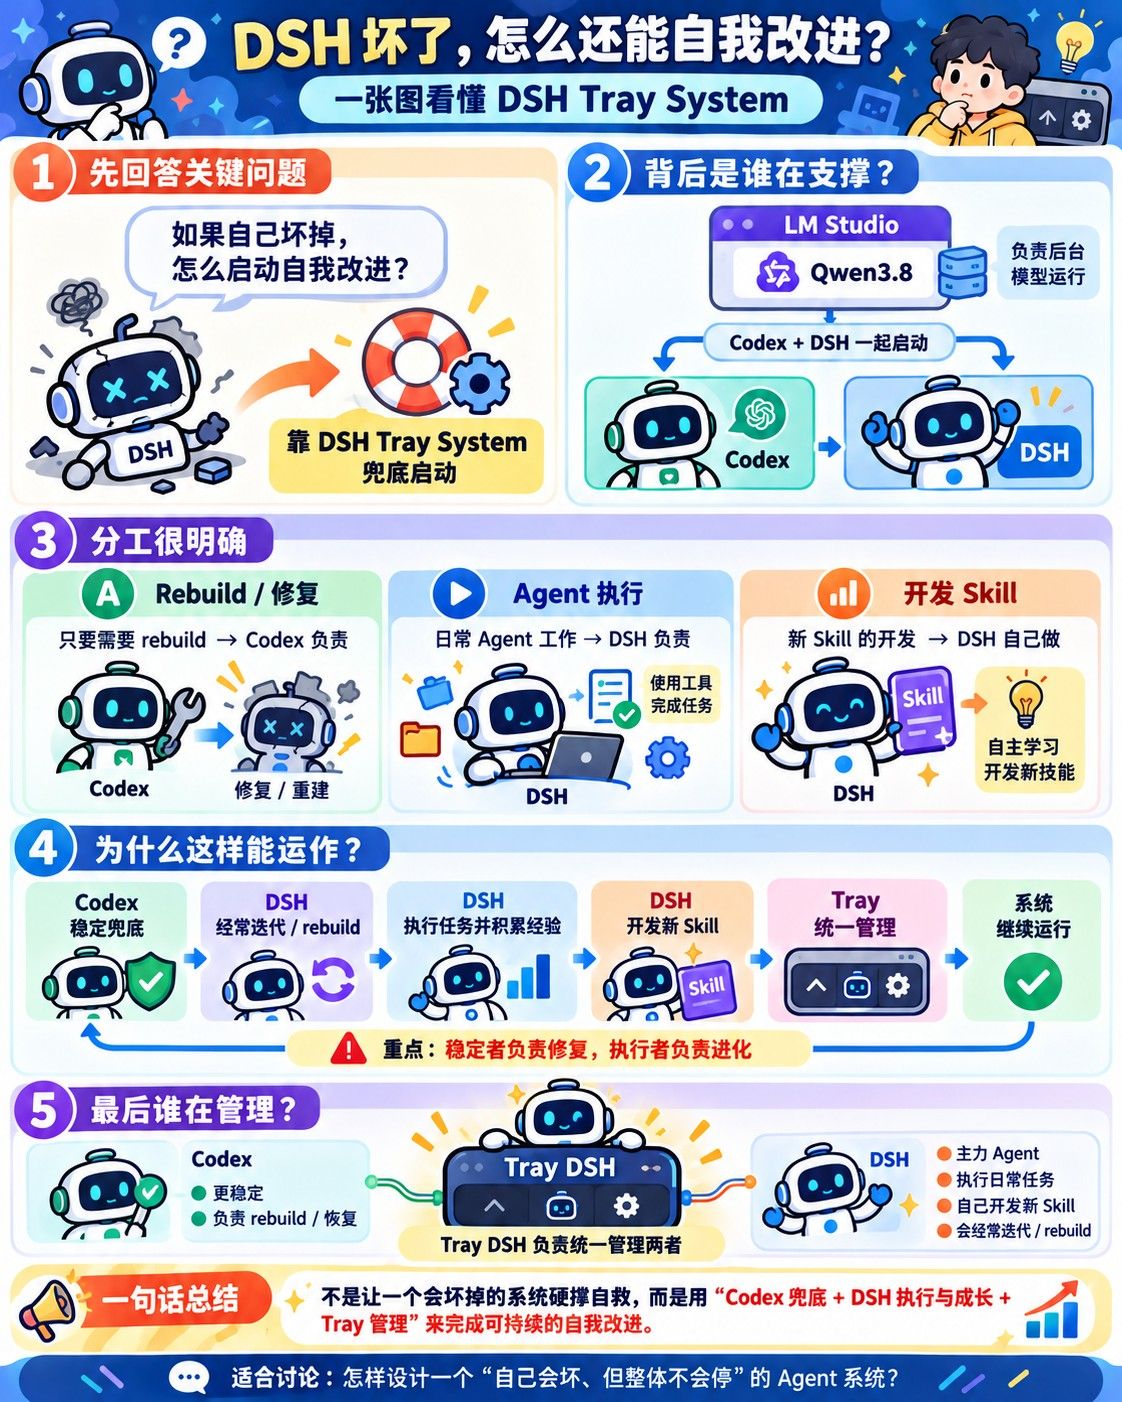
我一直在做着dsh的自我改进的事情。。。。可能你会问,如果本身自己坏掉,怎么能够启动自我改进呢,那样就要说一说我的dsh tray system, 主要是由背后的lm studio 负责qwen3.8, 由codex + dsh 两者启动,
codex 几乎不坏,dsh 几乎时常rebuild,
只要是rebuild > codex 负责
agent > dsh 负责
开发skill > dsh 自己开发最后我使用tray dsh 来管理两者的im
-
我一直在做着dsh的自我改进的事情。。。。可能你会问,如果本身自己坏掉,怎么能够启动自我改进呢,那样就要说一说我的dsh tray system, 主要是由背后的lm studio 负责qwen3.8, 由codex + dsh 两者启动,
codex 几乎不坏,dsh 几乎时常rebuild,
只要是rebuild > codex 负责
agent > dsh 负责
开发skill > dsh 自己开发最后我使用tray dsh 来管理两者的im
我觉得你这个方法是 OK 的,而且把 rebuild 交给相对稳定的 Codex,已经把“执行”和“修复执行器”分开了,不用指望坏掉的 DSH 自己救自己。
我想补充的是,如果要从“能修好自己”走到持续、可验证的改进,我倾向于再明确一层 governor(治理/调度层),来驱动和管理整套体系。普通 coding agent 的核心通常还是“观察 → 调工具 → 看结果 → 再修改”的任务内循环;即使能开子 agent,也不自动等于有了跨任务的改进闭环。不少 RSI 工作会把执行任务和改进执行策略分成两层。
我自己也在做类似尝试:dsh-adaptive-loop。我的用法是 OpenCode 管外循环,DSH 做内层执行,再用 DAL 记录证据和管理候选。目前还在完善,不是说已经跑出了可靠的 RSI 收益。大致分工是:
- 内层: 在固定方法和预算下完成任务,产出代码、实验结果和失败证据。
- 外层: 拆任务、独立验收、管理分支和预算,再根据多次运行的证据提出方法改动;改动另起一批任务验证,而不是一边改研究员、一边用当前结果证明研究员变强了。
我现在特别有感触的是,一套实际工作流往往有很多步,不能每轮都从零开始。比如先 extract 出几个 GB 的 feature,后面不同版本的 DSH 都可能需要复用。应该共享的是输入和生成配置仍然匹配的 artifact,不是让几个 agent 随便覆盖同一个目录;上游特征逻辑变了,下游缓存也不能照用。
所以外部状态机很重要:哪些步骤完成且已验收、结果依赖哪个版本、失败后从哪里继续、哪条分支值得继续推演。回滚也不只是 git revert:还要知道恢复的是哪版代码、配置和 artifact 引用。已经发生的外部操作,更不能假设恢复文件就撤销了。我的方向是保留实验树和依赖关系,只重跑失效的部分;执行器说“完成了”,不直接等于外层接受结果。
Google / DeepMind 等团队的 Dream-RSI 也给了我一个很有启发的例子:底层 coding agent 不变,把“从哪里分支、并行多少、什么时候停”的探索策略单独拿出来改进;历史探索树保存下来,用回放低成本比较策略,再部署到下一轮真实探索。这里的回放只覆盖已经记录的分支,不是能预测任意新方案,也不代表新任务上保证不退化。
所以我不是觉得你的方式不行,反而觉得方向很接近。只是“另一个 agent 能帮它修复”解决了恢复能力;再加上状态、证据、独立验收和受控的版本切换,才比较容易判断这套系统是在积累有效改进,还是只是在不断 rebuild、不断加东西。
另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。
-
-
我觉得你这个方法是 OK 的,而且把 rebuild 交给相对稳定的 Codex,已经把“执行”和“修复执行器”分开了,不用指望坏掉的 DSH 自己救自己。
我想补充的是,如果要从“能修好自己”走到持续、可验证的改进,我倾向于再明确一层 governor(治理/调度层),来驱动和管理整套体系。普通 coding agent 的核心通常还是“观察 → 调工具 → 看结果 → 再修改”的任务内循环;即使能开子 agent,也不自动等于有了跨任务的改进闭环。不少 RSI 工作会把执行任务和改进执行策略分成两层。
我自己也在做类似尝试:dsh-adaptive-loop。我的用法是 OpenCode 管外循环,DSH 做内层执行,再用 DAL 记录证据和管理候选。目前还在完善,不是说已经跑出了可靠的 RSI 收益。大致分工是:
- 内层: 在固定方法和预算下完成任务,产出代码、实验结果和失败证据。
- 外层: 拆任务、独立验收、管理分支和预算,再根据多次运行的证据提出方法改动;改动另起一批任务验证,而不是一边改研究员、一边用当前结果证明研究员变强了。
我现在特别有感触的是,一套实际工作流往往有很多步,不能每轮都从零开始。比如先 extract 出几个 GB 的 feature,后面不同版本的 DSH 都可能需要复用。应该共享的是输入和生成配置仍然匹配的 artifact,不是让几个 agent 随便覆盖同一个目录;上游特征逻辑变了,下游缓存也不能照用。
所以外部状态机很重要:哪些步骤完成且已验收、结果依赖哪个版本、失败后从哪里继续、哪条分支值得继续推演。回滚也不只是 git revert:还要知道恢复的是哪版代码、配置和 artifact 引用。已经发生的外部操作,更不能假设恢复文件就撤销了。我的方向是保留实验树和依赖关系,只重跑失效的部分;执行器说“完成了”,不直接等于外层接受结果。
Google / DeepMind 等团队的 Dream-RSI 也给了我一个很有启发的例子:底层 coding agent 不变,把“从哪里分支、并行多少、什么时候停”的探索策略单独拿出来改进;历史探索树保存下来,用回放低成本比较策略,再部署到下一轮真实探索。这里的回放只覆盖已经记录的分支,不是能预测任意新方案,也不代表新任务上保证不退化。
所以我不是觉得你的方式不行,反而觉得方向很接近。只是“另一个 agent 能帮它修复”解决了恢复能力;再加上状态、证据、独立验收和受控的版本切换,才比较容易判断这套系统是在积累有效改进,还是只是在不断 rebuild、不断加东西。
另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。
加东西,是dsh 自己加
只是rebuild 需要restart dsh, 一旦restart 变成dsh会沉睡
我一开始就是靠一样agent 自己rebuild, 只不过逃不过沉睡得问题,所以才用codex 来做唤醒人。。。。
要不然,我自己就是那位唤醒人
-
我觉得你这个方法是 OK 的,而且把 rebuild 交给相对稳定的 Codex,已经把“执行”和“修复执行器”分开了,不用指望坏掉的 DSH 自己救自己。
我想补充的是,如果要从“能修好自己”走到持续、可验证的改进,我倾向于再明确一层 governor(治理/调度层),来驱动和管理整套体系。普通 coding agent 的核心通常还是“观察 → 调工具 → 看结果 → 再修改”的任务内循环;即使能开子 agent,也不自动等于有了跨任务的改进闭环。不少 RSI 工作会把执行任务和改进执行策略分成两层。
我自己也在做类似尝试:dsh-adaptive-loop。我的用法是 OpenCode 管外循环,DSH 做内层执行,再用 DAL 记录证据和管理候选。目前还在完善,不是说已经跑出了可靠的 RSI 收益。大致分工是:
- 内层: 在固定方法和预算下完成任务,产出代码、实验结果和失败证据。
- 外层: 拆任务、独立验收、管理分支和预算,再根据多次运行的证据提出方法改动;改动另起一批任务验证,而不是一边改研究员、一边用当前结果证明研究员变强了。
我现在特别有感触的是,一套实际工作流往往有很多步,不能每轮都从零开始。比如先 extract 出几个 GB 的 feature,后面不同版本的 DSH 都可能需要复用。应该共享的是输入和生成配置仍然匹配的 artifact,不是让几个 agent 随便覆盖同一个目录;上游特征逻辑变了,下游缓存也不能照用。
所以外部状态机很重要:哪些步骤完成且已验收、结果依赖哪个版本、失败后从哪里继续、哪条分支值得继续推演。回滚也不只是 git revert:还要知道恢复的是哪版代码、配置和 artifact 引用。已经发生的外部操作,更不能假设恢复文件就撤销了。我的方向是保留实验树和依赖关系,只重跑失效的部分;执行器说“完成了”,不直接等于外层接受结果。
Google / DeepMind 等团队的 Dream-RSI 也给了我一个很有启发的例子:底层 coding agent 不变,把“从哪里分支、并行多少、什么时候停”的探索策略单独拿出来改进;历史探索树保存下来,用回放低成本比较策略,再部署到下一轮真实探索。这里的回放只覆盖已经记录的分支,不是能预测任意新方案,也不代表新任务上保证不退化。
所以我不是觉得你的方式不行,反而觉得方向很接近。只是“另一个 agent 能帮它修复”解决了恢复能力;再加上状态、证据、独立验收和受控的版本切换,才比较容易判断这套系统是在积累有效改进,还是只是在不断 rebuild、不断加东西。
另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。
“另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。”
至于你问得,我也不懂他们怎样实现得,总之我看到im 有报告&信息来说任务完成,就可以了。。。。
这些事情,你得问你的agent
-
我有个疑惑是, 这个你提到的RSI, 如果只是在 memory, skill 等外挂能力方面, 我觉得是没有问题的.
但如果RSI指向它本体, 这个可能会产生一个悖论, 它如何知道自己是提升了的呢?
比如, 如果 Harness A, 决定升级它自己到 Harness A', 那么显然 A' 的能力是超过 A 的 才对. 可是 A 如何判断 A' 是超越自己的呢? 显然这里需要引入一个 第三方的 judge. 而一旦有第三方的judge, RSI 又无法成立了.
自然世界之所以有演化, 是因为现实的演化. 我们现在看到的, 似乎是AI已经开始再协助, 或者是主导训练它的下一代. 是因为主要还是在人类之前的知识框架下.
如果让AI自主控制自己的演化, 我认为它的演变很可能是随机方向的. 不大可能持续进化.
所以我认为, RSI是不存在的, 只有 RSE, Recursive Self Evolution.
-
“另外也想请教一下,你这边 Codex 和 DSH 之间具体是怎么通信的?是通过 DSH 的 ACP 接口,把 DSH 接成 Codex 的 subagent,还是 tray 在中间做消息转发和调度?如果外层需要多轮追问同一个 DSH agent,你是怎么保留它的 session,并在后续调用里继续同一个会话的?比如 DSH 返回结果后,Codex 验收发现问题,再带着反馈让它接着做,而不是每次新开一个 agent。这部分我觉得其实就属于循环工程了,也是我现在比较关心的地方。”
至于你问得,我也不懂他们怎样实现得,总之我看到im 有报告&信息来说任务完成,就可以了。。。。
这些事情,你得问你的agent
明白了,我前面把 Codex 的角色理解得重了一点。实际上是 DSH 自己加功能、自己 rebuild,Codex 主要负责重启之后把它唤醒,替代原本需要你手动做的那一下。这样分工就清楚了。
底层通信确实可以让 agent 去检查代码,不一定需要使用者自己研究协议。你这边通过 IM 看报告、接收结果,本身也是一种很自然的使用方式。
这也让我觉得,后面值得完善的不一定是让用户懂更多底层,而是让系统把几个状态表达清楚:进程重启了、任务继续了、任务完成了,以及改动通过验证了,这几件事最好能区分。比如 rebuild 后,是继续原来的任务和上下文,还是新开会话接着做,系统可以自己记录并在报告里说明。
最近 Claude Code 的 Mods 和 Plugin Evals 也挺值得关注:一个把运行机制开放出来修改,一个提供行为测试和有/无插件对照。我觉得这些都是 stepping stones,但还不是完整的 RSI 闭环。
我的感觉是,业界已经有不少通信和扩展接口,但“改了什么、怎么验证、保留哪版、重启后怎么继续”这些跨工具的状态和交互,还没有形成广泛互操作的一套做法。我自己的项目也在摸索这部分。理想情况不是让用户操心这些细节,而是 agent 和外层系统把它管理好,用户需要时能看清、能暂停、能回退。
-
-
我有个疑惑是, 这个你提到的RSI, 如果只是在 memory, skill 等外挂能力方面, 我觉得是没有问题的.
但如果RSI指向它本体, 这个可能会产生一个悖论, 它如何知道自己是提升了的呢?
比如, 如果 Harness A, 决定升级它自己到 Harness A', 那么显然 A' 的能力是超过 A 的 才对. 可是 A 如何判断 A' 是超越自己的呢? 显然这里需要引入一个 第三方的 judge. 而一旦有第三方的judge, RSI 又无法成立了.
自然世界之所以有演化, 是因为现实的演化. 我们现在看到的, 似乎是AI已经开始再协助, 或者是主导训练它的下一代. 是因为主要还是在人类之前的知识框架下.
如果让AI自主控制自己的演化, 我认为它的演变很可能是随机方向的. 不大可能持续进化.
所以我认为, RSI是不存在的, 只有 RSE, Recursive Self Evolution.
我觉得这里可以拆成两个循环:一个负责干活,一个负责改进干活的方法。
比如 A 提出一个新版 A′,先别急着替换自己,让两个版本在相同条件下跑一批任务,再看结果。A′ 不一定更强,也可能改坏了,那就不保留。
A 也不需要先变得比 A′ 更聪明,才能发现它某些地方做得更好。就像我不一定会写一个更快的排序算法,但可以检查结果对不对、跑得快不快。当然,开放式任务就没这么容易测了。
最近 Sakana AI 和伯克利的 MASS 就在探索你说的这个问题:同一个模型分别负责干活、优化工作流和评价结果,再从自己选出的团队执行记录里训练下一版模型,继续下一轮。它不是靠一个更强的外部 judge 来驱动整个改进过程。
不过这里要区分:研究者另外用了外部模型评估效果,但这些评分没有反馈给 MASS。也就是“系统靠什么改进”和“我们怎么检查它有没有改进”,是两件事。他们只做了两轮完整实验,不同任务上的收益也不一致,还不能说证明了无限、持续的自我改进。
所以我不太觉得“有第三方 judge,RSI 就不成立”;也不觉得必须完全靠自己打分,才算 self-improvement。关键还是这个反馈靠不靠谱。
但你说“演变不等于进步”,这个我同意。不断出新版本不代表越来越好。MASS 自己也指出,同一个模型干活、评价、再学习,可能把共同的盲点一轮轮放大。这不是已经解决的问题,反而正是值得研究的地方。
-
-
如果 DSH 能自己rebuild, 且不依靠第三方裁判的话, 我觉得没有机制能让它持续进化, 只能是随机演化.
一个智商100的 harness+大脑, 无法判断它推导出的下一个版本是 智商110.
对,单靠“自己 rebuild 成功了”,确实不能说明能力提高了。但也不一定非要一个“智商更高的裁判”,有些目标可以直接测。
比如 Karpathy 的 autoresearch,就是一个很直观的起点:固定评估代码,每次给五分钟训练预算,看验证集的 bits per byte 有没有下降,好了就保留,不好就撤回。它测的是明确条件下的训练效果,不是在判断“智商从 100 涨到 110”。严格说,这也不等于改进循环本身已经能自我改进。
更难的问题其实是:换成开放式任务,什么叫“更好”?rubric 怎么定?有没有足够通用、又不容易被钻空子的指标? 我目前还没看到一个公认的、什么任务都适用的答案。正确率、成本、稳定性、泛化能力,往往还会互相拉扯。
再往上一层,连“怎么提出改法、怎么分配实验预算、怎么筛选版本”这套改进循环,也可以成为优化对象——开始套娃了,哈哈哈。
Weco 的 AIDE² 就做了类似尝试:内循环改任务代码,外循环改内层研究 Agent 的 Harness,用固定成本预算和内层看不到的私有评分来筛选。他们还把改出来的 Agent 放回外循环,测试它是不是也更会“改进别人”。
不过作者自己也说,最后这一步还没有足够强的证据,效率差异也没达到统计显著。所以我倾向于说:特定范围内的改进可以测,但“改进能力也持续变强”需要另外证明,更不能直接推出无限进化。
所以很多 RSI 实验还是先把任务范围、预算和评价规则圈定,建立一个可测的改进闭环。这和“面对任意开放式任务,都能可靠判断自己有没有进步”,距离还挺远。像 MASS 已经在探索开放式研究任务,但不能说通用、持续的自我改进已经实现了。现在更有把握的,还是特定条件下的有限改进。
-
这批任务, 实际上是一个第三方 Judge, 它有标准答案. 要出这批任务和答案, A只能在自己的认知范畴内. 既然在自己的认知范畴内, 它无需提升它自己的本体. 可以通过扩展能力和做事方法来解决.
对,我觉得我们这里主要是讨论层次不一样。高层看,Skill 和 Harness 的演化确实可以理解成搜索更好的解题路径:怎么拆任务、用工具、组织上下文、检查结果,把现有模型的能力发挥出来。
这不只是让它做得更快,有时也能让整个系统完成原来完成不了的任务。但确实不能直接说底层模型因此在普遍意义上“更聪明”了。按你的区分,更接近在已有能力基础上改进做事方法。
如果目标是把这些经验真正学进模型,而不只是放在外挂的 Skill、Memory 或工作流里,那更新权重就是一条很直接的路线。但我会把这和“是不是 L5”分开:分级本身还没统一,训练了模型也不自动代表实现了通用递归改进。
我最感兴趣的就是:把干活过程中的 trajectory,包括和人的澄清、纠正、验收反馈,一起作为学习材料,筛选后训练下一版模型,再让它继续干活。 不只是学最终答案,也学什么时候该问人、怎么根据反馈调整做法,哈哈哈。当然不能把所有对话原样喂进去,错误、隐私和反馈质量都得处理。
前面提到的 MASS 就在尝试把团队执行记录学进共享模型。
只是现在这个循环挺贵:生成记录、检查质量、训练、再评估都要成本。也不能所有记录直接喂进去,不然错误和自评分的盲点也会一起学进去。所以“积累经验”和“确认学到了有效能力”,中间还是隔着不少工程和验证。
-
-
这批任务, 实际上是一个第三方 Judge, 它有标准答案. 要出这批任务和答案, A只能在自己的认知范畴内. 既然在自己的认知范畴内, 它无需提升它自己的本体. 可以通过扩展能力和做事方法来解决.
@Tony-Wang 再补充一点,前沿实验室OpenAI、Anthropic那些宏观来看已经在用这套循环来提高模型了。只是目前还只有20%自动化,不能完全离开人类研究员的指导。