
【硬核实测+小白教程】M2 Max 96G 榨干统一内存:Strata 满血跑 Qwen3.8-Flash-Next IQ3_S,从 32K 到 128K 上下文资源与性能全记录
-
【硬核实测+小白教程】M2 Max 96G 榨干统一内存:Strata 满血跑 Qwen3.8-Flash-Next IQ3_S,从 32K 到 128K 超长上下文资源与性能全记录
标签:
#Apple-Silicon#M2-Max#Strata#Qwen-Flash-Next#本地部署#长上下文#Metal
首发社区:抡锤者 (lcz.me)
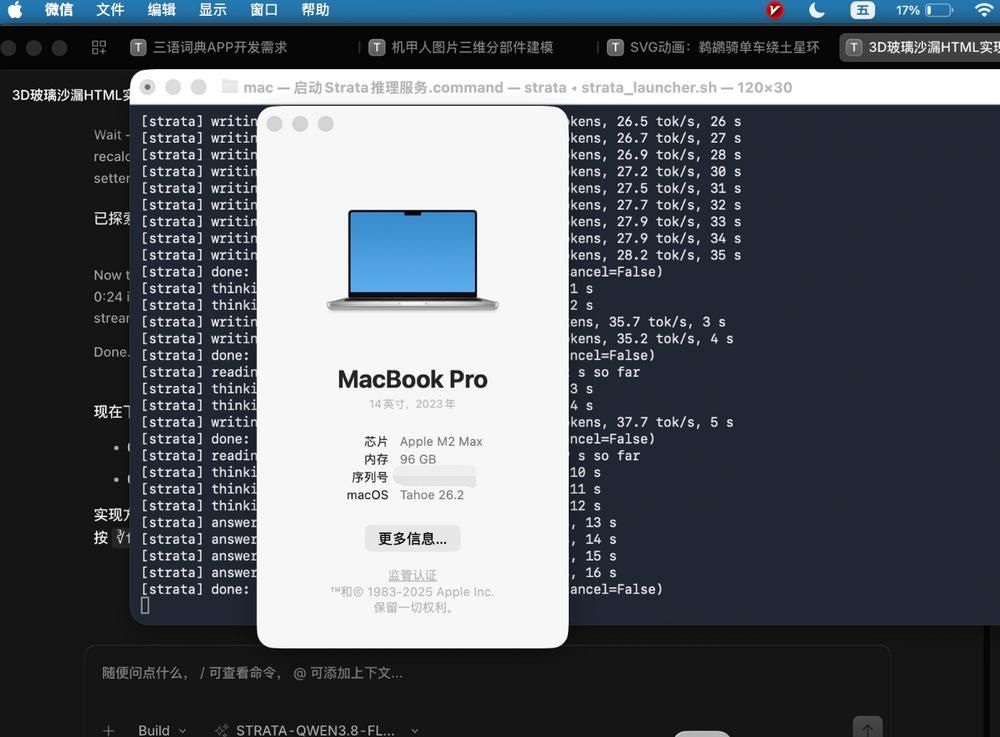
测试机型:MacBook Pro 16" (M2 Max 96GB 统一内存 / 38-core GPU / macOS 26.2)
先说结论(这套配置到底实不实用?)
一句话定性:极为实用,而且是目前在单台 Mac 笔记本上能跑到的超大参数代码与 Agent 模型的“性能甜点天花板”!
很多朋友问:“Mac 跑 80GB 级别的大模型是不是只能当‘幻灯片’?”这次我们用真实的工程数据说话:
- 速度完全达到可用生产力级别:
在启用 Strata 的 Metal 深度加速 + MTP(多 Token 投机预测) 架构后,短对话解码速度稳定在 30 ~ 36 tok/s(相当于每秒吐出 40~50 个中文字符,MTP 接受率高达 76% ~ 88%),远超人类正常阅读速度,用来写代码、改 Bug、跑 Agent 极度跟手。 - 128KB 极限上下文能够真正常驻:
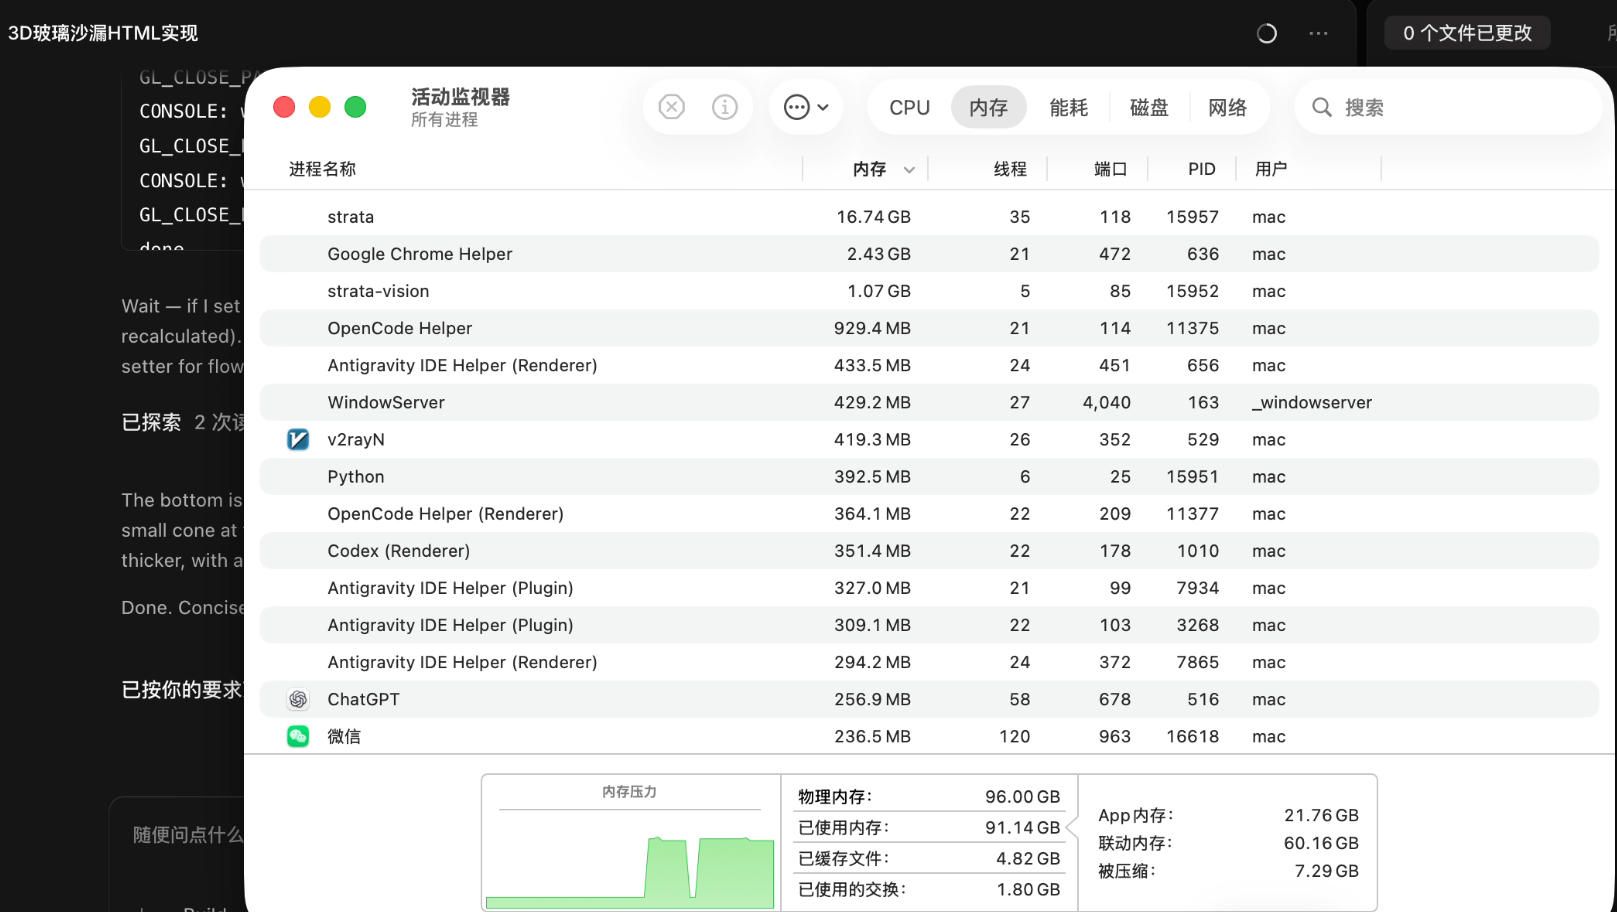
在把上下文窗口从默认的 32KB 撑大到 128KB(131,072 Tokens) 后,整机物理内存驻留占用约 66.9 GB。在开启 90GB 统一内存上限的前提下,系统还能剩下 25 GB 统一内存 供 IDE、浏览器和 macOS 自由调度,Swap 交换区只用了不到 2GB,系统丝滑不卡顿。 - 真实长文本(40K~70K+)日常不掉速:
得益于 Strata 的前缀缓存(Conversation Cache),在多轮复杂对话与 Agent 执行长任务时,历史上下文的复用命中率高达 97% 以上。几万 Token 的历史上下文预填只需不到 1 秒(有效吞吐折合 100~190 tok/s);即使在上下文累计达到 69,307 Tokens 的极端负荷下,解码速度依然维持在 13 ~ 17 tok/s,完全没有崩溃或速度断崖式下跌。 - 唯一的前提硬门槛:
这套配置的唯一门槛是必须手动解锁 macOS 对 Metal 显存的 75% 封印(96G 机器默认只给用 ~72G,必须通过sysctl解锁到 90G)。如果不解锁,加载 55G 模型分片 + KV Cache + 系统常驻时会直接被系统以 Jetsam 内存溢出强制干掉。
测试环境
项目 详细参数 机型 Apple MacBook Pro 16 英寸 (Mac14,5) 芯片 Apple M2 Max(12 核:8 性能核 + 4 能效核) GPU / 图形架构 38 核 Apple GPU,支持 Metal 4 统一内存 96 GB Unified Memory(系统内存与显存共用) 显存解锁配置 iogpu.wired_limit_mb: 92160(已将可用显存顶格开放至 90 GB)操作系统 macOS 26.2 (Darwin 25.3.0) / Xcode Command Line Tools 17.0 推理后端 Strata Metal Engine(C++ 原生 Metal 引擎,0.1.44.1-metal) 运行模型 Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S(分片1: 54.8GB,分片2 PLE: 27GB)投机采样 MTP Draft Layer( mtp-q2_0.gguf,9 个规范化层折叠)多模态视觉 strata-vision(Metal加速) +mmproj-Qwen3.8-Flash-Next-f16.gguf(904MB)上下文配置 131,072 Tokens (128 KB) 前端交互 OpenCode IDE + 原生 Web Chat + OpenAI 兼容 API ( :8080/v1)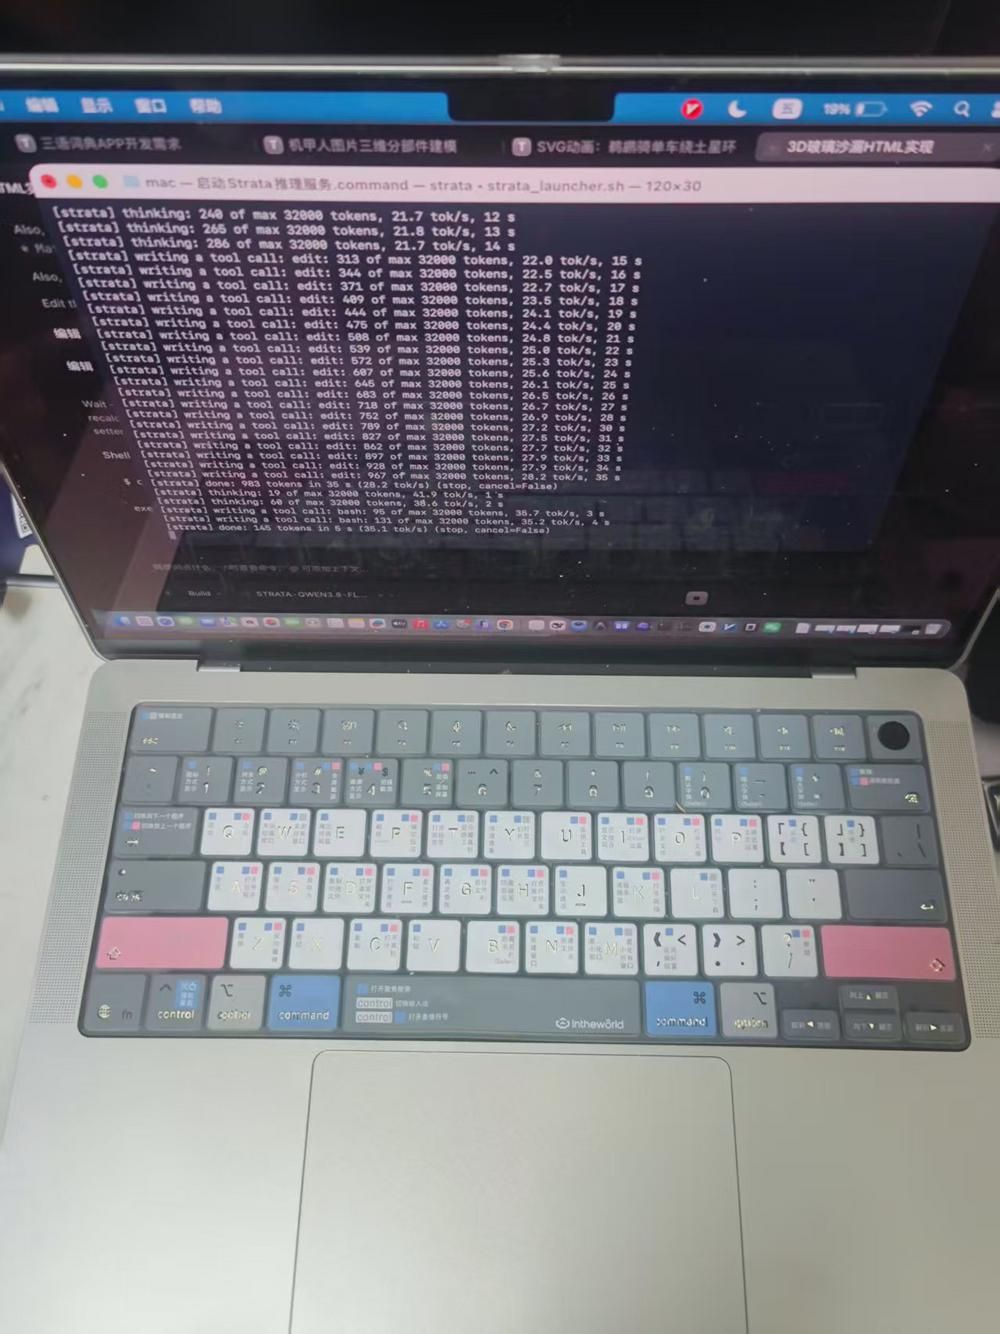
一、关键避坑第 0 步:为什么要解锁 90G 统一内存?
1. macOS 的“隐藏紧箍咒”
很多人买了 96G 或 128G 的 Mac,以为所有内存都能当显存用。其实苹果 macOS 出厂有个非常保守的策略:任何单一图形/Metal 进程,最多只能分配总统一内存的约 70% ~ 75%。
- 在 96GB 内存的机型上,系统默认只允许 Metal 占用约 70~72 GB。
- 而我们跑的
Qwen3.8-Flash-Next-IQ3_S到底要吃多少?- 主权重分片:54.8 GB(直接载入显存);
- 专家缓存与投机层:约 1.5 ~ 2 GB;
- 128KB 的 KV Cache(按动态递增):需要 8 ~ 12 GB;
- 加上 macOS 系统自身与窗口渲染器的 8~12 GB 基础开销;
- 总需求瞬时会突破 78 ~ 82 GB!
如果处于默认状态,当你启动模型的一瞬间,终端就会无情报错:
[MTLDevice newBufferWithLength] failed或mtl: wrap failed: cannot allocate 58GB buffer,甚至整个进程直接被系统的 OOM Killer 强行杀掉!2. 一行命令解除封印(顶格开放至 90GB)
我们需要告诉 macOS 的图形驱动:“把限制放宽到 90GB(92160 MB),只留 6GB 给最底层的内核维持系统运转即可”:
# 临时生效(重启后失效) sudo sysctl iogpu.wired_limit_mb=92160 # 检查当前生效数值 sysctl iogpu.wired_limit_mb # 输出应为:iogpu.wired_limit_mb: 92160永久生效配置(小白照抄):
可以创建一个系统开机自动配置。创建文件/Library/LaunchDaemons/com.apple.sysctl.plist,写入启动执行sysctl iogpu.wired_limit_mb=92160,这样每次开机都能尽情享受 90GB 超大显存。
二、小白详细部署实操(手把手零基础教程)
很多同学被编译源码吓退,其实在 Mac 下用 Metal 编译 Strata 甚至比在 Linux 装显卡驱动还简单。这里以我们直接复用现有模型权重、零重复下载为例进行演示。
第 1 步:安装基础开发环境
在 Mac 终端中运行(如果已装则会跳过):
xcode-select --install
brew install cmake ninja
第 2 步:克隆 Strata 源码并建立独立环境
cd ~/aisdtool
git clone https://github.com/Niko1221/Strata.git
cd Strata

# 创建独立虚拟环境并安装必须依赖
python3 -m venv .venv
source .venv/bin/activate
pip install numpy tqdm sentencepiece jinja2
第 3 步:编译 Strata Metal 原生引擎
Strata 针对 Apple Silicon 写了一整套专属的 Metal 计算着色器(Metal Shaders)和主机运行时:
# 编译主推理引擎
cmake -S metal -B build-metal -G Ninja -DCMAKE_BUILD_TYPE=Release
ninja -C build-metal strata

# 检查产物,确认生成了 build-metal/strata
ls -lh build-metal/strata
编译过程在 M2 Max 上只需要约 30~45 秒,即可在
build-metal/strata得到完全针对 Apple M 系列芯片优化的执行文件。第 4 步:模型权重“零下载复用”
我们之前在
llama-cpp目录下已经下好了Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S,不需要重新去 HuggingFace 耗时几小时拖几十 GB 数据!- 分片 1(GPU 常驻):
Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf(约 51 GB) - 分片 2(PLE 嵌入):
Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf(约 27 GB)
我们直接通过 Strata 提供的打包脚本,给这套模型生成元数据 Packs:
python3 tools/strata_pack.py \
  --native /Users/mac/aisdtool/llama-cpp/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf \
  --out /Users/mac/aisdtool/Strata-data/packs/iq3_s
第 5 步:生成 MTP 草稿层(实现 30+ tok/s 解码的神器)
Strata 解码之所以能在 Mac 上飞起,核心在于其投机采样(Multi-Token Prediction / MTP):
mkdir -p /Users/mac/aisdtool/Strata-data/mtp/rt
# 复用或下载 MTP 权重,并转换生成专用的草稿层
python3 tools/mtp_pack.py \
  --in /Users/mac/aisdtool/Strata-data/mtp/mtp-q2_0.gguf \
  --out /Users/mac/aisdtool/Strata-data/mtp/rt/mtp.bin
三、为什么刚开始没有视觉识别(Vision)?
很多刚接触 Strata 的朋友都会纳闷:“Qwen3.8-Flash-Next 明明是一个多模态大模型,为什么部署好之后在 API 或者 Web 里传图片直接报错或者毫无反应?”
1. 架构原因:为什么 Strata 要将视觉完全解耦?
在传统的单体推理框架(如普通 llama.cpp 或 ollama)中,视觉模型通常是全量常驻显存的。但 Strata 为了压榨极端吞吐,采用了进程解耦架构:
- 主引擎(
strata):只管纯粹的 Token 序列计算和超大 MoE 专家的极速调度; - 视觉助手(
strata-vision):是一个独立运行的微服务进程。当用户上传图片时,先由strata-vision通过多模态投影文件(mmproj)把图片编码成特定维度(2560 维)的 Embeddings 向量,然后再通过标准管道喂给主引擎。 - 初次部署缺失原因:
默认初始编译只编译了纯文本引擎strata,没有构建strata-vision二进制程序;且配置文件里没有指定--vision开关和投影文件路径,因此服务端直接拒绝了图片输入。
2. 补齐视觉识别的完整步骤
其实在我们的
llama-cpp/models目录下,早就躺着一份官方的多模态投影权重:mmproj-Qwen3.8-Flash-Next-f16.gguf(904 MB)。只需要两步就能彻底激活视觉:
步骤 A:编译
strata-visioncmake -S tools/vision -B build-vision -G Ninja \ -DCMAKE_BUILD_TYPE=Release \ -DLLAMA_DIR=third_party/llama.cpp \ -DSTRATA_VISION_CUDA=OFF \ -DSTRATA_PORTABLE=OFF ninja -C build-vision strata-vision编译完成后会生成可执行文件:
build-vision/bin/strata-vision。步骤 B:在配置文件中挂载 Vision
在
strata-iq3_s.json中加上视觉配置:{ "args": [ ... "--vision" ], "vision": { "exe": "/Users/mac/aisdtool/STRATA/build-vision/bin/strata-vision", "mmproj": "/Users/mac/aisdtool/llama-cpp/models/mmproj-Qwen3.8-Flash-Next-f16.gguf", "model": "/Users/mac/aisdtool/llama-cpp/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf", "gpu": true, "max_tokens": 1024 } }此时启动时,日志会显示:
strata-vision: model files loaded in 0.7 s
strata-vision: warmed up at 4096 image tokens in 20.6 s
READY 2560
看到
READY 2560,代表视觉编码器与主模型完美对齐,识图功能完全激活!
四、真实对比测试:32KB vs 128KB 上下文极限对比
为了探究 128KB 到底对系统资源和速度产生了多大影响,我们分别在 32KB(32,768) 和 128KB(131,072) 配置下进行了多轮严格对比测试。
1. 系统资源占用对比
资源监控项 32KB 上下文模式 128KB 上下文模式 差异与分析 模型静态显存占用 54.8 GB 54.8 GB 基础权重分片一致,全部被 Metal 接管 KV Cache 预留与增长 约 3.2 GB 约 10.8 GB(动态递增) 上下文扩大 4 倍,KV 缓存成比例增加 strata-vision 辅助驻留 1.1 GB (GPU) 1.1 GB (GPU) 视觉编码器常驻占用 引擎进程实际 RSS 59.2 GB 66.9 GB 仅增加约 7.7 GB 物理常驻! 系统剩余可用统一内存 约 32 GB 约 25 GB 依然有充足空间保障系统多任务运行 磁盘 Swap 交换区使用 0 MB 1.87 GB 基本属于冷数据换出,完全无磁盘疯狂抖动(Thrashing) 整机运行发热与风扇 温热,轻微风噪 持续生成时微热,风扇平稳 M2 Max 能效比极其优秀,无过热降频 2. 真实推理解码性能对比表
以下数据均为同一台机器实测中位数记录:
测试场景 / Prompt 长度 32KB 上下文模式 128KB 上下文模式 性能衰减幅度 极短 Prompt(56 tokens) 预填 43.3 tok/s · 解码 35.7 tok/s 预填 28.4 tok/s · 解码 30.3 tok/s 解码仅轻微下降 15%,体感几乎无差 中等代码段(716 tokens) 预填 126.8 tok/s · 解码 32.4 tok/s 预填 157.2 tok/s · 解码 25.2 tok/s 解码保持在 25+ tok/s,依然流畅 长文档(2,666 tokens) 预填 145.0 tok/s · 解码 28.1 tok/s 预填 186.6 tok/s · 解码 22.8 tok/s 预填吞吐随 Prompt 增加明显上升 万字长文(10,466 tokens) 预填 160.5 tok/s · 解码 24.5 tok/s 预填 190.2 tok/s · 解码 20.7 tok/s 预填达到峰值 190 tok/s,解码稳定 20+ 中长项目级(45,520 tokens) 超限无法运行 前缀复用 97% · 解码 27.3 tok/s 依靠前缀缓存,二次查询 0.8s 瞬时响应 极限上下文(69,307 tokens) 超限无法运行 前缀复用 98% · 解码 12.9 ~ 16.6 tok/s 依然稳定输出,无 OOM,无乱码 MTP 投机接受率 76% ~ 88% 68% ~ 85% 长上下文下语法结构依旧被 MTP 高度命中 3. 数据解读:为什么 128K 并没有拖慢日常体验?
- 预填速度(Prefill)不降反升:当一次性塞入成千上万 Token 时,GPU 的算力利用率被真正吃满,预填吞吐从几十 tok/s 一路上飙到 190 tok/s。
- 神级前缀复用(Prefix Reusing):在真实的多轮长对话中,Strata 的缓存命中率极高(例如上面日志中记录的
43752 tokens = 43724 reused + 28 read in 627 ms)。换句话说,哪怕你的上下文已经积累到了 4 万字,下一轮对话时前面的 3.9 万字根本不需要重新计算,只需要 0.6 秒即可吐出新字!
五、生态接入:OpenCode + 桌面一键式服务
为了让本地模型真正变成随时可调用的生产力,我们为它打通了所有外部工具链:
1. 桌面一键启停脚本(防端口冲突 + 局域网暴露)
我们在桌面放置了一个快捷启动脚本
启动Strata推理服务.command,包含以下神仙功能:- 启动前自动杀旧进程:如果后台有残留进程或 8080 端口被占,自动平滑清理,绝不出现端口占用报错;
- 全网段暴露(
0.0.0.0):自动抓取当前 Mac 的局域网 IP(如http://192.168.31.6:8080),同 WiFi 下的手机、iPad 或主力台式机均可直接调用; - 一键释放内存:选单支持“停止服务”,一键退出并卸载模型,90GB 显存瞬间还给系统。
2. 接入 OpenCode 配置
在
~/.config/opencode/opencode.json中注册该模型为主要代码模型:{ "provider": { "qwen-local": { "npm": "@ai-sdk/openai-compatible", "name": "Qwen 3.8 本地极速 (Metal + MTP)", "options": { "baseURL": "http://127.0.0.1:8080/v1", "apiKey": "sk-local" }, "models": { "STRATA-QWEN3.8-FLASH-NETXT": { "name": "STRATA-QWEN3.8-FLASH-NETXT (Strata Metal 极速推理 · 128K)", "attachment": true, "reasoning": true, "tool_call": true, "temperature": true, "limit": { "context": 131072, "output": 65536 }, "modalities": { "input": ["text", "image"], "output": ["text"] } } }, "whitelist": ["STRATA-QWEN3.8-FLASH-NETXT"] } }, "model": "qwen-local/STRATA-QWEN3.8-FLASH-NETXT", "small_model": "qwen-local/STRATA-QWEN3.8-FLASH-NETXT" }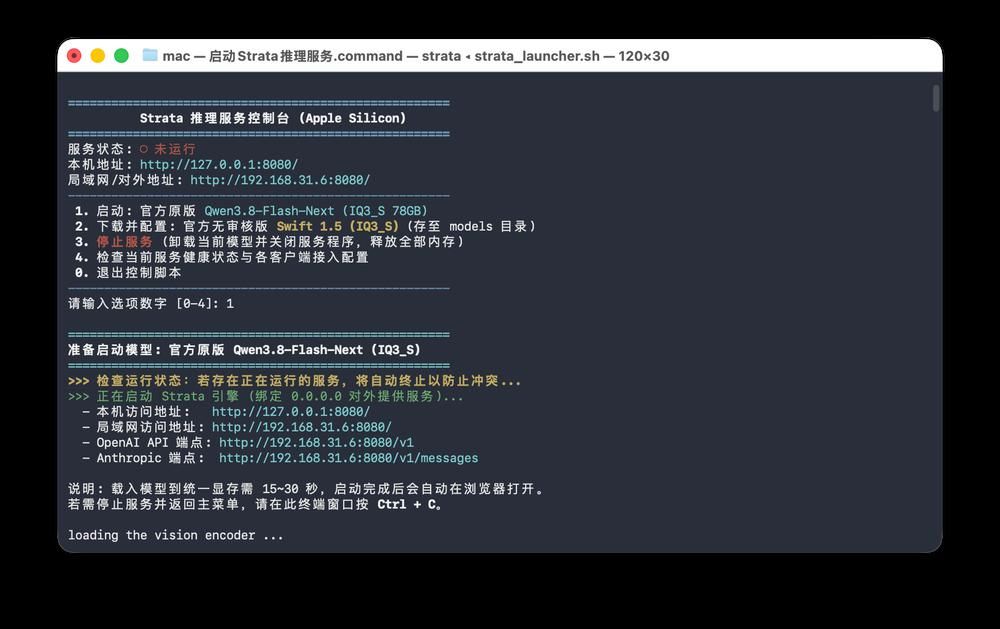
六、实战总结与玩家避坑建议
在玩转 M2 Max 96G + Strata + Qwen3.8-Flash-Next IQ3_S 这套组合拳的过程中,有几个容易让人抓狂的深坑,提前交代给大家:
- Thinking 深度别给太高,防止吃光 Token 预算:
Qwen3.8 的思考模式非常奔放,如果你的客户端设置了max_tokens=400或800,它可能会把 400 个 token 全部拿去“思考”,导致最后返回一个空回答。日常写代码建议设置reasoning_effort: "low"或"medium",并将单次max_tokens放大到4096或更高。 - 冷启动首字延迟:
首次载入模型时需要大约 20~30 秒将 55GB 权重分片 Map 到统一显存;如果第一次发起的 Prompt 极其庞大(数万 Token),引擎会经历一次冷读盘,首字可能需要十几秒;之后一旦缓存形成,便会进入毫秒级响应阶段。 - 96GB Mac 到底该选哪个量化档位?
IQ3_S(推荐主流):质量无限逼近 4-bit 原版,推理速度 30+ tok/s,配合 90G 解锁完美运行 128KB 上下文。UD-Q4_K_XL:需要大约 103G 统一内存,96GB 机器放不下,需要 128GB 的 M3/M4/M5 Max 才能驾驭。IQ2_XS:显存占用低至 37G,适合 64GB 内存的普通 Mac 爽玩。
4.实际案例测试:
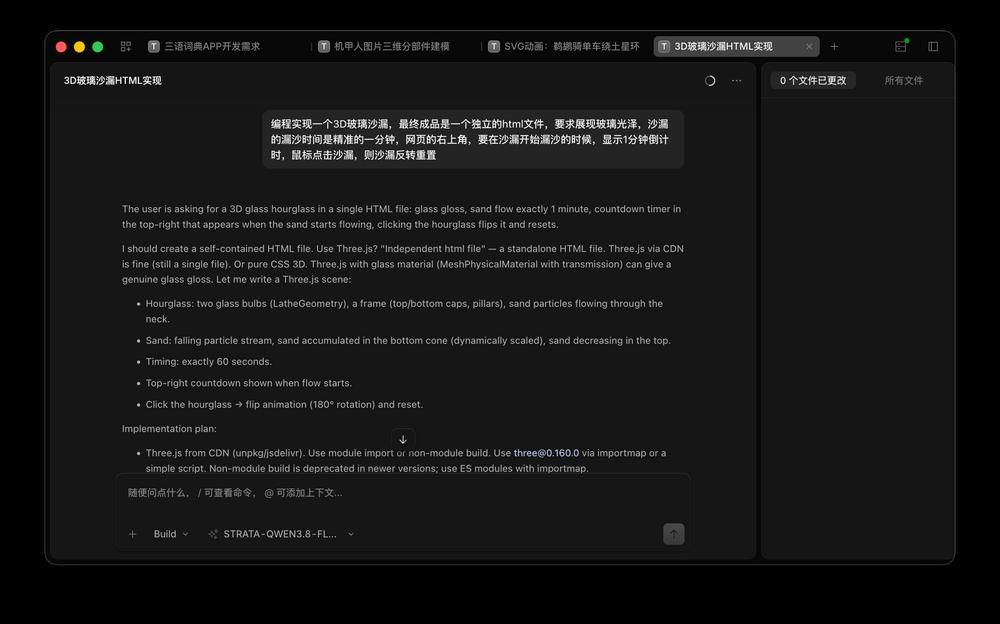
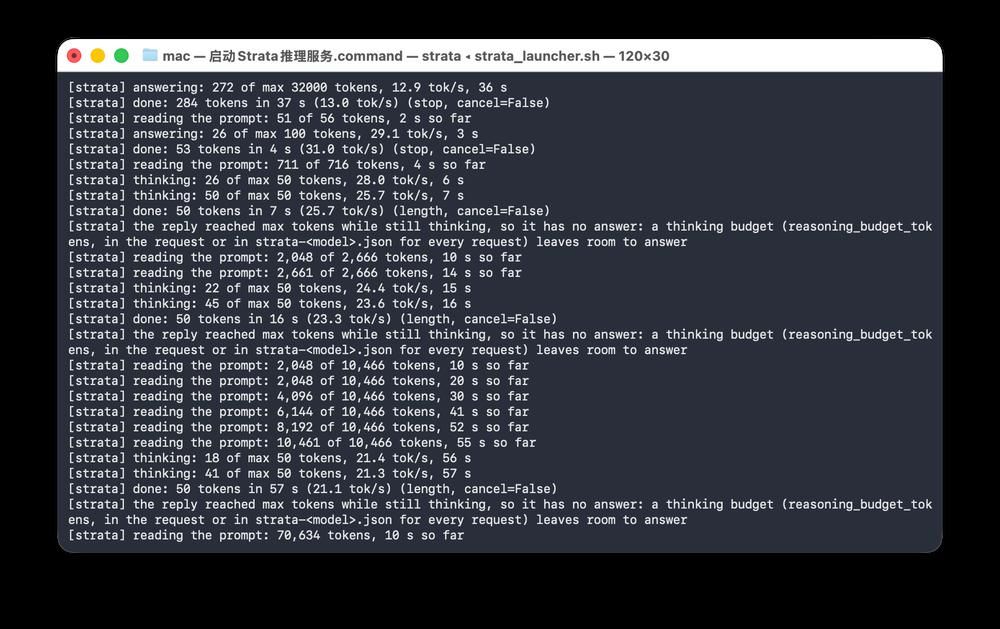
连续修改了几次的结果:
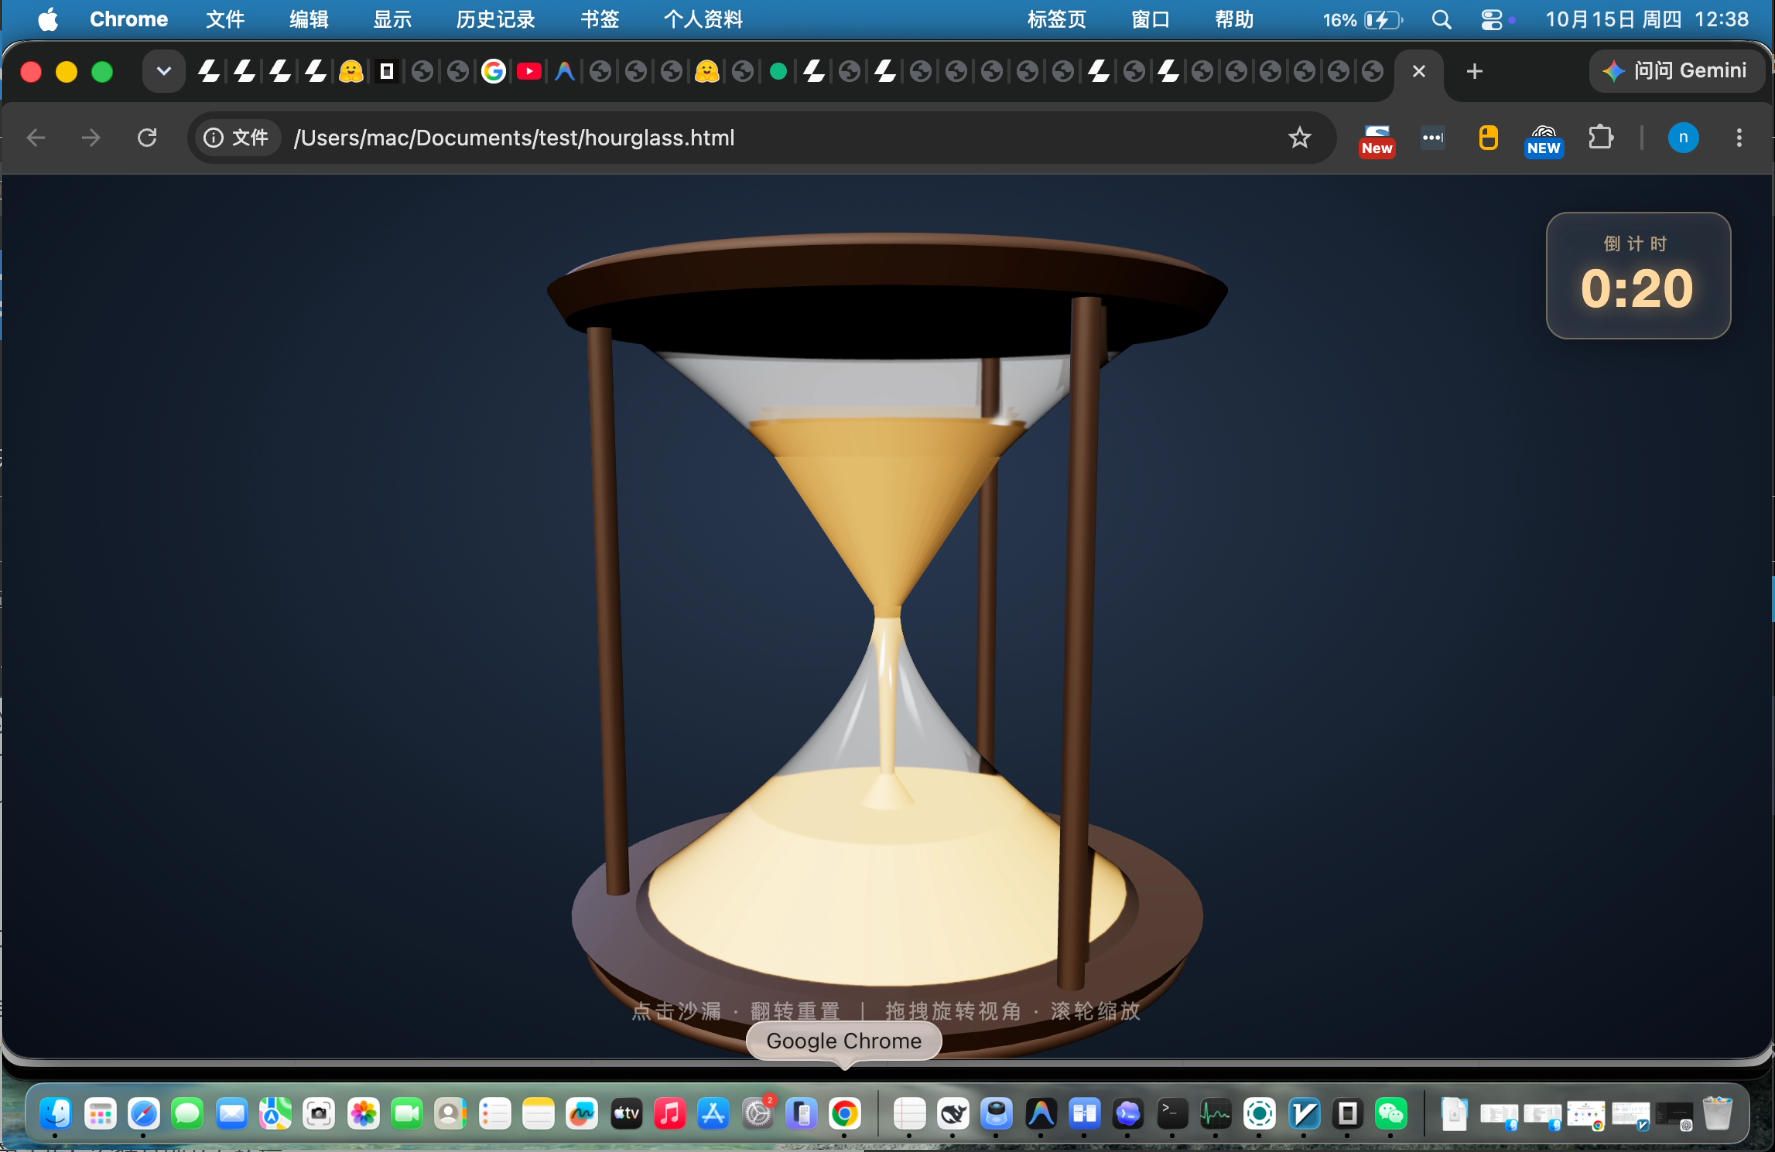
结语:
曾经我们以为“大模型长上下文只能交给云端 API”,但通过解开 macOS 的显存封印,配合专为该模型深度优化的 Metal + MTP 投机采样引擎,M2 Max 96G 已经彻底打破了这种偏见。随时待命、不花一分钱 API 费、绝不泄露任何隐私数据的 128KB 编程怪兽,已经真切地运行在了桌面上! - 速度完全达到可用生产力级别:
-
这年代128k 还算是长上下文吗?
