Club-3090 俱樂部 頂尖對決 GLM-5.3-Flash vs Qwen3.8-Flash-Next vs. Qwen3.8-27B
-
資料很多, 有重點沒提到的歡迎補上喔

GPT Image 圖像快速解說版
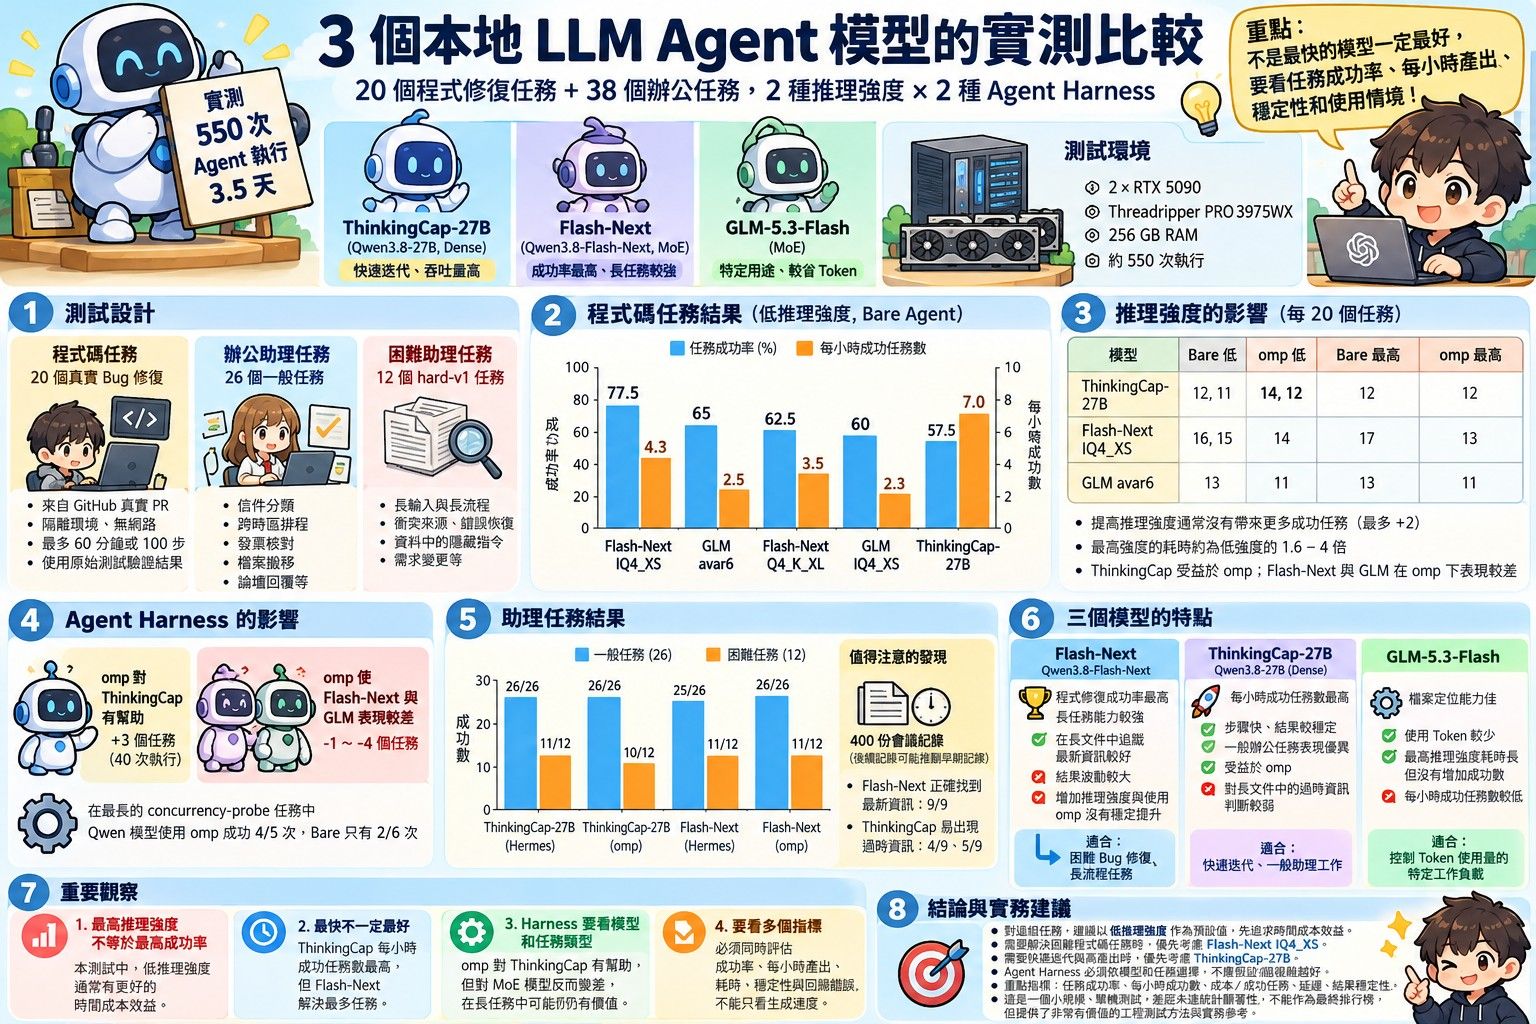
原文作者 : paulp83
配置:2塊RTX 5090顯示卡,TR PRO 3975WX散熱器,256GB記憶體。大約550個代理程式運行了三天半
3 位local LLMs 作為代理完成了以下工作:20 個 club-3090 修復、38 個桌面任務、2 個安全帶、2 個工作量級別 #1690
https://github.com/noonghunna/club-3090/discussions/1690我詢問俱樂部的測試結果是否與我使用的模型和框架有關,維護者要求我做一個 2×2 的對比測試:低強度模型與高強度模型,裸代理與 OMP。我在這個倉庫中提供了三個模型,並運行了上述 2×2 測試,然後給其中兩個模型佈置了一組非編碼的桌面任務。以下是測試結果,包括每個模型的優勢和劣勢,以及我現在使用的設定。
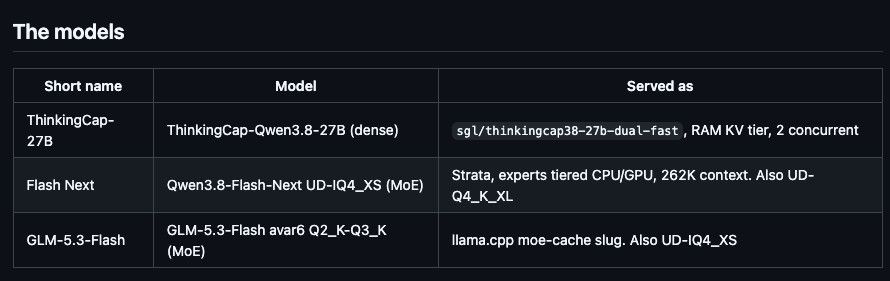
受測目標模型
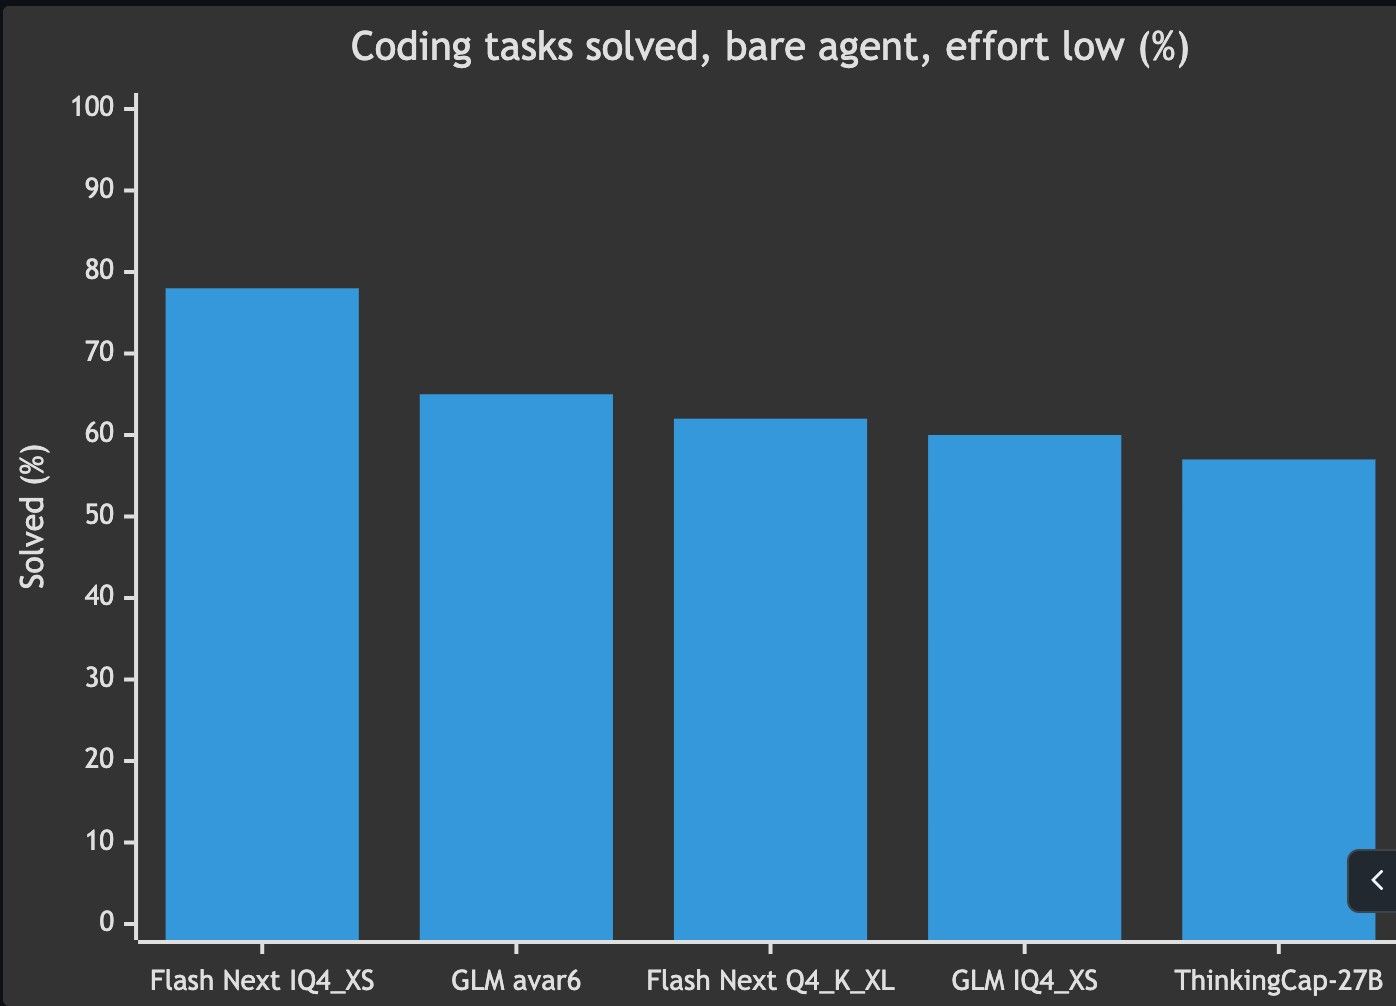
受測結果 成功解題比率
每小時的解題效率
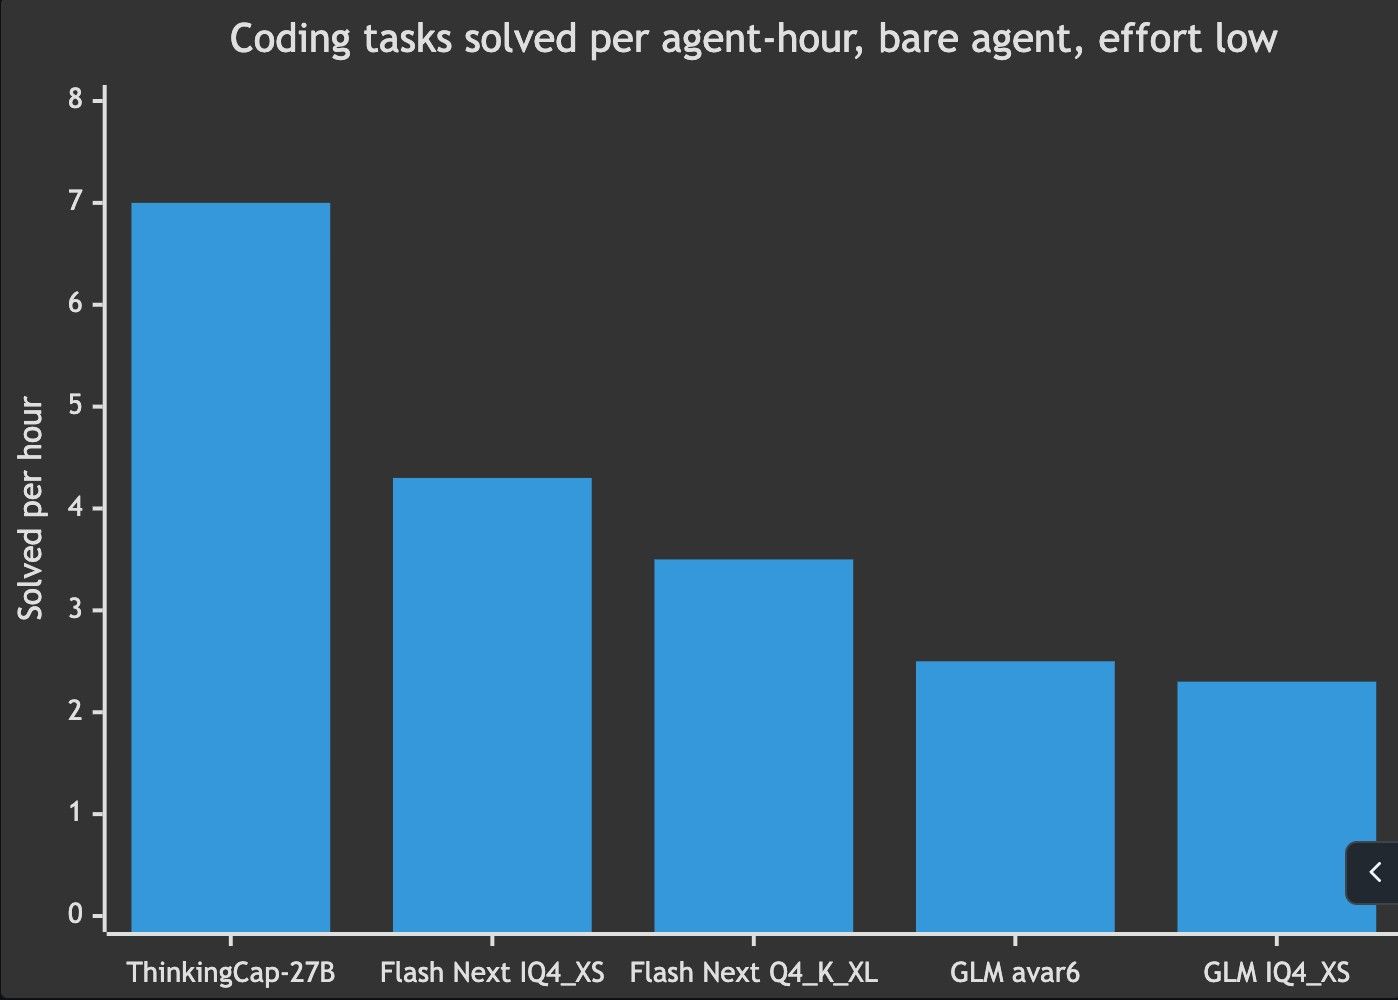
Config Solved 95% CI Partial credit Right files Median min/task Solved per agent-hour Flash Next IQ4_XS 31/40 62–88% 0.85 0.93 9.7 4.3 GLM avar6 13/20 43–82% 0.72 0.96 12.6 2.5 Flash Next Q4_K_XL 25/40 47–76% 0.71 0.88 7.6 3.5 GLM IQ4_XS 12/20 39–78% 0.70 0.93 12.0 2.3 ThinkingCap-27B 23/40 42–71% 0.68 0.87 4.4 7.0 -
-
这些模型我也都跑过哎, 虽然没有测这么全, 但是这个结果跟我的感觉是一样的。最扯的是 GLM5.3 Flash IQ2 还会在数学题上算错,而GLM IQ4我跑起来只有 15tok/s
-
-