跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. Club-3090 俱樂部 頂尖對決 GLM-5.3-Flash vs Qwen3.8-Flash-Next vs. Qwen3.8-27B

Club-3090 俱樂部 頂尖對決 GLM-5.3-Flash vs Qwen3.8-Flash-Next vs. Qwen3.8-27B

已定时 已固定 已锁定 已移动 LLM讨论区
rtx3090glmqwen
5 帖子 4 发布者 341 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • kos orK
    kos orK
    kos or
    至尊皇帝
    编写于 最后由 kos or 编辑
    #1

    資料很多, 有重點沒提到的歡迎補上喔 😊

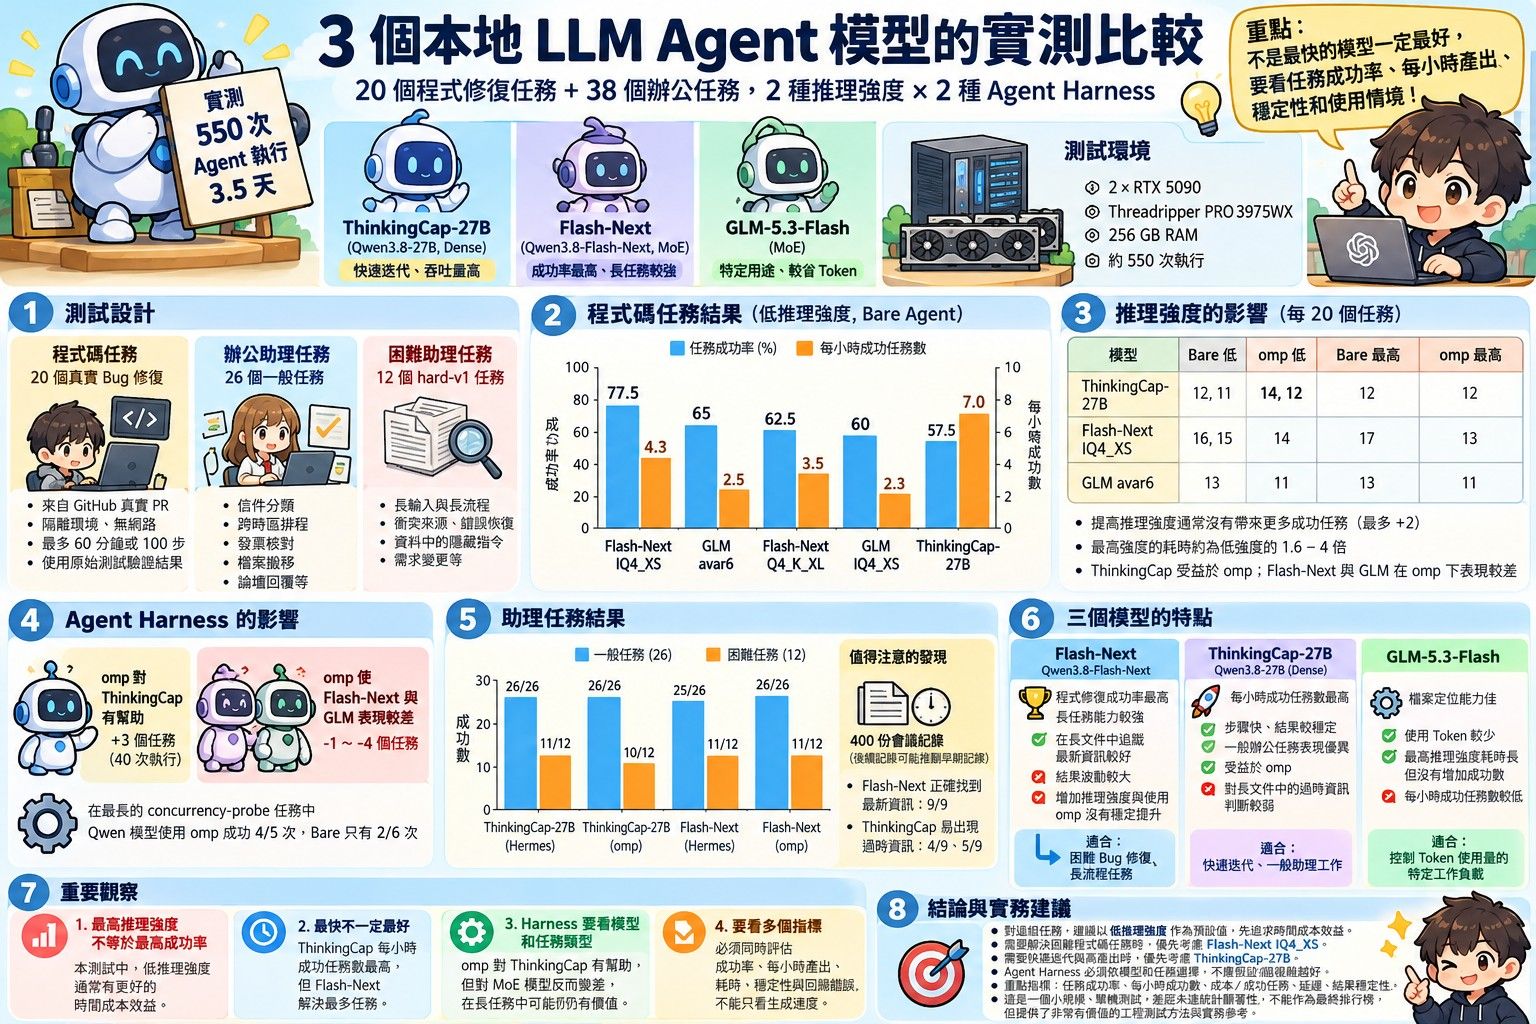
    GPT Image 圖像快速解說版

    image.jpeg

    原文作者 : paulp83

    配置:2塊RTX 5090顯示卡,TR PRO 3975WX散熱器,256GB記憶體。大約550個代理程式運行了三天半

    3 位local LLMs 作為代理完成了以下工作:20 個 club-3090 修復、38 個桌面任務、2 個安全帶、2 個工作量級別 #1690
    https://github.com/noonghunna/club-3090/discussions/1690

    我詢問俱樂部的測試結果是否與我使用的模型和框架有關,維護者要求我做一個 2×2 的對比測試:低強度模型與高強度模型,裸代理與 OMP。我在這個倉庫中提供了三個模型,並運行了上述 2×2 測試,然後給其中兩個模型佈置了一組非編碼的桌面任務。以下是測試結果,包括每個模型的優勢和劣勢,以及我現在使用的設定。

    受測目標模型
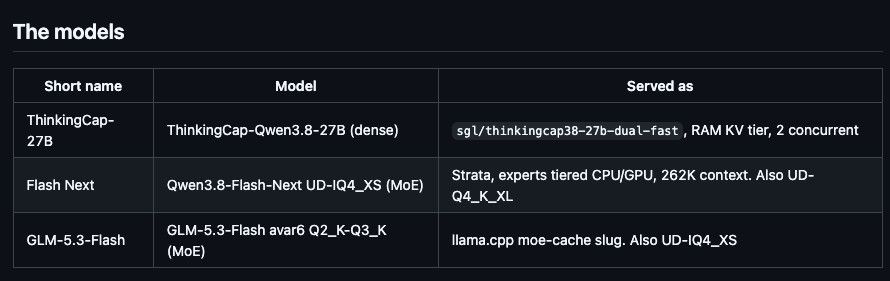
    image.jpeg

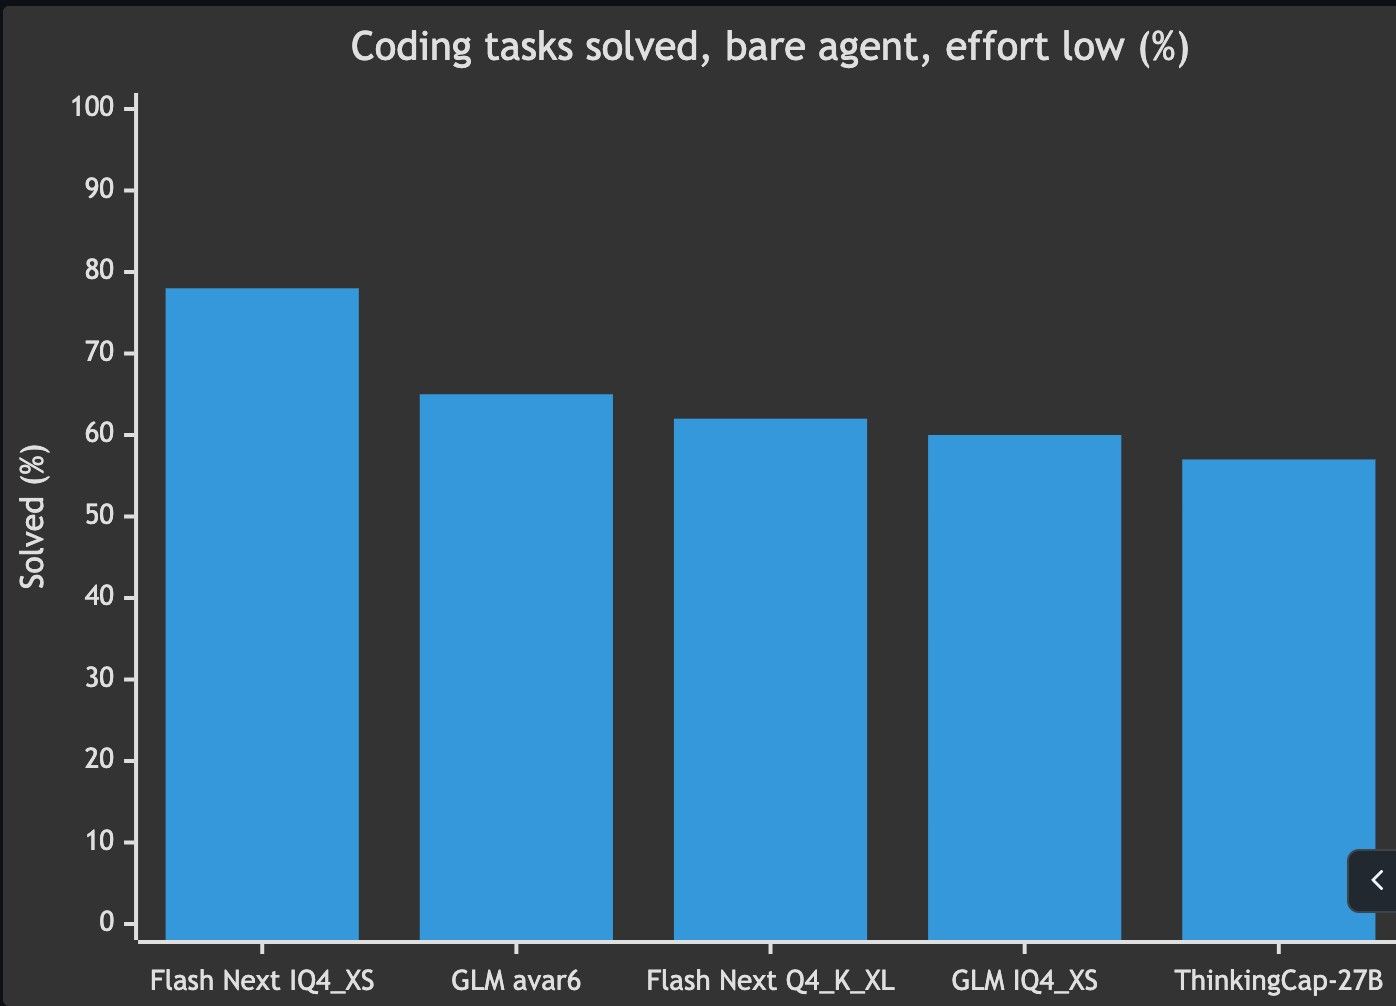
    受測結果 成功解題比率

    image.jpeg

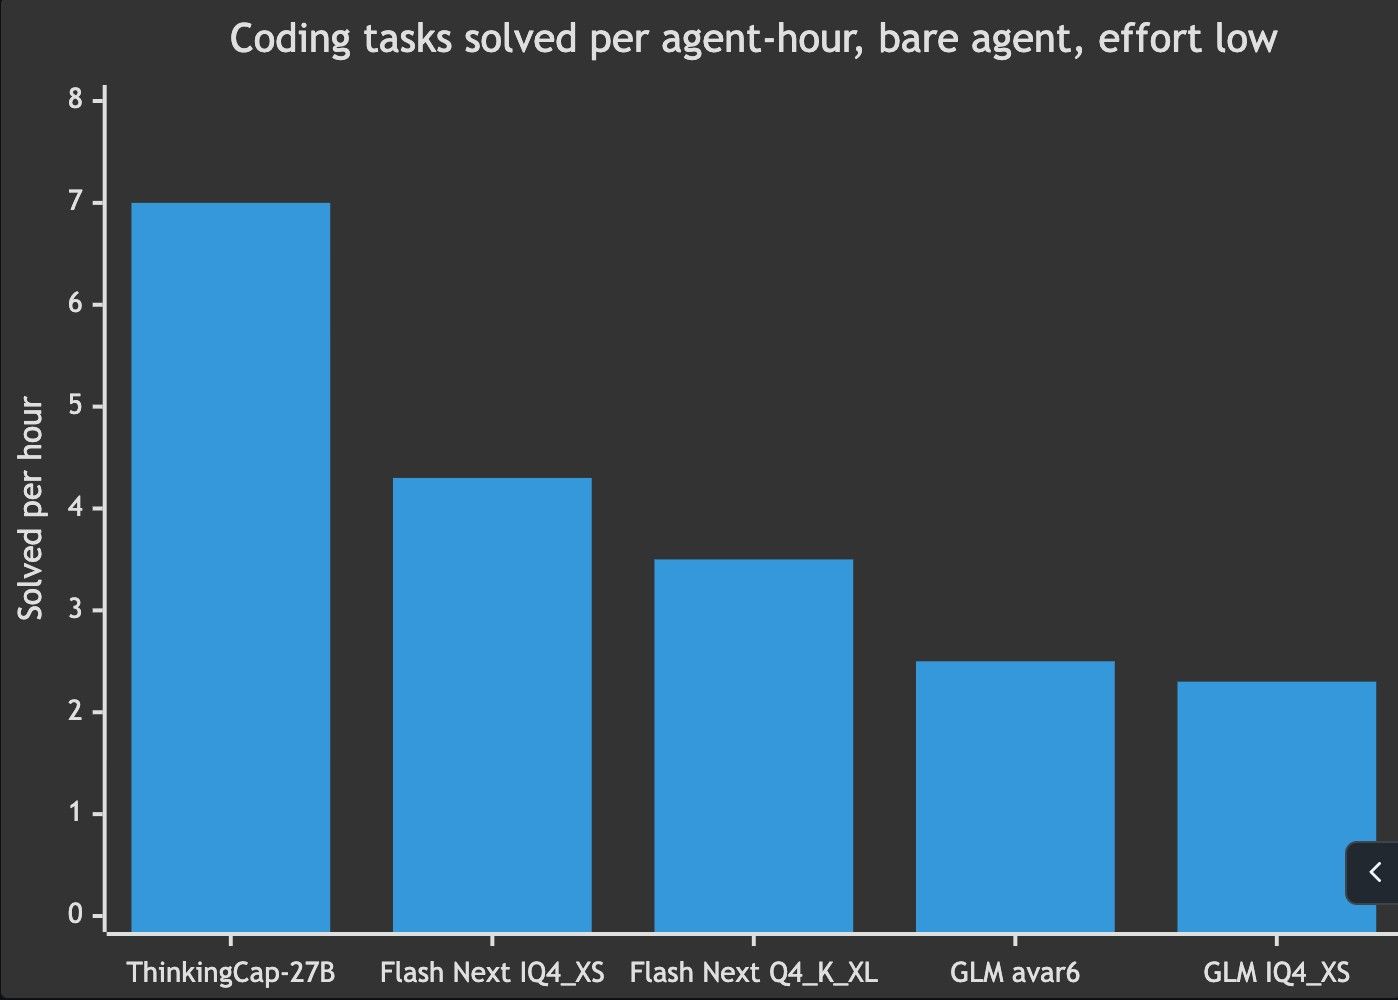
    每小時的解題效率

    image.jpeg

    Config Solved 95% CI Partial credit Right files Median min/task Solved per agent-hour
    Flash Next IQ4_XS 31/40 62–88% 0.85 0.93 9.7 4.3
    GLM avar6 13/20 43–82% 0.72 0.96 12.6 2.5
    Flash Next Q4_K_XL 25/40 47–76% 0.71 0.88 7.6 3.5
    GLM IQ4_XS 12/20 39–78% 0.70 0.93 12.0 2.3
    ThinkingCap-27B 23/40 42–71% 0.68 0.87 4.4 7.0
    1 条回复 最后回复
    3
    • johnnybegoodJ
      johnnybegoodJ
      johnnybegood
      王侯将相
      编写于 最后由 johnnybegood 编辑
      #2

      这些模型我也都跑过哎, 虽然没有测这么全, 但是这个结果跟我的感觉是一样的。最扯的是 GLM5.3 Flash IQ2 还会在数学题上算错,而GLM IQ4我跑起来只有 15tok/s

      kos orK 1 条回复 最后回复
      2
      • johnnybegoodJ johnnybegood

        这些模型我也都跑过哎, 虽然没有测这么全, 但是这个结果跟我的感觉是一样的。最扯的是 GLM5.3 Flash IQ2 还会在数学题上算错,而GLM IQ4我跑起来只有 15tok/s

        kos orK
        kos orK
        kos or
        至尊皇帝
        编写于 最后由 编辑
        #3

        @johnnybegood

        看來還是QFN 比較香甜

        不過有四台DGX Spark跑高精度的GLM 說不定效果不同

        1 条回复 最后回复
        1
        • stxpnetS
          stxpnetS
          stxpnet
          王侯将相
          编写于 最后由 编辑
          #4

          物理定律在那里锁死的,只能等STRATA作者深入发掘一下大内存和大带宽下面的潜力了。

          双卡3090 PCIE 4.0 16X/16X

          白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
          夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
          1 条回复 最后回复
          1
          • terryT
            terryT
            terry
            易有太极
            编写于 最后由 编辑
            #5

            可以,以后完全不用自己写稿子,打开电脑,照着念一个帖子。

            油管:https://www.youtube.com/@抡锤者

            1 条回复 最后回复
            1

            你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

            厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

            有了你的建议,这篇帖子会更精彩哦 💗

            注册 登录
            回复
            • 在新帖中回复
            登录后回复
            • 从旧到新
            • 从新到旧
            • 最多赞同


            • 登录

            • 登录或注册以进行搜索。
            • 第一个帖子
              最后一个帖子
            0
            • 版块
            • 最新
            • 标签
            • 热门
            • 用户
            • 群组