
【硬核实测】双 4080S 跑 125B Flash-Next 吊打 27B:单路 153 tok/s,是 27B 的 2.2 倍,Strata 三套量化 vs SGLang 全对比
-
【实测】双 4080S 32G:Qwen3.8-27B FP8(SGLang TP=2)对比 Flash-Next IQ3_XXS / UD-IQ4_XS / OrcaRouter IQ4_XS(Strata),四组性能 + 七项质量两轮
之前在论坛看了不少双 3090、R9700、5070 的 Strata 帖子,受益很多。这两天把自己这台双 4080S 的四组配置用同一套测法跑完了,数据整理出来回馈一下。
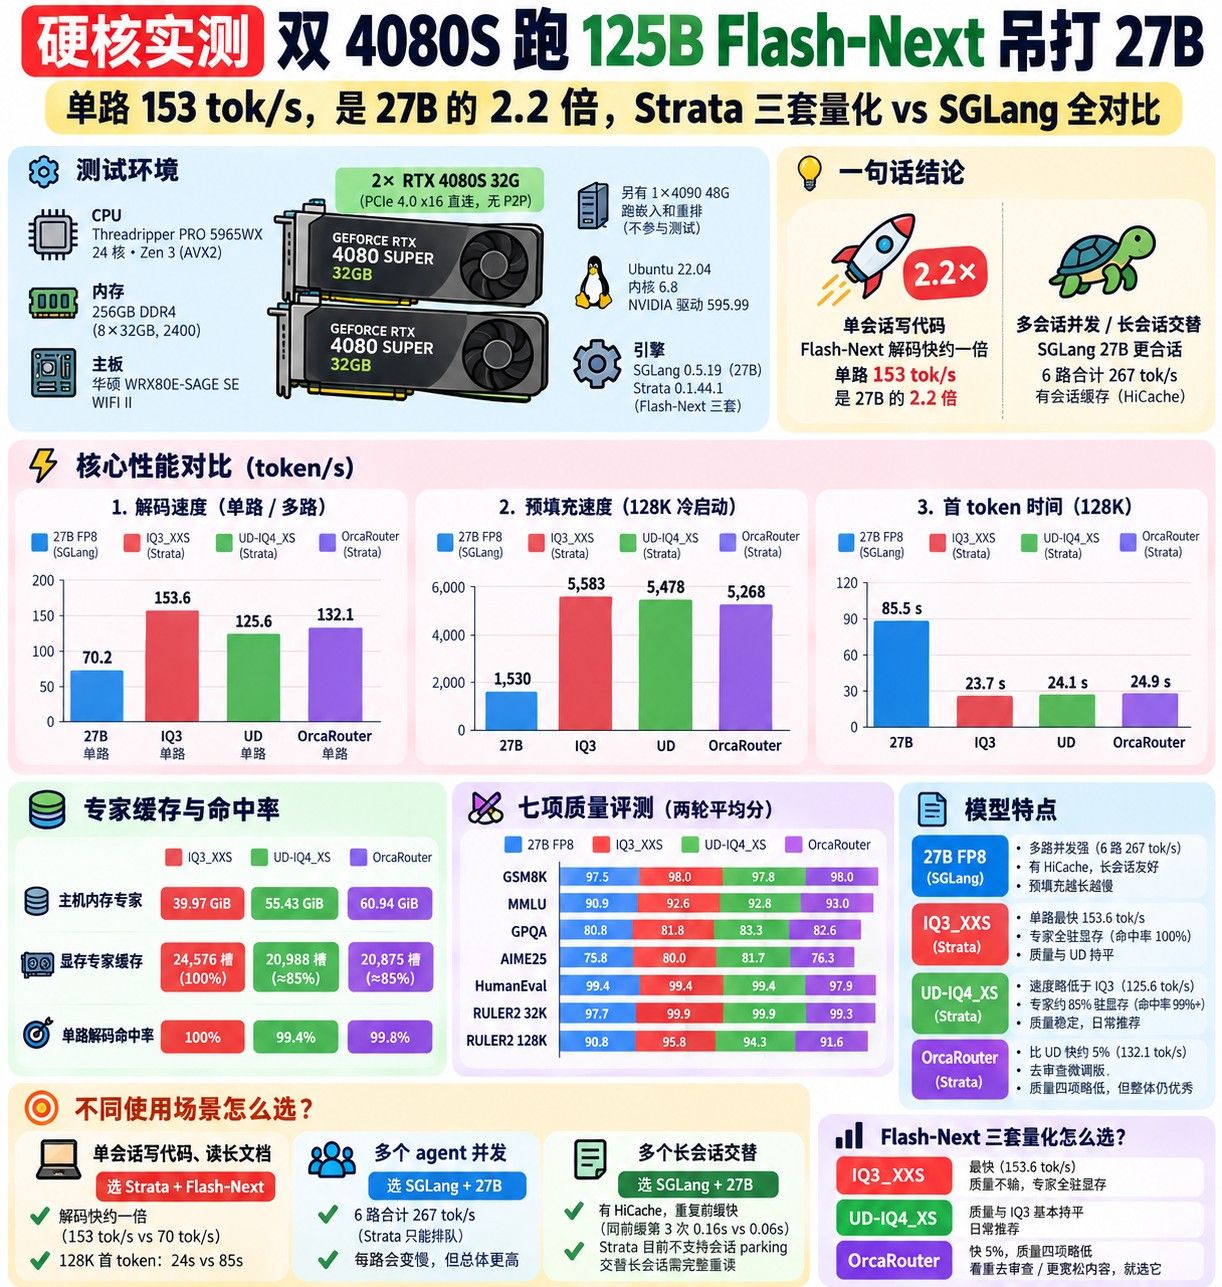
一句话结论:单会话写代码,Strata 跑 Flash-Next 解码快约一倍、长提示预填充快约 3.6 倍;多会话并发和多个长会话交替,SGLang 跑 27B 仍然更合适。三套 Flash-Next 量化的七项质量差别不大。
一、测试环境
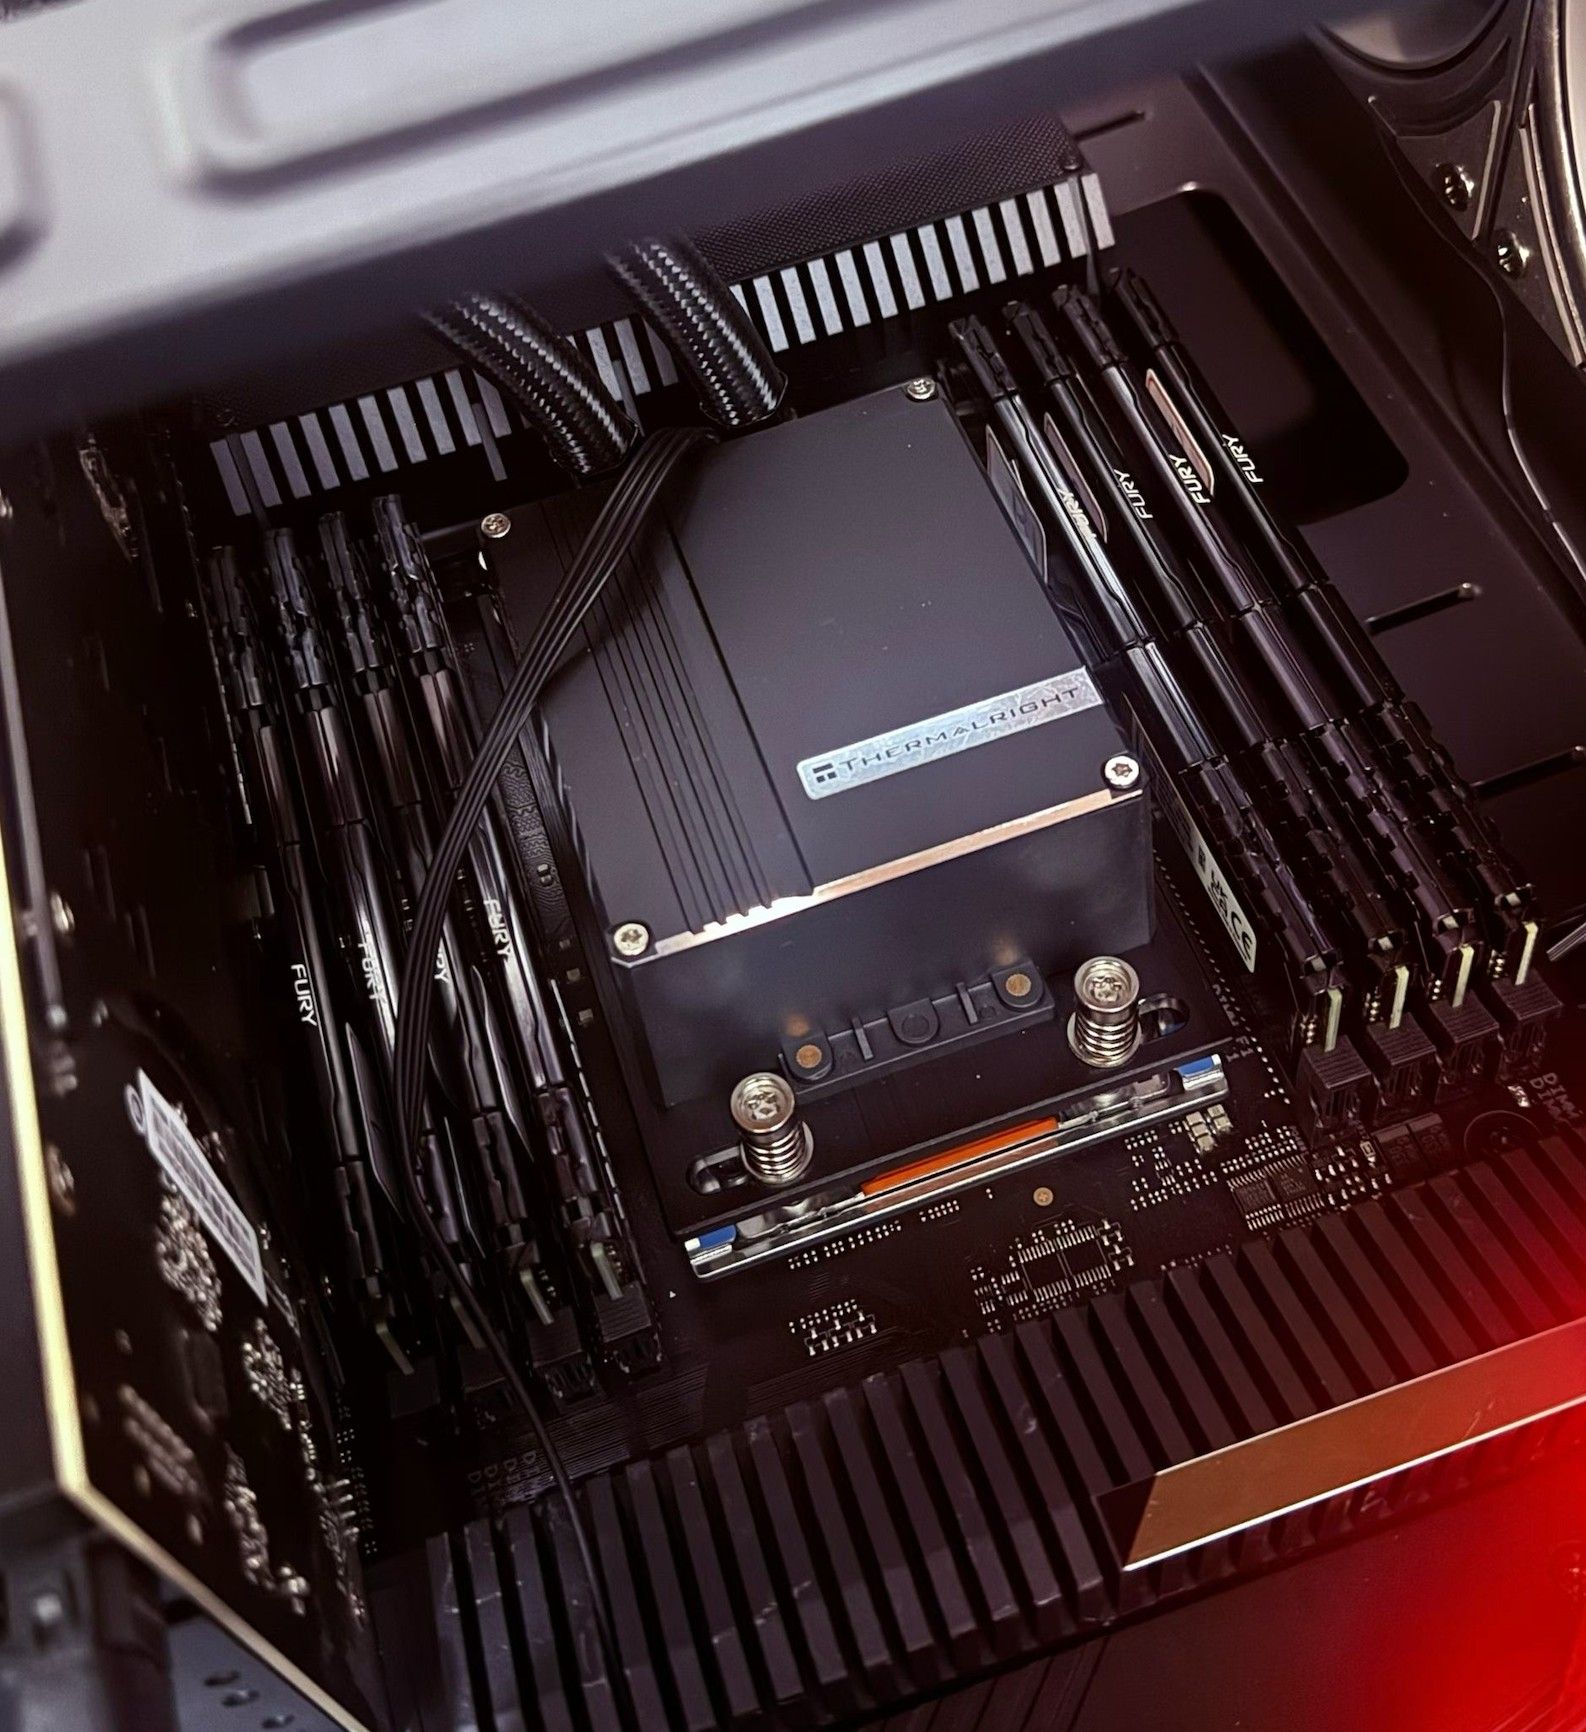
项 配置 CPU Threadripper PRO 5965WX,24 核,Zen 3,只支持 AVX2 主板 华硕 Pro WS WRX80E-SAGE SE WIFI II 内存 256GB DDR4(8×32GB 占满八通道),跑 2400,没开 DOCP 显卡 2× RTX 4080 SUPER 32G 魔改涡轮卡,两张都是 PCIe 4.0 x16 直连 CPU,无 P2P 其他 机器里另有一张 4090 48G 跑嵌入和重排,不参与本帖测试 系统 Ubuntu 22.04,内核 6.8,NVIDIA 驱动 595.99 引擎 27B 用 SGLang 0.5.19;Flash-Next 三套都用 Strata 0.1.44.1(IQ3 另有一份 0.1.38 的旧数据) 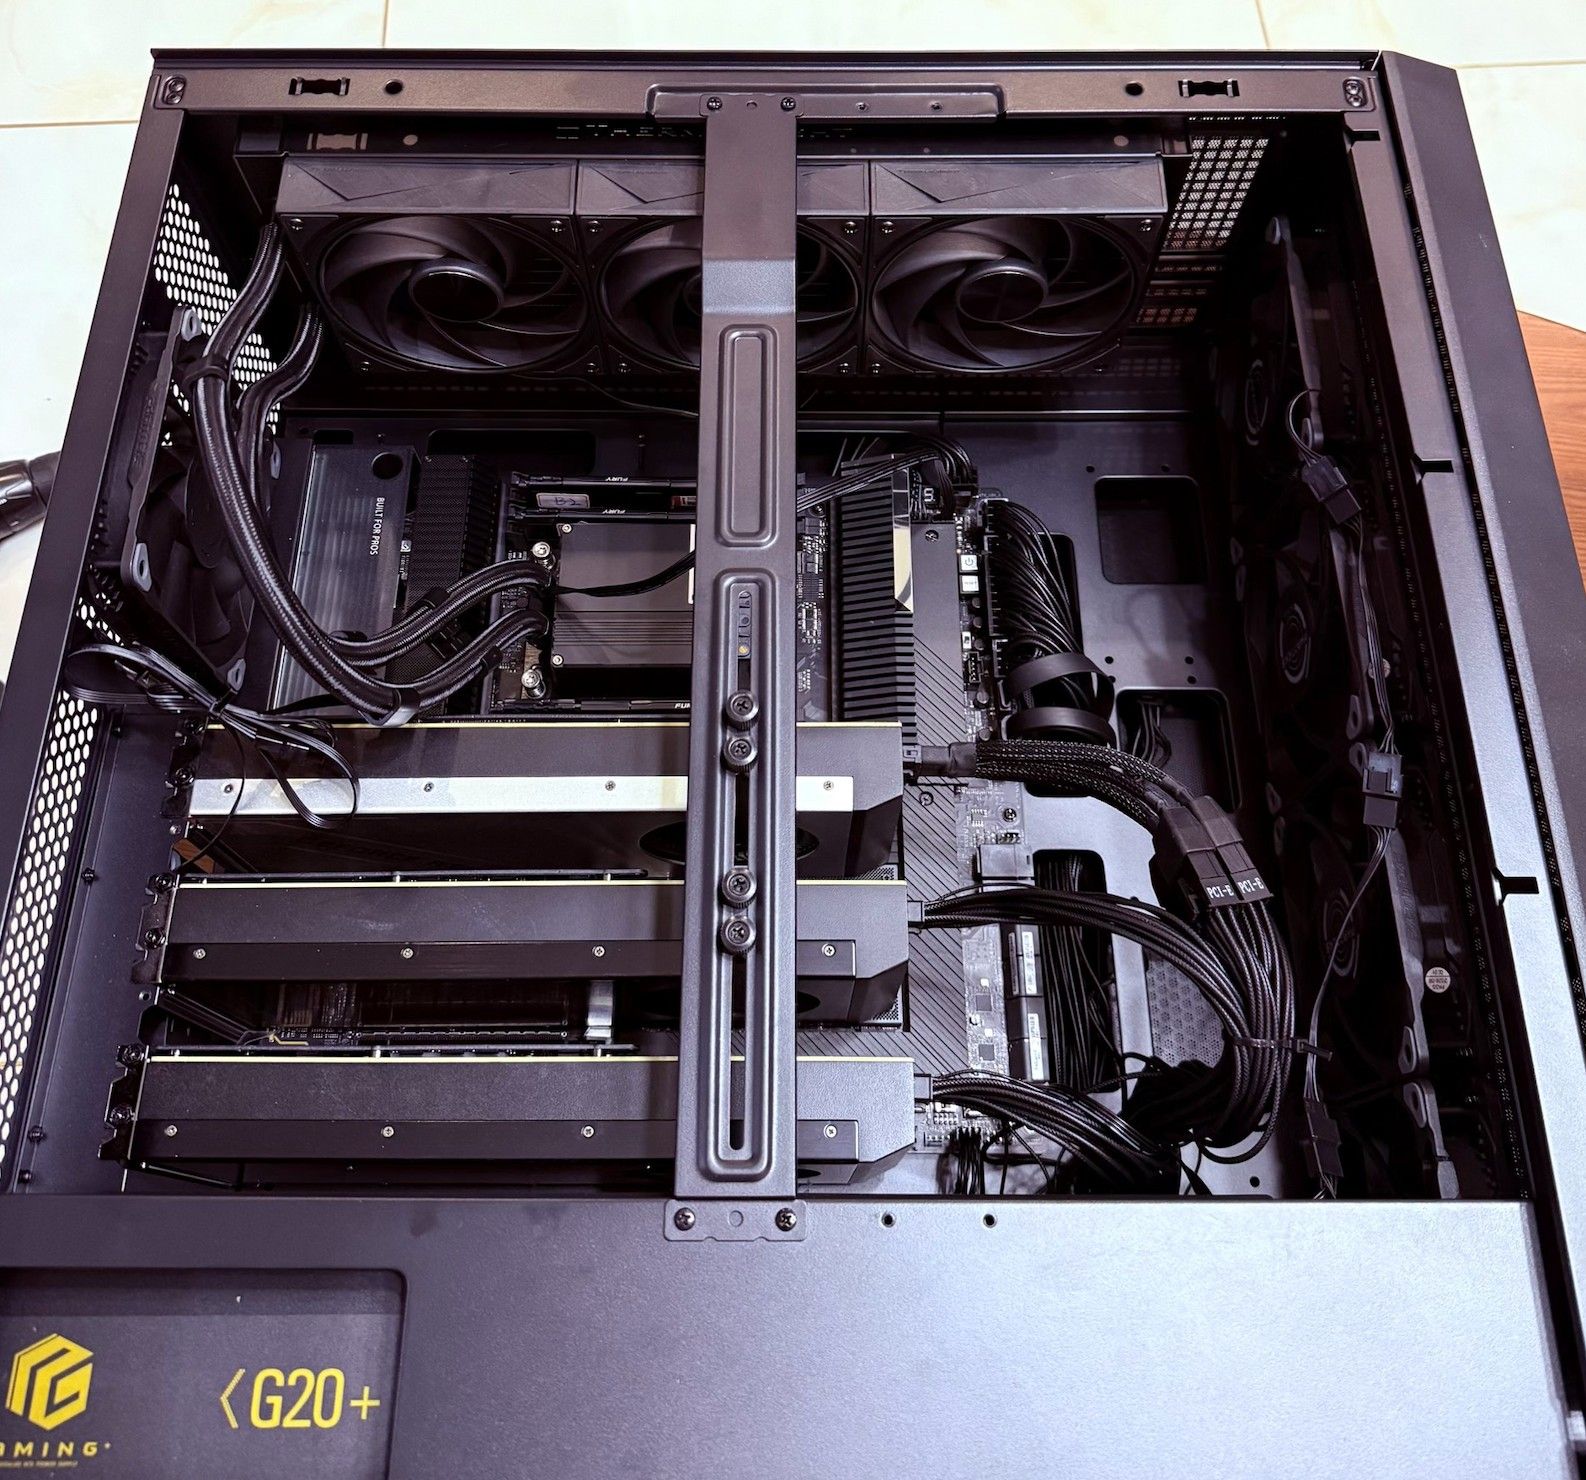
二、模型、引擎与启动参数
1. 模型文件
配置 Hugging Face 仓库 revision 文件 大小 27B FP8 Qwen/Qwen3.8-27B-FP8017b9c7af6b5689d5dd426a76e0bc077eb5ca20a官方 safetensors 约 30.9 GB IQ3_XXS ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUFed59f92082b1e93c0e96d60a8b11aab089b52f09IQ3_XXS/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00001-of-00002.gguf(47.0 GB)、-00002-of-00002.gguf(28.8 GB,PLE 表在这一片)约 75.8 GB UD-IQ4_XS unsloth/Qwen3.8-Flash-Next-GGUF38bb39ee97821de2c9009abb7e93950eec396e66UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00001~00003-of-00003.gguf约 93.7 GB OrcaRouter IQ4_XS orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF(gated,要先申请)d27c0a15447dd92ae7c90919352c6810496945b1Qwen3.8-Flash-Next-Uncensored-IQ4_XS-00001~00003-of-00003.gguf(PLE 表在第 1 片)约 97.5 GB MTP 草稿头 Qwen/Qwen3.8-Flash-Next(官方 BF16)de4b8e4d43b917e7706784d8bb445c9af86a3540只取 MTP 层的张量,由 Strata 打包 — UD 和 OrcaRouter 用的都是上面这份官方原版 MTP 草稿头。OrcaRouter 仓库里自带的
MTP-draft.gguf是 llama.cpp 格式,Strata 用不了,按上游docs/ORCA.md改用原版。2. 引擎
引擎 版本与来源 SGLang lmsysorg/sglang@sha256:59e11312666e1c5c155210ea335589b91daa0d70848521b390b93b1b1e8fb0ef(0.5.19)Strata 0.1.44.1,源码 commit 296b59d(github.com/Niko1221/Strata),本地自建 Docker 镜像打包方式:
- IQ3_XXS、UD-IQ4_XS:用 Strata 自带的 setup 准备(UD 是 setup 原生支持的
unsloth系列)。 - OrcaRouter:0.1.44.1 的 setup 不支持它,按上游
docs/ORCA.md在镜像里手工打包:iq_pack.py --gguf <第 1 片> --out <pack 目录> --compat-bf16。--compat-bf16必须开,会把 363 个小投影从 IQ4_XS/IQ4_NL 舍入成 BF16,96 个路由器从 F32 精确转成 BF16。打包约 20 秒。
3. Strata 启动参数
三套 Flash-Next 共用的部分(两卡,层切 21):
--expert-profile /opt/strata/data/expert-profile.bin \
--expert-cache auto --prefill auto \
--spec 4 --spec-min-p 0.5 --mtp <MTP 打包目录> \
--max-context 262144 --kv int8 --kv-resident 32768 \
--pcie-frac 0 --pipeline-windows 2
# 配置文件里 "layer_split": "21",环境变量 STRATA_RESIDENT_PIN=1
三套之间的差别:
配置 --pack/--native--ple-gguf额外环境变量 IQ3_XXS setup 生成的 pack; --native指第 1 片第 2 片 — UD-IQ4_XS setup 生成的 pack; --native指第 1 片不写(setup 自己处理) STRATA_HC_Q8=1、STRATA_ROUTE_TAIL_SKIP=0(setup 写入)OrcaRouter 手工打包的 pack; --native指第 1 片第 1 片(与 --native相同)STRATA_ROUTE_TAIL_SKIP=0;去掉 UD 专用的STRATA_HC_Q8OrcaRouter 的配置是拿 UD 的配置改的,只改了 pack、
--native、--ple-gguf、分词目录和模型名,其余完全相同,所以两套的速度和质量对比只差在权重本身。4. SGLang 启动参数(27B)
在 lcz.me/topic/1587 那份命令的基础上改的:
python3 -m sglang.launch_server \
  --model-path /models/Qwen3.8-27B-FP8 \
  --tp 2 \
  --kv-cache-dtype fp8_e4m3 \
  --context-length 262144 \
  --mem-fraction-static 0.88 \
  --max-running-requests 8 --cuda-graph-max-bs 8 \
  --chunked-prefill-size 4096 --page-size 64 \
  --max-mamba-cache-size 32 \
  --enable-hierarchical-cache --hicache-ratio 2 \
  --hicache-io-backend direct --hicache-write-policy write_through \
  --speculative-algorithm NEXTN \
  --reasoning-parser qwen3 --tool-call-parser qwen3_coder \
  --enable-metrics
和原命令的差别:
- 去掉
--default-chat-template-kwargs:它会覆盖客户端传的reasoning_effort。另外挂了一个兼容模板,把max/high归一到xhigh。 - 打了一个本地补丁:两条 128K 请求同时跑时,SGLang 的 mamba 状态槽会被锁满,然后断言退出(sglang issue #43204)。补丁的做法是拿不到槽时跳过这次前缀缓存的检查点捐赠。
--max-mamba-cache-size 32下,每个请求占 5 槽,所以实际最多 6 路同时运行,不是 8 路。要跑 8 路得提到 40,我没改。
5. 四组配置一览
项 27B FP8 Flash-Next IQ3_XXS Flash-Next UD-IQ4_XS Flash-Next OrcaRouter IQ4_XS 权重来源 Qwen 官方 FP8 ISTA-DASLab GSQ-RCO Unsloth UD(官方原版权重) orcarouter 去审查微调版 引擎 SGLang 0.5.19 Strata 0.1.44.1 同左 同左( --compat-bf16手工打包)多卡方式 TP=2 层切,切点 21,开 --pipeline-windows 2同左 同左 投机解码 MTP(NEXTN) MTP, --spec 4同左 同左 KV FP8,显存池 373,184 token + HiCache 内存层 746,432 token int8,前 32,768 个位置驻留显存,其余放锁页内存 同左 同左 其他 最多 6 路同时运行(受状态槽限制) --pcie-frac 0,一次只处理一个请求同左 同左 几点说明:
- 四组都用同一套自写测试脚本:自写提示词解码(输出约 2,000 token)、random-decode(64 个请求)、同长度冷预填充、同前缀重复请求。性能数据都是单次完整测试。
- UD 和 OrcaRouter 的 IQ4_XS 不是同一种东西:UD 是动态量化,专家 gate/up 压到 3 bit 级(IQ3_S),稠密层给 Q8_0;OrcaRouter 是均匀 4 bit 级(专家 IQ4_XS/IQ4_NL,稠密层 4~5 bit)。
三、性能
1. 解码
指标(token/s) 27B FP8 IQ3_XXS UD-IQ4_XS OrcaRouter 单路解码 70.2 153.6 125.6 132.1 2 路合计 122.2 154.6 127.5 133.9 4 路合计 196.0 154.4 126.2 135.4 6 路合计 267.0 未测 未测 未测 random-decode 单路 78.6 177.4 147.8 160.0 - Strata 默认一次只处理一个请求,所以 2、4 路合计和单路一样;SGLang 的多路合计随路数上升,但每路会变慢(1 路 70.3 → 6 路每路 44.7)。
- IQ3_XXS 在旧版 0.1.38 上是 119.5,升 0.1.44.1 并打开 pw2 后到 153.6(中间还换过内存,不能全算给版本)。
- pw2(层切流水)实测比不开快 2%~5%,交叉解码快 6%~7%。
2. 预填充与首 token
指标 27B FP8 IQ3_XXS UD-IQ4_XS OrcaRouter 32K 冷预填充 token/s 1,953 4,758 4,642 4,507 128K 冷预填充 token/s 1,530 5,583 5,478 5,268 32K 首 token 16.6 s 7.0 s 7.1 s 7.2~7.3 s 128K 首 token 85.5 s 23.7 s 24.1 s 24.9 s 150K 首 token 102.2 s 27.2 s 27.8 s 28.7 s 32K 同前缀第 3 次首 token 0.16 s 0.06 s 0.06 s 0.06 s 两边的趋势相反:27B 的预填充越长越慢(8K 约 2,000 → 150K 约 1,470 token/s),Strata 越长越快,到 128K 后持平。
3. 专家放在哪里、命中率多少
项 IQ3_XXS UD-IQ4_XS OrcaRouter 主机内存里的全部专家 39.97 GiB 55.43 GiB 60.94 GiB 显存专家缓存 24,576 槽,全部驻留 20,988 槽,约 85% 20,875 槽,约 85% 单路解码专家命中率 100% 99.4% 99.8% random-decode 64 个请求命中率 100% 92.9%~99.0%,均值 97.5% 96.5%~99.4%,均值 98.7% 128K 冷预填充命中率 100% 99.7% 99.4% 草稿接受率(单路) 0.571 0.550 0.553 容器内存峰值 47.7 GiB 65.8 GiB 72.4 GiB 加载后显存剩余 8,229 MiB 709 MiB 519 MiB 两张 32G 卡能把约 85% 的专家放进显存,命中率就到 99% 以上。这和 Strata 论文里 RTX 5070 12G 的情况很不一样:那台机器命中率约 0.71,一个验证窗口有一半多时间在等 CPU 算缺的专家;我这台 CPU 那一半基本没有了。
两个 IQ4 启动时 GPU1 显存都报
LOW,引擎建议加约 1.1 GiB 的--vram-reserve-later-mib。我没加,跑了四轮各 3.5 小时的质量测试也没有遇到停顿。四、质量:七项标准题集,各跑两轮
采样都是 temperature 0、
reasoning_effortmedium、max_tokens 16384。表里是两轮的分数,括号内是截断数。RULER2 长是 128K。题集 27B FP8 IQ3_XXS(0.1.38) UD-IQ4_XS OrcaRouter GSM8K 97.50 / 97.50 98.00 / 98.00 97.50 / 98.00 98.50 / 97.50 MMLU 90.88 / 90.88 92.63 / 92.63 92.63 / 92.98 92.98 / 92.98 GPQA 83.33 / 78.28 81.82 / 81.82 84.34 / 82.32 83.84 / 81.31 AIME25 75.00 / 76.67 80.00 / 80.00 80.83 / 82.50 75.00 / 77.50 HumanEval 99.39 / 99.39 99.39 / 99.39 99.39 / 99.39 98.17 / 97.56 RULER2 32K 98.57 / 96.90 99.93 / 99.93 99.93 / 99.93 99.10 / 99.52 RULER2 长(128K) 90.76(只有一轮有效) 95.76 / 95.76 96.17 / 92.42 91.61 / 91.59 怎么读:
- 同一配置两轮也会不一样:27B 的 GPQA 两轮差 5 分,UD 的 RULER2 长差 3.75 分。所以单轮的 1~3 分差距不能当结论。IQ3 两轮完全相同,我猜是因为它的专家全部驻留显存,没有 CPU/GPU 分工带来的时序差异(Strata 文档提到过这一点),没逐题核对。
- UD 与 IQ3 基本持平:七项差距都在 UD 自己两轮的波动内。
- OrcaRouter 有四项略低于 UD:AIME25(两轮均值低 5.4 分)、HumanEval(低 1.5 分,164 题里少对 2~3 题)、RULER2 32K(低 0.6 分)、RULER2 长(低 2.7 分),而且两轮都低于 UD 的两轮。其余三项持平。和 27B 比,OrcaRouter 七项里有六项不低于它。这四项的差距不能直接算给量化位宽:它是去审查微调后的权重,来源和 UD 不同。
- Flash-Next 的 MMLU 稳定比 27B 高约 2 分,27B 两轮都是 90.88。
- 27B 的 RULER2 长只有一轮有效:补丁前两轮在并发长请求下 SGLang 崩了(mamba 状态槽的问题,sglang issue #43204),打了本地补丁后才跑出 90.76。
这七项都不测拒答行为,OrcaRouter 去审查的效果本帖没有测。
五、瓶颈在哪里:几个和直觉不同的发现
- 单路解码的瓶颈在 GPU 侧,不在 CPU 和内存。 按 IQ3 粗算,每个验证窗口读权重(稠密层 + 超连接等 BF16 张量 + 专家)约占窗口时间的 42%~51%,其余是 MTP 草稿、注意力、两卡交接和内核开销。命中率 99% 以上时,CPU 只算零星几个专家。所以我这台换 5995WX 或开 DOCP 3200,对单路解码帮助应该不大(推断,DOCP 还没实测)。
- 预填充也不受 PCIe 限制。 本来以为预填充要经 PCIe 拷很多专家,但实测 IQ4 预填充命中率 99.4%~99.7%,全驻留的 IQ3 也只比 OrcaRouter 快 6%。Strata 论文在 5070 上也写了预填充只用到 PCIe 26 GB/s 中的约 7 GB/s。
--pcie-frac在大显存机器上别开。 UD 去掉--pcie-frac 0后,引擎按实测带宽选了 0.55,单路反而慢 1.3%、random-decode 慢 2.8%~4.0%。论文在 5070 上开它是正收益,那是因为 5070 缺的专家多。- 27B 的 TP 预填充被同步拖慢。 没有 P2P,每层两次 all-reduce 都绕主机内存。4080S 的 BAR1 只有 16 GiB,覆盖不了 32 GB 显存,P2P 补丁的前提不成立。
- 长上下文解码掉得不多。 IQ3 在 0.1.38 上实测:短提示 119.5、64K 108.5、128K 104.4 token/s。KV 全驻留显存和只驻留 32K 速度一样,全驻留反而少了 806 个专家槽,所以保持默认 32768。
六、选型结论与短板
用法 选哪个 原因 单会话写代码、读长文档 Strata + Flash-Next 解码快约一倍,128K 首 token 24 秒对 85 秒 多个 agent 并发 SGLang + 27B 6 路合计 267 token/s;Strata 一次一个请求 多个长会话交替 SGLang + 27B 0.1.38 层切下不支持会话 parking,两个 250K 会话交替时每次追问都要完整重读,首 token 约 51 秒;27B 靠 HiCache 约 1 秒 Flash-Next 选哪个量化 速度看 IQ3,日常我用 UD IQ3 最快、质量不输;UD 质量与 IQ3 持平;OrcaRouter 快 5%、质量四项略低,看重去审查就选它 短板:
- Strata 默认不开批处理,多路只能排队;
parallel批处理在层切 + MTP 下能不能开、效果多少,我还没测。 - 0.1.44.1 下的长上下文解码和多会话限制,我还没重测。
- 魔改 4080S 没有官方保修;BAR1 只有 16 GiB,P2P 没开。
后面打算测 coding agent 的工具调用和 RAG 记忆抽取,到时再来更新。数据都来自本机实测,有不同硬件的账本欢迎一起对照。
- IQ3_XXS、UD-IQ4_XS:用 Strata 自带的 setup 准备(UD 是 setup 原生支持的
-
-
-
-
羡慕32gb 4080
这个机箱对我胃口, 是什么牌子机箱?
还有一张卡是什么用处? -
-
,
 T terry 固定了此主题
-
-
-
-
-
-
看了个帖子,魔改卡,开p2p,大概原理是 原有bar保持不变,滑窗机制,可以参考下。
另外请教一个问题,大佬您电源是 2kw ? 我看是 12pin接口,4个8pin 转 1个 12pin,三张就需要12个8pin,这电源要求高。看了个帖子,魔改卡,开p2p,大概原理是 原有bar保持不变,滑窗机制,可以参考下。
另外请教一个问题,大佬您电源是 2kw ? 我看是 12pin接口,4个8pin 转 1个 12pin,三张就需要12个8pin,这电源要求高。
- P2P目前没开,需要转社区的驱动,采用strata需要从内存搬运专家,就算采用PCIE4 x 16、8通道DDR4 2400内存的基础上,瓶颈也在PICE,在没上PICE5的情况下,感觉现在已经是天花板了,后期可以考虑P2P折腾下
2.是的,电源:2000w,三张卡:两个原生12pin接口, 一个4个8pin 转 1个 12pin
- P2P目前没开,需要转社区的驱动,采用strata需要从内存搬运专家,就算采用PCIE4 x 16、8通道DDR4 2400内存的基础上,瓶颈也在PICE,在没上PICE5的情况下,感觉现在已经是天花板了,后期可以考虑P2P折腾下
-
看了个帖子,魔改卡,开p2p,大概原理是 原有bar保持不变,滑窗机制,可以参考下。
另外请教一个问题,大佬您电源是 2kw ? 我看是 12pin接口,4个8pin 转 1个 12pin,三张就需要12个8pin,这电源要求高。
- P2P目前没开,需要转社区的驱动,采用strata需要从内存搬运专家,就算采用PCIE4 x 16、8通道DDR4 2400内存的基础上,瓶颈也在PICE,在没上PICE5的情况下,感觉现在已经是天花板了,后期可以考虑P2P折腾下
2.是的,电源:2000w,三张卡:两个原生12pin接口, 一个4个8pin 转 1个 12pin
- P2P目前没开,需要转社区的驱动,采用strata需要从内存搬运专家,就算采用PCIE4 x 16、8通道DDR4 2400内存的基础上,瓶颈也在PICE,在没上PICE5的情况下,感觉现在已经是天花板了,后期可以考虑P2P折腾下
-
-
,系统 取消固定了此主题





 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!