
把Strata + Paiton 接入 DSH 实测,看看本地模型到底值不值
-
之前测试过Strata和Paiton的性能——Qwen3.8-Flash-Next UD-Q4_K_XL 引擎对比:llama.cpp 与 Strata,同样的48GB 显存 + 128GB 内存,不同的结果,这篇写落地:把这两台引擎接进 DSH,一台当主模型,一台专门跑子代理。
一、两台引擎
引擎 显卡 显存 上下文 对外 Strata NVIDIA RTX PRO 5000 48G 47,861 / 48,935 MiB 262,144 <推理机>:18090Paiton (vLLM) AMD R9700 32G 31.7 / 31.9 GB 65,536 <推理机>:18982两张卡各顶到 98% 附近,长期共存互不影响。Paiton 在 Docker 里,靠
--device /dev/kfd --device /dev/dri吃 AMD 卡。Paiton 的参数里有一条:
--served-model-name  Qwen3.8
--max-model-len      65536
--max-num-seqs       8
--enable-auto-tool-choice --tool-call-parser qwen3_coder
--no-enable-prefix-caching
最后一条关掉了前缀缓存,日志里
Prefix cache hit rate长期是0.0%,每轮都要重读全部历史。Strata 那边同一时段的复用率是 93%~99.9%。拿 Paiton 当子代理,是因为子代理上下文短、任务独立,不是因为它在长对话里划算。让它做主模型会很难受。
二、DSH
配置在
~/.dsh/profiles/desktop/cordis.patch.yml。凭据单独放,
~/.dsh/.credentials.yaml:refs: STRATA_API_KEY: <key> PAITON_API_KEY: <key>两个 provider:
      strata:
        displayName: Strata
        api: openai-completions
        baseURL: http://<推理机>:18090/v1
        apiKeyEnv: STRATA_API_KEY
        models:
          - id: qwen3.8-flash-next-unsloth-ud-q4_k_xl
            contextWindow: 262144
            maxTokens: 65536
            input: [text, image]
      paiton:
        displayName: paiton-65K
        api: openai-completions
        baseURL: http://<推理机>:18982/v1
        apiKeyEnv: PAITON_API_KEY
        models:
          - id: Qwen3.8
            contextWindow: 65536
            maxTokens: 16384
子代理要另外开白名单:
- id: subagent-model-selection-settings config: enabled: true allowedModels: - provider: paiton model: Qwen3.8 - provider: strata model: qwen3.8-flash-next-unsloth-ud-q4_k_xlallowedModels只是允许哪些路由出现在选择列表里,不等于默认。真正派活是按次指定provider/model,省略就继承主模型。所以"让子代理走 Paiton"这件事,可以在每次派发时写明,也可以在配置中固定,前者更灵活一些。
三、跑一次真实任务
这一节是它在真实任务里的表现,数字来自三个来源:DSH 的会话记录、Strata 引擎日志、Paiton 容器日志,能对的地方都对过。
任务是 kos or 大神出的题: LLM解題 極限測試 Extreme-Exam-v7-A (出題者 : GPT6-Astra-max)。
55 分钟出答案,3 小时 39 分做完
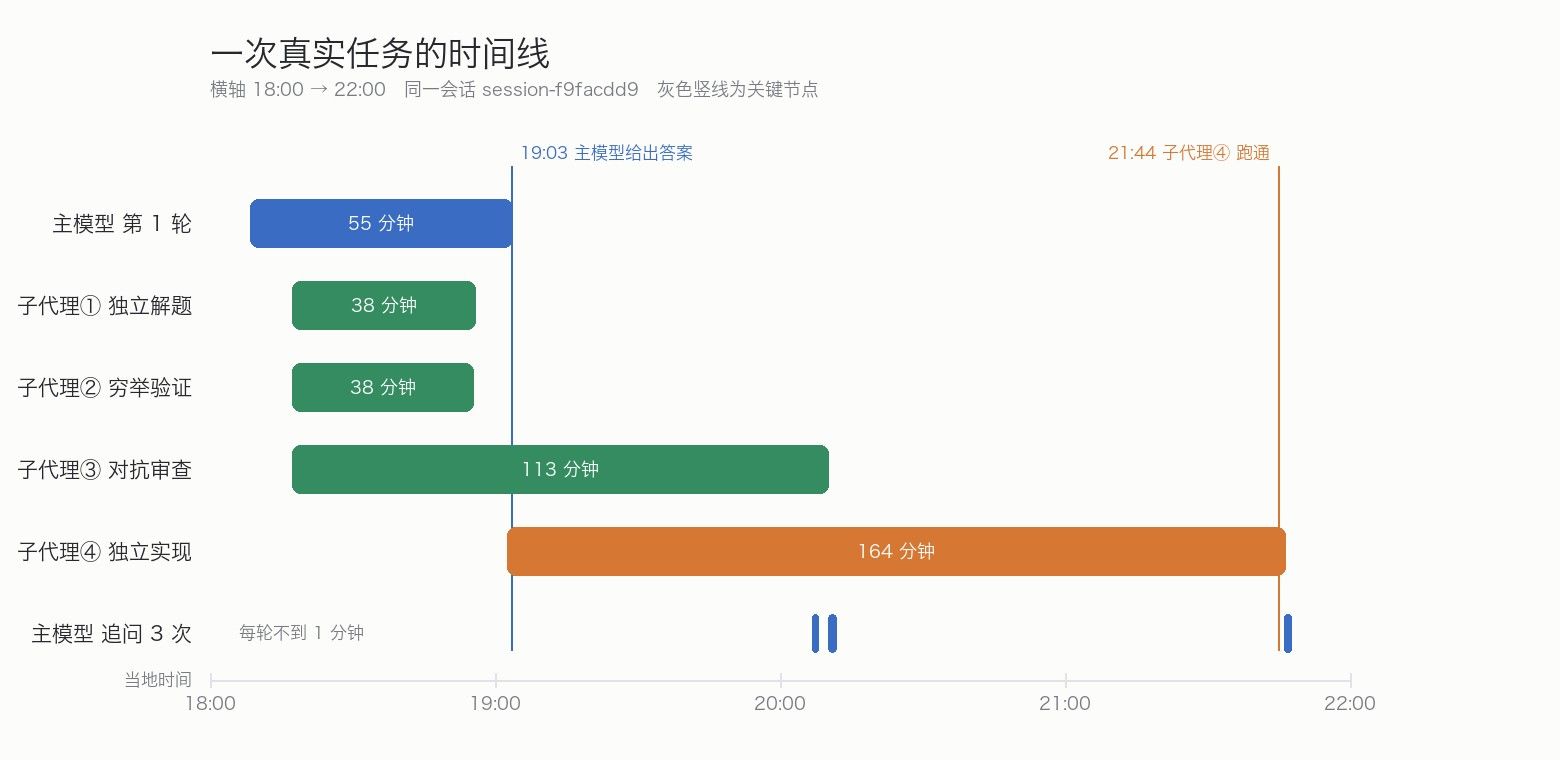
主模型在第 1 轮 55 分钟里给出了答案。但同一轮派出的四个子代理里,有两个在答案出来时还在跑:
子代理 起 止 时长 ① 独立解题 18:17 18:55 38 分钟 ② 穷举验证 18:17 18:55 38 分钟 ③ 对抗审查 18:17 20:10 113 分钟 ④ 独立实现 19:02 21:46 164 分钟 主模型 19:03 交卷,③ 又跑了 67 分钟,④ 又跑了 161 分钟。会话总跨度 3 小时 39 分,其中两小时四十三分是 ④ 一个人在后台干活。
模型自己报告的"端到端约 45 分钟",只算上了它自己那一轮。
三个实现收敛到同一个数
子代理 ④ 是"独立实现",折腾到 21:44 才跑通:
[ok] b(1..6) match known values
[ok] C(4)=6   [ok] C(6)=63   [ok] C(8)=717
[ok] C(30)=3202559936373493
[info] large-N computation took 60.01s
FINAL_R = 385583993536
和主模型算的结果一致。它还多验了一个之前没验过的量:C(30) 的精确值。
两边的账
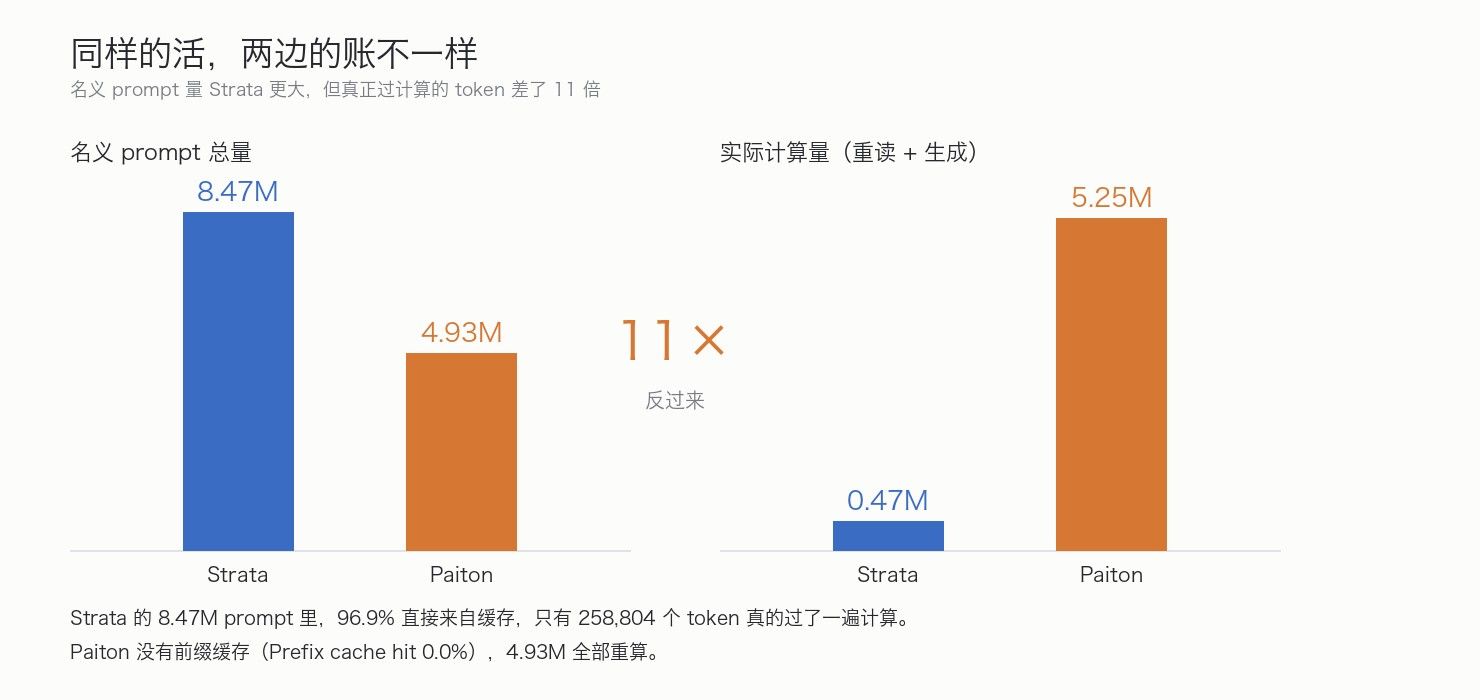
Strata(主模型) Paiton(子代理) 请求数 90 186 名义 prompt 8,466,905 ≈ 4,930,000 真正重读 258,804(3.1%) ≈ 4,930,000(100%) 生成 207,906 ≈ 315,200 实际计算量 466,710 ≈ 5,245,200 Strata 名义上处理的 prompt 更多,但 96.9% 来自缓存;Paiton 没有前缀缓存,四百九十万全部重算。实际计算量差了十一倍,和我一开始的预想正好相反——不是主模型扛大头,是子代理。
并发
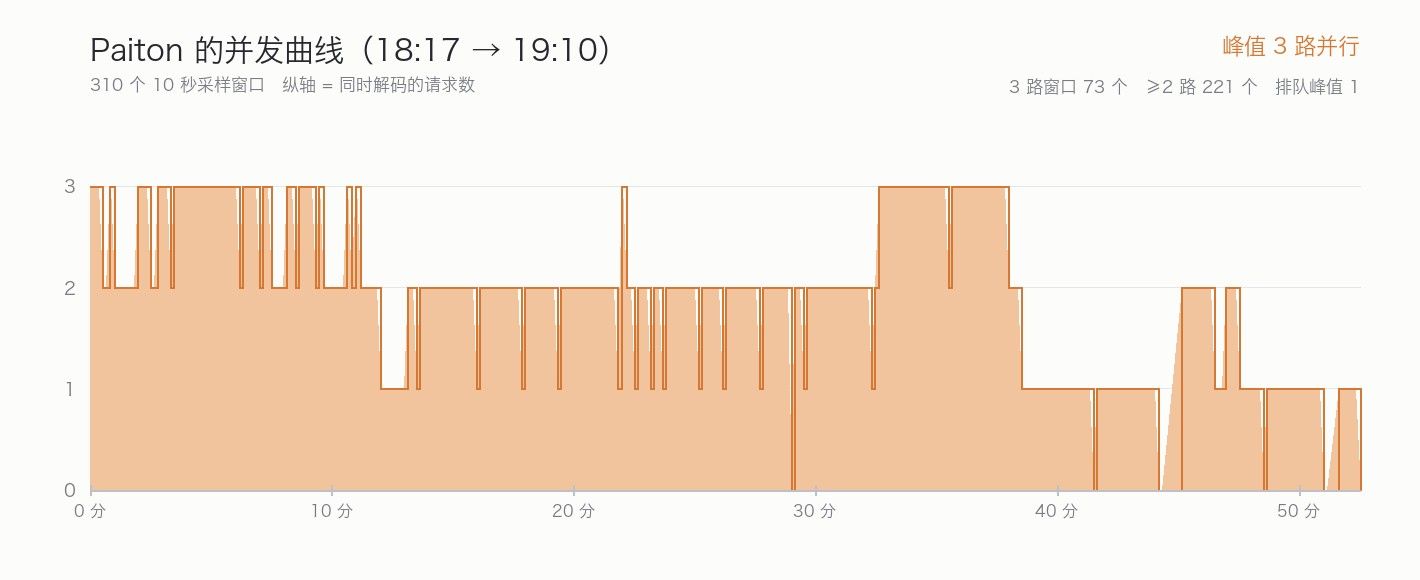
310 个采样窗口里,73 个是 3 路同时解码,221 个是 2 路以上,排队峰值只有 1。三个子代理是同一秒发出去的,日志证明它们真在同时算。
Strata 逐请求的中位解码是 92.3 tok/s(p10 74.8,p90 111.6),预填中位 226 tok/s。Paiton 聚合生成峰值 292.8 tok/s,预填峰值 5,744 tok/s——原始预填比 Strata 快,但它每轮都从零算,这个优势被缓存抵掉了。
一次压缩失败
三次自动压缩里,一次报
summarization produced no text summary content,摘要请求没产出内容。会话继续了,但那一次等于没压缩。
四、跑完之后
端到端是通的,并行也是真的,日志摆在那里,这个不用怀疑。
这次真正值钱的是上下文隔离。子代理在 65K 上限里各烧各的,主模型在最大 151,082 token 的上下文里继续工作,复用率 96.9%。子代理的脏活一点没污染主上下文。这一点比快多少 tok/s 重要得多。
但"交卷"和"做完"不是一回事。主模型 19:03 给出答案时,还有两个子代理在跑。主模型把"我算完了"当成了"任务完成了",没把仍在后台进行的工作交代出来,人看到的现象就是任务一直不结束。
冗余验证的代价也被低估了。子代理 ④ 用两小时四十三分独立重写了一份实现,结论和主模型一模一样。它先写出来的版本跑不完——13,824 个除数各做一次 30×30 矩阵幂,纯 Python 要几十亿次运算。后来子代理 ④ 跑了一遍性能分析(Python 自带的 cProfile,能按函数统计耗时),定位到瓶颈就在这里,重写那一段之后才压到 60 秒。会自我纠错是好事,但为一个已有答案的结果再烧三小时,收益几乎为零。
八个槽位只用了三个。任务拆不出八个互相独立的子任务,配置的余量也就只是余量。
还有一点得说清楚:这次没有对照组。同样这道题,之前只靠 Strata 单模型(加上我手动修它的 bug)也得出了一模一样的答案。所以这次证明的是跑得通、并行真、结果对,没证明多子代理比单模型更好更快更省。要证明这件事,得同一道题跑两遍对照,这次没做。
算一下就很清楚:
机械计算:    1 秒
出答案:     55 分钟
全部做完:  3 小时 39 分
开 parallel、加子代理、换更快的卡,边际收益都很低。卡住效率的是交卷标准、没有预算的冗余验证,以及缺一个对照。这三件都不是硬件问题。
五、现在的状态
项 状态 双卡共存 正常,各占一卡 主模型 + 子代理 Strata 主 + 4 个 paiton 子代理,跑通 子代理并行 Running: 3, Waiting: 0,73 个窗口 3 路答案正确性 三个独立实现收敛到同一个数 出答案 vs 全部做完 55 分钟 vs 3 小时 39 分 Strata 缓存复用 96.9%,最大单次 prompt 151,082
小结
至于这套组合能不能用,那要分跑什么样的任务。
对能自我验证的活——数学推导、算法实现、数据变换这种答案对错机器能判的——它有实打实的生产力。这次 55 分钟拿到一个由三条独立路径互相印证的答案,全程本地,没有 API 费用。以前要么自己写几小时,要么花钱调云模型。
优点集中在三处。上下文隔离:子代理各烧各的 65K,主模型在十五万 token 里继续,互不污染。不抢卡:子代理在 AMD、主模型在 N 卡,这是双卡唯一真正兑现的地方。还有一个我原本没预期的——子代理扛得住反复试错,有一个重写了三小时,最后真跑通了。
短板同样清楚。Paiton 没有前缀缓存,每轮从零读 prompt,长任务不划算;65K 一过就得回落到 Strata,而 Strata 和主模型共用一张卡、还只能串行,优势当场抵消。更麻烦的是子代理会跑偏:那次三小时的重写,主模型中途并不知道该不该喊停,人看到的就是任务一直不结束。
至于省不省钱,得先分清两边是怎么计费的,它们根本不是一回事。
本地是按时间花钱:满载 500W,一小时两毛五电费(0.5 元一度)。这段时间产出多少 token、跑得快还是慢,跟账单无关。
DeepSeek 是按 token 花钱:flash 空闲时段缓存命中输入 0.02 元/百万,未命中 1 元,输出 4 元;高峰时段翻倍。跑多久不影响账单,处理多少 token 才影响。高峰是工作日 9:00-12:00 和 14:00-18:00,其余时段和周末按空闲价。
我 9 月的真实账单:9,424 次请求,2.89B tokens,154.36 元。平均每请求 30 万 tokens,均价 0.053 元/百万——只比缓存命中价 0.02 高一点。
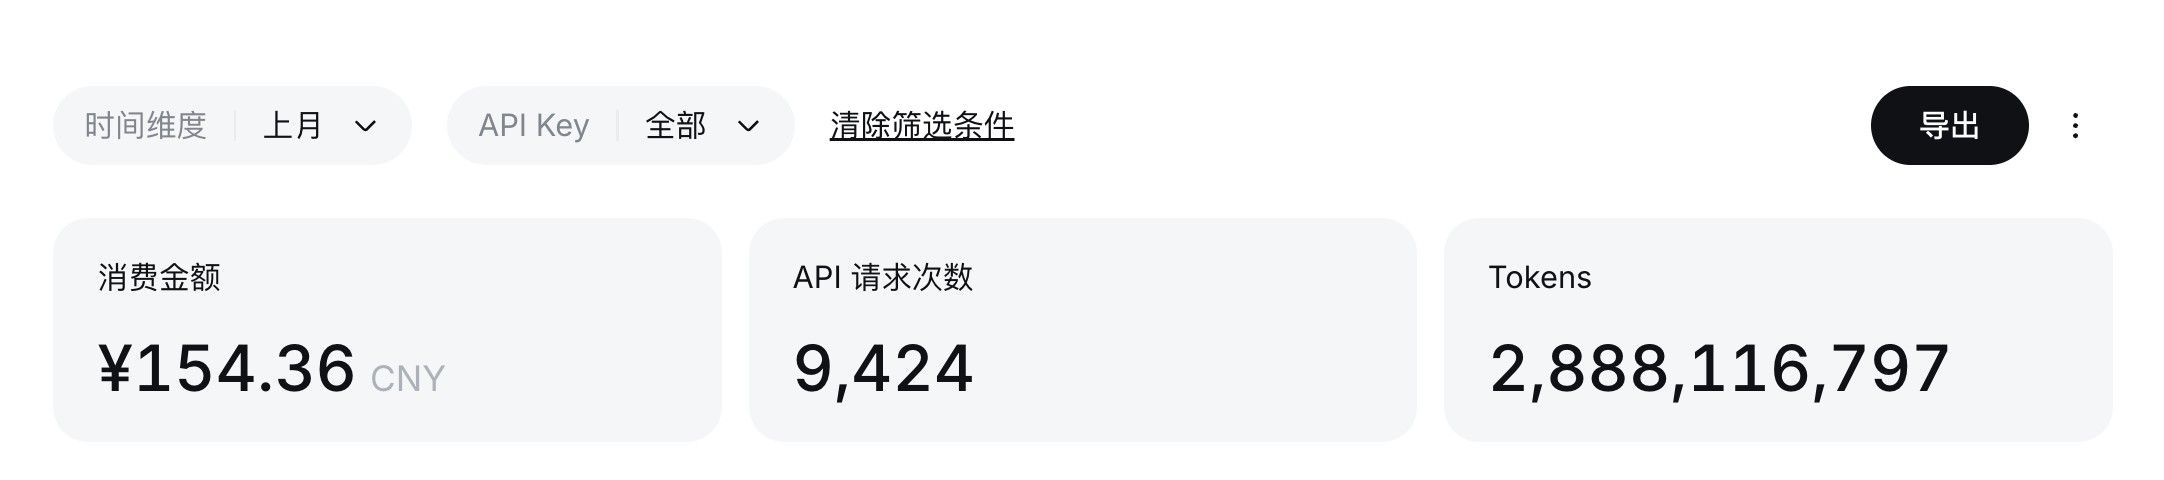
这个均价说明了一件事:两亿九千万 tokens 里,真正按未命中价和输出价算的只有八千万左右,其余全部命中了缓存,命中率约 97%。
而缓存命中是这套账里最关键的数字。同样 2.89B tokens,全部命中的话账单是 58 元;全部未命中,是 2,888 元。差五十倍。
换成本地呢?本地不吃缓存价,只吃时间。按这次实测的真实计算速率(未命中加输出,每小时 1.56M tokens),9 月那八千多万的实际计算量,大约需要每月 52 个 GPU 小时,折合每天 1.7 小时,电费 13 元。
用量 tokens/月 每天 GPU 时间 本地电费 flash 账单 整机 6 万回本 现在 2.89B 1.7 小时 13 元 154 元 35 年 5 倍 14.4B 8.7 小时 65 元 772 元 7.1 年 10 倍 28.9B 17.3 小时 130 元 1,544 元 3.5 年 跑满 24 小时 39.9B 23.9 小时 179 元 2,130 元 2.6 年 本地电费按满载 500W、0.5 元一度、30 天算;500W 是按 N 卡实测 183W、A 卡加主板 CPU 估的,空闲时 N 卡只有二十来瓦,所以这一列是上限。账单按空闲时段价折算,高峰翻倍。
结论比我原先想的保守:按现在的用量,买卡完全不划算,省下的钱要三十多年才抵得上机器。用量涨到十倍——每天十七个小时——才勉强进入三到四年的区间;跑满 24 小时也只有现在的十四倍,回本两年半。二十四小时是单机的物理上限,再往上只能加机器。
但这个结论有两个前提,不说清楚会被误读。
一是用量。我不是专业开发者,2.89B 是业余时间折腾出来的量。专业开发者一天到晚在跑 agent,可能是我这里的几倍到几十倍——真到那个量级,回本周期会从三十多年掉到几年,而且会撞上单机的物理上限。
二是目的,这一条更关键。这套系统现在没在产出任何价值,纯属娱乐和实验。"回本"这个概念只对生产环境成立:如果它就是个爱好,这笔钱该和别的爱好比——三万块的相机不会因为"省了租相机的钱"而回本。它买的是折腾的乐趣、随时能试的自由、数据不出门。
所以准确的说法是:按我现在的用量和目的,这笔钱是消费,不是投资。想让它变成投资,用量和生产价值得同时上去,缺一条都不成立。
另外两点。本地这个 Qwen3.8-Flash-Next 和 deepseek-flash 不是同一个东西,能力和可靠性都有差距,省钱的账只是一面。还有这个数仍有压缩空间——3 小时 39 分是没优化的试验状态,光一次冗余复核就占了 2 小时 43 分,真进了生产流程这种活不该重演,账还会更好看。
-
,
 T terry 固定了此主题
-
-
-
-
@terry 对于使用者来说,除了了解模型的能力,更重要的是了解模型的边界和驱动模型工作的规则。模型性能越堆越高,但落地实际跟预期相比还是有很大差距,当然有硬件的因素。但是在世界已经为AI陷入疯狂的时候,需要有一部分人用怀疑的眼光去审视。接触AI两年,亲身体会了技术的进步,但就我个人感受来说,仍是道阻且长,仍需努力,很多层面还是在吹泡泡。
-
还需用发展的眼光看问题, 这周说得对,下周就不一定了
-
-
-
这个按整机按6万算的,如果按照便宜点的x99洋垃圾配置,R9700+X99+64G DDR4+电源硬盘机箱散热=17000元以内,这套配置的tok中位数是72,比你的92tok低了20%,那么可以算作效率低20%,
即回本周期分别为
35年 × 系数(1+20%)×1.7万元/6万元
=35×0.34=11.9年,
其他同理
7.1年×0.34=2.4年,
3.5年×0.34=1.19年,
2.6年×0.34=0.88年,
不到一年就回本,还是挺不错的,
如果换成7900xtx,价格少6000,总成本不到1.1W,tok是65左右,系数是 0.24,那么结论分别是 8.4年,1.7年,0.8年,0.6年
当然这只是数量的比较,严格来说tok的质量肯定是不如在线的 -
-
其实我觉得最快回本的方法就是去711 或者麦当劳打工。。。然后用手机通过tailscale连接回家生成视频
-
,系统 取消固定了此主题




