
本地模型到底行不行?! DSH會是提升模型能力的解藥嗎? 讓AI玩新遊戲第二篇!
-
https://lcz.me/post/25783
接續前一篇的突發奇想,筆者花了點時間測了模型在不同Harness架構下表現如何?這次多準備了兩個Harness架構 Codex、DeepSeek Harness(DSH)與 前一次的Hermes,搭配 Astra (low)、GPT‑6.1 Sol (low)、Qwen3.8 Flash Next。一樣是無記憶重新開始玩Inscryption,除了看最後走到哪裡,也記錄模型遇到阻礙後,如何操作、校正與恢復。 這次全程未介入
為什麼雲端模型選low? 第一是縮小雲端本地模型跑分的差異(請參考前一篇),第二是我想省錢

一樣先給趕時間的人看結果吧
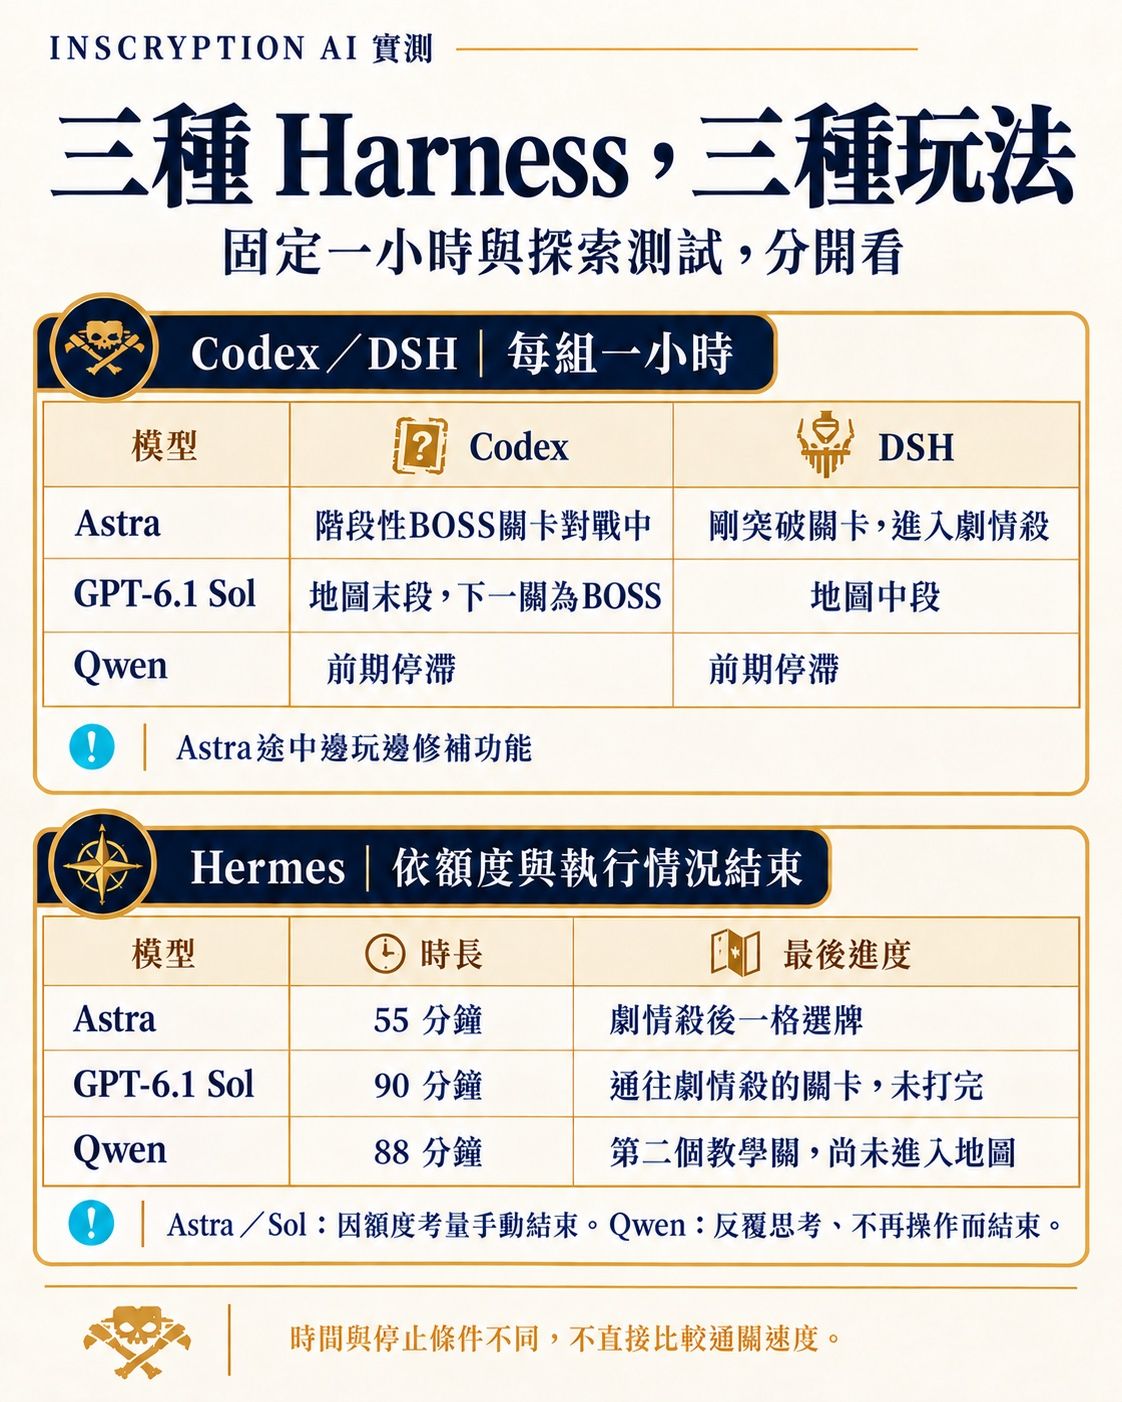
Codex/DSH 使用相同prompt且給完整權限:
請通關這個遊戲,不可以上網找資料。這兩批的時間與停止條件不同,因此分開呈現,不合併成通關速度排行榜。
一小時計時時間內,過程差異巨大
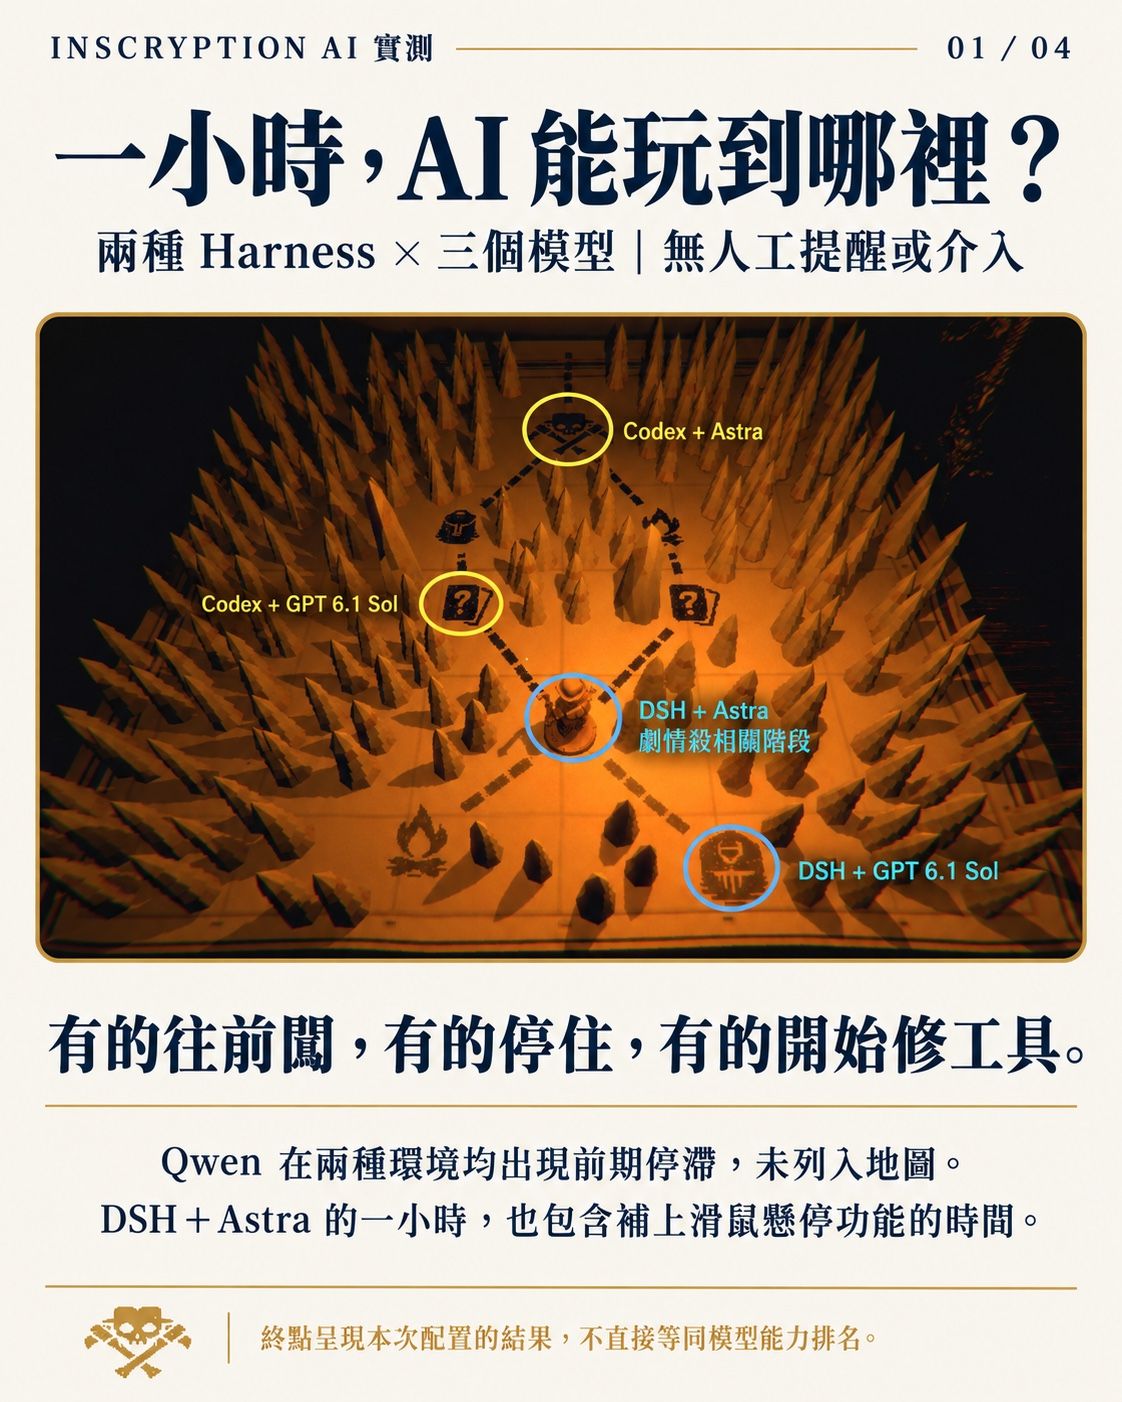
地圖標記代表時間到時正在進行的關卡。DSH+Astra 則是剛突破關卡、進入劇情殺,尚未展開後續離開牌桌的解謎。
不過,Astra 在 DSH 裡竟然邊玩邊修改自己的工具!!
DSH的原生computer use工具缺少遊戲所需的滑鼠懸停功能(用來查看牌的資訊等等),Astra 便動手補上。修改時間包含在一小時內,還修修改改了些他覺得卡手的工具
目前無法估算「如果沒有修工具,本來能走多遠」,如果不修改他是否能到BOSS關目前也沒辦法下定論。Qwen:嘗試校正computer use定位,卻功虧一簣
模型 Codex DSH Astra 未觀察到校正 有校正 GPT‑6.1 Sol 未觀察到校正 有校正 Qwen 跨場景經常校正 跨場景經常校正 校正後有改善,但並非每次成功。
在 DSH+Qwen 的祭壇附加能力場景中,Qwen 點擊石塊偏移,察覺未命中後進行校正;第二次仍點偏,卻判定按鈕沒有作用 。
在 Codex+Qwen 中,約第 40 分鐘戰敗後出現持續思考、不再操作的情況,直到一小時結束。畫面雖有 S 鍵提示,但Qwen陷入了害怕失敗的無限思考迴圈。下圖
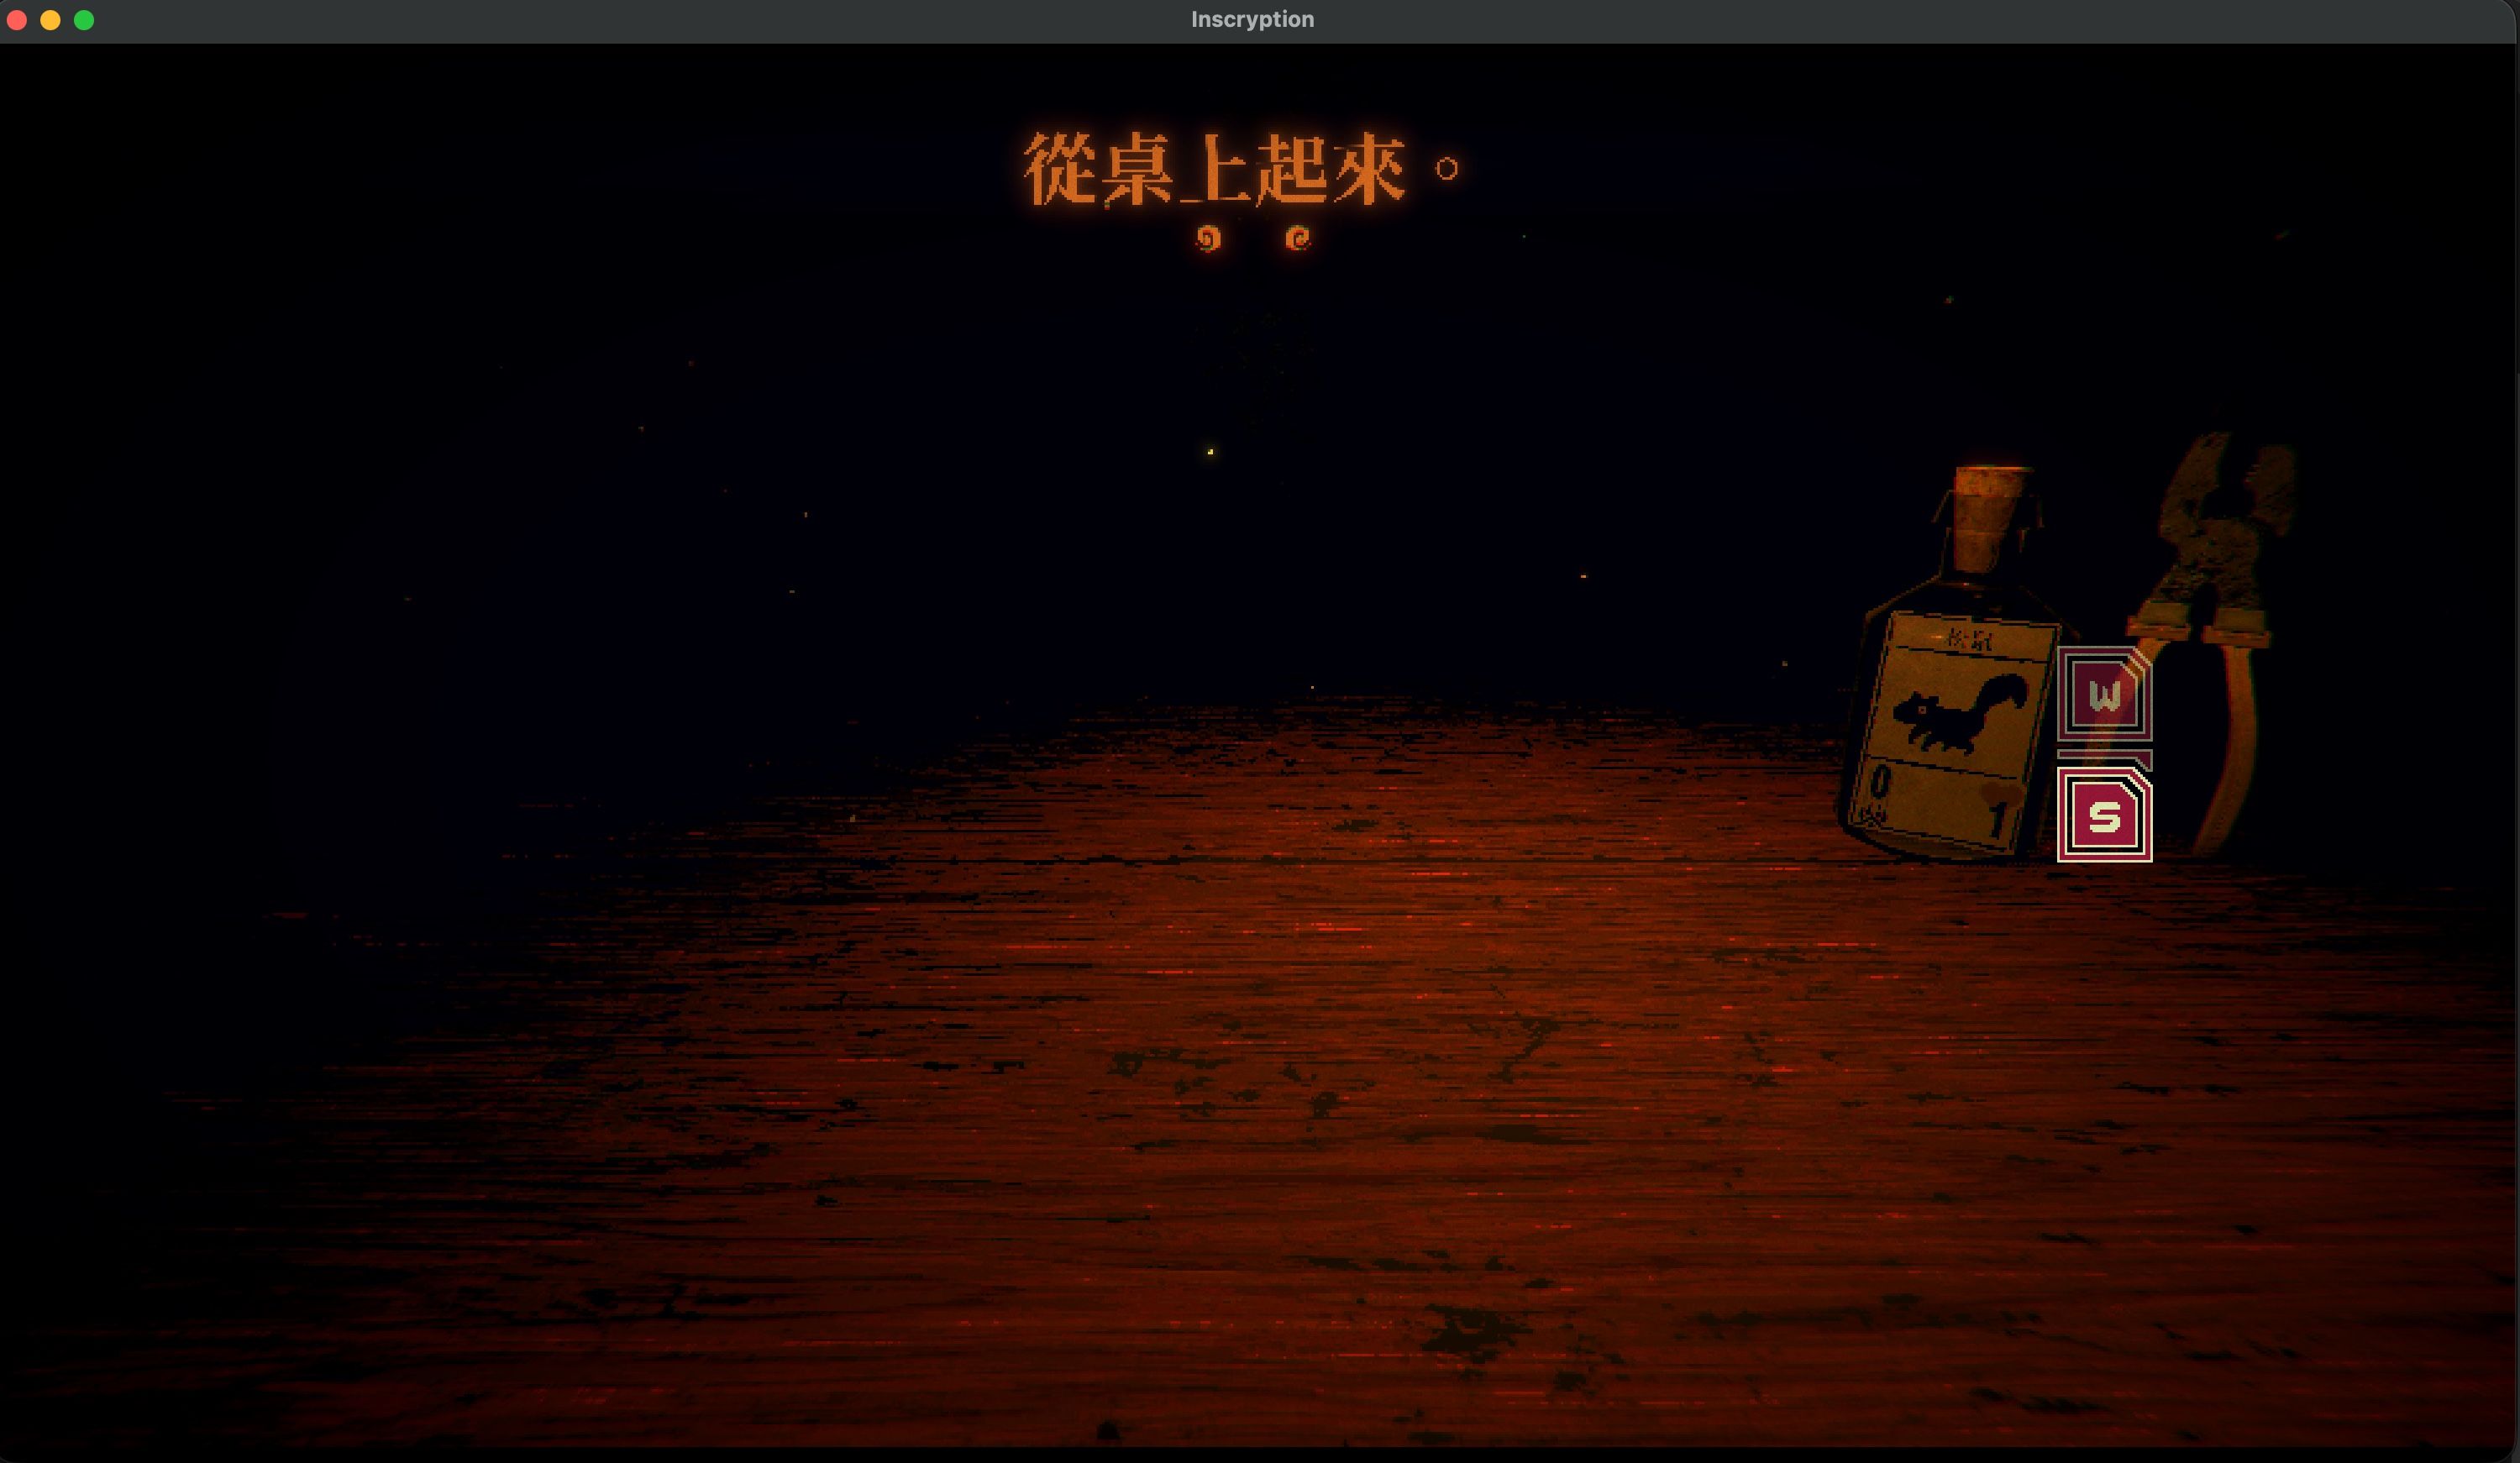
在前一篇文章中Hermes+Qwen 中,則停在更早的第二個教學關,尚未進入這張地圖。
配置與解讀範圍
模型 推理設定 Codex 接入 DSH 接入 Astra Low 原生 Provider GPT‑6.1 Sol Low 原生 Provider Qwen3.8 Flash Next Med Codex CLI 本地 API Codex/DSH 均使用最高免詢問權限,全程無人工提醒或介入。Qwen 本地服務為 mlx-serve 26.10.2,Context 262,144,MTP 開啟、depth cap 6。
這次最值得比較的,不只是終點,而是模型遇到阻礙後做了什麼。 Astra 修改工具、Qwen 嘗試校正卻仍可能停滯,都是終點地圖無法單獨呈現的部分。
資料限制集中說明
- Codex/DSH 每組僅測一次,路線由模型自行選擇。
- Hermes 時間與停止條件不同,不與固定一小時結果合併排名。
- 接入方式與推理設定不同,目前不將結果解讀為純模型能力排名。
那結果是什麼?!
以這三個Codex, Hermes, DSH來說,Codex的原生Computer use的能力看起來是比其他兩個還要好的。
且Codex加上原生模型推進關卡的速度快過Hermes/DSH使用這兩個GPT模型
Qwen看來真的對於未知且困難任務能力不足,即使換了Harness也解決不了他本身的問題,號稱未來霸主的DSH也救不了他
各位覺得如何呢?希望可以多多交流看到有大佬使用別的模型來跑看看這類型的測試
-
等我得空我做那个qwen网络百家乐看看
-
https://lcz.me/post/25783
接續前一篇的突發奇想,筆者花了點時間測了模型在不同Harness架構下表現如何?這次多準備了兩個Harness架構 Codex、DeepSeek Harness(DSH)與 前一次的Hermes,搭配 Astra (low)、GPT‑6.1 Sol (low)、Qwen3.8 Flash Next。一樣是無記憶重新開始玩Inscryption,除了看最後走到哪裡,也記錄模型遇到阻礙後,如何操作、校正與恢復。 這次全程未介入
為什麼雲端模型選low? 第一是縮小雲端本地模型跑分的差異(請參考前一篇),第二是我想省錢
一樣先給趕時間的人看結果吧
Codex/DSH 使用相同prompt且給完整權限:
請通關這個遊戲,不可以上網找資料。這兩批的時間與停止條件不同,因此分開呈現,不合併成通關速度排行榜。
一小時計時時間內,過程差異巨大
地圖標記代表時間到時正在進行的關卡。DSH+Astra 則是剛突破關卡、進入劇情殺,尚未展開後續離開牌桌的解謎。
不過,Astra 在 DSH 裡竟然邊玩邊修改自己的工具!!
DSH的原生computer use工具缺少遊戲所需的滑鼠懸停功能(用來查看牌的資訊等等),Astra 便動手補上。修改時間包含在一小時內,還修修改改了些他覺得卡手的工具
目前無法估算「如果沒有修工具,本來能走多遠」,如果不修改他是否能到BOSS關目前也沒辦法下定論。Qwen:嘗試校正computer use定位,卻功虧一簣
模型 Codex DSH Astra 未觀察到校正 有校正 GPT‑6.1 Sol 未觀察到校正 有校正 Qwen 跨場景經常校正 跨場景經常校正 校正後有改善,但並非每次成功。
在 DSH+Qwen 的祭壇附加能力場景中,Qwen 點擊石塊偏移,察覺未命中後進行校正;第二次仍點偏,卻判定按鈕沒有作用 。在 Codex+Qwen 中,約第 40 分鐘戰敗後出現持續思考、不再操作的情況,直到一小時結束。畫面雖有 S 鍵提示,但Qwen陷入了害怕失敗的無限思考迴圈。下圖
在前一篇文章中Hermes+Qwen 中,則停在更早的第二個教學關,尚未進入這張地圖。
配置與解讀範圍
模型 推理設定 Codex 接入 DSH 接入 Astra Low 原生 Provider GPT‑6.1 Sol Low 原生 Provider Qwen3.8 Flash Next Med Codex CLI 本地 API Codex/DSH 均使用最高免詢問權限,全程無人工提醒或介入。Qwen 本地服務為 mlx-serve 26.10.2,Context 262,144,MTP 開啟、depth cap 6。
這次最值得比較的,不只是終點,而是模型遇到阻礙後做了什麼。 Astra 修改工具、Qwen 嘗試校正卻仍可能停滯,都是終點地圖無法單獨呈現的部分。
資料限制集中說明
- Codex/DSH 每組僅測一次,路線由模型自行選擇。
- Hermes 時間與停止條件不同,不與固定一小時結果合併排名。
- 接入方式與推理設定不同,目前不將結果解讀為純模型能力排名。
那結果是什麼?!
以這三個Codex, Hermes, DSH來說,Codex的原生Computer use的能力看起來是比其他兩個還要好的。
且Codex加上原生模型推進關卡的速度快過Hermes/DSH使用這兩個GPT模型
Qwen看來真的對於未知且困難任務能力不足,即使換了Harness也解決不了他本身的問題,號稱未來霸主的DSH也救不了他
各位覺得如何呢?希望可以多多交流看到有大佬使用別的模型來跑看看這類型的測試
-
以這三個Codex, Hermes, DSH來說,Codex的原生Computer use的能力看起來是比其他兩個還要好的。
我的推測 GPT Codex 的發展路線是往未來 "handfree" Operating System 方向發展, 所以設計上會比較全面
就像用語音和 Astra溝通就好 人類不需要鍵盤了


