跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 双 RTX PRO 6000 + 48GB RAM:Strata 跑 DeepSeek 1017,Decode 80.8 tok/s,524K Prefill 1,385 tok/s

双 RTX PRO 6000 + 48GB RAM:Strata 跑 DeepSeek 1017,Decode 80.8 tok/s,524K Prefill 1,385 tok/s

已定时 已固定 已锁定 已移动 LLM讨论区
rtxpro6000deepseek多卡部署
25 帖子 7 发布者 656 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • lunarmoon26L lunarmoon26

    @johnnybegood 也就是说你在dsh里说“给我生成一个鹈鹕骑自行车的 SVG动画” 他自己生成了个html吗?没有写别的要求?
    还有就是dsh web profile里自带的工具,Skill和harness loop本身都会影响输出结果。(还有你自己电脑上装的Skill 看下你的~/.agents/skills里有没有东西被自动加载了)

    严谨来讲最好写个单独的eval python来调用LLM生成鹈鹕svg

    johnnybegoodJ
    johnnybegoodJ
    johnnybegood
    王侯将相
    编写于 最后由 编辑
    #13

    @lunarmoon26

    1, 启动strata, 加载模型qfn iq4_xs
    2,启动deepseek harnness , 开新对话,选中本地qfn模型

    3, 请帮我生成一个醍醐骑自行车的svg动画
    4,生成了个醍醐灌顶骑车
    5,错了!你是不是傻。 重新生成 鹈鹕骑自行车的svg动画
    6,跑了20多分钟就出来tihu2了

    lunarmoon26L 1 条回复 最后回复
    0
    • johnnybegoodJ johnnybegood

      @lunarmoon26

      1, 启动strata, 加载模型qfn iq4_xs
      2,启动deepseek harnness , 开新对话,选中本地qfn模型

      3, 请帮我生成一个醍醐骑自行车的svg动画
      4,生成了个醍醐灌顶骑车
      5,错了!你是不是傻。 重新生成 鹈鹕骑自行车的svg动画
      6,跑了20多分钟就出来tihu2了

      lunarmoon26L
      lunarmoon26L
      lunarmoon26
      体面乡绅
      编写于 最后由 编辑
      #14

      @johnnybegood 是的 模型一样的情况下有harness和没harness生成的svg差别很大

      1 条回复 最后回复
      0
      • soop ladiosS
        soop ladiosS
        soop ladios
        贵族大夫 硕果累累
        编写于 最后由 编辑
        #15

        光就跑deepseek來說, DGX spark GB10還是比較香一點, 一張RTX pro 6000差不多就四台GB10的錢. 4台GB10可以跑滿血deepseek v4.1 flash 1017, decode 90~100 tok/s, prefill 3500-4000 tok/s, 500K ctx 10併發.

        kos orK johnnybegoodJ lunarmoon26L 3 条回复 最后回复
        1
        • soop ladiosS soop ladios

          光就跑deepseek來說, DGX spark GB10還是比較香一點, 一張RTX pro 6000差不多就四台GB10的錢. 4台GB10可以跑滿血deepseek v4.1 flash 1017, decode 90~100 tok/s, prefill 3500-4000 tok/s, 500K ctx 10併發.

          kos orK
          kos orK
          kos or
          至尊皇帝
          编写于 最后由 kos or 编辑
          #16

          @soop-ladios said:

          deepseek v4.1 flash 1017, decode 90~100 tok/s, prefill 3500-4000 tok/s, 500K ctx 10併發.

          10併發, aggregate 速度有多快呢? 聽起來好像不錯

          RTX pro 6000 算多功全能型, 跑ComfyUI 應該很順

          soop ladiosS 1 条回复 最后回复
          0
          • kos orK kos or

            @soop-ladios said:

            deepseek v4.1 flash 1017, decode 90~100 tok/s, prefill 3500-4000 tok/s, 500K ctx 10併發.

            10併發, aggregate 速度有多快呢? 聽起來好像不錯

            RTX pro 6000 算多功全能型, 跑ComfyUI 應該很順

            soop ladiosS
            soop ladiosS
            soop ladios
            贵族大夫 硕果累累
            编写于 最后由 编辑
            #17

            @kos-or 10併發約230-260 tok/s.

            1 条回复 最后回复
            1
            • soop ladiosS soop ladios

              光就跑deepseek來說, DGX spark GB10還是比較香一點, 一張RTX pro 6000差不多就四台GB10的錢. 4台GB10可以跑滿血deepseek v4.1 flash 1017, decode 90~100 tok/s, prefill 3500-4000 tok/s, 500K ctx 10併發.

              johnnybegoodJ
              johnnybegoodJ
              johnnybegood
              王侯将相
              编写于 最后由 编辑
              #18

              @soop-ladios 四张 5070ti 加起来, 从纯硬件角度看真的要超过 rtx pro 6000了, 就看软件能发挥硬件多少能力的问题了。

              lunarmoon26L 1 条回复 最后回复
              1
              • soop ladiosS soop ladios

                光就跑deepseek來說, DGX spark GB10還是比較香一點, 一張RTX pro 6000差不多就四台GB10的錢. 4台GB10可以跑滿血deepseek v4.1 flash 1017, decode 90~100 tok/s, prefill 3500-4000 tok/s, 500K ctx 10併發.

                lunarmoon26L
                lunarmoon26L
                lunarmoon26
                体面乡绅
                编写于 最后由 lunarmoon26 编辑
                #19

                @soop-ladios 有数据出处吗?4个GB10连起来VRAM带宽理论上是可以scale 大概270*4将近1TB/s 但是除了DGX Spark的钱还需要买QSFP112光纤和交换机大概又是好几千美元。

                而且10并法意思是aggregate起来230-260 tok/s吧 所以单个用户只有20tok/s 还是基本上等于不能用

                目前双PRO6000方案这个人的是最快的:
                https://huggingface.co/cliecy/DeepSeek-V4.1-Flash-1017-EXL3-3bpw-2xRTXPRO6000

                EXL3 3bpw量化大概 decode 100 tok/s, prefill 4800 tok/s, 1m ctx, on vllm
                但是RAM需求非常高 要256GB

                soop ladiosS 1 条回复 最后回复
                0
                • johnnybegoodJ johnnybegood

                  @soop-ladios 四张 5070ti 加起来, 从纯硬件角度看真的要超过 rtx pro 6000了, 就看软件能发挥硬件多少能力的问题了。

                  lunarmoon26L
                  lunarmoon26L
                  lunarmoon26
                  体面乡绅
                  编写于 最后由 lunarmoon26 编辑
                  #20

                  @johnnybegood 4x5070ti (或者别的卡)主要问题是Pcie通信的带宽 如果这些卡支持Spark上那种ConnectX-7的RoCE链接 核心算力速度和显存带宽是可以叠加的

                  不然就光Pcie通信overhead可能都会增加延迟。

                  johnnybegoodJ 1 条回复 最后回复
                  0
                  • lunarmoon26L lunarmoon26

                    @soop-ladios 有数据出处吗?4个GB10连起来VRAM带宽理论上是可以scale 大概270*4将近1TB/s 但是除了DGX Spark的钱还需要买QSFP112光纤和交换机大概又是好几千美元。

                    而且10并法意思是aggregate起来230-260 tok/s吧 所以单个用户只有20tok/s 还是基本上等于不能用

                    目前双PRO6000方案这个人的是最快的:
                    https://huggingface.co/cliecy/DeepSeek-V4.1-Flash-1017-EXL3-3bpw-2xRTXPRO6000

                    EXL3 3bpw量化大概 decode 100 tok/s, prefill 4800 tok/s, 1m ctx, on vllm
                    但是RAM需求非常高 要256GB

                    soop ladiosS
                    soop ladiosS
                    soop ladios
                    贵族大夫 硕果累累
                    编写于 最后由 soop ladios 编辑
                    #21

                    @lunarmoon26
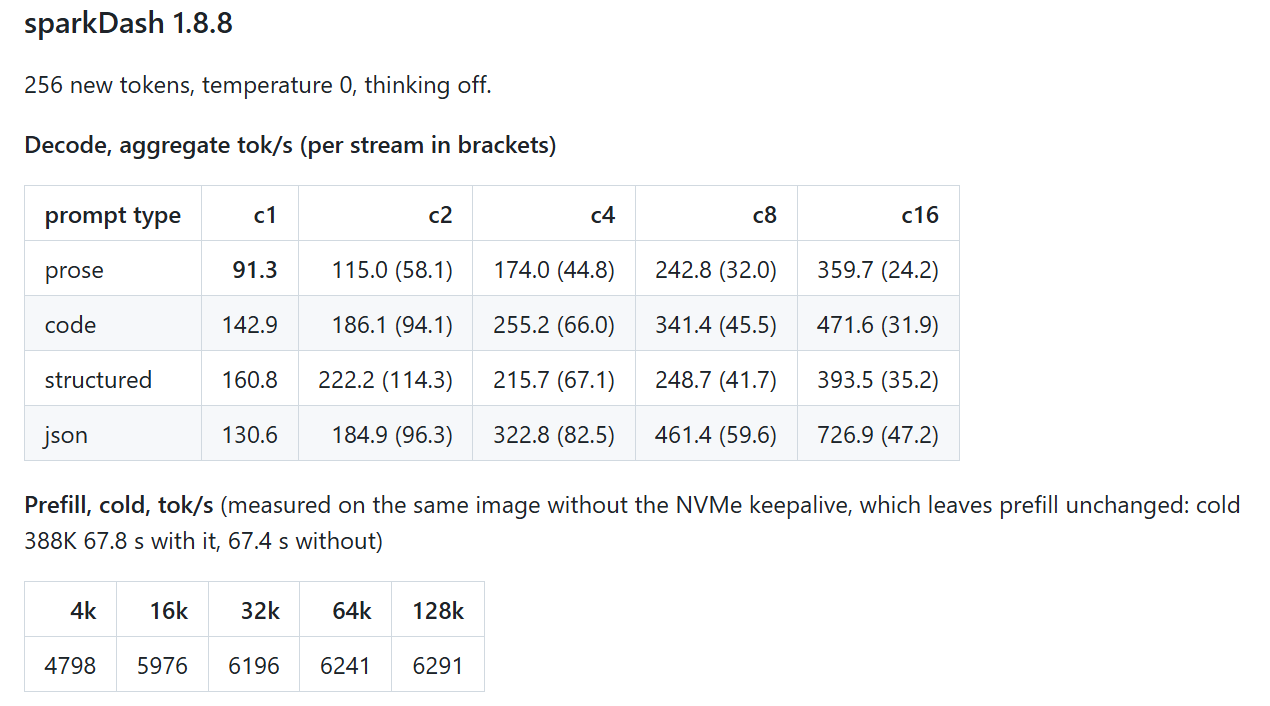
                    這是我實測的數字, 配方來源 https://github.com/knapcio/DeepSeek-V4.1-Flash-4x-DGX-Spark-TP4
                    這是原版模型,不是3 bit量化的. 10併發實測能有2x我覺得很好了.
                    原repo的數據:
                    螢幕擷取畫面 2026-10-26 060538.png

                    我的實測c1 90~100多是實際跑任務觀察的, c10 是叫Agent打的, 平常沒那麼多在跑.
                    社區上有更猛的repo, 不過要改到kernel, 我就懶得弄了

                    lunarmoon26L 1 条回复 最后回复
                    0
                    • soop ladiosS soop ladios

                      @lunarmoon26
                      這是我實測的數字, 配方來源 https://github.com/knapcio/DeepSeek-V4.1-Flash-4x-DGX-Spark-TP4
                      這是原版模型,不是3 bit量化的. 10併發實測能有2x我覺得很好了.
                      原repo的數據:
                      螢幕擷取畫面 2026-10-26 060538.png

                      我的實測c1 90~100多是實際跑任務觀察的, c10 是叫Agent打的, 平常沒那麼多在跑.
                      社區上有更猛的repo, 不過要改到kernel, 我就懶得弄了

                      lunarmoon26L
                      lunarmoon26L
                      lunarmoon26
                      体面乡绅
                      编写于 最后由 编辑
                      #22

                      @soop-ladios 说:

                      令我驚豔,不過那是原版的. Exl3 2.9bpw我正在 4 x v100 32G + 128G DDR4 ram測試, 速度也只有30 tok/s, prefill只有500多, 還要再調一下, 調完再來看看品質如何. Ok的話30 tok/s還是很好用的.

                      照理说原版应该比量化慢🤔 不过4台spark还是很猛的 我的4台spark马上也要到了 有点小期待

                      你连spark用了交换机吗?有没有推荐的?

                      哈哈哈 30toks我不行 我日常使用一定要~100toks左右 不过context 400k就够了

                      soop ladiosS 1 条回复 最后回复
                      0
                      • lunarmoon26L lunarmoon26

                        @soop-ladios 说:

                        令我驚豔,不過那是原版的. Exl3 2.9bpw我正在 4 x v100 32G + 128G DDR4 ram測試, 速度也只有30 tok/s, prefill只有500多, 還要再調一下, 調完再來看看品質如何. Ok的話30 tok/s還是很好用的.

                        照理说原版应该比量化慢🤔 不过4台spark还是很猛的 我的4台spark马上也要到了 有点小期待

                        你连spark用了交换机吗?有没有推荐的?

                        哈哈哈 30toks我不行 我日常使用一定要~100toks左右 不过context 400k就够了

                        soop ladiosS
                        soop ladiosS
                        soop ladios
                        贵族大夫 硕果累累
                        编写于 最后由 编辑
                        #23

                        @lunarmoon26
                        交換機我只有買過MIKROTIK CRS 804, 預設風扇蠻吵, 應該可以調. 不知道好不好買, 4台的話不用switch也是行的.

                        1 条回复 最后回复
                        0
                        • lunarmoon26L lunarmoon26

                          @johnnybegood 4x5070ti (或者别的卡)主要问题是Pcie通信的带宽 如果这些卡支持Spark上那种ConnectX-7的RoCE链接 核心算力速度和显存带宽是可以叠加的

                          不然就光Pcie通信overhead可能都会增加延迟。

                          johnnybegoodJ
                          johnnybegoodJ
                          johnnybegood
                          王侯将相
                          编写于 最后由 编辑
                          #24

                          @lunarmoon26 我说的4张5070ti,比喻的就是4台Spark。而且4台Spark对比的是一张RTX Pro6000。如果有两张的话,当然是无敌的。

                          lunarmoon26L 1 条回复 最后回复
                          0
                          • johnnybegoodJ johnnybegood

                            @lunarmoon26 我说的4张5070ti,比喻的就是4台Spark。而且4台Spark对比的是一张RTX Pro6000。如果有两张的话,当然是无敌的。

                            lunarmoon26L
                            lunarmoon26L
                            lunarmoon26
                            体面乡绅
                            编写于 最后由 编辑
                            #25

                            @johnnybegood 5070ti核心算力和spark差不多 不过硬件架构问题4x5070ti还是不能跟4xSpark一样协同工作

                            5070ti便宜太多了

                            1 条回复 最后回复
                            0

                            你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                            厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                            有了你的建议,这篇帖子会更精彩哦 💗

                            注册 登录
                            回复
                            • 在新帖中回复
                            登录后回复
                            • 从旧到新
                            • 从新到旧
                            • 最多赞同


                            • 登录

                            • 登录或注册以进行搜索。
                            • 第一个帖子
                              最后一个帖子
                            0
                            • 版块
                            • 最新
                            • 标签
                            • 热门
                            • 用户
                            • 群组