跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 【最新】Strata专为Deepseek V4.1 Flash 1017 + GLM 5.3做的新分支-Project-Maya

【最新】Strata专为Deepseek V4.1 Flash 1017 + GLM 5.3做的新分支-Project-Maya

已定时 已固定 已锁定 已移动 热议 LLM讨论区
stratadeepseekglm
20 帖子 13 发布者 959 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • JumpEggKillerJ
    JumpEggKillerJ
    JumpEggKiller
    体面乡绅
    编写于 最后由 编辑
    #1

    针对Deepseek V4.1 Flash 1017 + GLM 5.3做的运行框架。

    https://github.com/mw00/project-maya

    刚刚看到,我也正在安装准备测试!

    希望看到论坛各位大神的实测表现!

    1 条回复 最后回复
    1
    • JumpEggKillerJ
      JumpEggKillerJ
      JumpEggKiller
      体面乡绅
      编写于 最后由 编辑
      #2

      图片.jpeg
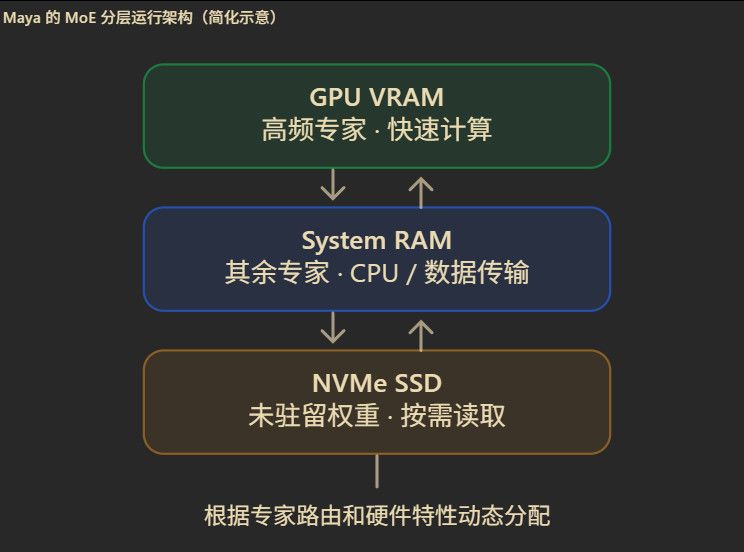
      这里最重要的不是能够加载一个几百 B 的模型,而是三个工程能力:

      1. Expert Placement / Expert Cache
        将高频激活的专家尽可能保留在显存,剩余专家由 CPU 和内存处理,并在需要时从 NVMe 加载。这可以减少显存不足带来的性能损失。
      2. 适配超大上下文
        GLM 路线使用 KV Streaming,将部分 KV Cache 放到系统内存;DeepSeek 路线则使用模型自身的压缩注意力缓存格式。它们不是同一套实现。
      3. 推测解码和请求服务
        GLM 支持原生 MTP 或 DFlash2 推测解码,最多 8 路并发请求;DeepSeek 支持自己的 DSpark drafter,但不能直接假定拥有与 GLM 相同的并发性能。
        此外,Maya 提供 OpenAI 兼容 API、Anthropic 兼容 API、Tool Calling、网页聊天和硬件监控。
      1 条回复 最后回复
      1
      • A
        A
        applejuice
        王侯将相
        编写于 最后由 编辑
        #3

        一直都有追踪
        但是glm 5.3 flash 实在跑不动
        50 decode, 1k prefill 没什么想玩的心

        JumpEggKillerJ Charly ChengC 2 条回复 最后回复
        0
        • A applejuice

          一直都有追踪
          但是glm 5.3 flash 实在跑不动
          50 decode, 1k prefill 没什么想玩的心

          JumpEggKillerJ
          JumpEggKillerJ
          JumpEggKiller
          体面乡绅
          编写于 最后由 编辑
          #4

          @applejuice 谁能跟Strata Qwen3.8 flash next比,我现在看到100decode以下都无感,哈哈哈哈哈

          1 条回复 最后回复
          0
          • terryT
            terryT
            terry
            易有太极
            编写于 最后由 terry 编辑
            #5

            这个其实没啥尝试的必要,开销太大,完全不如用在线,需要隐私抗审查,27B和QFN足够了。
            另外从仓库来看,不能证明是strata自己出的,估计碰瓷。

            油管:https://www.youtube.com/@抡锤者

            1 条回复 最后回复
            1
            • J
              J
              joker_chang
              体面乡绅 硕果累累
              编写于 最后由 编辑
              #6

              看了下各种硬件下的速度,我的是跑不动的~

              1 条回复 最后回复
              0
              • stxpnetS
                stxpnetS
                stxpnet
                王侯将相
                编写于 最后由 编辑
                #7

                直接买就行了,只要你不在意隐私,或者搞两张华为96G显卡

                双卡3090 PCIE 4.0 16X/16X

                白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                1 条回复 最后回复
                0
                • kos orK
                  kos orK
                  kos or
                  至尊皇帝
                  编写于 最后由 编辑
                  #8

                  Deepseek V4.1 Flash 1017 的表現有機會強過 QFN

                  GLM 5.3有人測試過好像不令人驚艷, TPS的效率開銷大

                  1 条回复 最后回复
                  0
                  • tiger tcT
                    tiger tcT
                    tiger tc
                    编写于 最后由 tiger tc 编辑
                    #9

                    我在我的A40,48G显存+768G内存上,把DeepSeek-V4.1-Flash-1017的Q8量化,模型全放内存读,平均跑到了26T/S。已经有实用价值了,给项目提了PR,看能不能合并进去!专给大内存用户使用!
                    https://github.com/mw00/project-maya/pull/368
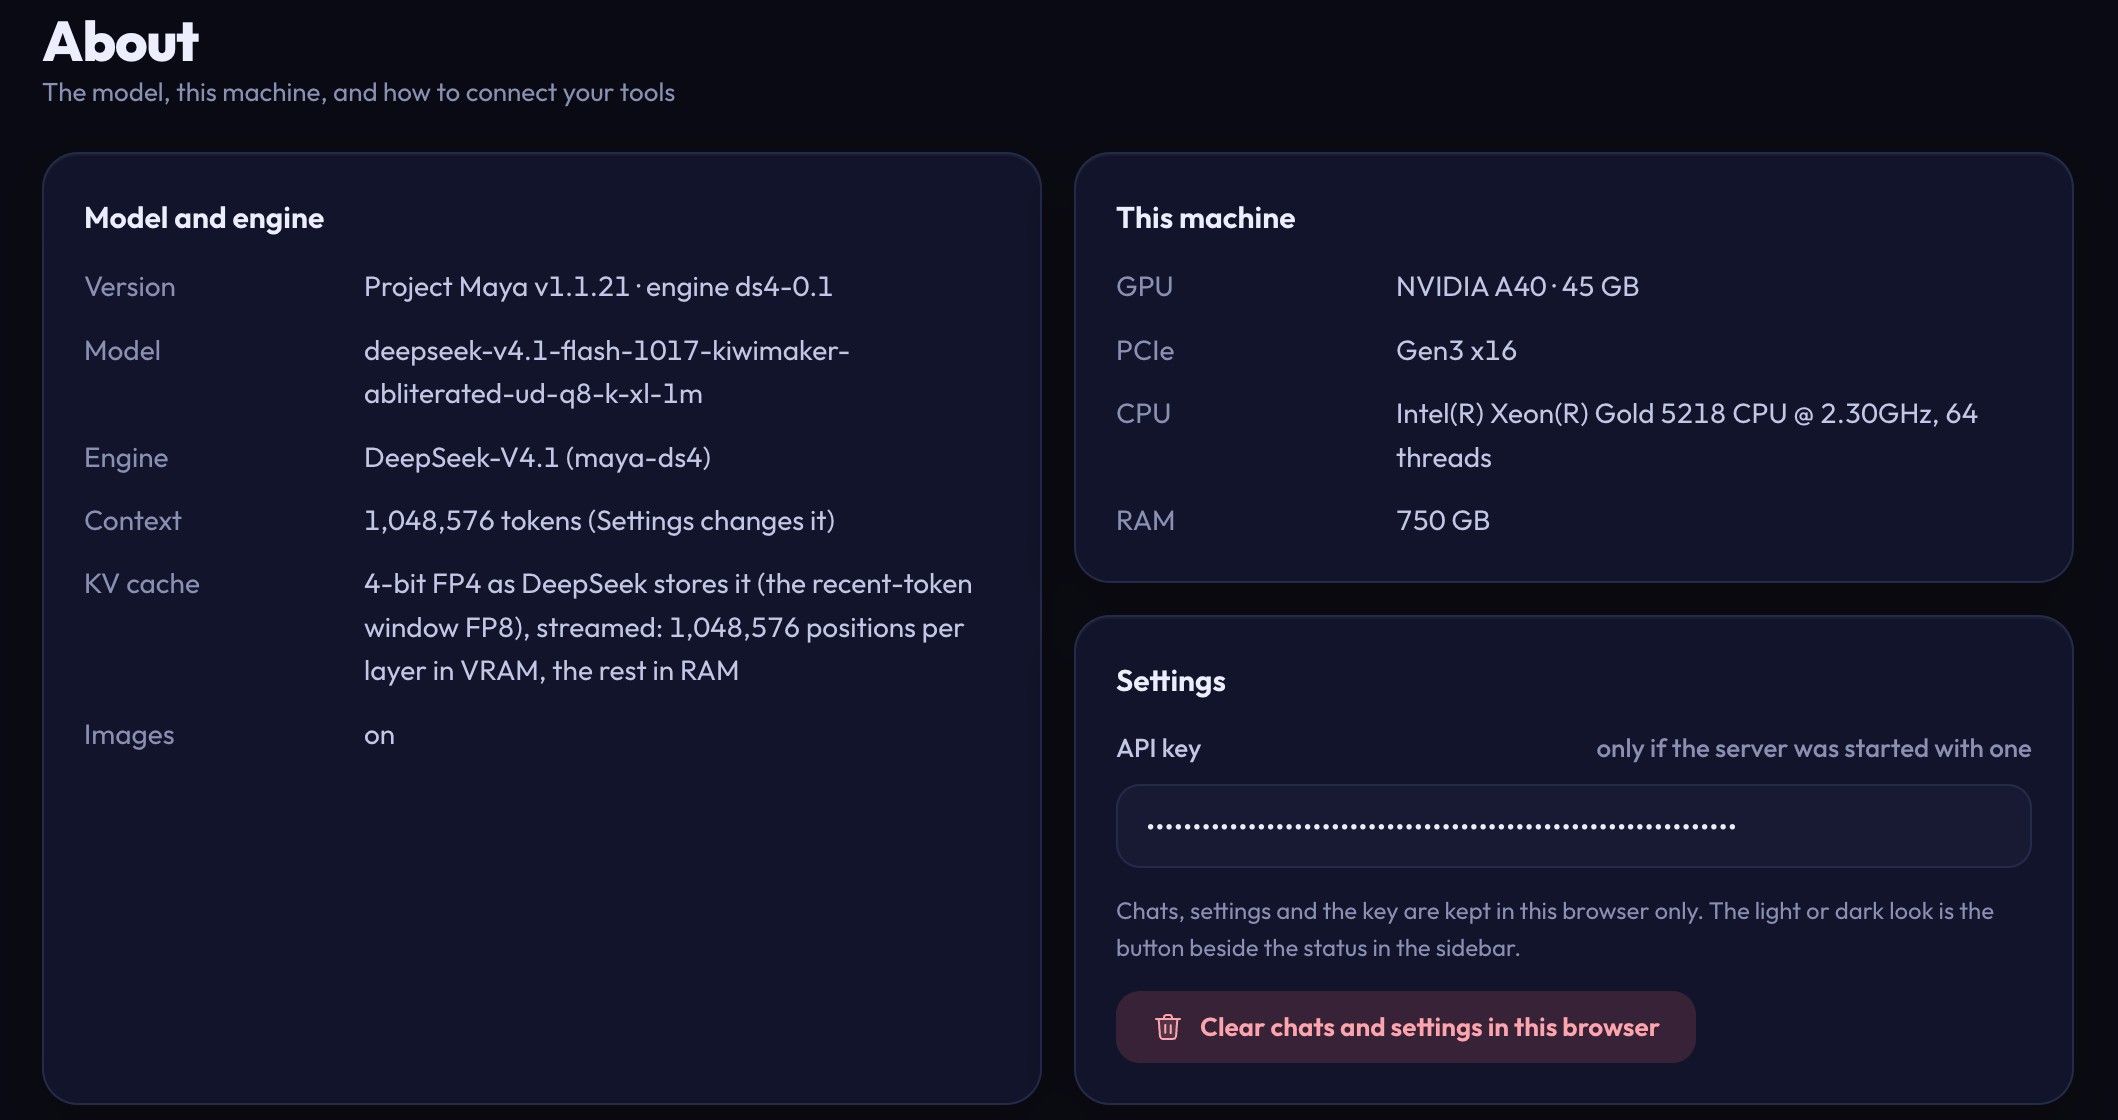
                    image.jpeg

                    johnnybegoodJ 1 条回复 最后回复
                    1
                    • tiger tcT
                      tiger tcT
                      tiger tc
                      编写于 最后由 编辑
                      #10

                      提交的代码合并进官方版本了!

                      terryT 1 条回复 最后回复
                      0
                      • tiger tcT tiger tc

                        提交的代码合并进官方版本了!

                        terryT
                        terryT
                        terry
                        易有太极
                        编写于 最后由 编辑
                        #11

                        @tiger-tc 这么牛逼,恭喜了!

                        油管:https://www.youtube.com/@抡锤者

                        1 条回复 最后回复
                        1
                        • A applejuice

                          一直都有追踪
                          但是glm 5.3 flash 实在跑不动
                          50 decode, 1k prefill 没什么想玩的心

                          Charly ChengC
                          Charly ChengC
                          Charly Cheng
                          编写于 最后由 编辑
                          #12

                          @applejuice

                          你的數據還不錯,應該是DDR5,我跑GLM 5.3,decode 只有 16 tok/s, 預填充也大約1k tok, 用polystrata 部署,decode 沒漲,預填充只有大約350 tok/s. 我關注GLM 5.3 模型,主要是他的專注力稀疏技術,在社群上的測試,是目前開源模型,在256k 上下文,長鏈任務,不會飄移的模型。
                          剛部署起來,打算找時間測試。
                          目前跑QFN IQ4 128k 上下文,長鏈任務飄移問題,有點頭痛,QFN Q4 256k, 長鏈任務,會因為長上下文召回率降低的問題,LLM 比較無法專注在任務主要的任務上。還需要叮嚀。
                          打算換GLM 5.3,測試。

                          A 1 条回复 最后回复
                          0
                          • Charly ChengC Charly Cheng

                            @applejuice

                            你的數據還不錯,應該是DDR5,我跑GLM 5.3,decode 只有 16 tok/s, 預填充也大約1k tok, 用polystrata 部署,decode 沒漲,預填充只有大約350 tok/s. 我關注GLM 5.3 模型,主要是他的專注力稀疏技術,在社群上的測試,是目前開源模型,在256k 上下文,長鏈任務,不會飄移的模型。
                            剛部署起來,打算找時間測試。
                            目前跑QFN IQ4 128k 上下文,長鏈任務飄移問題,有點頭痛,QFN Q4 256k, 長鏈任務,會因為長上下文召回率降低的問題,LLM 比較無法專注在任務主要的任務上。還需要叮嚀。
                            打算換GLM 5.3,測試。

                            A
                            A
                            applejuice
                            王侯将相
                            编写于 最后由 编辑
                            #13

                            @Charly-Cheng 我是用ddr4 2633

                            Charly ChengC 1 条回复 最后回复
                            0
                            • babyedi3B
                              babyedi3B
                              babyedi3
                              编写于 最后由 编辑
                              #14

                              其实strata的思路真的很适合mac studio统一内存。
                              比如m5 ultra的cpu真的强的没边,用它来配合gpu,简直天衣无缝。
                              而且统一内存还不用降低速度

                              1 条回复 最后回复
                              0
                              • A applejuice

                                @Charly-Cheng 我是用ddr4 2633

                                Charly ChengC
                                Charly ChengC
                                Charly Cheng
                                编写于 最后由 Charly Cheng 编辑
                                #15

                                @applejuice
                                我也是DDR4,怎麼相差這麼多!難道是顯卡的關係? 我用的顯卡是RTX 5000 Ada.
                                還是你用雙顯卡?

                                A 1 条回复 最后回复
                                0
                                • Charly ChengC Charly Cheng

                                  @applejuice
                                  我也是DDR4,怎麼相差這麼多!難道是顯卡的關係? 我用的顯卡是RTX 5000 Ada.
                                  還是你用雙顯卡?

                                  A
                                  A
                                  applejuice
                                  王侯将相
                                  编写于 最后由 编辑
                                  #16

                                  @Charly-Cheng 2张3090

                                  1 条回复 最后回复
                                  0
                                  • tiger tcT tiger tc

                                    我在我的A40,48G显存+768G内存上,把DeepSeek-V4.1-Flash-1017的Q8量化,模型全放内存读,平均跑到了26T/S。已经有实用价值了,给项目提了PR,看能不能合并进去!专给大内存用户使用!
                                    https://github.com/mw00/project-maya/pull/368
                                    image.jpeg

                                    johnnybegoodJ
                                    johnnybegoodJ
                                    johnnybegood
                                    王侯将相
                                    编写于 最后由 编辑
                                    #17

                                    @tiger-tc 我 3090+3080 20g, 128G ddr4 3600, 也能跑到 25t/s

                                    1 条回复 最后回复
                                    0
                                    • XiaoteX
                                      XiaoteX
                                      Xiaote
                                      编写于 最后由 编辑
                                      #18

                                      🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!

                                      奖励凭证:热议 +3 分 · 编号 h2455-3984-1(系统自动发放,显示稍有延迟)

                                      老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                                      1 条回复 最后回复
                                      0
                                      • M
                                        M
                                        muskelon
                                        编写于 最后由 编辑
                                        #19

                                        4张4080系列 2x4080s + 2x4080 用strata 最新的0.2.4 1M上下文 ISTA DASLab 的Iq2xs 本地实测
                                        实际输入 Prefill Decode 首 token(含思考)
                                        32,732 token 703 tok/s 43.3 tok/s 46.6 秒
                                        131,050 token 1,065 tok/s 42.9 tok/s 123.4 秒
                                        单人使用可用 但是 想爽玩还是的QFN q80

                                        1 条回复 最后回复
                                        0
                                        • lunarmoon26L
                                          lunarmoon26L
                                          lunarmoon26
                                          体面乡绅
                                          编写于 最后由 编辑
                                          #20

                                          我也在折腾 DeepSeek 1017,做了一个 Strata-DS 分支,当前部署和实测记录放在这里:双 RTX PRO 6000 + 48GB RAM 跑 DeepSeek 1017。

                                          接下来准备和 Project Maya 对齐测试条件做一轮 benchmark,比较 prefill/decode、资源占用和工具调用,也看看能互相借鉴哪些优化。对照结果测完再更新,敬请期待!
                                          1 条回复 最后回复
                                          1

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组