
【最新】Strata专为Deepseek V4.1 Flash 1017 + GLM 5.3做的新分支-Project-Maya
-
针对Deepseek V4.1 Flash 1017 + GLM 5.3做的运行框架。
https://github.com/mw00/project-maya
刚刚看到,我也正在安装准备测试!
希望看到论坛各位大神的实测表现!
-
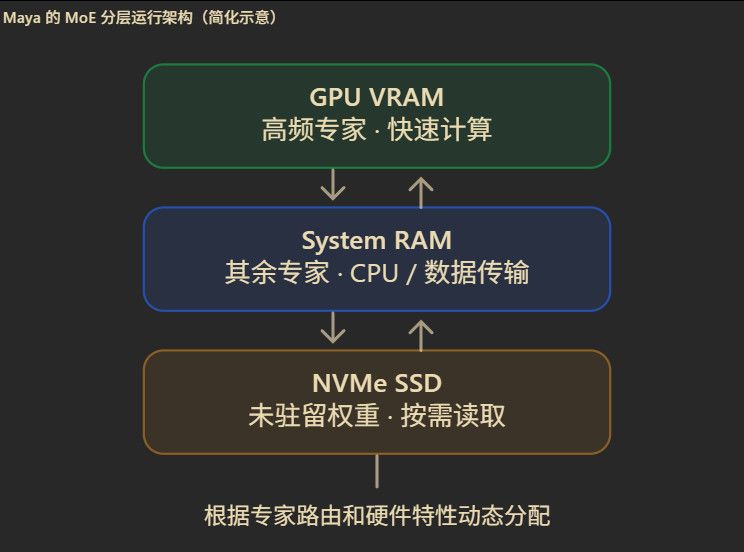
这里最重要的不是能够加载一个几百 B 的模型,而是三个工程能力:- Expert Placement / Expert Cache
将高频激活的专家尽可能保留在显存,剩余专家由 CPU 和内存处理,并在需要时从 NVMe 加载。这可以减少显存不足带来的性能损失。 - 适配超大上下文
GLM 路线使用 KV Streaming,将部分 KV Cache 放到系统内存;DeepSeek 路线则使用模型自身的压缩注意力缓存格式。它们不是同一套实现。 - 推测解码和请求服务
GLM 支持原生 MTP 或 DFlash2 推测解码,最多 8 路并发请求;DeepSeek 支持自己的 DSpark drafter,但不能直接假定拥有与 GLM 相同的并发性能。
此外,Maya 提供 OpenAI 兼容 API、Anthropic 兼容 API、Tool Calling、网页聊天和硬件监控。
- Expert Placement / Expert Cache
-
-
一直都有追踪
但是glm 5.3 flash 实在跑不动
50 decode, 1k prefill 没什么想玩的心@applejuice 谁能跟Strata Qwen3.8 flash next比,我现在看到100decode以下都无感,哈哈哈哈哈
-
-
-
-
-
-
-
-
一直都有追踪
但是glm 5.3 flash 实在跑不动
50 decode, 1k prefill 没什么想玩的心你的數據還不錯,應該是DDR5,我跑GLM 5.3,decode 只有 16 tok/s, 預填充也大約1k tok, 用polystrata 部署,decode 沒漲,預填充只有大約350 tok/s. 我關注GLM 5.3 模型,主要是他的專注力稀疏技術,在社群上的測試,是目前開源模型,在256k 上下文,長鏈任務,不會飄移的模型。
剛部署起來,打算找時間測試。
目前跑QFN IQ4 128k 上下文,長鏈任務飄移問題,有點頭痛,QFN Q4 256k, 長鏈任務,會因為長上下文召回率降低的問題,LLM 比較無法專注在任務主要的任務上。還需要叮嚀。
打算換GLM 5.3,測試。 -
你的數據還不錯,應該是DDR5,我跑GLM 5.3,decode 只有 16 tok/s, 預填充也大約1k tok, 用polystrata 部署,decode 沒漲,預填充只有大約350 tok/s. 我關注GLM 5.3 模型,主要是他的專注力稀疏技術,在社群上的測試,是目前開源模型,在256k 上下文,長鏈任務,不會飄移的模型。
剛部署起來,打算找時間測試。
目前跑QFN IQ4 128k 上下文,長鏈任務飄移問題,有點頭痛,QFN Q4 256k, 長鏈任務,會因為長上下文召回率降低的問題,LLM 比較無法專注在任務主要的任務上。還需要叮嚀。
打算換GLM 5.3,測試。 -
-
@Charly-Cheng 我是用ddr4 2633
@applejuice
我也是DDR4,怎麼相差這麼多!難道是顯卡的關係? 我用的顯卡是RTX 5000 Ada.
還是你用雙顯卡? -
@applejuice
我也是DDR4,怎麼相差這麼多!難道是顯卡的關係? 我用的顯卡是RTX 5000 Ada.
還是你用雙顯卡?@Charly-Cheng 2张3090
-
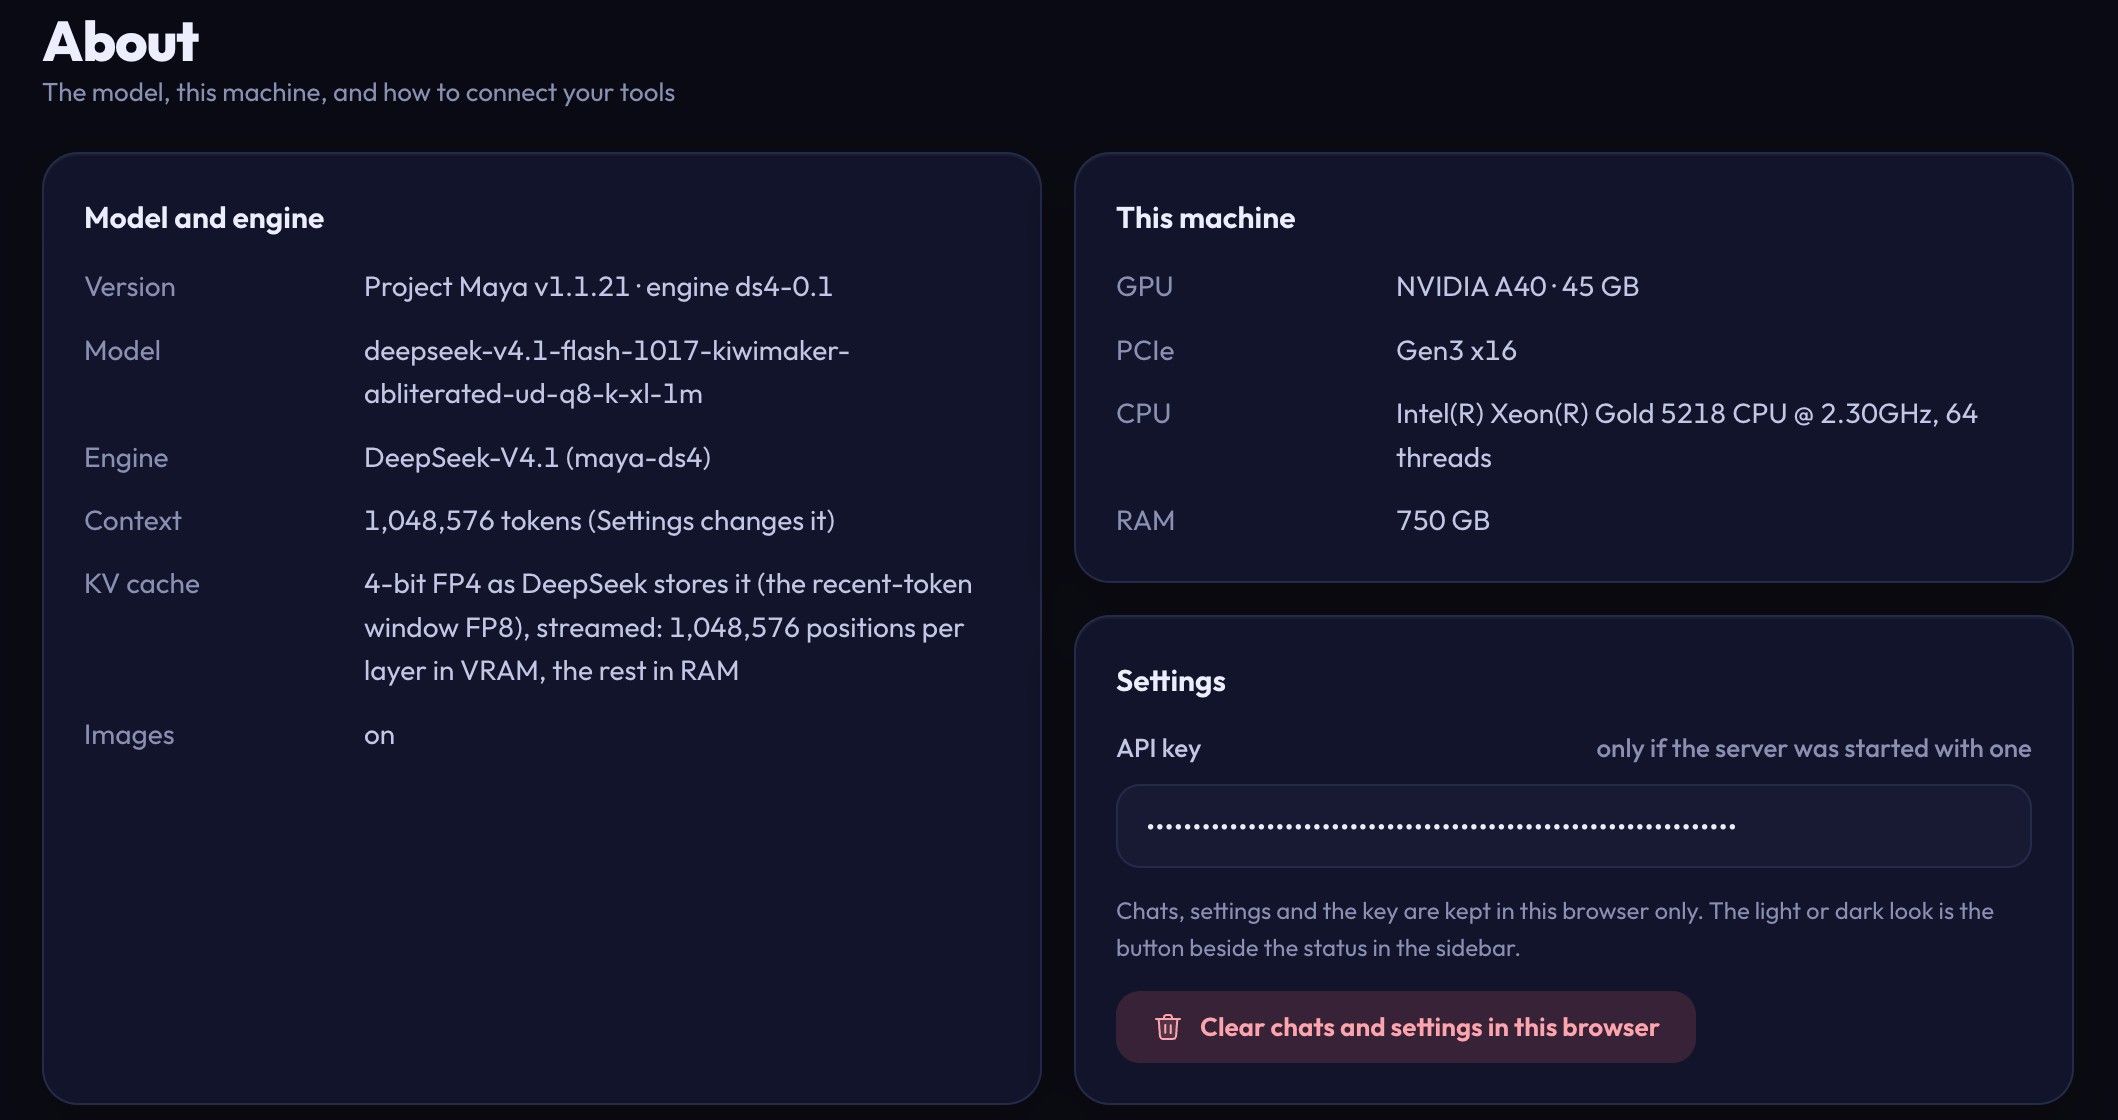
我在我的A40,48G显存+768G内存上,把DeepSeek-V4.1-Flash-1017的Q8量化,模型全放内存读,平均跑到了26T/S。已经有实用价值了,给项目提了PR,看能不能合并进去!专给大内存用户使用!
https://github.com/mw00/project-maya/pull/368
-
-
-
我也在折腾 DeepSeek 1017,做了一个 Strata-DS 分支,当前部署和实测记录放在这里:双 RTX PRO 6000 + 48GB RAM 跑 DeepSeek 1017。
接下来准备和 Project Maya 对齐测试条件做一轮 benchmark,比较 prefill/decode、资源占用和工具调用,也看看能互相借鉴哪些优化。对照结果测完再更新,敬请期待!








 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!
