
Qwen3.8-27B方案新王降臨 Capy-Flash v0.6.0 雙 RTX 5070 Ti + WSL2 跑 capy-flash v0.6.0:Qwen3.8-27B NVFP4 開到 256K,解碼 145 t/s
-
雙 RTX 5070 Ti + WSL2 跑 capy-flash v0.6.0:Qwen3.8-27B NVFP4 開到 256K,解碼 145 t/s
先講結論:在沒有 AVX-512 的 5700X3D 上,capy-flash 的 27B dense 路線完全可行,256K context 開得起來、也用得動,長 context 解碼仍在 145 t/s 上下。以下全部是同機實測,不是引用發佈方數字。
一、測試平台
項目 規格 CPU AMD Ryzen 7 5700X3D(Zen 3,無 AVX-512) GPU 2 × RTX 5070 Ti 16GB(無 P2P,PCIe 4.0 x8/x8) RAM 112GB DDR4-2400(四條混插,JEDEC) OS Windows 11 + WSL2 Ubuntu 24.04 驅動 617.14 引擎 capy-flash v0.6.0(release tarball,sm120a) 模型 Qwen3.8-27B QUASAR-QAT NVFP4(16.2 GiB,含 vision + MTP) 之所以特別註明「無 AVX-512」:官方文件寫 Flash-Next NVFP4 需要 AVX-512 做 CPU expert 計算,但 27B 不需要——權重完整放在兩張卡上。這點對老平台很關鍵。
二、256K 可以開,而且真的能用
KV 262,144 tokens, int8 | pages 4096/4096 | runtime 5.03 GiB | 每卡剩 ~172 MiB深度實測(MTP ×3,thinking off,單請求):
提示詞 tokens Prefill Decode 草稿接受率 197,783 2,422 t/s 146.5 t/s 93.3% 213,772 2,319 t/s 150.8 t/s 93.3% 249,852 2,100 t/s 145.6 t/s 93.3% 短至中等深度:
提示詞 tokens Decode 772 181.8 t/s 12,044 156.3 t/s 48,109 195.5 t/s 96,198 180.7 t/s 142,784 209.4 t/s 155,704 172.4 t/s 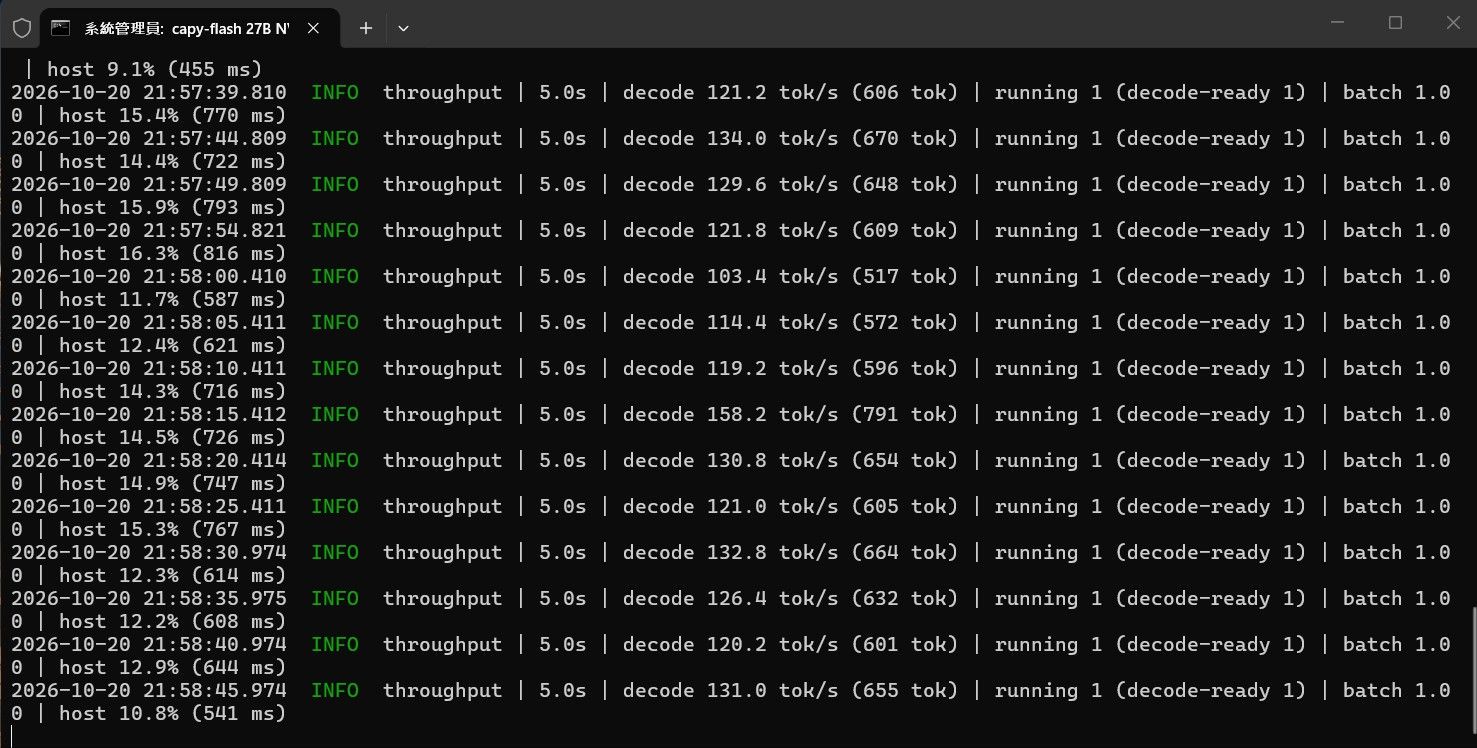
代價:冷的 25 萬 prompt,TTFT 約 2 分鐘;每卡只剩 170MB 餘裕,不能同時跑 ComfyUI / 另一個引擎。
三、MTP vs DFlash2:短輸出會騙人
同一個 40k 提示詞、各生成 500+ tokens(這才是公平樣本):
後端 Decode 接受率 MTP ×3 151.7 t/s 52.3% DFlash2 ×7 133.2 t/s 26.2% 但如果你只讓它生成 20 個 token,DFlash2 會出現 314.9 t/s 的數字——那是短輸出的假象,接受率在長生成時會掉到 26%。論斷投機解碼一定要用長輸出。
四、實戰 Agent 負載(DSH,114 筆請求)
項目 結果 結束原因 114/114 全部正常 stop_token,零截斷Decode 中位數 99.7 t/s(52.7–142.4) 提示詞深度 最深 ~129K Prefix cache 正常命中(單筆 126k tokens 命中) 工具呼叫 正常(單筆最多 8 個 tool call) Vision 通過(四象限色塊全對,編碼 0.044 秒) 速度隨深度下滑:60–80K 約 120–140 t/s,90–130K 約 75–95 t/s。
五、三個踩過的坑(照順序踩)
1. 內附 libcudart 直接 segfault
用 tarball 內附的
lib/libcudart.so.13啟動,會在initializing CUDA後直接 SIGSEGV,log 沒有其他線索。
解法:改用系統 CUDA 13.0 runtime,排在最前面:export LD_LIBRARY_PATH=/usr/local/cuda-13.0/targets/x86_64-linux/lib:$FFMPEG_LIB2. 缺 FFmpeg 8 共享庫
Ubuntu 24.04 只有 FFmpeg 6,但這個 release 連結
libavformat.so.62/libavcodec.so.62/libswscale.so.9/libavutil.so.60。
解法:抓 BtbN 的ffmpeg-n8.1-latest-linux64-gpl-shared,解到私人目錄後加進LD_LIBRARY_PATH,不要污染系統套件。3. 8 GiB host-KV 鎖定被 OOM 殺
--profile 27b預設會鎖 8 GiB host KV,在 WSL 的 cgroup 裡被 OOM kill(oom_score_adj: 200)。
解法:縮小可選的 host tier:--host-kv-mib 2048 --host-state-slots 4
六、256K 下的隱形殺手:KV lease 長不下去
這是這次最有價值的發現。設定 50K 輸出上限時,答案常常在 12K–17K 就自己停住,回報
output_limit,看起來像被截斷。引擎 log 寫得很清楚:
[engine] warning: Device KV lease of lane 0 cannot grow ...
still short 1 main page for its smallest step,
so the answer ends early with output_limit
原因是 256K 的 KV 池先把 VRAM 佔滿,答案變長時要擴 KV 卻擴不出來,只好硬收。
解法:--kv-lease-window 0一開始就把整個輸出空間保留好,不必中途擴張。加上之後 114 筆請求、0 次警告、0 次截斷,速度也沒有下降(改前 133–136 t/s、改後中位 99.7 t/s,差異來自深度與內容而非這個參數)。
代價:長提示+長輸出超過 256K 總量時會直接拒絕(
context_capacity),而不是默默截斷。
七、關於思考長度
同一顆模型在一般請求的思考中位數只有 206 tokens,但遇到難題會單筆吃 79,458 tokens 才產出答案。所以:
- 設「思考上限」會硬切推理,難題正確率有下降風險(此引擎沒有鬼打牆偵測,無法區分這兩者);
- 比較安全的做法是輸出上限留 92K 給長推理,撞上限就人工中止重問。
八、幾個誠實的邊界
- 這不是跟 Strata/Flash-Next 的公平比較。 capy-flash 27B 是 27B dense,Flash-Next 是 125B MoE;引擎、模型、量化全都不同。
- 測試機沒有 AVX-512、RAM 是 DDR4-2400,所以官方在 DDR5-5600 平台上的 175 t/s 不該直接對照;我們在 40k 提示的長生成是 151.7 t/s。
- 只有一台機器、單一使用者,
--max-concurrency 1,多用戶數字未驗證。 - DFlash2 在 27B 這條線沒有想像中強,至少在英文技術內容上是 MTP 較穩。官方也提過 DFlash2 的接受率對內容極敏感(非英文散文可能掉到 20%)。
- 26B/27B 以上量化選擇未做同題品質 A/B,本文只有速度與穩定性。
九、目前使用的啟動設定
ninfer-serve <27B-quasar-nvfp4.ninfer> \
  --profile 27b --host 0.0.0.0 --port 8080 --model-id capy-27b \
  --max-context 262144 \
  --kv-lease-window 0 \
  --spec mtp --draft-tokens 3 --lm-head-draft \
  --host-kv-mib 2048 --host-state-slots 4
載入約 40 秒,模型 id 需完全一致(
capy-27b),送錯名稱會回 404。十、測試結果
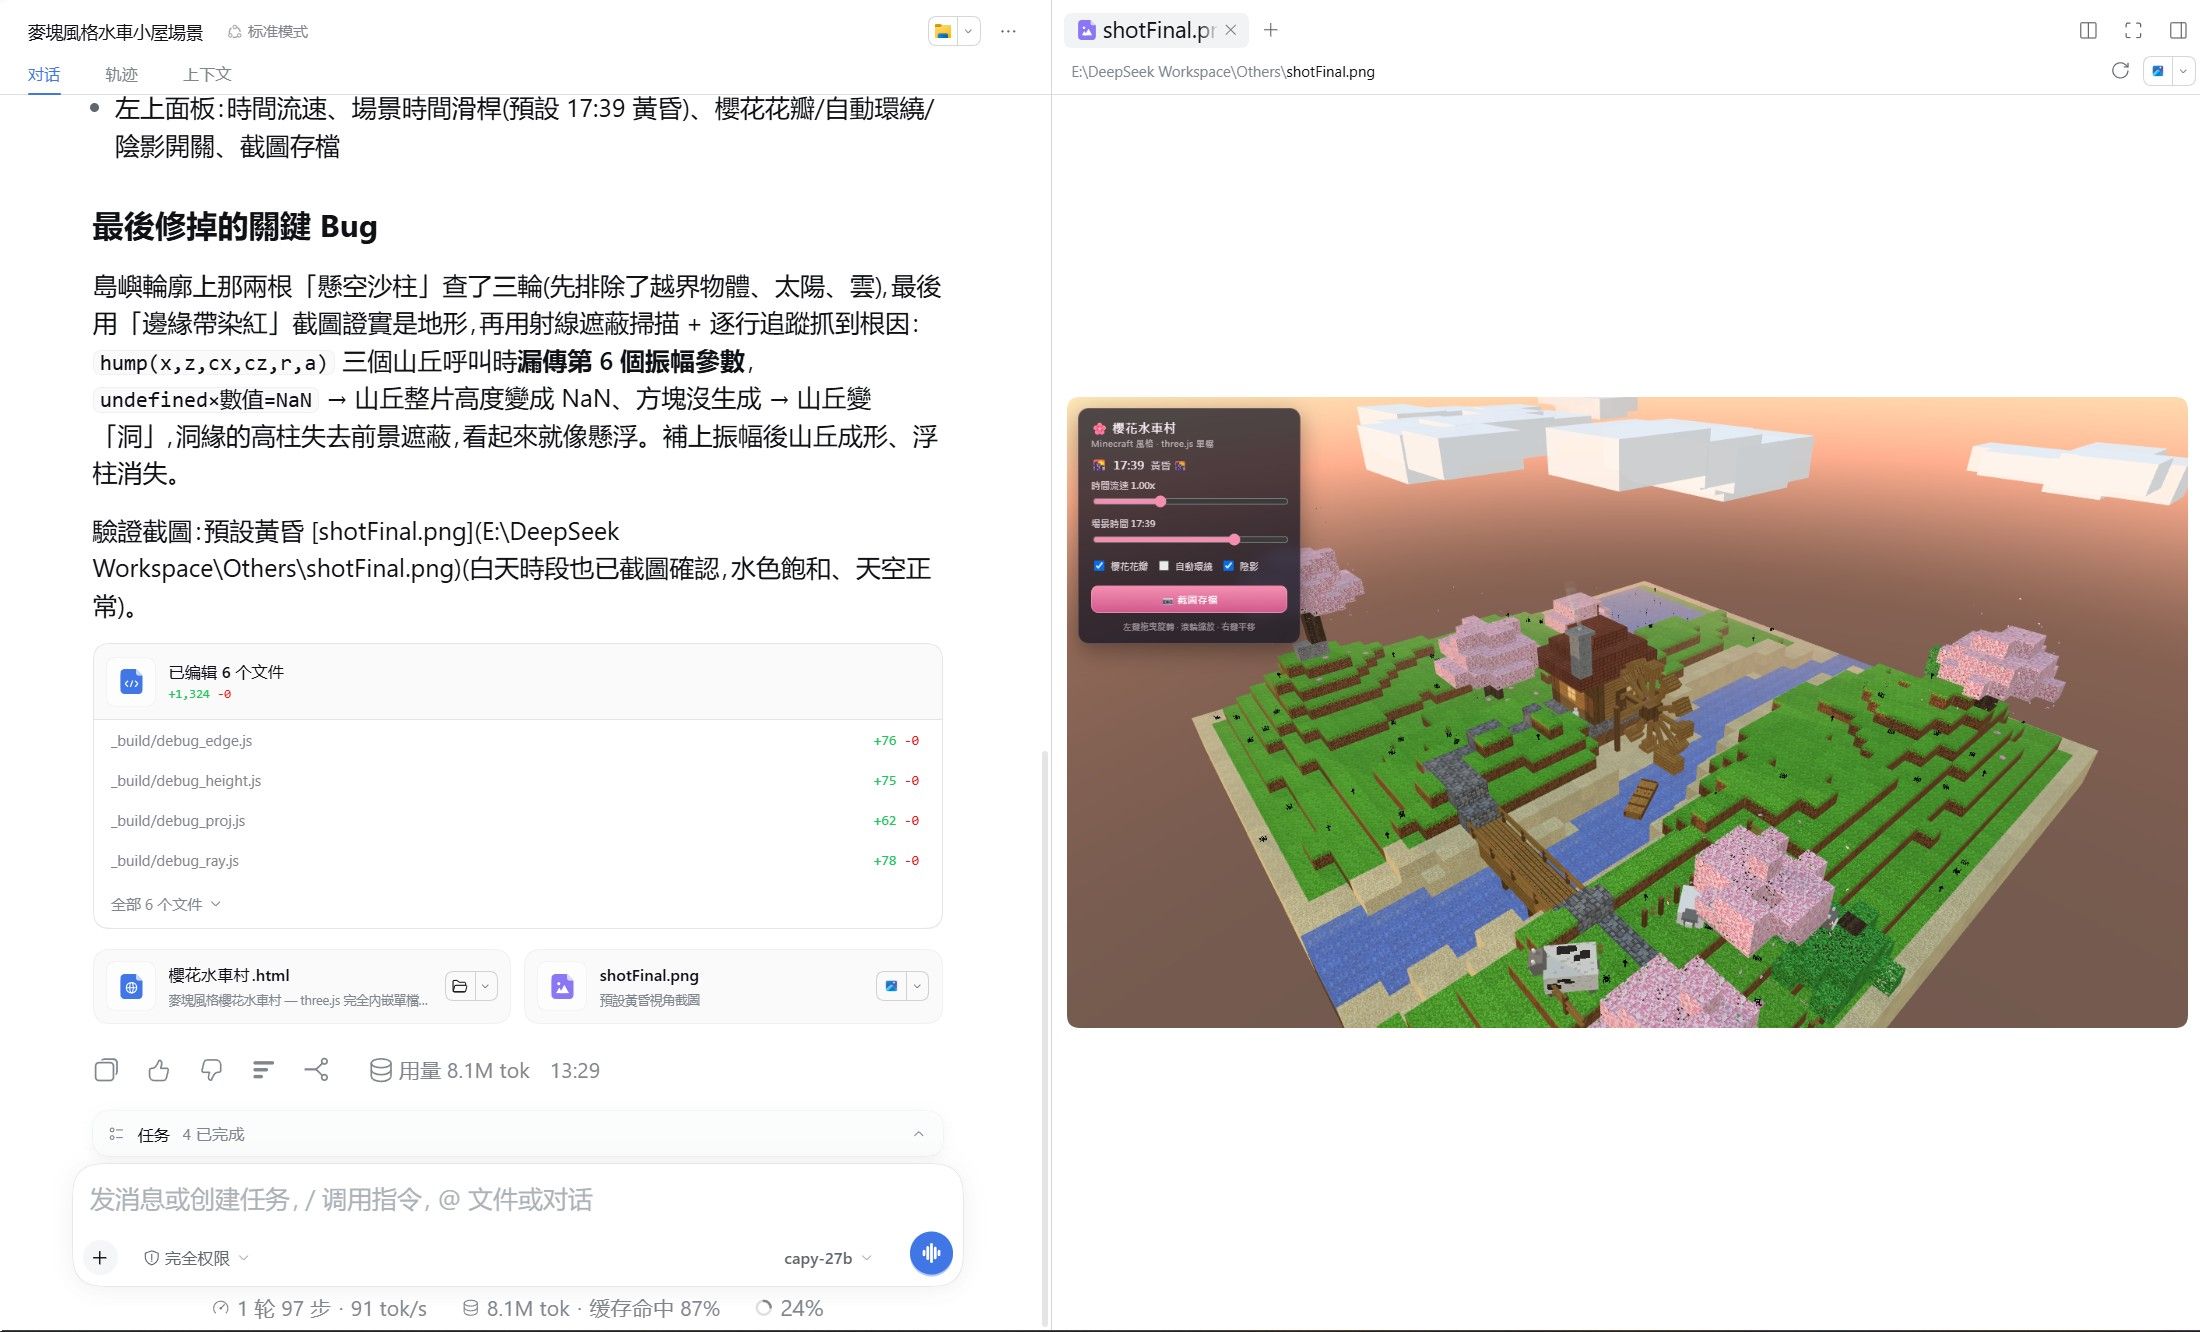
three.js水車小屋測試
Prompt:請用three.js建造一個麥塊風格的水車小屋,要有櫻花樹的場景
每個方塊請要有各自的材質,不要用單色的方塊,方塊內容要細緻,場景也盡可能精雕細琢,要有日出日落的變換
水車小屋,河道,水田,牧場,地形高低起伏,櫻花飄落
請把 three.js 完全內嵌進 HTML,做成html單檔一次完成,沒有任何破圖,做出來效果還是相當不錯的
-
-
-
-
27b 还是很有潜力
-
,
 T terry 固定了此主题
-
-
-
,系统 取消固定了此主题



