
64 GB RAM 从 RTX 4070+3060 换到双 RX 7900 XTX:Maya 本地推理实测GLM-5.3-Flash + DeepSeek-V4.1-Flash-1017
-
最近把本地 LLM 平台从 NVIDIA 换到了双 AMD,CPU 和内存也整理好了。分享一下目前各个模型、后端的配置和实测结果,供类似硬件的朋友参考,也欢迎交流双 7900 XTX 的优化经验。
目前比较明显的感受是:显存从 24GB 增加到 48GB,模型放置和上下文配置更宽裕了,但速度仍然很依赖模型、量化格式、推理内核和专家缓存命中率。
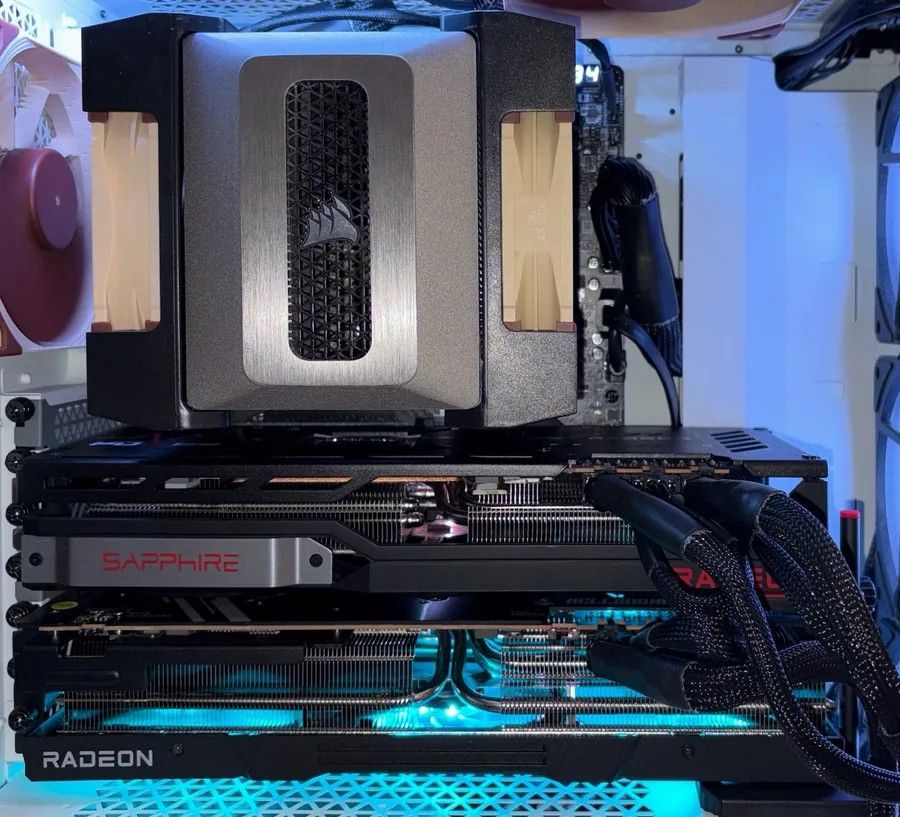
硬件变化
项目 之前的 NVIDIA 平台 当前 AMD 平台 CPU i5-13600KF i9-13900KS GPU RTX 4070 12GB+RTX 3060 12GB RX 7900 XTX 24GB ×2 总显存 24GB 48GB 系统内存 64GB 64GB,系统可见约 61.51GiB 当前主板 — MSI MPG Z690 CARBON WIFI 当前 GPU 链路 — CPU PCIe 4.0 x8/x8 当前两张 AMD 卡都参与推理,但直接 P2P 尚未启用:
- SGLang、vLLM 使用 TP2,经主机内存传输。
- llama.cpp、Strata、Maya 使用各自支持的分层方案;Strata/Maya 的这些配置不能等同于真正的张量并行。
- MoE 模型使用 CPU/RAM 专家卸载和 GPU 热专家缓存,Strata、Maya 的流式模型放在 NVMe 上。
本次使用的后端版本
后端 版本/提交 llama.cpp HIP/Vulkan 4c3c5810SGLang ROCm,gfx1100 分支 f84475cc,保留本地 RDNA 修复vLLM ROCm 0.32.1rc1.dev36+ge68efc685.rocm72Strata HIP 0.1.45 / 477ac13cProject Maya HIP 1.1.17 / 8d9a9b5dROCm SDK 7.2.3当前 AMD 实测
下面九个配置使用相同的基本测试流程:
- 短提示词分别测试代码和故事生成,每项预热一次、计时三次,取中位数。
- 输出上限 256 tokens,
temperature=0.6、top_p=0.95、seed=42,请求关闭 thinking。 - Prefill 使用新输入,约 8K tokens;Maya tokenizer 下实际约 6.3K。
- 冷启动和编译时间不计入 TTFT。
- Decode 为外部 SSE 测量;llama.cpp/Strata/Maya 的 PP 来自原生计时,SGLang/vLLM 来自各自引擎的 prefill 阶段计时,定义有差异。
下表的“代码/故事”按这个顺序排列。PP、Decode 单位均为 tokens/s。
模型/量化 后端/策略 配置上下文 Prefill 新输入 Prefill TTFT 短提示词 TTFT,代码/故事 Decode,代码/故事 Qwen3.8-27B Q4_K_M llama.cpp Vulkan,MTP3 64K 670.4 12.222s 0.132/0.131s 77.10/45.86 Qwen3.6-35B-A3B MXFP4_MOE llama.cpp HIP,专家缓存+MTP3 256K 373.5 21.933s 0.059/0.059s 126.73/78.36 Nemotron-3.5-Bolt-74B-A9B Q4_K_M llama.cpp HIP,专家缓存 256K 220.3 35.989s 0.400/0.243s 37.21/36.87 Empero Qwen3.8-35B-A3B IQ4_XS llama.cpp HIP,专家缓存+MTP3 256K 388.4 21.083s 0.057/0.057s 125.85/77.07 Qwen3.8-27B GPTQ INT4 SGLang TP2,DFlash2 160K 1314.8 6.235s 0.102/0.097s 178.82/63.40 Qwen3.8-27B GPTQ INT4 vLLM TP2,compiled MTP3 160K 1413.8 5.806s 0.066/0.092s 130.31/68.96 Qwen3.8-Flash-Next IQ3_XXS Strata HIP,overlap+MTP3 256K 914.3 8.987s 0.219/0.223s 76.61/53.35 GLM-5.3-Flash Maya-S24 Maya HIP,分层+MTP 32K 525.9 12.159s 0.074/0.097s 21.13/16.54 DeepSeek-V4.1-Flash-1017 Maya-S Maya HIP,分层,DSpark 关闭 32K 185.5 33.956s 0.374/0.550s 6.24/6.84 另一个保留的模型是 Nemotron Super IQ3_XXS。它使用固定约 8K 输入的代码/故事测试,工作负载不同,因此单独列出:
模型/后端 上下文 实际输入/输出 原生 Prefill TTFT Decode Super IQ3_XXS/llama.cpp HIP,代码 32K 8,108/256 98.21 82.566s 15.90 Super IQ3_XXS/llama.cpp HIP,故事 32K 8,111/256 97.84 82.911s 16.95 Super 当前关闭 MTP,使用 CPU 专家 backing 和 GPU 热专家缓存。上面的 TTFT 包含约 8K 输入处理,不能与前表的短提示词 TTFT 直接比较。
长上下文到底测到了哪里?
配置了某个窗口,不代表整个窗口已经完成质量和速度验证。目前保留的证据如下:
配置 实际输入/输出 验证结果 SGLang DFlash2,160K 160,861/22 开头、中间、结尾三个标记全部找回;新输入 TTFT 283.113s,历史跟进 TTFT 0.795s vLLM MTP3,160K 160,868/22 三个标记全部找回;新输入 TTFT 183.591s,历史跟进 TTFT 1.467s Strata Q3,256K 257,984/256 长输入和历史跟进通过;该探针原生 PP 1000.1、原生 Decode 67.1,未记录外部 TTFT Maya GLM/DeepSeek,32K 约 30K 输入 标记检索和完整历史跟进通过 三个较小的 llama.cpp MoE 虽然配置为 256K,但保留的检索证据主要是旧版本约 64K,以及新版本约 8K 测试,不把它们写成已经完整验证 256K。
同样,表里的 SGLang 178.82 t/s 是短提示词代码生成成绩,不能当作带着 16 万 tokens 历史时的持续生成速度。
Strata 和 Maya 的配置补充
- Strata 保留 Flash-Next IQ3_XXS,专家 RAM 预算 13.5GiB,6 个 pool workers;INT8 KV,GPU KV 驻留 32K,其余使用主机 backing。
- GLM 使用 Maya-S24/IQ2_XXS_S,三个 GGUF 分片,RAM 专家预算 40GiB,MTP 开启。
- DeepSeek 使用 Maya-S/IQ2_XXS,六个 GGUF 分片,包含 Q6_K Engram。这是混合量化,不能理解成所有张量都是统一 2-bit。
- DeepSeek 的 DSpark 已测过,这台机器上没有选用,当前保持关闭。
- Maya 保留每卡原生 8GiB reserve,并要求启动后实际整卡空闲至少 6GiB,同时监控主机内存、显存和 owned worker 的 swap/spill。
目前通过的配置均保留了零 observed worker swap/VRAM spill 的记录。正在测试 GLM Maya-S 对比 S24;暂时仍以上表已经验证的 S24 结果为准。
旧 NVIDIA 平台留档
旧平台是 4070 12GB+3060 12GB。挑几组有实际计时记录的数据作参考:
模型/量化 当时的后端 上下文 Decode,代码/故事 Qwen27B Q4_K_M llama.cpp,MTP 64K 53.5/32.0 Qwen27B INT4/group128 SGLang TP2,MTP 40K 83.56/51.59 Qwen27B INT4/group128 vLLM TP2,MTP3 48K 86.04/58.01 Qwen27B AWQ HyperQwen TP2,MTP3 64K 108.3/66.8 Qwen27B AWQ HyperQwen TP2,DFlash2 64K 170.1/67.3 Flash-Next IQ3_XXS Strata,MTP4 256K 68.8/64.6 这些 NVIDIA 数据来自各自历史版本,CPU、量化、后端版本、上下文、输出长度和策略都存在变化,不能据此计算纯 GPU 升级带来的提升百分比。特别是旧 NVIDIA 的 HyperQwen DFlash2,本来就有很不错的短提示词成绩。
我把硬件、启动脚本、版本、测试方法和数值记录整理在了 Github 公开仓库:Biegle-W
欢迎有双 7900 XTX、类似 CPU/内存配置的朋友贴一下自己的 Maya、Strata 或 ROCm 成绩,最好带上量化、实际输入长度、采样参数、缓存状态和版本,方便一起对照。
-
-
此主題已被删除!
-

