3090春天来啦!最新推理引擎比Strata 快1.63倍!!!
-
-
如图,项目地址如下:https://github.com/turbo-tan/tqllm
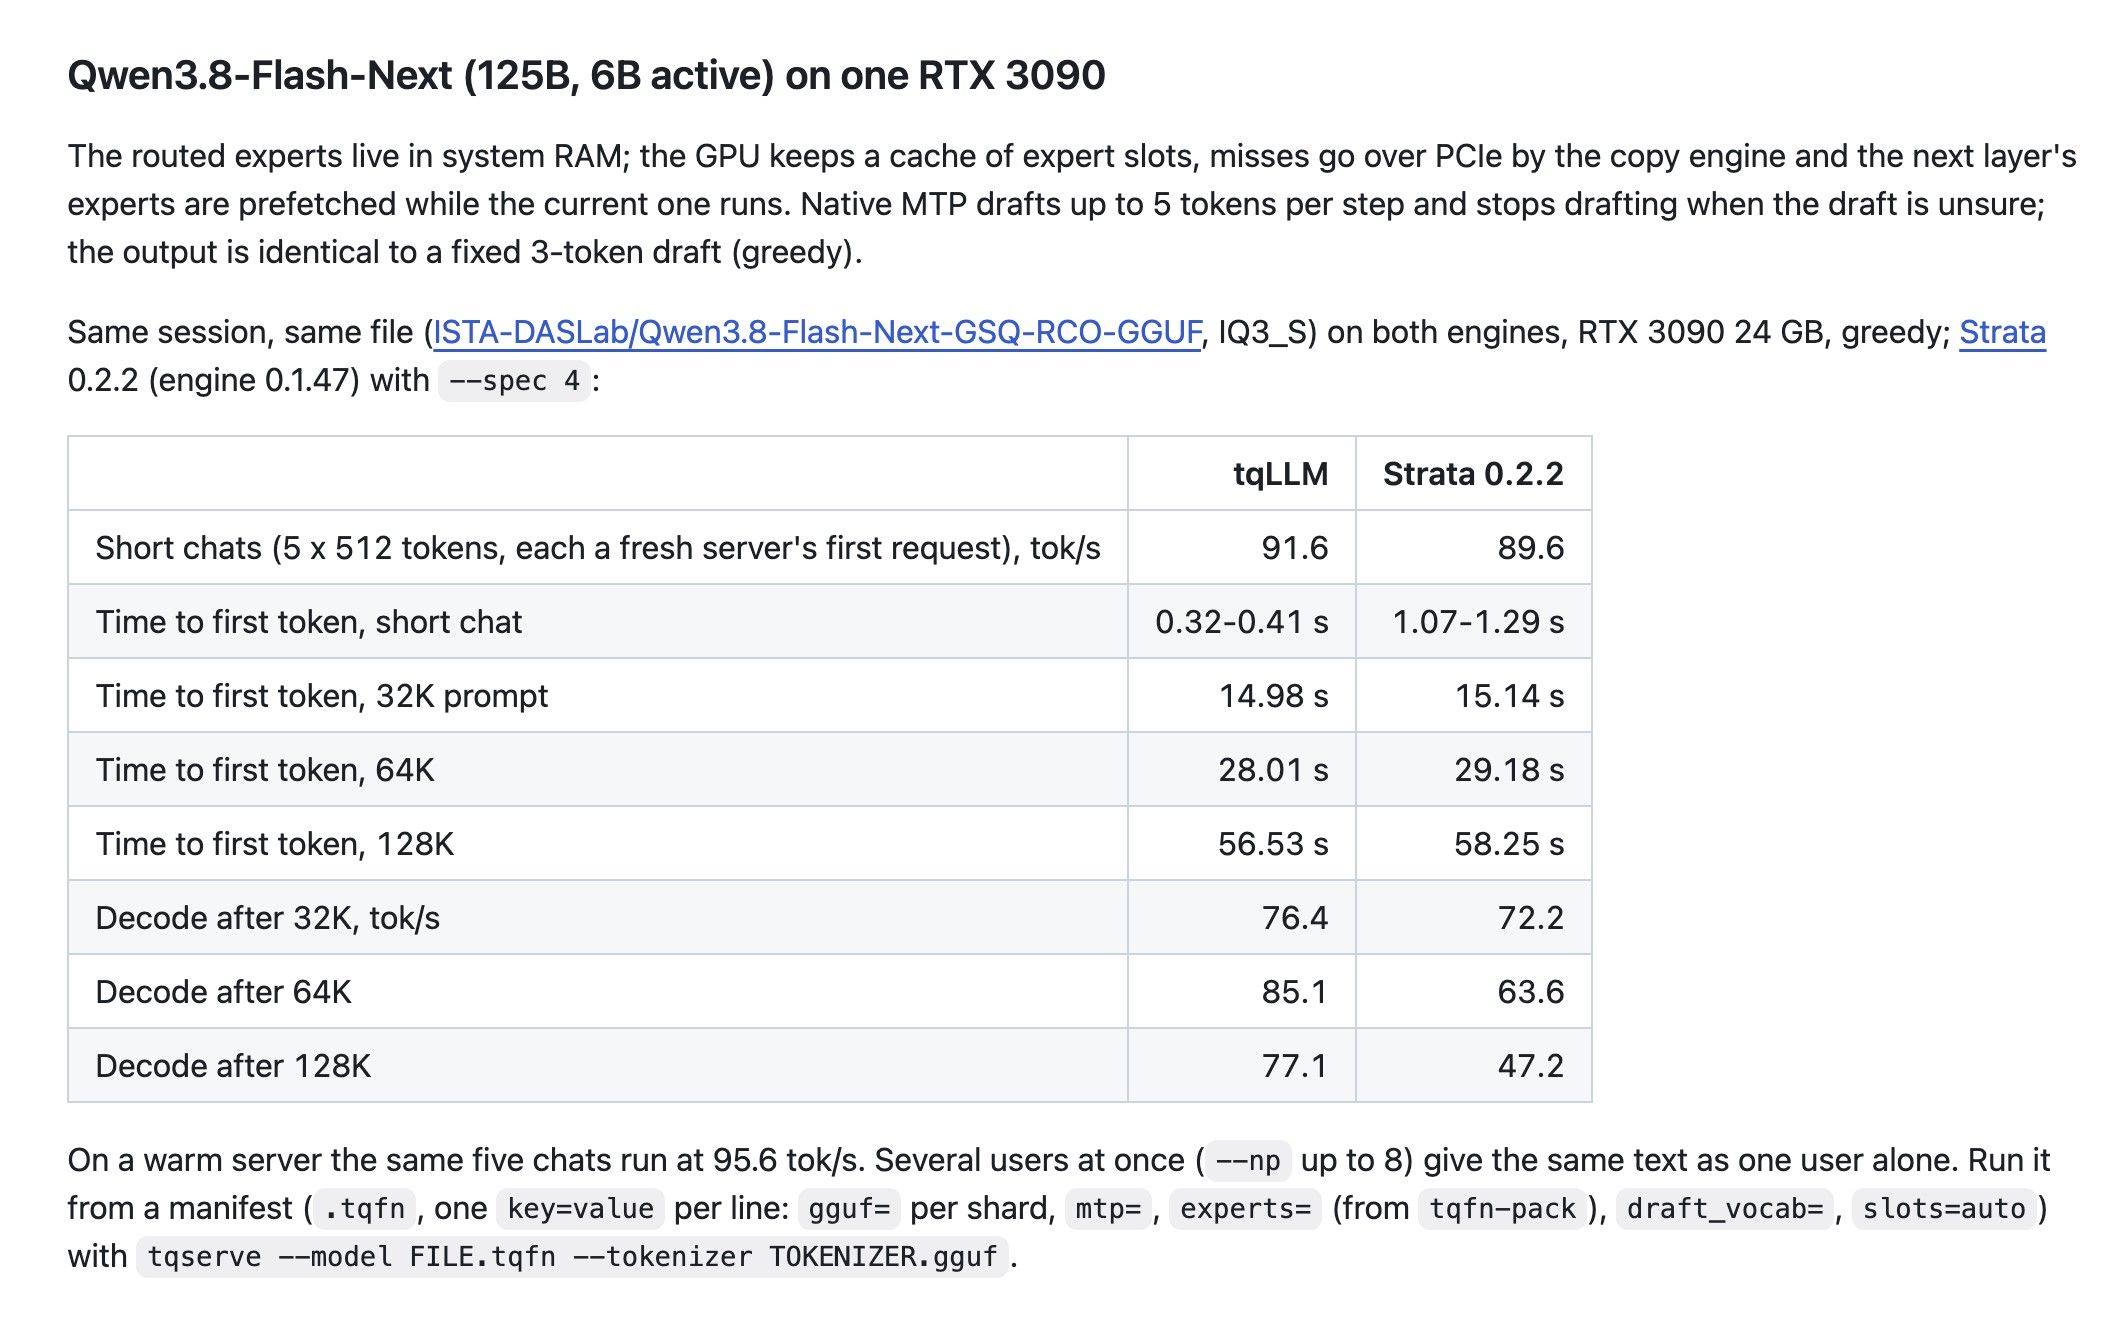
按项目官方所说,在128K长上下文状态下,可以比Strata推理引擎接近快1.63倍!
如果在算上最近3090的算力破解,decode速度可能没变,但是pf速度可能快很多啊,可以解决一下 目前Strata推理引擎 在长上下文等待第一个token 过久的问题!!
-
先别急着把 1.63x 当成全场景结论,关键看它测的是 TTFT 还是 decode。
128K 下 Strata 的首 token 延迟,瓶颈通常在 MoE expert offload 的 PCIe/CPU 路径,不在 3090 的算力。如果 tqllm 的收益来自 chunked prefill 或 expert 驻留策略,那它改善的会是长上下文 TTFT;短对话快很多则更像调度/批处理优化,和 prefill 关系不大。
建议用同一模型同一量化(IQ3_S)、batch=1,分别测 8K/32K/128K 的 TTFT p50/p95 和 decode tok/s,再看 1.63x 落在哪一段。否则很容易把「短对话优化」误读成「长上下文全面提速」。
-
-
-
如图,项目地址如下:https://github.com/turbo-tan/tqllm
按项目官方所说,在128K长上下文状态下,可以比Strata推理引擎接近快1.63倍!
如果在算上最近3090的算力破解,decode速度可能没变,但是pf速度可能快很多啊,可以解决一下 目前Strata推理引擎 在长上下文等待第一个token 过久的问题!!