跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. Strata跑deepseek-V4.1-flash, Maya 实测 decode 50 tokens

Strata跑deepseek-V4.1-flash, Maya 实测 decode 50 tokens

已定时 已固定 已锁定 已移动 LLM讨论区
stratadeepseekrtxpro5000
9 帖子 4 发布者 309 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Peng XiaoP
    Peng XiaoP
    Peng Xiao
    编写于 最后由 编辑
    #1

    DeepSeek-V4.1-Flash 性能测试报告

    测试时间:2026-10-23 | 测试方式:API 流式/非流式实测(127.0.0.1:8080 + 公网隧道)
    引擎:Project Maya v1.1.25(build/maya-ds4)· 模型:DeepSeek-V4.1-Flash-1017(Maya-S 量化)


    一、软硬件环境

    硬件

    组件 规格
    CPU AMD EPYC 7K62 48 核 / 96 线程(L2 24 MiB · L3 192 MiB)
    内存 252 GB DDR4(单 NUMA 节点)
    GPU 0 NVIDIA RTX PRO 5000 Blackwell · 48 GB · PCIe 4.0 x16
    GPU 1 NVIDIA GeForce RTX 5060 Ti · 16 GB · PCIe 4.0 x16
    GPU 2 NVIDIA RTX PRO 4500 Blackwell · 32 GB · PCIe 4.0 x16
    磁盘 Predator GM7000HS 2TB NVMe(模型 339.5 GB 存放于此)

    软件

    组件 版本
    操作系统 Ubuntu 24.04.5 LTS(内核 7.0.0-38-generic)
    NVIDIA 驱动 595.99.02(CUDA 13.2 runtime)
    CUDA 编译工具 nvcc CUDA 12.0 构建链 / sm_120
    Maya 引擎 v1.1.25(2026-10-23 发布)
    模型量化 Maya-S:IQ2_XXS/IQ2_S/IQ3_XXS/IQ3_S 专家 + Q6_K Engram(339.5 GB)
    草稿器 DSpark(--dspark on),保留率 ~75%
    隧道 cloudflared 2026.10.1(quick tunnel)
    Python 3.12.3

    引擎配置

    --max-context 393216(384K)· --tp 2 · 3 GPU · 无视觉 · 专家分层:

    GPU 分得层 专家驻留
    CUDA0(48G) [0, 42) 3534 / 6528(54%)
    CUDA1(16G) [16, 25) 961 / 3840(25%)
    CUDA2(32G) [26, 39) + head 2321 / 5376(43%)

    二、性能实测数据

    1. 生成速度(流式,免思考,1200 tok/轮)

    轮次 首 token 速度
    冷启动 1.5 s 51.8 tok/s
    热身第 2 轮 0.0 s 56.3 tok/s
    热身第 3 轮 0.0 s 55.4 tok/s

    2. 思考模式(thinking budget 修复后)

    指标 值
    数学题端到端 4.2 s(思考 84 tok + 答案 48 tok)
    全程速度 31.6 tok/s
    结论 v1.1.22 的"思考失控吃光预算"问题已修复

    3. Prefill(prompt 读取)

    场景 tokens 速度 耗时
    短文档 2,925 319 tok/s 9.2 s
    长 prompt 14,541 601 tok/s 24.2 s

    长 prompt 更快的原因:v1.1.19+ 的长 prompt 跳层(DeepInfer 方法,20-39 层只算最后 ~2.7K token)+ NVMe 页缓存变热。文档越长读取效率越高。

    4. 对话缓存

    重复同题首 token 0.44 s(conversation checkpoint 命中),同类新题 0.0-1.5 s。

    5. 公网链路(cloudflared quick tunnel)

    指标 值
    TLS 握手 0.14-0.31 s
    首字节(TTFB) 1.0-1.7 s
    可用性 HTTP 200,/v1/models 返回完整 384K 配置

    6. 资源占用(384K KV cache 下)

    资源 状态
    GPU 显存 三卡满配计划内(专家池占 ~95 GB),空闲 450-590 MiB/卡
    RAM 已用 113 G + 页缓存 125 G,可用 137 G

    三、纵向对比(同机 DeepSeek Maya-S)

    版本/配置 热身生成 16K prefill 备注
    v1.1.22 @ 256K 46-48 tok/s 479 tok/s 2026-10-22
    v1.1.25 @ 384K 55-56 tok/s 601 tok/s 2026-10-23,+16% / +26%

    与 GLM Maya-L(同机 v1.1.25,384K,parallel 2)对比:GLM 44-46 tok/s,DeepSeek 55-56 tok/s 快约 20%。

    四、校准与调优记录

    • DS4 校准(./maya.sh --calibrate):--tp 2(40.0) > --tp 1(39.4) > --tp 3(37.2)——tp 2 为最优;3 卡显存互不相等(48/16/32 GB),TP 只能两两配对,其余各跑各的层
    • PCIe lane 自适应:引擎实测 CPU lane(0.24-1.1 ms/专家)vs GPU 流式(1.1-1.5 ms)vs 磁盘(5.3-6.3 ms),自动关闭不划算的流式
    • 页缓存:随使用增长(当前 125 GB),磁盘 miss 持续减少

    五、结论

    1. 本机 DeepSeek Maya-S 已接近该硬件的理论上限:三卡利用率均衡,RAM/SSD 分层工作正常
    2. v1.1.25 相比 v1.1.22 全面提升:生成 +16%、长 prompt 读取 +26%
    3. 384K 上下文的 KV 开销被引擎优化完全吸收,无回退
    1 条回复 最后回复
    2
    • farmer nodeF
      farmer nodeF
      farmer node
      体面乡绅 硕果累累
      编写于 最后由 编辑
      #2

      我也一直在关注这个项目,最近A 卡的也都支持了, 都在考虑是否有必要把 ram 括到256g 了

      1 条回复 最后回复
      0
      • Peng XiaoP
        Peng XiaoP
        Peng Xiao
        编写于 最后由 编辑
        #3

        内存总是越大越好,实在用不上就做磁盘缓存

        1 条回复 最后回复
        0
        • johnnybegoodJ
          johnnybegoodJ
          johnnybegood
          王侯将相
          编写于 最后由 编辑
          #4

          力大飞砖!力大飞砖!

          1 条回复 最后回复
          0
          • NY ZhaoN
            NY ZhaoN
            NY Zhao
            编写于 最后由 编辑
            #5

            128G内存可以不?可以的话,我再买一张4090 48G @peng-xiao

            1 条回复 最后回复
            0
            • Peng XiaoP
              Peng XiaoP
              Peng Xiao
              编写于 最后由 编辑
              #6

              跑应该能跑起来,内存放不下就放nvme磁盘,性能就没测过了

              johnnybegoodJ 1 条回复 最后回复
              0
              • ,gao GaoG gao Gao 引用了 此主题
              • Peng XiaoP Peng Xiao

                跑应该能跑起来,内存放不下就放nvme磁盘,性能就没测过了

                johnnybegoodJ
                johnnybegoodJ
                johnnybegood
                王侯将相
                编写于 最后由 编辑
                #7

                @Peng-Xiao 能看出速度是个什么趋势么? 是受限于最慢那个卡, 还是三个卡的速度中和了一下。

                1 条回复 最后回复
                0
                • Peng XiaoP
                  Peng XiaoP
                  Peng Xiao
                  编写于 最后由 编辑
                  #8

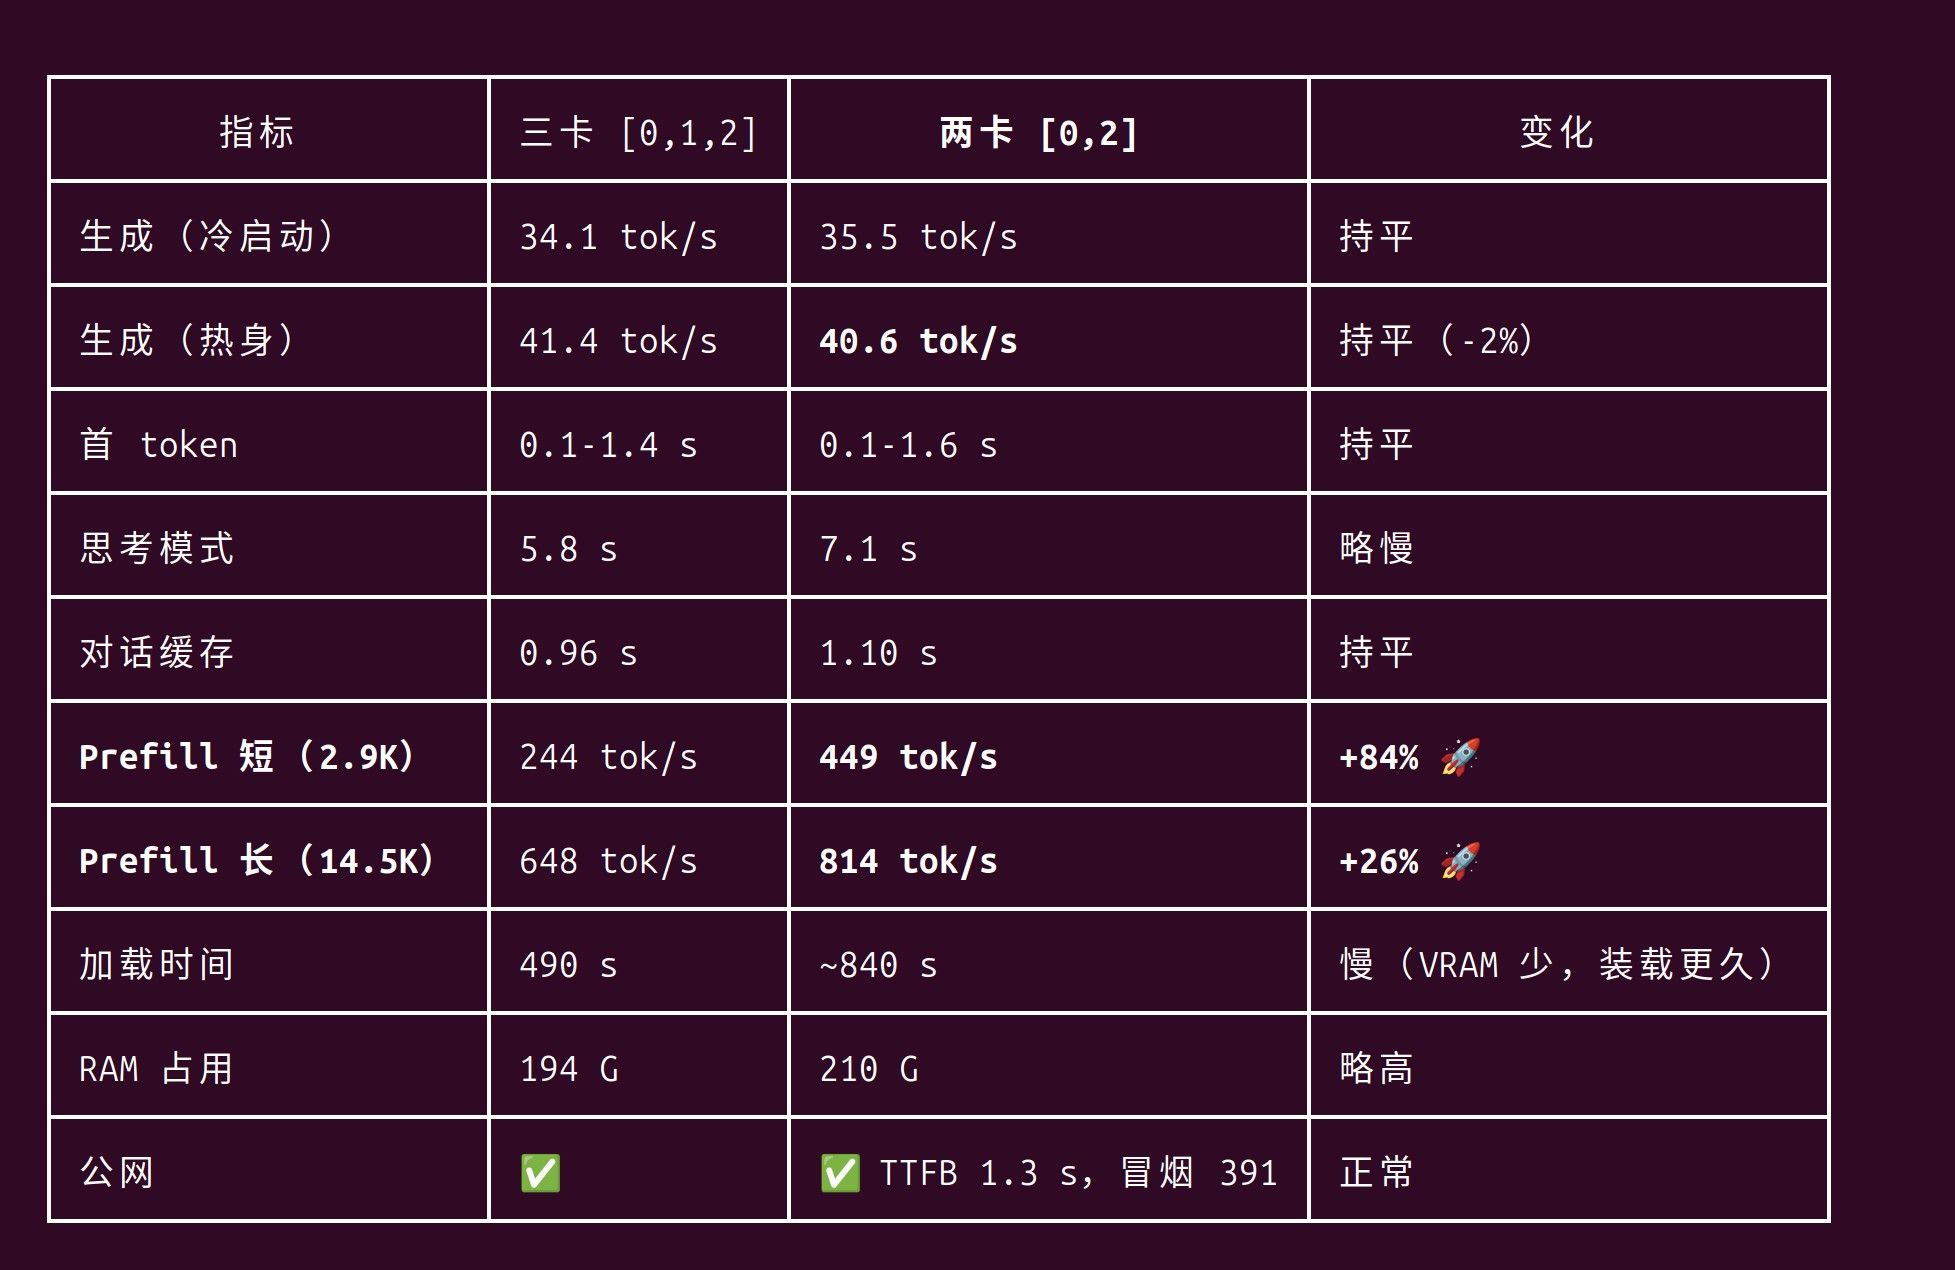
                  image.jpeg
                  使用48G+32G两张卡性能更好,接近60 tokens/s了

                  1 条回复 最后回复
                  0
                  • Peng XiaoP
                    Peng XiaoP
                    Peng Xiao
                    编写于 最后由 编辑
                    #9

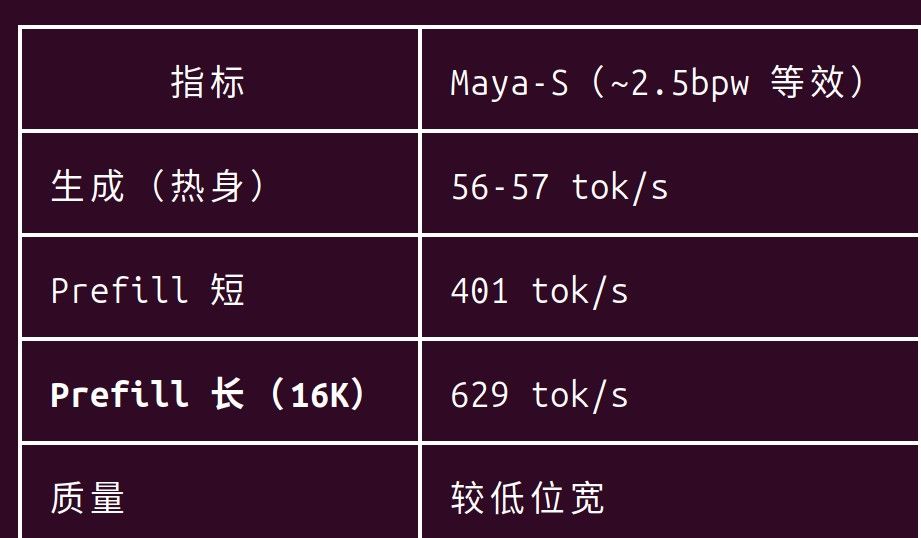
                    更新 更高精度版本的性能
                    image.jpeg

                    1 条回复 最后回复
                    0

                    你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                    厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                    有了你的建议,这篇帖子会更精彩哦 💗

                    注册 登录
                    回复
                    • 在新帖中回复
                    登录后回复
                    • 从旧到新
                    • 从新到旧
                    • 最多赞同


                    • 登录

                    • 登录或注册以进行搜索。
                    • 第一个帖子
                      最后一个帖子
                    0
                    • 版块
                    • 最新
                    • 标签
                    • 热门
                    • 用户
                    • 群组